

Aloha, oameni buni! Numele meu este Oleg Anastasie, lucrez la Odnoklassniki în echipa Platformei. Pe lângă mine, în Odnoklassniki lucrează o mulțime de echipamente. Avem patru centre de date, cu aproximativ 500 de rack-uri și peste 8000 de servere. La un moment dat, ne-am dat seama că implementarea unui nou sistem de management ne va permite să folosim mai eficient tehnologia, să simplificăm gestionarea accesului, să automatizăm (re)distribuția resurselor computaționale, să accelerăm lansarea de noi servicii și să răspundem mai rapid la avarii mari.
Ce a ieșit din asta?
Pe lângă mine și o mulțime de echipamente, sunt oameni care lucrează cu aceste echipamente: ingineri care se află direct în centrele de date; specialiști în rețea care configurează infrastructura de rețea; administratori, adică SRE, care asigură reziliența infrastructurii; și echipe de dezvoltatori, fiecare fiind responsabil pentru o parte din funcțiile portalului. Software-ul pe care îl creează funcționează cam așa:
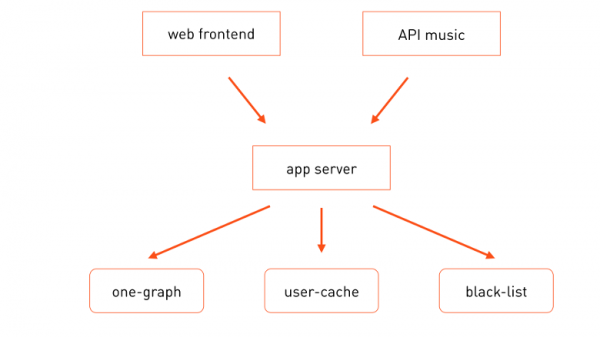
Cererea utilizatorilor ajunge atât la frontend-ul principal al portalului , cât și la altele, de exemplu la frontend-urile API-ului de muzică. Acestea, pentru a gestiona logica de business, apelează serverul de aplicații, care, în procesul de prelucrare a cererii, invocă microserviciile specializate necesare — one-graph (grafica legăturilor sociale), user-cache (cache-ul profilurilor utilizatorilor) etc.
Fiecare dintre aceste servicii este desfășurat pe mai multe mașini, iar pentru fiecare există dezvoltatori responsabili de funcționarea modulelor, exploatarea acestora și dezvoltarea tehnologică. Toate aceste servicii sunt lansate pe servere fizice, iar până de curând am rulat exact o sarcină pe un server, adică acesta era specializat pentru o anumită sarcină.
De ce așa? Acest lucru avea câteva avantaje:
- Se simplifică gestionarea în masă. Să spunem că sarcina necesită anumite biblioteci, anumite configurații. Atunci serverul este alocat exact unei anumite grupuri, se descrie o politică cfengine pentru această grupă (sau deja a fost descrisă), iar această configurație este răspândită centralizat și automat pe toate serverele din această grupă.
- Se simplifică diagnosticarea. Să presupunem că observi o încărcare crescută a procesorului central și îți dai seama că această încărcare a fost generată doar de sarcina care rulează pe acest procesor fizic. Căutările pentru vinovat se încheie foarte repede.
- Se simplifică monitorizare. Dacă există o problemă cu serverul, monitorul te anunță și știi exact cine este de vină.
Serviciului, format din mai multe replici, i se atribuie mai multe servere - câte unul pentru fiecare. Astfel, resursa de calcul pentru serviciu este alocată foarte simplu: câte servere are serviciul, atâtea resurse poate consuma la maxim. „Simplu” aici nu înseamnă că este ușor de utilizat, ci că distribuția resurselor se face manual.
Această abordare ne-a permis de asemenea să realizăm configurații hardware specializate pentru sarcini care rulează pe acest server. Dacă sarcina stochează volume mari de date, folosim un server 4U cu șasiu pentru 38 de discuri. Dacă sarcina este pur și simplu de calcul, putem cumpăra un server 1U mai ieftin. Aceasta este eficient din punct de vedere al resurselor de calcul. De asemenea, această abordare ne permite să utilizăm de patru ori mai puține mașini pentru o încărcare comparabilă cu o rețea socială prietenoasă nouă.
Această eficiență în utilizarea resurselor de calcul ar trebui să asigure și eficiența economică, având în vedere presupunerea că cele mai scumpe sunt serverele. O perioadă lungă de timp, cel mai scump a fost în mod cert hardware-ul, iar noi am investit mult în reducerea costului hardware-ului, inventând algoritmi pentru asigurarea rezilienței în fața erorilor pentru a reduce cerințele de fiabilitate a echipamentului. Și astăzi am ajuns la un stadiu în care prețul serverului nu mai este determinant. Dacă nu luăm în considerare cele mai recente exotisme, configurația specifică a serverelor în rack nu mai contează. Acum ne confruntăm cu o altă problemă - costul locului ocupat de server în data center, adică locul din rack.
Realizând că este așa, am decis să calculăm cât de eficient utilizăm rack-urile.
Am preluat prețul celui mai puternic server din categoria economică, am calculat câte astfel de servere putem amplasa în rack-uri, ce sarcini am putea rula pe acestea conform vechii metode „un server = o sarcină” și cât de eficient ar putea fi utilizat echipamentul. Am calculat și am rămas surprinși. S-a dovedit că eficiența utilizării rack-urilor este de aproximativ 11%. Concluzia este evidentă: trebuie să creștem eficiența utilizării centrelor de date. Ar părea că soluția este simplă: trebuie să rulăm mai multe sarcini pe un singur server. Însă aici apar dificultățile.
Configurarea în masă devine rapid mult mai complicată — acum nu mai este posibil să alocăm un anumit grup unui server. Deoarece pe un singur server pot rula mai multe sarcini ale echipelor diferite. În plus, configurația poate fi conflictuală pentru diferite aplicații. Diagnosticarea devine de asemenea mai dificilă: dacă observați un consum crescut de CPU sau de discuri pe server, nu știți care dintre sarcini cauzează probleme.
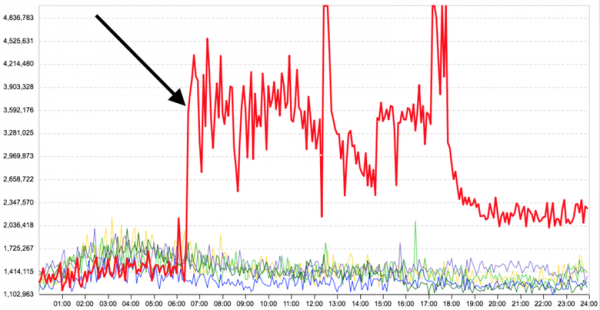
Dar cel mai important este că între sarcinile rulate pe aceeași mașină nu există izolare. De exemplu, graficul timpului mediu de răspuns al unei sarcini server după ce pe același server a fost lansată o altă aplicație de calcul complet necorespunzătoare primei — timpul de răspuns pentru sarcina principală a crescut semnificativ.
Este evident că trebuie să rulăm sarcinile fie în containere, fie în mașini virtuale. Deoarece practic toate sarcinile noastre rulează sub un singur sistem de operare (Linux) sau sunt adaptate pentru acesta, nu avem nevoie să menținem o multitudine de sisteme de operare diferite. Prin urmare, virtualizarea nu este necesară, iar din cauza costurilor suplimentare, va fi mai puțin eficientă decât containerizarea.
Ca implementare a containerelor pentru a rula sarcini direct pe serverele Docker este un candidat destul de bun: imaginile sistemelor de fișiere rezolvă bine problemele cu configurațiile conflictuale. Faptul că imaginile pot fi compuse din mai multe straturi ne permite să reducem semnificativ volumul de date necesar pentru desfășurarea lor pe infrastructură, dedicând părțile comune unor straturi de bază separate. Astfel, straturile de bază (și cele mai voluminoase) vor fi rapid cache-uite pe întreaga infrastructură, iar pentru livrarea unui număr mare de tipuri diferite de aplicații și versiuni va fi necesar să transferăm doar straturi mici.
În plus, registrul pregătit și etichetarea imaginilor în Docker ne oferă primitive gata făcute pentru versionarea și livrarea codului în producție.
Docker, ca orice altă tehnologie similară, ne oferă un anumit nivel de izolare a containerelor din cutie. De exemplu, izolarea pe memorie — fiecărui container i se atribuie o limită pentru utilizarea memoriei mașinii, dincolo de care nu va consuma. De asemenea, este posibil să se izoleze containerele în funcție de utilizarea CPU. Cu toate acestea, pentru noi, izolația standard a fost insuficientă. Dar despre asta - mai jos.
Lansarea directă a containerelor pe servere este doar o parte a problemelor. Cealaltă parte este legată de plasarea containerelor pe servere. Trebuie să înțelegem ce container poate fi plasat pe ce server. Acesta nu este o sarcină atât de simplă, deoarece containerele trebuie să fie plasate pe servere cât mai dens, fără a reduce viteza lor de funcționare. O astfel de plasare poate fi complexă și din perspectiva rezilienței. Adesea dorim să plasăm replicile aceluiași serviciu în rackuri diferite sau chiar în săli diferite ale centrului de date, astfel încât, în caz de defecțiune a unui rack sau a unei săli, să nu pierdem toate replicile serviciului.
Distribuirea manuală a containerelor nu este o variantă, când ai 8.000 de servere și între 8.000 și 16.000 de containere.
În plus, am vrut să oferim dezvoltatorilor mai multă autonomie în distribuirea resurselor, astfel încât să poată plasa singuri serviciile lor în producție, fără ajutorul unui administrator. În același timp, am dorit să păstrăm controlul, astfel încât un serviciu secundar să nu consume toate resursele centrelor noastre de date.
Este evident că este nevoie de un strat de management care să se ocupe de acest lucru în mod automat.
Iată că am ajuns la o imagine simplă și clară, pe care o adoră toți arhitecții: trei pătrățele.
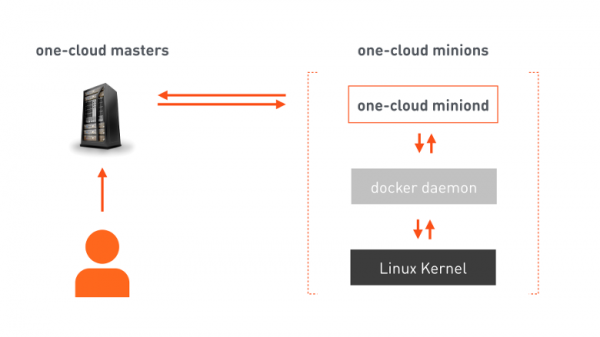
one-cloud masters — un cluster tolerant la erori, responsabil pentru orchestruirea norului. Dezvoltatorul trimite în master un manifest care conține toate informațiile necesare pentru găzduirea serviciului. Masterul, pe baza acestuia, dă comenzi miniunilor selectate (mașini destinate rulării containerelor). Pe miniuni se află agentul nostru, care primește comanda, dă propriile sale comenzi Docker, iar Docker configurează kernel-ul linux pentru a rula containerul corespunzător. Pe lângă executarea comenzilor, agentul comunică continuu masterului despre schimbările de stare atât ale mașinii-minion, cât și ale containerelor rulate pe aceasta.
Distribuția resurselor
Și acum să ne ocupăm de sarcina unei distribuții mai complexe a resurselor pentru mai multe miniuni.
Resursa de calcul în one-cloud este
- Puterea de procesare a procesorului consumată de o sarcină specifică.
- Volumul de memorie disponibil pentru sarcină.
- Traficul de rețea. Fiecare dintre miniuni are o interfață de rețea specifică cu o lățime de bandă limitată, așa că nu putem distribui sarcini fără a ține cont de volumul de date transmise prin rețea.
- Discuri. Pe lângă, evident, spațiul necesar datelor sarcinii, de asemenea, alocăm tipul de disc: HDD sau SSD. Discurile pot deservi un număr finit de cereri pe secundă — IOPS. Prin urmare, pentru sarcinile care generează mai multe IOPS decât poate deservi un singur disc, alocăm și „spindle-uri” — adică dispozitive de disc care trebuie rezervate exclusiv pentru sarcină.
Așadar, pentru un serviciu anume, precum user-cache, putem nota resursele consumate într-un mod similar: 400 de nuclee de procesor, 2,5 Tb de memorie, 50 Gbit/s de trafic în ambele direcții, 6 Tb de spațiu pe HDD, găzduit pe 100 de spindle-uri. Sau într-o formă mai familiară pentru noi:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Resursele serviciului user-cache consumă doar o parte din toate resursele disponibile în infrastructura de producție. Prin urmare, ne dorim să facem astfel încât, dintr-o eroare a operatorului sau nu, user-cache să nu consume mai multe resurse decât i s-au alocat. Cu alte cuvinte, trebuie să limităm resursele. Dar la ce am putea lega cota?
Să ne întoarcem la schema noastră foarte simplificată de interacțiune a componentelor și să o redesenăm cu mai multe detalii — așa:
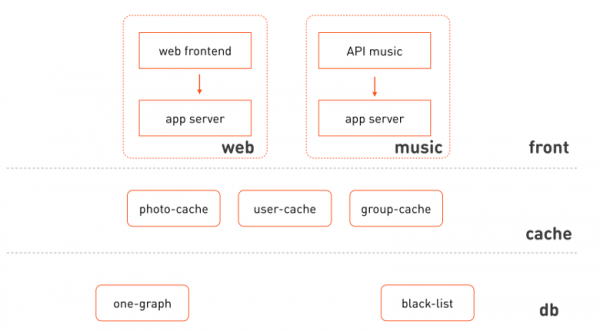
Ce atrage atenția:
- Frontend-ul web și muzica folosesc clustere izolate ale aceluiași server de aplicații.
- Se pot evidenția straturile logice, la care aparțin aceste clustere: fronturi, cache-uri, strat de stocare și gestionare a datelor.
- Frontend-ul nu este omogen, ci reprezintă diferite subsisteme funcționale.
- Cache-urile pot fi de asemenea distribuite în cadrul subsistemului ale cărui date le cache-uiesc.
Încă o dată, să redesenăm imaginea:
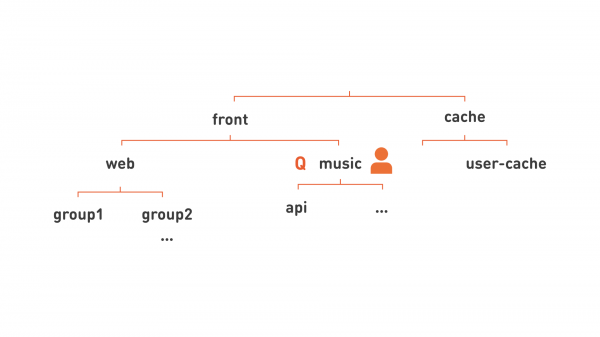
Wow! Vedem o ierarhie! Asta înseamnă că putem distribui resursele în bucăți mai mari: să desemnăm un dezvoltator responsabil pentru un nod al acestei ierarhii, corespunzător subsistemului funcțional (precum „music” în imagine), și să legăm o cotă la acest nivel al ierarhiei. O astfel de ierarhie ne permite, de asemenea, să organizăm mai flexibil serviciile pentru o gestionare mai comodă. De exemplu, toate web, deoarece este un grup foarte mare de servere, le împărțim în câteva grupuri mai mici, reprezentate în imagine ca group1, group2.
Eliminând liniile inutile, putem scrie fiecare nod al imaginii noastre într-o formă mai plată: group1.web.front, api.music.front, user-cache.cache.
Astfel, ajungem la conceptul de «coada ierarhică». Aceasta are un nume, cum ar fi «group1.web.front». Se alocă o cotă de resurse și drepturi utilizatorilor. O persoană din DevOps va primi drepturi de a trimite serviciul în coadă, iar acest angajat poate activa ceva în coadă, iar unei persoane din OpsDev i se vor da drepturi administrative, și acum poate gestiona coada, poate desemna oameni acolo, le poate oferi drepturi etc. Serviciile activată în această coadă vor fi executate în cadrul cotei cozii. Dacă cota de calcul a cozii este insuficientă pentru a executa simultan toate serviciile, atunci acestea vor fi executate secvențial, formând astfel propriuzis coada.
Să analizăm serviciile în detaliu. Fiecare serviciu are un nume complet, care include întotdeauna numele cozii. Atunci serviciul frontului web va avea numele ok-web.group1.web.front. Iar serviciul serverului de aplicații, la care se adresează, se va numi ok-app.group1.web.front. Fiecare serviciu are un manifest care specifică toate informațiile necesare pentru desfășurarea pe mașini specifice: câte resurse consumă această sarcină, ce configurație îi este necesară, câte replici trebuie să existe, proprietățile pentru gestionarea defecțiunilor acestui serviciu. Și după desfășurarea serviciului direct pe mașini, apar instanțele acestuia. Acestea sunt, de asemenea, denumite în mod univoc — ca numărul instanței și numele serviciului: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Este foarte convenabil: uitându-ne doar la numele containerului pornit, putem afla imediat multe informații.
Acum să ne familiarizăm mai bine cu ceea ce fac de fapt aceste instanțe: cu sarcinile.
Clase de izolare a sarcinilor
Toate sarcinile din OK (și probabil și în altă parte) pot fi împărțite în grupuri:
- Sarcini cu întârziere scurtă — prod. Pentru astfel de sarcini și servicii, întârzierea răspunsului (latency) este foarte importantă, cât de repede va fi procesat fiecare dintre cereri de către sistem. Exemple de sarcini: fronturi web, cache-uri, servere de aplicații, stocări OLTP etc.
- Sarcini de calcul — batch. Aici, viteza de procesare a fiecărei cereri specifice nu este esențială. Ceea ce contează este câte calcule totale va efectua această sarcină într-un anumit (mare) interval de timp (throughput). Astfel vor fi sarcinile de tip MapReduce, Hadoop, învățare automată, statistică.
- Sarcini de fundal — idle. Pentru astfel de sarcini, nici latency, nici throughput nu sunt foarte importante. Aici intră diverse teste, migrații, recalculări, conversii de date dintr-un format în altul. Pe de o parte, seamănă cu cele de calcul, pe de altă parte — nu ne interesează foarte mult cât de repede se finalizează.
Să ne uităm cum consumă astfel de sarcini resursele, de exemplu, ale procesorului central.
Sarcini cu întârziere scurtă. Astfel de sarcini vor avea un model de consum al CPU similar cu acesta:
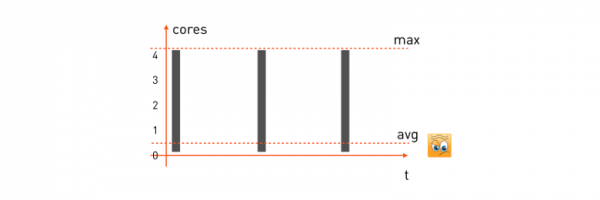
Un cerere de la utilizator este procesată, sarcina începe să folosească toate nucleele CPU disponibile, se finalizează, returnează un răspuns, așteaptă următoarea cerere și stă. A sosit următoarea cerere — din nou folosește tot ce a fost, se calculează, așteptăm următoarea.
Pentru a garanta o întârziere minimă pentru această sarcină, trebuie să luăm maximul resurselor consumate de ea și să rezervăm numărul necesar de nuclee pe minion (mașina care va efectua sarcina). Atunci formula de rezervare pentru sarcina noastră va fi următoarea:
alloc: cpu = 4 (max)Și dacă avem o mașină-minion cu 16 nuclee, putem rula exact patru astfel de sarcini pe ea. Este important de menționat că consumul mediu al procesorului pentru astfel de sarcini este adesea foarte scăzut — ceea ce este evident, deoarece o mare parte din timp sarcina este în așteptarea unei cereri și nu face nimic.
Sarcini de calcul. Acestea vor avea un model ceva diferit:
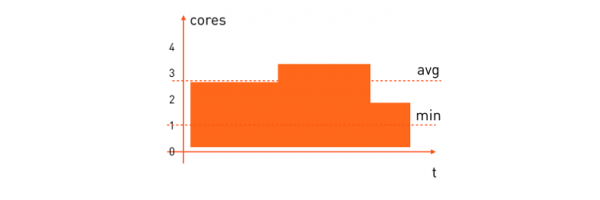
Consumului mediu de resurse ale procesorului pentru astfel de sarcini este destul de ridicat. De multe ori, dorim ca o sarcină de calcul să fie finalizată într-un anumit interval de timp, așa că trebuie să rezervăm un număr minim de procesoare de care are nevoie, astfel încât întreaga calculare să se încheie într-un timp rezonabil. Formula de rezervare va arăta astfel:
alloc: cpu = [1,* )«Te rog, plasează-l pe minion acolo unde există cel puțin un nucleu liber, iar restul — să consume tot ce este disponibil».
Aici, eficiența utilizării este semnificativ mai bună decât în cazul sarcinilor cu întârziere scurtă. Însă câștigul va fi mult mai mare dacă combinăm ambele tipuri de sarcini pe aceeași mașină-minion și distribuim resursele acesteia pe parcurs. Atunci când o sarcină cu întârziere scurtă are nevoie de procesor — îl primește imediat, iar când resursele nu mai sunt necesare — acestea sunt transferate sarcinii de calcul, adică cam așa:
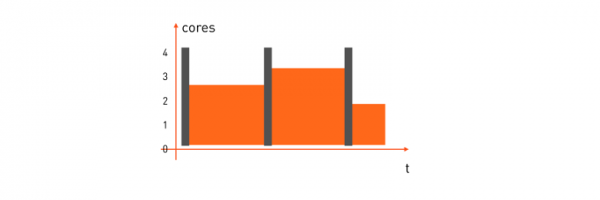
Dar cum să faci asta?
Mai întâi, să ne ocupăm de prod și de alloc: cpu = 4. Trebuie să rezervăm patru nuclee. În Docker run, acest lucru se poate face în două moduri:
- Prin opțiunea
--cpuset=1-4, adică să alocăm sarcinii patru nuclee specifice pe mașină. - Utilizați
--cpuquota=400_000 --cpuperiod=100_000, să stabilim o cotă de timp de procesor, adică să indicăm că fiecare 100 ms de timp real, sarcina consumă nu mai mult de 400 ms de timp de procesor. Rezultatul sunt aceleași patru nuclee.
Dar care dintre aceste metode este potrivită?
Aspectul cpuset este destul de atrăgător. Sarcina are patru nuclee dedicate, ceea ce înseamnă că cache-urile procesorului vor funcționa la capacitate maximă. Există și o latură negativă: ar trebui să ne asumăm sarcina de a distribui calculele pe nuclee neîncărcate ale mașinii în locul sistemului de operare, și aceasta este o sarcină destul de neobișnuită, mai ales dacă încercăm să plasăm pe o astfel de mașină sarcini batch. Testele au arătat că varianta cu cota este mai potrivită: astfel, sistemul de operare are mai multă libertate în alegerea nucleului pentru executarea sarcinii în acel moment, iar timpul procesorului este distribuit mai eficient.
Să înțelegem cum să facem rezervări în docker pentru numărul minim de nuclee. Cota pentru sarcinile batch nu mai este aplicabilă, deoarece nu este nevoie să se limiteze maximul, este suficient să se asigure un minim. În acest caz, opțiunea este potrivită docker run --cpushares.
Am convenit că dacă batch-ul necesită o garanție minimă pe un nucleu, atunci vom specifica --cpushares=1024, iar dacă minimul este pe două nuclee, atunci specificăm --cpushares=2048. Cpu shares nu interferează în distribuția timpului procesorului atâta timp cât există suficient. Astfel, dacă prod nu utilizează în acel moment toate cele patru nuclee — nu există nimic care să limiteze sarcinile batch și acestea pot utiliza timp suplimentar de procesor. Însă, în situația în care există o lipsă de procesor, dacă prod a consumat toate cele patru nuclee și a atins cota — timpul rămas de procesor va fi împărțit proporțional cu cpushares, adică, în cazul a trei nuclee libere, una va primi sarcina cu 1024 cpushares, iar celelalte două — sarcina cu 2048 cpushares.
Dar utilizarea quota și shares nu este suficientă. Trebuie să ne asigurăm că sarcina cu întârziere scurtă primește prioritate față de sarcina batch în distribuția timpului procesorului. Fără o astfel de prioritizare, sarcina batch va acapara tot timpul de procesor în momentul în care este necesar prod. În Docker run nu există opțiuni de prioritizare a containerelor, dar politicile de planificare a procesorului în Linux vin în ajutor. Despre acestea se poate citi în detaliu , iar în cadrul acestui articol vom trece prin ele pe scurt:
- SCHED_OTHER
În mod implicit, toate procesele utilizatorilor obișnuiți de pe o mașină Linux primesc această politică. - SCHED_BATCH
Destinat pentru procese care consumă multe resurse. Atunci când o sarcină este plasată în procesor, se introduce așa-numita penalizare de activare: o astfel de sarcină are șanse mai mici de a obține resursele procesorului dacă acesta este momentan utilizat de o sarcină cu SCHED_OTHER - SCHED_IDLE
Un proces de fundal cu o prioritate foarte scăzută, chiar mai mică decât nice –19. Folosim biblioteca noastră cu cod sursă deschis , pentru a stabili politica necesară la pornirea containerului prin apelul
one.nio.os.Proc.sched_setscheduler(pid, Proc.SCHED_IDLE)Dar chiar dacă nu programezi în Java, același lucru se poate face cu comanda chrt:
chrt -i 0 $pidSă adunăm toate nivelurile noastre de izolare într-un tabel pentru claritate:
Clasa de izolare
Exemplu alloc
Opțiuni Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Dacă faci chrt din interiorul containerului, poate fi necesar să ai capability sys_nice, deoarece implicit Docker elimină această capacitate la pornirea containerului.
Dar sarcinile consumă nu numai procesor, ci și trafic, care afectează și mai mult întârzierea sarcinii de rețea decât o distribuție greșită a resurselor procesorului. De aceea, dorim, în mod natural, să obținem o imagine exactă și pentru trafic. Adică, atunci când sarcina prod trimite pachete în rețea, limităm viteza maximă (formula alloc: lan=[*,500mbps) ), cu care prod poate face acest lucru. Iar pentru batch garantăm doar lățimea de bandă minimă, dar nu limităm maxima (formula alloc: lan=[10Mbps,*) ) În acest timp, traficul prod ar trebui să aibă prioritate față de sarcinile batch.
Aici Docker nu are nicio primitivă pe care am putea-o folosi. Dar ne vine în ajutor . Am reușit să obținem rezultatul dorit cu ajutorul disciplinei . Cu ajutorul acesteia, alocăm două clase de trafic: prod de înaltă prioritate și batch/idle de prioritate scăzută. În cele din urmă, configurația pentru traficul ieșitor devine astfel:
aici 1:0 — „qdisc-ul rădăcină” al disciplinei hsfc; 1:1 — clasa secundară hsfc cu o limită comună de lățime de BANDĂ de 8 Gbit/s, sub care sunt plasate clasele secundare ale tuturor containerelor; 1:2 — clasa secundară hsfc comună pentru toate sarcinile batch și idle cu o limită „dinamică”, despre care mai jos. Celelalte clase secundare hsfc sunt clase dedicate pentru containerele prod active, cu limite conform manifestelor lor — 450 și 400 Mbit/s. Fiecărei clase hsfc i se alocă o coadă qdisc fq sau fq_codel, în funcție de versiunea kernel-ului linux, pentru a evita pierderile de pachete în timpul vârfurilor de trafic.
De obicei, disciplinele tc sunt folosite pentru a prioritiza doar traficul de ieșire. Dar dorim să prioritizăm și traficul de intrare, pentru că o sarcină batch ar putea ocupa tot canalul de intrare, primind, de exemplu, un pachet mare de date de intrare pentru map&reduce. Pentru aceasta, folosim modulul , care crea un interfăț ifbX virtual pentru fiecare interfață de rețea și redirecționează traficul de intrare de pe interfață în ieșire pe ifbX. Apoi, pentru ifbX funcționează toate aceleași discipline pentru controlul traficului de ieșire, pentru care configurația hsfc va fi foarte asemănătoare:
În timpul experimentelor, am descoperit că cele mai bune rezultate hsfc se obțin atunci când clasa 1:2 a traficului batch/idle neprioritar este limitată pe mașinile-minion la o lățime liberă de bandă. În caz contrar, traficul neprioritar influențează prea mult întârzierea sarcinilor prod. Valoarea curentă a lățimii de bandă liberă este determinată de miniond în fiecare secundă, măsurând consumul mediu de trafic de către toate sarcinile prod ale acestui minion  și scăzând-o din lățimea de bandă a interfeței de rețea
 cu un mic rezervă, adică.

Lățimile sunt definite pentru traficul de intrare și de ieșire independent. Și conform noilor valori miniond reconfigurează limita clasei neprioritare 1:2.
Astfel, am implementat toate cele trei clase de izolare: prod, batch și idle. Aceste clase influențează semnificativ performanțele execuției sarcinilor. De aceea, am decis să plasăm acest atribut sus în ierarhie, pentru a fi evident din numele cozii ierarhice cu ce ne confruntăm:
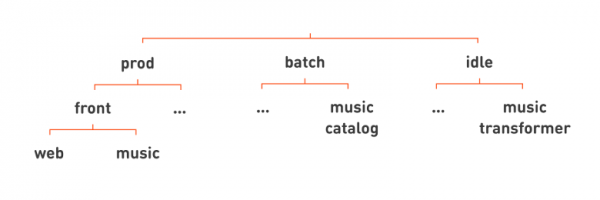
Toate fronturi cunoscute web și music ocupați apoi ierarhiile sub prod. De exemplu, sub batch să plasăm serviciul catalog muzical, care periodic creează un catalog de melodii dintr-un set de fișiere mp3 încărcate în «Одноклассники». Un exemplu de serviciu pentru idle poate fi transformator de muzică, care normalizează nivelul de volum al muzicii.
Îndepărtând din nou liniile inutile, putem scrie numele serviciilor noastre mai simplu, adăugând clasa de izolare a sarcinii la sfârșitul numelui complet al serviciului: web.front.prod, catalog.music.batch, transformer.music.idle.
Și acum, privind la numele serviciului, înțelegem nu doar ce funcție îndeplinește, ci și clasa de izolare a acestuia, iar asta înseamnă criticitatea sa etc.
Totul este minunat, dar există o adevărată amărăciune. Este imposibil să izolăm complet sarcinile care rulează pe aceeași mașină.
Ce am reușit să obținem: dacă batch consumă intens doar resursele procesorului, planificatorul încorporat al CPU-ului Linux își face foarte bine treaba, iar influența asupra sarcinii prod este practic inexistentă. Dar dacă această sarcină batch începe să lucreze activ cu memoria, atunci influența reciprocă devine evidentă. Acest lucru se întâmplă deoarece sarcina prod 'scoate' cache-urile procesorului din memorie — în rezultatul acesta cresc ratele de eșec în cache, iar procesorul procesează sarcina prod mai lent. O astfel de sarcină batch poate crește întârzierile containerului nostru tipic prod cu 10%.
Este și mai complicat să izolăm traficul din cauza că modernii cipuri de rețea au o coadă internă de pachete. Dacă un pachet din sarcina batch a intrat primul acolo, înseamnă că va fi transmis primul prin cablu, și nu avem ce face în legătură cu asta.
În plus, deocamdată am reușit să rezolvăm doar problema prioritizării traficului TCP: pentru UDP, abordarea cu hsfc nu funcționează. Și chiar și în cazul traficului TCP, dacă sarcina batch generează mult trafic, acest lucru aduce de asemenea o creștere de aproximativ 10% a întârzierii sarcinii prod.
Redundanță
Unul dintre obiectivele în dezvoltarea one-cloud a fost îmbunătățirea rezistenței la defecțiuni pentru Одноклассники. Prin urmare, aș dori să analizez mai detaliat posibilele scenarii de defecțiuni și accidente. Să începem cu un scenariu simplu — cu defecțiunea unui container.
Un container poate eșua în mai multe moduri. Poate fi vorba despre un experiment, un bug sau o eroare în manifest, ceea ce determină o sarcină de producție să consume mai multe resurse decât cele specificate în manifest. Am avut un caz: un dezvoltator a implementat un algoritm complex, l-a refăcut de mai multe ori, s-a complicat atât de mult încât, în cele din urmă, sarcina s-a blocat într-un ciclu destul de complex. Și, având în vedere că sarcina de producție are prioritate mai mare decât toate celelalte pe aceleași minioane, a început să consume toate resursele disponibile ale procesorului. În această situație, izolarea a salvat situația, mai exact cota pe timpul CPU. Dacă sarcinii i se alocă o cotă, aceasta nu va consuma mai mult. Prin urmare, toate sarcinile batch și celelalte sarcini de producție care funcționau pe aceeași mașină nu au observat nimic.
A doua problemă posibilă este prăbușirea containerului. Și aici ne ajută politicile de restart, pe care toată lumea le cunoaște; Docker se descurcă perfect. Practic, toate sarcinile de producție au o politică de restart 'always'. Uneori folosim 'on_failure' pentru sarcinile batch sau pentru depanarea containerelor de producție.
Ce putem face în cazul în care un întreg minion devine inaccesibil?
Evident, putem rula containerul pe o altă mașină. Ceea ce este interesant aici este ce se întâmplă cu adresa IP (adreselor) atribuite containerului.
Putem atribui containerelor aceleași adrese IP ca cele ale mașinilor-minion pe care aceste containere sunt rulate. Așadar, la pornirea unui container pe o altă mașină, adresa sa IP se schimbă și toți clienții trebuie să înțeleagă că containerul s-a mutat, iar acum trebuie să acceseze o altă adresă, ceea ce necesită un serviciu de Service Discovery separat.
Service Discovery este convenabil. Pe piață există multe soluții de diferite grade de fiabilitate pentru organizarea unui registru de servicii. Adesea, în astfel de soluții se implementează logica unui balancer de sarcină, stocarea unei configurații suplimentare sub formă de KV-storage etc.
Cu toate acestea, ne-ar plăcea să putem evita necesitatea introducerii unui registru separat, deoarece aceasta ar însemna introducerea unui sistem critic utilizat de toate serviciile în mediu de producție. Asta înseamnă că ar fi un punct potențial de eșec și trebuie să alegem sau să dezvoltăm o soluție foarte fiabilă, ceea ce, evident, nu este deloc simplu, durează mult și costă mult.
Și o altă mare problemă: pentru ca infrastructura noastră veche să funcționeze cu cea nouă, ar trebui să rescriem absolut toate sarcinile pentru a utiliza un sistem de Service Discovery. Este un volum de muncă FOARTE mare, iar uneori devine imposibil, mai ales când vine vorba de dispozitive la nivel de kernel sau care interacționează direct cu hardware-ul. Implementarea acestei funcționalități prin tiparele consacrate de soluții, cum ar fi ar însemna uneori o încărcare suplimentară, alteori — o complicare a exploatării și scenarii suplimentare de eșec. Nu ne-am dorit să complicăm lucrurile, așa că am decis să facem utilizarea Service Discovery opțională.
În one-cloud, IP-ul urmărește containerul, adică fiecare instanță a sarcinii are propria adresă IP. Această adresă este „statică”: ea este alocată fiecărei instanțe în momentul primei trimitere a serviciului în cloud. Dacă pe parcursul vieții serviciului a existat un număr variabil de instanțe, atunci în final va fi alocată atât de multe adrese IP câte instanțe au fost maximum existente.
Ulterior, aceste adrese nu se modifică: sunt alocate o singură dată și continuă să existe pe toată durata de viață a serviciului în producție. Adresele IP urmăresc containerele prin rețea. Dacă un container este mutat pe alt minion, atunci și adresa îl va urma.
Astfel, asocierea numelui serviciului cu lista adreselor sale IP se schimbă foarte rar. Dacă privim din nou la numele instanțelor serviciului pe care le-am menționat la începutul articolului (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), atunci ne putem da seama că acestea seamănă cu FQDN-urile utilizate în DNS. Și da, pentru a afișa numele instanțelor serviciilor în adresele lor IP, folosim protocolul DNS. Acest DNS returnează toate adresele IP rezervate ale tuturor containerelor — atât cele active, cât și cele oprite (de exemplu, dacă folosim trei replici, dar avem cinci adrese rezervate — toate cele cinci vor fi returnate). Clienții, primind aceste informații, vor încerca să se conecteze la toate cele cinci replici — și astfel vor identifica care dintre ele sunt active. Această metodă de determinare a disponibilității este semnificativ mai fiabilă, neimplicând nici DNS, nici Service Discovery, astfel încât nu există probleme greu de rezolvat cu menținerea actualizată a informațiilor și a rezilienței acestor sisteme. Mai mult, în cazul serviciilor critice, de la care depinde funcționarea întregului portal, putem să nu folosim deloc DNS, ci pur și simplu să introducem adresele IP în configurație.
Implementarea unei astfel de migrații a IP-urilor între containere poate fi non-trivială — și ne vom opri asupra modului în care funcționează, pe următorul exemplu:
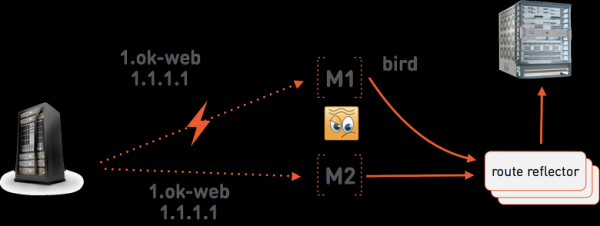
Să presupunem că masterul one-cloud dă comanda minionului M1 să pornească 1.ok-web.group1.web.front.prod cu adresa 1.1.1.1. Pe minion funcționează , care anunță această adresă în serverele speciale . Acestea au o sesiune BGP cu echipamentul de rețea, în care se transmite ruta adresei 1.1.1.1 la M1. M1 rotează pachetele în interiorul containerului folosind instrumentele Linux. Există trei servere route reflector, deoarece aceasta este o parte foarte critică a infrastructurii one-cloud — fără ele, rețeaua în one-cloud nu va funcționa. Le plasăm în rackuri diferite, dacă este posibil în săli diferite ale centrului de date, pentru a reduce probabilitatea unei defecțiuni simultane a tuturor celor trei.
Acum să presupunem că legătura între masterul one-cloud și minionul M1 a dispărut. Masterul one-cloud va acționa acum, presupunând că M1 a eșuat complet. Adică va da comanda minionului M2 să pornească web.group1.web.front.prod cu aceeași adresă 1.1.1.1. Acum avem două rute conflictuale în rețea pentru 1.1.1.1: pe M1 și pe M2. Pentru a rezolva astfel de conflicte, folosim Multi Exit Discriminator, care este specificat în anunțul BGP. Acest număr arată greutatea rutei anunțate. Din cele conflictuale, va fi aleasă ruta cu valoarea MED mai mică. Masterul one-cloud suportă MED ca parte integrantă a adreselor IP ale containerelor. Adresa este emisă pentru prima dată cu un MED suficient de mare = 1.000.000. În situația unei astfel de mutări de urgență a containerului, masterul reduce MED-ul, iar M2 va primi comanda de a anunța adresa 1.1.1.1 cu MED = 999.999. Instanța care funcționează pe M1 va rămâne fără conexiune, iar soarta sa ulterioară nu ne interesează prea mult până la restabilirea conexiunii cu masterul, când va fi oprit ca un dublu vechi.
Avarii
Toate sistemele de management al datacentrelor gestionează întotdeauna acceptabil eșecurile minore. Căderea unui container este o normă aproape peste tot.
Să analizăm cum gestionăm o avarie, de exemplu o întrerupere a alimentării în una sau mai multe încăperi ale datacenter-ului.
Ce înseamnă o avarie pentru sistemul de management al datacenter-ului? În primul rând, este o defalcare masivă a multor mașini în același timp, iar sistemul de management trebuie să migreze simultan un număr mare de containere. Dar dacă avaria este foarte extinsă, este posibil ca toate sarcinile să nu poată fi relocuite pe alte mașini, deoarece capacitatea resurselor a datacenter-ului scade sub 100% din sarcină.
Adesea, avariile sunt precedate de o defalcare a stratului de control. Acest lucru se poate întâmpla din cauza defectării echipamentului său, dar mai frecvent din cauza faptului că avariile nu sunt testate, iar stratul de control se prăbușește din cauza încărcărilor crescute.
Ce se poate face cu toate acestea?
Migrațiile în masă înseamnă că în infrastructură apar multe acțiuni, migrații și plasamente. Fiecare migrație poate dura un timp necesar pentru livrarea și desfășurarea imaginilor containerelor pe mașini, lansarea și inițializarea containerelor etc. Prin urmare, este de dorit ca sarcinile mai importante să fie lansate înaintea celor mai puțin importante.
Să privim din nou la ierarhia de servicii pe care o cunoaștem și să încercăm să decidăm ce sarcini dorim să lansăm în primul rând.
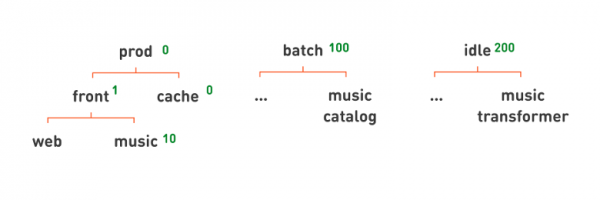
Desigur, acestea sunt procesele care participă direct la procesarea cererilor utilizatorilor, adică prod. Acest lucru este specificat prin prioritatea plasării — un număr care poate fi atribuit unei cozi. Dacă o coadă are o prioritate mai mare, serviciile sale sunt plasate cu prioritate.
Pe prod, atribuim priorități mai mari, 0; pe batch — puțin mai mici, 100; pe idle — chiar și mai mici, 200. Prioritățile se aplică ierarhic. Toate sarcinile de sub ierarhie vor avea prioritatea corespunzătoare. Dacă dorim ca în interiorul prod să fie active cache-urile înaintea frontend-urilor, atunci atribuim prioritate cache-ului = 0 și frontend-urilor subordonate = 1. De exemplu, dacă dorim ca portalul principal să pornească înaintea frontend-ului muzical, putem atribui unei priorități mai mici pentru acesta — 10.
Următoarea problemă este lipsa de resurse. Așadar, am avut o defecțiune la un număr mare de echipamente, întregi săli de centre de date, iar noi am activat atât de multe servicii încât acum nu avem suficiente resurse. Trebuie să decidăm ce sarcini să sacrificăm pentru a avea funcționale serviciile principale critice.
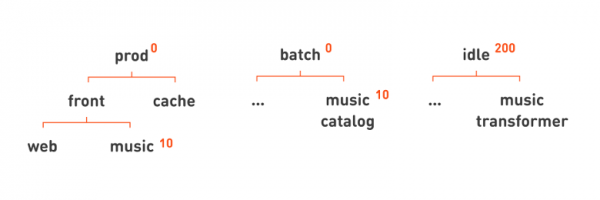
Spre deosebire de prioritatea plasării, nu putem sacrifica toată sarcinile batch; unele dintre ele sunt importante pentru funcționarea portalului. Prin urmare, am dedicat separat prioritatea de excludere sarcinii. Atunci când se plasează o sarcină cu prioritate mai mare, aceasta poate exclude, adică opri o sarcină cu prioritate mai mică, dacă nu există minioni disponibili. În acest caz, sarcina cu prioritate scăzută va rămâne probabil neplasată, adică nu va mai exista un minion potrivit cu suficiente resurse libere.
În ierarhia noastră, este foarte simplu să specificăm o prioritate de excludere astfel încât sarcinile prod și batch să excludă sau să oprească sarcinile idle, dar nu una pe cealaltă, specificând pentru idle o prioritate de 200. La fel ca în cazul priorității plasării, putem folosi ierarhia noastră pentru a descrie reguli mai complexe. De exemplu, specificăm că, pentru funcția de muzică, sacrificăm dacă ne lipsesc resursele pentru portalul web principal, stabilind pentru nodurile corespunzătoare o prioritate mai mică: 10.
Accidente ale DC-ului în întregime
De ce poate eșua întregul centru de date? Forța naturii. A fost un articol bun despre cum . Oamenii fără adăpost pot fi considerați o forță a naturii, având în vedere că au ars odată fibra optică într-un canal și centrul de date a pierdut complet legătura cu celelalte locații. Cauza defecțiunii poate fi și factorul uman: un operator poate da o comandă astfel încât întregul centru de date să se prăbușească. Acest lucru se poate întâmpla din cauza unui bug major. În general, centrele de date se prăbușesc — nu este ceva rar. La noi se întâmplă o dată la câteva luni.
Și iată ce facem pentru ca nimeni să nu posteze în #okjivi pe Twitter.
Prima strategie — izolare. Fiecare instanță one-cloud este izolată și poate gestiona mașinile doar dintr-un singur centru de date. Asta înseamnă că pierderea unui nor din cauza bug-urilor sau a unei comenzi greșite a operatorului — este pierderea doar unui centru de date. Suntem pregătiți pentru asta: avem o politică de rezervare, conform căreia replicile aplicației și ale datelor sunt plasate în toate centrele de date. Folosim baze de date rezistente la defectiuni și testăm periodic aceste defecte.
Deoarece astăzi avem patru centre de date, avem și patru instanțe separate, complet izolate de one-cloud.
Această abordare nu doar că protejează împotriva defecțiunilor fizice, dar poate proteja și împotriva erorilor operatorului.
Ce altceva mai putem face cu factorul uman? Atunci când un operator dă o comandă ciudată sau potențial periculoasă norului, acesta poate fi solicitat brusc să rezolve o mică sarcină pentru a verifica cât de bine s-a gândit la asta. De exemplu, dacă este o oprire masivă a multor replici sau pur și simplu o comandă ciudată — reducerea numărului de replici sau schimbarea numelui imaginii, nu doar a numărului de versiune din noul manifest.
Concluzii
Caracteristicile distinctive ale one-cloud:
- Un sistem de denumire ierarhic și vizual pentru servicii și containere, care permite identificarea rapidă a sarcinii, a domeniului de aplicare și a funcționării acesteia, precum și a persoanei responsabile.
- Folosim tehnologia noastră de combinare a sarcinilor prod- și batch-pe minioni pentru a crește eficiența utilizării mașinilor. În loc de cpuset, folosim cote CPU, acțiuni, politici ale programatorului CPU și QoS Linux.
- Nu am reușit să izolăm complet containerele care rulează pe aceeași mașină, dar influența lor reciprocă rămâne în limite de până la 20%.
- Organizarea serviciilor într-o ierarhie ajută la eliminarea automată a accidentelor prin priorități de plasare și de înlăturare..
FAQ
De ce nu am adoptat o soluție gata făcută.
- Diferitele clase de izolare a task-urilor necesită o logică diferită pentru alocarea pe minioni. Dacă sarcinile prod pot fi alocate prin rezervarea simplă a resurselor, atunci batch și idle trebuie alocate urmărind utilizarea reală a resurselor pe mașinile minioni.
- Necesitatea de a considera resursele consumate de aceste sarcini, cum ar fi:
- lățimea de bandă a rețelei;
- tipurile și „spindelii” discurilor.
- Necesitatea de a specifica prioritățile serviciilor în cazul unor întreruperi, drepturile și cotele echipelor pentru resurse, ceea ce se rezolvă prin intermediul cozii ierarhice în one-cloud.
- Necesitatea de a avea denumiri umane pentru module pentru a reduce timpul de reacție la incidente și întreruperi.
- Imposibilitatea de a implementa simultan Service Discovery în întreaga rețea; necesitatea de a coexista o perioadă mai lungă cu sarcinile alocate pe servere fizice — ceea ce se rezolvă prin intermediul adreselor IP „statice” care urmează modulelor, și, ca urmare, necesitatea unei integrări unice cu o infrastructură de rețea mare.
Toate aceste funcții ar necesita modificări semnificative ale soluțiilor existente pentru a se potrivi nevoilor noastre, iar evaluând volumul de muncă, am realizat că putem dezvolta propria noastră soluție cu un efort similar. Dar soluția noastră va fi semnificativ mai ușor de exploatat și dezvoltat — nu conține abstracții inutile care să susțină funcționalități de care nu avem nevoie.
Celor care au citit ultimele rânduri — vă mulțumim pentru perseverență și atenție!
Sursa: habr.com
