

Introducere în sistemele de operare
Salut, Habr! Vreau să vă prezint o serie de articole-traduceri dintr-o literatură care mi se pare interesantă - OSTEP. Acest material examinează în mod profund funcționarea sistemelor de operare de tip unix, și anume - gestionarea proceselor, diferitele planificatoare, memorie și alte componente asemănătoare care formează un sistem de operare modern. Puteți vizualiza originalul tuturor materialelor aici . Vă rog să țineți cont că traducerea a fost efectuată neprofesional (destul de liber), dar sper că am păstrat sensul general.
Lucrările de laborator pentru această materie le puteți găsi aici:
Alte părți:
De asemenea, mă puteți urmări pe canalul meu de =)
Introducere în planificator
Problema esențială: Cum să dezvolți o politică de planificator
Cum ar trebui să fie dezvoltate cadrele de bază ale politicilor planificatorului? Care sunt presupunerile cheie? Ce metrici sunt importante? Ce tehnici fundamentale au fost folosite în sistemele de calcul timpurii?
Presupunerile privind sarcina de lucru
Înainte de a discuta politicile posibile, să facem câteva observații simplificatoare despre procesele rulate în sistem, care sunt denumite în ansamblu sarcina de lucru. Definind sarcina de lucru ca parte critică a dezvoltării politicilor și cu cât știi mai multe despre sarcină, cu atât mai bună va fi politica pe care o poți redacta.
Vom face următoarele presupuneri despre procesele rulate în sistem, denumite uneori tasks (sarcini). Practic, toate aceste presupuneri nu sunt realiste, dar sunt necesare pentru dezvoltarea ideii.
- Fiecare sarcină rulează un timp identic,
- Toate sarcinile sunt inițiate simultan,
- Sarcina inițiată rulează până la finalizarea sa,
- Toate sarcinile folosesc doar CPU,
- Timpul de execuție al fiecărei sarcini este cunoscut.
Metricile Planificatorului
Pe lângă unele presupuneri despre sarcină, este nevoie de un instrument de comparare a diferitelor politici de planificare: metricile planificatorului. O metrică este pur și simplu o măsură a ceva. Există un anumit număr de metrici care pot fi folosite pentru compararea planificatorilor.
Ca exemplu, vom folosi o metrică numită timp de rotație (turnaround time). Timpul de rotație al unei sarcini este definit ca diferența dintre timpul finalizării sarcinii și timpul la care sarcina a fost introdusă în sistem.
Tturnaround=Tfinalizare−Tintrare
Deoarece am presupus că toate sarcinile au fost introduse în același timp, atunci Ta=0 și astfel Tt=Tc. Această valoare se va schimba natural atunci când vom modifica presupunerile menționate anterior.
O altă metrică — fairness (fairness, echitate). Performanța și echitatea sunt adesea caracteristici opuse în planificare. De exemplu, un planificator poate optimiza performanța, dar în detrimentul așteptării inițierii altor sarcini, reducând astfel echitatea.
FIRST IN FIRST OUT (FIFO)
Cel mai de bază algoritm pe care îl putem implementa se numește FIFO sau first come (in), first served (out). Acest algoritm are câteva avantaje: este foarte simplu de implementat și se potrivește cu toate ipotezele noastre, realizând sarcina destul de bine.
Să luăm un exemplu simplu. Să presupunem că 3 sarcini au fost atribuite simultan. Dar să presupunem că sarcina A a sosit puțin mai devreme decât celelalte, așa că va apărea mai devreme în lista de execuție, la fel cum B se va afla relaționat cu V. Să presupunem că fiecare dintre ele va fi executată timp de 10 secunde. Care va fi astfel timpul mediu de execuție pentru aceste sarcini?
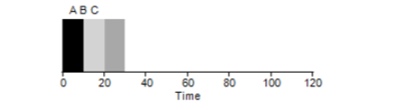
Calculând valorile — 10+20+30 și împărțind la 3, obținem un timp mediu de execuție al programului egal cu 20 de secunde.
Acum încercăm să ne schimbăm ipotezele. În special ipoteza 1, astfel încât să nu mai presupunem că fiecare sarcină are un timp de execuție egal. Cum se va comporta FIFO de data aceasta?
Se dovedește că timpii de execuție diferite ale sarcinilor au un impact extrem de negativ asupra productivității algoritmului FIFO. Să presupunem că sarcina A se va executa timp de 100 de secunde, în timp ce B și V vor continua să dureze câte 10 fiecare.
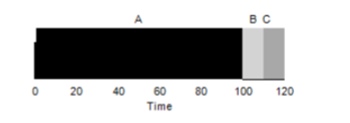
După cum se poate observa din diagramă, timpul mediu pentru sistem va fi (100+110+120)/3=110. Acest efect se numește efectul convoiului, atunci când anumiți consumatori de scurtă durată ai unei resurse vor sta în așteptare în spatele unui consumator greu. Este asemănător cu o coadă la magazinul alimentar, când înaintea ta se află un cumpărător cu un cărucior plin. Cea mai bună soluție pentru problemă este să încerci să schimbi casa de marcat sau să te relaxezi și să respiri adânc.
Shortest Job First
Se poate soluționa cumva o astfel de situație cu procese greoaie? Desigur. Un alt tip de planificare se numeșteShortest Job First (SJF). Algoritmul său este, de asemenea, destul de primitiv — după cum sugerează și numele, sarcinile cele mai scurte vor fi executate prima dată, una după alta.
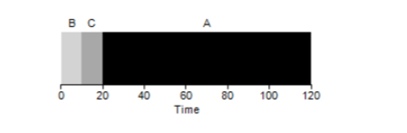
În acest exemplu, rezultatul executării acelorași procese va fi o îmbunătățire a timpului mediu de rotație a programelor, care va fi egal cu 50 în loc de 110, ceea ce este practic de 2 ori mai bine.
Astfel, conform presupunerii că toate sarcinile sosesc în același timp, algoritmul SJF pare a fi cel mai optim algoritm. Totuși, presupunerile noastre încă nu par realiste. De data aceasta, vom schimba presupunerea 2 și vom considera că sarcinile pot sosi în orice moment, nu toate simultan. Ce probleme poate cauza acest lucru?
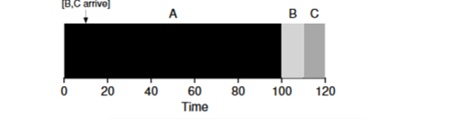
Să presupunem că sarcina A (100s) sosesc prima și începe să fie executată. La momentul t=10 sosesc sarcinile B și C, fiecare având o durată de 10 secunde. Astfel, timpul mediu de execuție este (100+(110-10)+(120-10))/3 = 103. Ce ar putea face programatorul pentru a îmbunătăți situația?
Shortest Time-to-Completion First (STCF)
Pentru a îmbunătăți situația, vom renunța la presupunerea 3 conform căreia programul este lansat și rulează până la final. De asemenea, vom avea nevoie de suport hardware și, după cum probabil ați ghicit, vom folosi un temporizator pentru a întrerupe sarcina în execuție și a schimba contexte. Astfel, programatorul poate întreprinde ceva în momentul sosirii sarcinilor B și C — să oprească execuția sarcinii A și să proceseze sarcinile B și C, iar după finalizarea acestora, să continue execuția procesului A. Acest tip de programator se numește STCFsau Preemptive Job First.
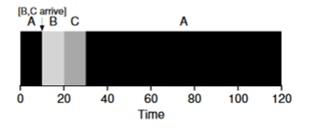
Rezultatul acestui programator va fi astfel: ((120-0)+(20-10)+(30-10))/3=50. Astfel, acest programator devine și mai optim pentru sarcinile noastre.
Metrica Timp de răspuns (Response Time)
Astfel, dacă știm timpul de execuție al sarcinilor și faptul că aceste sarcini folosesc doar CPU, STCF va fi cea mai bună soluție. Și în vremurile de mult uitate, aceste algoritmi au funcționat destul de bine. Totuși, acum utilizatorul își petrece cea mai mare parte a timpului la terminal și așteaptă interacțiuni interactive eficiente. Așa a apărut o nouă metrică — timp de răspuns (response).
Timpul de răspuns se calculează astfel:
Tresponse=Tfirstrun−Tarrival
Astfel, pentru exemplul anterior, timpul de răspuns va fi: A=0, B=0, C=10 (abg=3,33).
Se pare că algoritmul STCF nu este atât de bun în situația în care 3 sarcini sosesc simultan — va trebui să aștepte până când sarcinile mici se finalizează complet. Astfel, algoritmul este bun pentru metrica timpului de rotație, dar slab pentru metrica interactivității. Imaginați-vă că, așezat la un terminal, încercând să tastați caractere într-un editor, trebuie să așteptați mai mult de 10 secunde deoarece o altă sarcină ocupă procesorul. Nu este deloc plăcut.
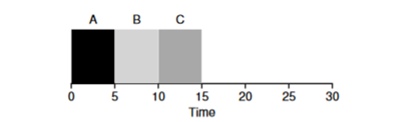
Astfel, ne confruntăm cu o altă problemă — cum putem construi un programator care să fie sensibil la timpul de răspuns?
Round Robin
Pentru a rezolva această problemă, a fost dezvoltat un algoritm Round Robin (RR). Ideea de bază este destul de simplă: în loc să lansăm sarcinile până la completarea lor, vom rula o sarcină pentru un anumit interval de timp (numit cuantă de timp) și apoi vom comuta la o altă sarcină din coadă. Algoritmul repetă această procedură până când toate sarcinile sunt terminate. Timpul de execuție al programului trebuie să fie multiplu al intervalului de timp în care temporizatorul va întrerupe procesul. De exemplu, dacă temporizatorul întrerupe procesul la fiecare x=10ms, atunci dimensiunea ferestrei de execuție a procesului trebuie să fie multiplu de 10 și să fie 10, 20 sau x*10.
Să luăm un exemplu: Sarcinile A, B, C sosesc simultan în sistem și fiecare dintre ele dorește să ruleze 5 secunde. Algoritmul SJF va executa fiecare sarcină până la finalizare înainte de a lansa o alta. Spre deosebire de algoritmul RR cu fereastra de execuție=1s, va parcurge sarcinile în următorul mod (fig. 4.3):
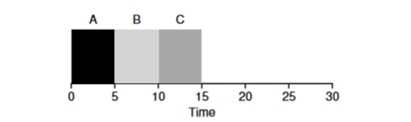
(SJF din nou (rău pentru timpul de răspuns)
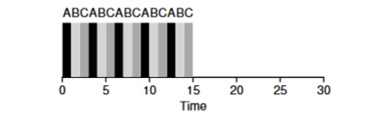
(Round Robin (bun pentru timpul de răspuns)
Timpul mediu de răspuns pentru algoritmul RR (0+1+2)/3=1, în timp ce pentru SJF (0+5+10)/3=5.
Este logic să presupunem că fereastra de timp este un parametru foarte important pentru RR; cu cât este mai mică, cu atât timpul de răspuns este mai mare. Totuși, nu trebuie să fie prea mică, deoarece timpul de schimbare a contextului va juca, de asemenea, un rol în performanța generală. Astfel, alegerea timpului de fereastră de execuție este stabilită de arhitectul sistemului de operare și depinde de sarcinile care sunt planificate a fi executate. Schimbarea contextului nu este singura operație de serviciu care consumă timp - programul în execuție operează și cu diverse cache-uri, iar la fiecare schimbare este necesară salvarea și restaurarea acestui mediu, ceea ce poate necesita, de asemenea, mult timp.
RR este un planificator excelent, dacă ne gândim doar la metricile timpului de răspuns. Dar cum se va comporta metrica timpului de întoarcere a sarcinii în acest algoritm? Să luăm exemplul de mai sus, când timpul de execuție pentru A, B, C este de 5s și ajung în același timp. Sarcina A se va finaliza la 13s, B la 14s, C la 15s, iar timpul mediu de întoarcere va fi de 14s. Astfel, RR este cel mai slab algoritm pentru metricile de întoarcere.
În termeni mai generali, orice algoritm de tip RR este corect, împărțind timpul de lucru pe CPU în mod egal între toate procesele. Astfel, aceste metrici intră constant în conflict între ele.
Prin urmare, avem mai multe algoritmi opuși și, în același timp, încă mai rămân câteva presupuneri - că timpul sarcinii este cunoscut și că sarcina utilizează doar CPU.
Amestecarea cu I/O
În primul rând, să eliminăm presupunerea 4, că procesul utilizează doar CPU; desigur, nu este așa, iar procesele pot accesa și alte echipamente.
În momentul în care un proces solicită o operație de intrare-ieșire, acesta trece în starea blocată, așteptând finalizarea I/O. Dacă I/O este trimis către hard disk, această operație poate dura până la câteva ms sau mai mult, iar procesorul va fi inactiv în acest moment. În acest timp, planificatorul poate ocupa procesorul cu un alt proces. Următoarea decizie pe care va trebui să o ia planificatorul este când procesul va finaliza I/O. Când se întâmplă asta, va avea loc o întrerupere și sistemul de operare va schimba procesul care a solicitat I/O în starea de pregătire.
Să luăm un exemplu din mai multe sarcini. Fiecare dintre ele necesită 50ms de timp de procesor. Totuși, prima va accesa I/O la fiecare 10ms (care va fi de asemenea executat la fiecare 10ms). Procesul B, pe de altă parte, folosește pur și simplu 50ms de procesor fără I/O.
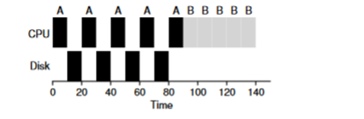
În acest exemplu, vom folosi programatorul STCF. Cum se va comporta programatorul dacă vom rula pe el un proces precum A? Acesta va proceda după cum urmează — va finaliza mai întâi complet procesul A, apoi procesul B.
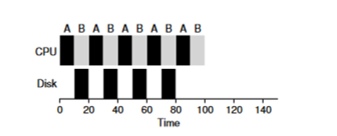
Abordarea tradițională pentru a rezolva această problemă este de a interpreta fiecare subtask de 10ms al procesului A ca o sarcină separată. Astfel, la început, algoritmul STJF face o alegere clară între sarcina de 50ms și cea de 10ms. Apoi, când subtaskul A se va finaliza, se va porni procesul B și I/O. După finalizarea I/O, se va decide să se repornesc procesul de 10ms A în locul procesului B. Astfel, se poate realiza suprapunerea, când CPU este folosit de un alt proces, în timp ce primul așteaptă I/O. Ca rezultat, sistemul este mai bine utilizat — în momentul în care procesele interactive așteaptă I/O, pe procesor pot rula și alte procese.
Oracolul nu mai există
Acum să încercăm să scăpăm de presupunerea că timpul de execuție al sarcinii este cunoscut. Aceasta este, în general, cea mai proastă și nerealistă presupunere din întreaga listă. De fapt, în sistemele de operare medii, OS-ul însuși știe foarte puțin despre timpul de execuție al sarcinilor, cum atunci să construim un programator fără a ști cât timp va dura execuția unei sarcini? Poate am putea folosi unele principii RR pentru a rezolva această problemă?
Rezultatul
Am examinat conceptele de bază ale programării sarcinilor și am analizat două familii de programatori. Primul rulează sarcina cea mai scurtă la început, astfel crește timpul de rotație, iar al doilea se împarte uniform între toate sarcinile, sporind timpul de răspuns. Ambele algoritmi sunt slabi în domeniile în care sunt buni algoritmii celeilalte familii. De asemenea, am văzut cum utilizarea paralelă a CPU și I/O poate îmbunătăți performanța, dar nu am rezolvat problema viziunii sistemului de operare. În următoarea lecție, vom analiza un programator care se uită în trecutul apropiat și încearcă să prezică viitorul. Acesta se numește coada de feedback multi-nivel.
Sursa: habr.com
