

Arhitectura microserviciilor, la fel ca tot ce există în această lume, are atât avantaje, cât și dezavantaje. Unele procese devin mai simple, iar altele — mai complexe. În numele rapidității schimbărilor și unei scalabilități mai bune, trebuie să facem anumite sacrificii. Unul dintre aceste sacrificii este complicarea analizei. Dacă în monolit toată analiza operațională poate fi redusă la interogări SQL către replica analitică, în arhitectura multi-servicii fiecare serviciu are propria bază de date și pare că nu te poți descurca doar cu o singură interogare (sau poate te poți?). Pentru cei interesați de cum am rezolvat problema analizei operaționale în compania noastră și cum am învățat să trăim cu această soluție — bine ați venit.
Mă numesc Pavel Sivaș, iar la DomClick lucrez în echipa responsabilă de întreținerea depozitului de date analitice. Activitatea noastră poate fi considerată în mod curent inginerie de date, însă, de fapt, gama de sarcini este mult mai largă. Există sarcini standard pentru ingineria datelor ETL/ELT, suport și adaptare a instrumentelor pentru analiza datelor și dezvoltarea propriilor instrumente. În special, pentru rapoartele operaționale, am decis să 'ne facem că suntem un monolit' și să le oferim analiștilor o singură bază în care să se regăsească toate datele necesare.
În general, am luat în considerare diferite opțiuni. Am putea construi un depozit complet – am încercat chiar, dar, să fiu sincer, nu am reușit să adaptăm modificările frecvente în logică cu procesul de construire a depozitului și de implementare a modificărilor, care era destul de lent (dacă cineva a reușit, vă rog să scrieți în comentarii cum). Am putea să le spunem analiștilor: „Băieți, învățați python și folosiți replici analitice”, dar aceasta ar fi o cerință suplimentară în selecția personalului, iar părea că ar fi bine să evităm asta, dacă este posibil. Am decis să încercăm tehnologia FDW (Foreign Data Wrapper): în esență, este un dblink standard, care face parte din standardul SQL, dar cu un interfață mult mai convenabilă. Pe baza acesteia, am dezvoltat o soluție care, în final, a fost adoptată, pe care ne-am oprit. Detaliile sale sunt o temă de articol separat, și poate chiar mai multe, deoarece vreau să spun multe: de la sincronizarea schemelor bazelor de date până la gestionarea accesului și anonimizarea datelor personale. De asemenea, trebuie menționat că această soluție nu este un substitut pentru bazele de date analitice reale și depozite; ea rezolvă doar o problemă specifică.
La un nivel superior, arată astfel:
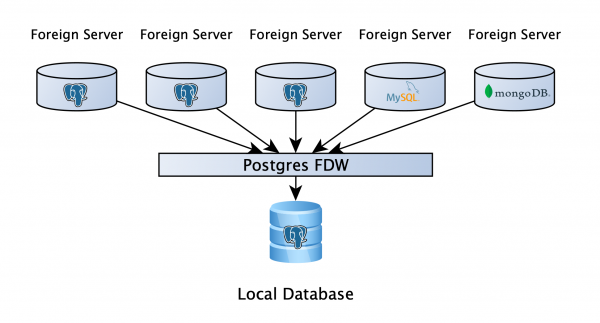
Există o bază de date PostgreSQL, unde utilizatorii își pot stoca datele de lucru, iar cel mai important – la această bază sunt conectate, prin FDW, replici analitice din toate serviciile. Aceasta oferă posibilitatea de a scrie o interogare pentru mai multe baze, fără a conta ce sunt acestea: PostgreSQL, MySQL, MongoDB sau altceva (fișier, API, iar dacă nu există un wrapper adecvat, putem scrie unul propriu). Cam atât, super! Ne descurcăm?
Dacă totul s-ar termina atât de repede și simplu, probabil că nici nu ar mai fi acest articol.
Este important să înțelegem clar cum PostgreSQL procesează interogările către serverele externe. Acest lucru pare logic, totuși adesea nu se acordă atenție: PostgreSQL împarte interogarea în părți, care sunt executate pe serverele externe în mod independent, adună aceste date, iar calculul final este efectuat de el însuși, motiv pentru care viteza de execuție a interogării va depinde foarte mult de modul în care este scrisă. De asemenea, trebuie menționat: atunci când datele vin de pe un server extern, nu au deja indexuri, nu au nimic care să ajute planificatorul, prin urmare, singurii care pot ajuta și îndruma suntem noi înșine. Și tocmai despre asta vreau să vorbesc mai în detaliu.
O solicitare simplă și planul asociat
Pentru a arăta cum PostgreSQL execută o interogare pe o masă de 6 milioane de rânduri pe serverul extern server, să ne uităm la un plan simplu.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Utilizarea instrucțiunii VERBOSE permite vizualizarea interogării care va fi trimisă la serverul extern și rezultatele pe care le vom obține pentru procesarea ulterioară (linia RemoteSQL).
Să mergem puțin mai departe și să adăugăm câteva filtre în interogarea noastră: unul pe boolean câmp, unul pe apariția timestamp în interval și unul pe jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Aici se află momentul cheie la care trebuie să acordăm atenție atunci când scriem interogări. Filtrele nu au fost transmise la serverul extern, ceea ce înseamnă că pentru a le executa, PostgreSQL extrage toate cele 6 milioane de rânduri, pentru a le filtra local (linia Filter) și a efectua agregarea. Secretul succesului este să scriem interogarea astfel încât filtrele să fie transmise pe mașina externă, iar noi să obținem și să agregăm doar rândurile necesare.
Asta e o prostie de tip boolean
Cu câmpurile boolean — totul e simplu. Problema din interogarea inițială a apărut din cauza operatorului is. Dacă îl înlocuim cu =, vom obține următorul rezultat:
explica analiza detaliată
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 months'
AND CURRENT_DATE - INTERVAL '6 months'
AND meta->>'source' = 'test';

Agregare  (cost=508010.14..508010.15 rows=1 width=8) (timp efectiv=19064.314..19064.314 rows=1 loops=1)
  Iesire: count(1)
  ->  Scanare externă pe fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (timp efectiv=33.035..18951.278 rows=1360025 loops=1)
        Iesire: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filtru: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 months'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 months'::interval)))
        Rânduri eliminate prin filtru: 3567989
        SQL la distanță: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Timp de planificare: 0.834 ms
Timp de execuție: 19064.534 ms
După cum vedeți, filtrul s-a mutat pe serverul extern, iar timpul de execuție a scăzut de la 27 la 19 secunde.
Merită menționat că operatorul is este diferit de operatorul = prin faptul că poate lucra cu valoarea Null. Aceasta înseamnă că is not True în filtrul va lăsa valorile False și Null, în timp ce != True va păstra doar valorile False. Prin urmare, la înlocuirea operatorului is not ar trebui să se transmită în filtru două condiții cu operatorul OR, de exemplu, WHERE (col != True) OR (col is null).
Am înțeles boolean-ul, să trecem mai departe. Între timp, să readucem filtrul pe valoarea booleană în forma sa inițială, pentru a examina independent efectul altor modificări.
timestamptz? hz
În general, adesea trebuie să experimentăm cu modul corect de a scrie o interogare care implică servere externe, și abia apoi să căutăm explicații despre de ce se întâmplă exact așa. Foarte puține informații pe acest subiect pot fi găsite pe Internet. Astfel, în experimente am descoperit că filtrul pe o dată fixă este procesat cu succes pe serverul extern, în timp ce atunci când dorim să stabilim data dinamic, de exemplu, now() sau CURRENT_DATE, acest lucru nu se întâmplă. În exemplul nostru, am adăugat un astfel de filtru pentru ca coloana created_at să conțină date exacte pentru 1 lună în trecut (BETWEEN CURRENT_DATE - INTERVAL '7 months' AND CURRENT_DATE - INTERVAL '6 months'). Ce am întreprins în acest caz?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 months')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 months'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 months'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta->>'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
Am sugerat planificatorului să calculeze dinainte data în subinterogare și să transmită deja variabila gata în filtrul de date. Această sugestie ne-a adus un rezultat excelent, interogarea a fost accelerată de aproape șase ori!
Din nou, este important să fii atent: tipul de date din subinterogare trebuie să fie același cu cel al câmpului pe care filtrăm, altfel planificatorul va considera că, având tipuri diferite, este necesar mai întâi să obținem toate datele și să le filtrăm local.
Să returnăm filtrul pe dată la valoarea inițială.
Freddy vs. Jsonb
În general, câmpurile boolean și datele au fost suficient pentru a accelera interogarea noastră, totuși exista încă un alt tip de date. Lupta cu filtrarea lui nu s-a încheiat, deși și aici există progrese. Așadar, iată cum am reușit să transmitem filtrul pe jsonb câmpul pe serverul la distanță.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 months'
AND CURRENT_DATE - INTERVAL '6 months'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 months'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
Este necesar să folosim operatorul de existență în locul operatorilor de filtrare. jsonb în altă parte. 7 secunde în loc de 29 inițiale. Până acum, aceasta este singura variantă de succes pentru transmiterea filtrilor prin jsonb un server extern, dar aici este important să ținem cont de o restricție: folosim versiunea bazei de date 9.6, dar până la sfârșitul lunii aprilie planificăm să finalizăm ultimele teste și să trecem la versiunea 12. Când ne vom actualiza, vom scrie cum a influențat, deoarece sunt multe schimbări, pe care ne punem multe speranțe: json_path, un comportament nou CTE, push down (existent din versiunea 10). Aș dori să încerc cât mai curând.
Finish him
Am verificat cum fiecare modificare afectează viteza interogării pe rând. Să vedem acum ce se va întâmpla când toate cele trei filtre sunt scrise corect.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    - >  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    - >  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  - >  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Da, interogarea arată mai complexă, este o plată forțată, dar viteza de execuție este de 2 secunde, ceea ce este de peste 10 ori mai rapid! Și vorbim aici despre o interogare simplă pe un set de date relativ mic. La interogările reale, am obținut un câștig de până la câteva sute de ori.
Să rezumăm: dacă folosiți PostgreSQL cu FDW, verificați întotdeauna dacă toate filtrele sunt trimise pe serverul extern, și veți avea succes... Cel puțin până nu ajungeți la join-uri între tabele din diferite servere. Dar aceasta este deja o poveste pentru un alt articol.
Mulțumesc pentru atenție! Voi fi bucuros să aud întrebări, comentarii, precum și povești despre experiența dumneavoastră în comentarii.
Sursa: habr.com
