

Ce ar putea determina o companie atât de mare precum Lamoda, cu un proces bine pus la punct și zeci de servicii interconectate, să își schimbe semnificativ abordarea? Motivațiile pot fi foarte diverse: de la cele legale la dorința inerentă a tuturor programatorilor de a experimenta.
Dar asta nu înseamnă că nu se poate conta pe beneficii suplimentare. Ce anume se poate câștiga dacă se implementează un API bazat pe evenimente pe Kafka, va explica Serghei Zaika (). Vor fi, de asemenea, discuții despre greșelile învățate și descoperirile interesante — nu poate exista un experiment fără acestea.
Disclaimer: Acest articol se bazează pe materialele meetup-ului pe care Serghei l-a organizat în noiembrie 2018 la HighLoad++. Experiența reală a Lamoda în utilizarea Kafka a atras cu siguranță atenția la fel de mult ca și celelalte prezentări din program. Ni se pare că acesta este un exemplu excelent al faptului că este întotdeauna posibil și necesar să găsești oameni cu aceleași idei, iar organizatorii HighLoad++ vor continua să încerce să creeze o atmosferă care să încurajeze acest lucru.
Despre proces
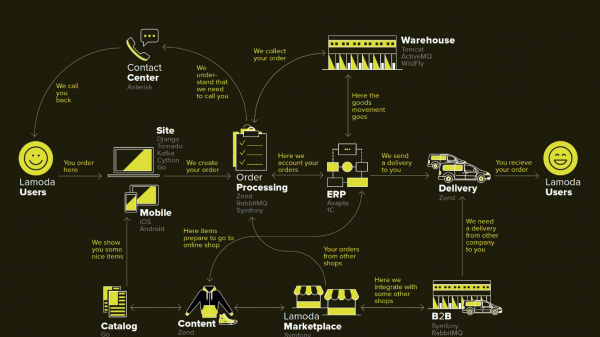
Lamoda este o platformă e-commerce mare, care are propriul său centru de contact, serviciu de livrare (și numeroase parteneriate), studio foto, un depozit imens și toate acestea funcționează pe propriul software. Există zeci de metode de plată, parteneri B2B care pot folosi unele sau toate aceste servicii și doresc să cunoască informațiile actualizate despre produsele lor. În plus, Lamoda activează în trei țări în afară de RF și acolo lucrurile sunt puțin diferite. În total, există probabil mai mult de o sută de moduri de a configura o nouă comandă, care trebuie procesată în mod specific. Toate acestea funcționează cu ajutorul a zeci de servicii care comunică uneori într-un mod mai puțin evident. Există, de asemenea, un sistem central, a cărui responsabilitate principală este gestionarea statutelor comenzilor. O numim BOB, iar eu lucrez cu acesta.
Refund Tool with events-driven API
Cuvântul events-driven este destul de folosit, iar mai târziu vom defini în detaliu ce înseamnă acest lucru. Voi începe cu contextul în care am decis să testăm abordarea API-ului bazat pe evenimente în Kafka.
În orice magazin, pe lângă comenzile pentru care clienții plătesc, există momente când magazinul este nevoit să returneze bani, deoarece clientului nu i s-a potrivit produsul. Acest proces relativ scurt: confirmăm informațiile, dacă este necesar, și transferăm banii.
Însă, returnarea s-a complicat din cauza modificărilor legislative, iar noi am fost nevoiți să implementăm un microserviciu separat pentru aceasta.
Motivația noastră:
- Legea FZ-54 — pe scurt, legea cere să raportăm autorităților fiscale fiecare operațiune financiară, fie că este vorba de returnare sau de venit, într-un termen destul de scurt, de câteva minute. Ca e-commerce, realizăm un număr considerabil de operațiuni. Tehnic, aceasta înseamnă o nouă responsabilitate (și, prin urmare, un nou serviciu) și modificări în toate sistemele implicate.
- BOB split — un proiect intern al companiei pentru a elibera BOB de un număr mare de responsabilități externe și a reduce complexitatea sa generală.
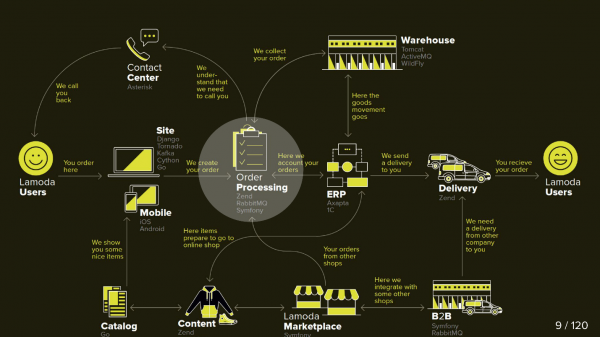
În acest diagramă sunt ilustrate sistemele principale ale Lamoda. În prezent, majoritatea dintre ele reprezintă mai mult o constelație de 5-10 microservicii în jurul unui monolit în diminuare.Ele cresc ușor, dar ne străduim să le facem mai puține, deoarece a desfășura un fragment dedicat în mijloc este înfricoșător — trebuie să ne asigurăm că nu va ceda. Toate interacțiunile (sagetele) trebuie rezervate, presupunând că oricare dintre ele poate deveni inaccesibil.
În BOB există de asemenea multe interacțiuni: sisteme de plată, livrare, notificări etc.
Tehnic, BOB este:
- ~150k linii de cod + ~100k linii de teste;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 integrații externe;
- 4 țări cu logica lor de afaceri.
A desfășura BOB este costisitor și dureros, volumul de cod și sarcinile pe care le rezolvă sunt astfel încât nimeni nu poate învăța totul despre el în întregime. În general, există multe motive pentru a-l simplifica.
Procesul de returnare
Inițial, procesul implică două sisteme: BOB și Payment. Acum apar încă două:
- Fiscalization Service, care se va ocupa de problemele de fiscalizare și de comunicarea cu serviciile externe.
- Refund Tool, în care se transferă pur și simplu noile interacțiuni pentru a nu umfla BOB.
Acum procesul arată astfel:
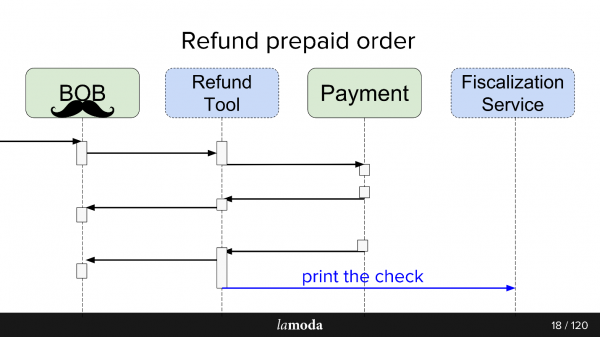
- BOB primește o cerere de returnare a banilor.
- BOB notifică Refund Tool despre aceasta.
- Refund Tool spune Payment: „Returnați banii”.
- Payment returnează banii.
- Refund Tool și BOB sincronizează între ei statusurile, deoarece deocamdată amândouă au nevoie de acest lucru. Nu suntem încă pregătiți să ne întoarcem pe deplin la Refund Tool, deoarece în BOB există un UI, rapoarte pentru contabilitate și, în general, multe date care nu pot fi transferate atât de ușor. Trebuie să ne menținem pe două scaune.
- Se trimite o cerere pentru fiscalizare.
În concluzie, am creat pe Kafka un fel de bus de evenimente - event-bus, pe care s-au legat toate. Ura, acum avem un singur punct de eșec (sarcasm).
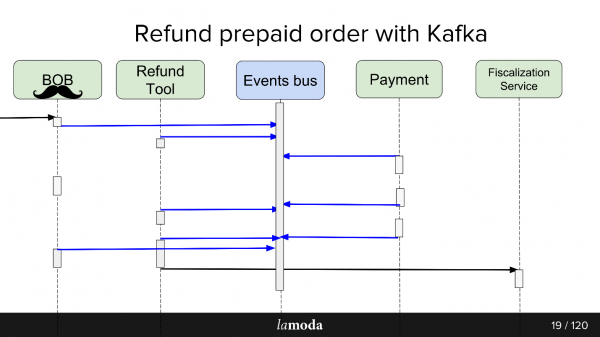
Pro și contra sunt destul de evidente. Am creat un bus, ceea ce înseamnă că acum toate serviciile depind de el. Aceasta simplifică proiectarea, dar introduce în sistem un punct unic de eșec. Dacă Kafka se prăbușește, procesul se oprește.
Ce este un API bazat pe evenimente
Un răspuns bun la această întrebare se găsește în prezentarea lui Martin Fowler (GOTO 2017) .
Pe scurt, ce am făcut:
- Am îmbrăcat toate schimburile asincrone prin stocarea evenimentelor. În loc să comunicăm prin rețea fiecărui consumator interesat despre schimbarea stării, scriem într-un depozit centralizat un eveniment despre schimbarea de stare, iar consumatorii interesați de subiect citesc de acolo tot ce apare.
- Un eveniment (event) în acest caz este o notificare (notifications) despre faptul că ceva s-a schimbat undeva. De exemplu, s-a schimbat statul unei comenzi. Consumatorul, căruia îi sunt importante anumite date de acompaniament la schimbarea stării și care nu sunt în notificare, poate afla starea lor singur.
- Varianta maximă - un sourcing de evenimente complet, transfer de stare, în care evenimentul conține toată informația necesară pentru procesare: de unde și în ce stare am trecut, cum s-au schimbat datele etc. Întrebarea este doar despre fezabilitate și volumul de informație pe care îți poți permite să-l stochezi.
În cadrul lansării instrumentului Refund, am folosit a treia variantă. Acest lucru a simplificat procesarea evenimentelor, deoarece nu a fost necesar să obținem informații detaliate, plus a exclus scenariul în care fiecare nou eveniment generează un vârf de solicitări de tip get pentru clarificări din partea consumatorilor.
Serviciul Refund Tool nu este suprasolicitat, astfel că Kafka acolo este mai mult o probă decât o necesitate. Nu cred că, dacă serviciul de returnare a fondurilor ar deveni un proiect de tip high-load, afacerea ar fi mulțumită.
Schimb asincron AȘA CUM ESTE
Pentru schimburile asincrone, departamentul de PHP folosește de obicei RabbitMQ. Am adunat datele pentru solicitare, le-am pus în coadă și consumatorul aceluiași serviciu le-a citit și le-a trimis (sau nu le-a trimis). Pentru API-ul propriu, Lamoda folosește activ Swagger. Proiectăm API-ul, îl descriem în Swagger, generăm codul client și server. De asemenea, folosim un JSON RPC 2.0 puțin extins.
În unele locuri se folosesc busuri esb, cineva trăiește pe activeMQ, dar, în general, RabbitMQ - standard.
Async exchange TO BE
Proiectând un schimb prin events-bus, se observă o analogie. Asemănător, descriem viitorul schimb de date prin descrierea structurii event-ului. Formatul yaml, generarea de coduri a trebuit să o facem noi înșine, generatorul conform specificației creează DTO-uri și învață clienții și serverele să lucreze cu acestea. Generarea se face în două limbaje - golang și php. Acest lucru permite menținerea bibliotecilor consecvente. Generatorul este scris în golang, motiv pentru care a primit numele gogi.
Event-sourcing pe Kafka este o practică obișnuită. Există o soluție de la versiunea enterprise principală Kafka Confluent, există , o soluție de la «frații» noștri din domeniul Zalando. Motivația noastră de a începe cu vanilla Kafka este să menținem soluția gratuită, până când ne decidem dacă vom folosi pe scară largă, precum și să ne lăsăm un spațiu de manevră și îmbunătățiri: vrem suport pentru propriul JSON RPC 2.0 , generatoare pentru două limbaje și să vedem ce altceva.Ironia este că, chiar și în cazul fericit în care există un business similar Zalando, care a realizat o soluție asemănătoare, nu putem utiliza eficient.
Arhitectural, în lansare, patternul este următorul: citim direct din Kafka, dar scriem doar prin events-bus. Pentru citirea din Kafka există multe soluții gata: brokeri, echilibratori și este mai mult sau mai puțin pregătită pentru scalare orizontală, acest lucru ne-am dorit să păstrăm. Scrierea, însă, am dorit să o împachetăm printr-un Gateway aka Events-bus, și iată motivul.
Events-bus
sau autobuz de evenimente. Este pur și simplu un gateway HTTP stateless, care își asumă câteva roluri importante:
Validarea producerii
- — verificăm că evenimentele respectă specificația noastră. Sistemul principal pentru evenimente
- , adică este singurul sistem din companie care răspunde la întrebarea, care evenimente cu ce structuri sunt considerate valide. În validare intră doar tipurile de date și enums pentru specificația strictă a conținutului.Funcția de hash
- pentru sharding - structura mesajului Kafka este key-value și aici, pe baza hash-ului de la key se calculează unde trebuie să fie plasat. De ce
Lucrăm într-o mare companie cu un proces bine stabilit. De ce am schimba ceva?
Este un experiment , și ne așteptăm să obținem câteva beneficii.1:n+1 schimburi (unu la mulți)
Este foarte simplu să conectezi API-uri pentru noi consumatori cu Kafka.
Cu Kafka, este foarte simplu să conectați noi consumatori la API.
Să presupunem că aveți un director pe care trebuie să îl mențineți actualizat în mai multe sisteme simultan (și în unele noi). În trecut, inventasem un bundle care implementa set-API, iar în sistemul principal comunicam adresele consumatorilor. Acum, sistemul principal trimite actualizări către un topic, și toți cei interesați le citesc. A apărut un nou sistem — l-am abonat la topic. Da, tot bundle, dar mai simplu.
În cazul tool-ului de rambursare, care este de fapt o parte a BOB, ne este convenabil să le menținem sincronizate prin Kafka. Payment spune că banii au fost returnați: BOB și RT au aflat despre asta, și-au actualizat statusurile, iar Fiscalization Service a aflat și a emis chitanța.
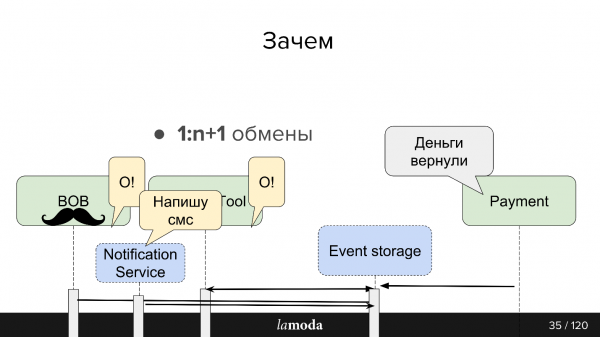
Plănuim să facem un Serviciu de Notificări unic, care să informeze clientul despre noutățile privind comanda/returnările sale. Acum, această responsabilitate este dispersată între sisteme. Ne va fi suficient să învățăm Serviciul de Notificări să extragă informații relevante din Kafka și să reacționeze la ele (și să dezactivăm aceste notificări în celelalte sisteme). Nu va fi necesar să facem schimburi directe noi.
Data-driven
Informația între sisteme devine transparentă — indiferent de cât de complex ar fi «enterprise»-ul vostru și de cât de mare ar fi backlog-ul vostru. În Lamoda există un departament de Data Analytics care colectează date din sisteme și le transformă într-o formă reutilizabilă, atât pentru afaceri, cât și pentru sistemele inteligente. Kafka permite furnizarea rapidă de multe date și menținerea acestui flux informațional actualizat.
Replication log
Mesajele nu dispar după citire, ca în RabbitMQ. Când un eveniment conține suficiente informații pentru procesare, avem o istorie a celor mai recente modificări ale obiectului și, la nevoie, posibilitatea de a aplica aceste modificări.
Perioada de stocare a replication log-ului depinde de intensitatea scrierii în acest topic, iar Kafka permite configurarea flexibilă a limitelor de stocare atât în timp, cât și în volum de date. Pentru topicurile intensive, este important ca toți consumatorii să reușească să citească informația înainte ca aceasta să dispară, chiar și în cazul unei nefuncționări temporare. De obicei, reușim să stocăm date pentru câteva zile, ceea ce este suficient pentru suport.
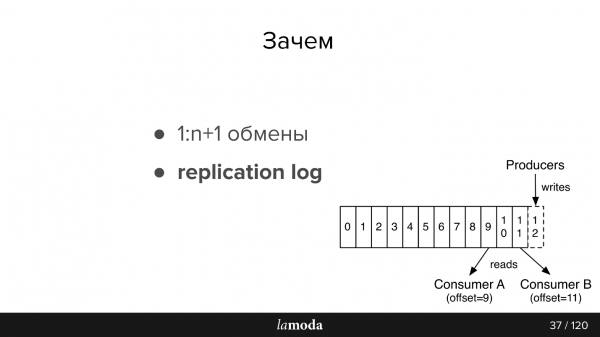
Mai departe, un scurt rezumat al documentației, pentru cei care nu sunt familiarizați cu Kafka (imaginea este de asemenea din documentație)
În AMQP există cozi: scriem mesaje în coadă pentru consumator. De obicei, o coadă este prelucrată de un singur sistem cu aceeași logică de afaceri. Dacă este necesar să notify mai multe sisteme, aplicația poate fi învățată să scrie în mai multe cozi sau să configureze un exchange cu un mecanism fanout, care le clonează automat.
În Kafka există o abstracție similară topic, în care scrieți mesaje, dar acestea nu dispar după ce sunt citite. Implicit, când vă conectați la Kafka, obțineți toate mesajele, și există posibilitatea de a salva locul unde ați rămas. Asta înseamnă că citiți secvențial, puteți să nu marcați mesajul ca fiind citit, dar să salvați id-ul de la care veți continua citirea. Id-ul, de la care ați rămas, se numește offset, iar mecanismul – commit offset.
Prin urmare, se poate implementa o logică diferită. De exemplu, BOB există în 4 instanțe pentru diferite țări – Lamoda este disponibilă în Rusia, Kazahstan, Ucraina, Belarus. Deoarece sunt desfășurate separat, au ceva confguri proprii și o logică de afaceri specifică. Indicam în mesaj la ce țară se referă. Fiecare consumator BOB din fiecare țară citește cu groupId-uri diferite, iar dacă un mesaj nu se referă la el, îl sar, adică comite imediat offset +1. Dacă aceeași temă este citită de serviciul nostru de plăți, o face cu un grup separat, și de aceea offset-urile nu se intersectează.
Cerințe pentru evenimente:
- Completeness of data. Ne-ar plăcea ca evenimentul să aibă suficiente date pentru a putea fi procesat.
- Integrity. Delegăm Events-bus-ului verificarea faptului că evenimentul este consistent și că poate fi procesat.
- Ordinea este importantă. În cazul returnărilor, suntem nevoiți să lucrăm cu istoria. În cazul notificărilor, ordinea nu este importantă, dacă sunt notificări omogene, email-ul va fi același indiferent de care comandă a sosit prima. În cazul returnărilor, există un proces clar, dacă schimbăm ordinea, pot apărea excepții, refund-ul nu se va crea sau nu va fi procesat – vom ajunge într-un alt statut.
- Coerența. Avem un depozit și acum creăm evenimente în loc de API-uri. Avem nevoie de un mod rapid și ieftin de a trimite informații despre noi evenimente și despre modificările celor existente în serviciile noastre. Acest lucru se realizează printr-o specificație comună într-un repository git separat și generatoare de cod. Astfel, clienții și serverele din diferite servicii sunt armonizate.
Kafka în Lamoda
Avem trei instalări Kafka:
- Logs;
- R&D;
- Events-bus.
Astăzi discutăm doar despre ultimul punct. În events-bus avem instalări destul de mici – 3 brokeri (servere) și în total 27 de teme. De obicei, o temă reprezintă un singur proces. Dar acesta este un aspect delicat, și în curând ne vom ocupa de el.
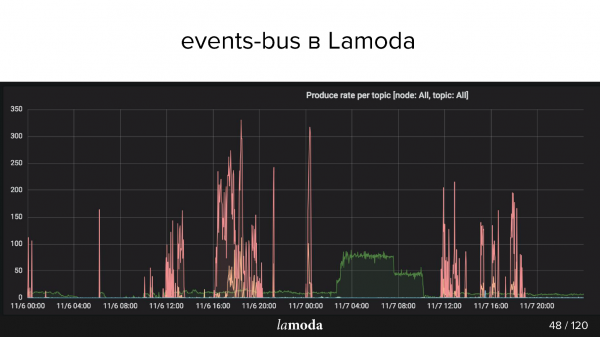
Mai sus este graficul rps. Procesul de returnare este marcat de linia turcoaz (da, da, aceea de pe axa X), iar procesul de actualizare a conținutului de cea roz.
Catalogul Lamoda conține milioane de produse, iar datele sunt actualizate constant. Unele colecții ies din modă, înlocuiesc noi produse care apar tot timpul în catalog. Încercăm să prezicem ce va fi interesant pentru clienții noștri mâine, așa că achiziționăm constant lucruri noi, le fotografiem și actualizăm vitrina.
Pecurile roz reprezintă actualizări de produs, adică modificări ale produselor. Se vede că echipa a fotografiat mereu, mereu, iar apoi, dintr-o dată! – au încărcat un lot de evenimente.
Cazuri de utilizare Lamoda Events
Arhitectura construită este folosită pentru astfel de operațiuni:
- Urmărirea statutelor de returnare: call-to-action și urmărirea statutelor din toate sistemele implicate. Plata, statuile, fiscalizarea, notificările. Aici am testat abordarea, am creat instrumente, am adunat toate bug-urile, am scris documentația și am explicat colegilor cum să folosească aceste instrumente.
- Actualizarea fișelor de produs: configurare, metadate, specificații. Citește un singur sistem (care le afișează), dar mai multe le scriu.
- Email, push și sms: comanda a fost realizată, comanda a ajuns, returnarea a fost acceptată etc., sunt multe.
- Stoc, actualizarea stocului – actualizare cantitativă a denumirilor, doar cifre: sosirea pe stoc, returnare. Este necesar ca toate sistemele legate de rezervarea produselor să opereze cu date cât mai actualizate. În prezent, sistemul de actualizare a stocului este destul de complex, Kafka va permite simplificarea acestuia.
- Analiza datelor (Departamentul R&D), instrumente ML, analitică, statistică. Vrem ca informația să fie transparentă - pentru asta Kafka este potrivit.
Acum partea mai interesantă despre greșelile făcute și descoperirile interesante care au avut loc în ultimele șase luni.
Probleme de proiectare
Să presupunem că dorim să realizăm o nouă nebunie - de exemplu, să transferăm întregul proces de livrare pe Kafka. În prezent, o parte din proces este implementată în Order Processing în BOB. Există un model de stare pentru transferul comenzii la serviciul de livrare, mutarea la depozitul intermediar și altele. Există un monolit întreg, chiar două, plus o mulțime de API-uri dedicate livrării. Ele știu mult mai multe despre livrare.
Se pare că acestea sunt domenii similare, dar pentru Order Processing în BOB și pentru sistemul de livrare, stările diferă. De exemplu, unele servicii de curierat nu transmit stări intermediare, ci doar finale: „livrat” sau „pierdut”. Altele, dimpotrivă, oferă informații detaliate despre mișcarea bunului. Fiecare are propriile reguli de validare: pentru unii, un email valid înseamnă că va fi procesat; pentru alții, un email invalid, dar comanda va fi totuși procesată, deoarece există un telefon de contact, iar alții vor spune că o astfel de comandă nu va fi procesată deloc.
Flux de date
În cazul lui Kafka se ridică întrebarea organizării fluxului de date. Această sarcină este legată de alegerea unei strategii pe câteva puncte, să le parcurgem pe toate.
Într-un topic sau în diferite?
Avem o specificație a evenimentului. În BOB scriem că o anumită comandă trebuie livrată și specificăm: numărul comenzii, compunerea acesteia, anumite SKU-uri și coduri de bare etc. Când bunul ajunge la depozit, livrarea va putea primi stări, timestamps și tot ce este necesar. Dar mai departe dorim să primim actualizări despre aceste date în BOB. Avem un proces invers de primire a datelor din livrare. Este același eveniment? Sau este o schimbare separată, care merită un topic separat?
Cel mai probabil, ele vor fi foarte asemănătoare, iar tentația de a face un topic unic nu este nejustificată, deoarece un topic separat înseamnă consumatori separați, configurații separate, generarea separată a tuturor acestora. Dar nu este sigur.
Câmp nou sau eveniment nou?
Dar dacă folosim aceleași evenimente, apare o altă problemă. De exemplu, nu toate sistemele de livrare pot genera un astfel de DTO care să poată genera BOB. Noi le trimitem ID-ul, iar ei nu-l păstrează, pentru că nu îl consideră necesar, iar din perspectiva inițierii procesului event-bus, acest câmp este obligatoriu.
Dacă stabilim pentru event-bus regula că acest câmp este obligatoriu, atunci suntem nevoiți să adăugăm reguli suplimentare de validare în BOB sau în handler-ul evenimentului inițial. Validarea începe să se răspândească în serviciu - ceea ce nu este foarte convenabil.
O altă problemă este tentația dezvoltării incrementale. Ni se spune că trebuie să adăugăm ceva în eveniment și, poate, dacă ne gândim bine, ar fi trebuit să fie un eveniment separat. Dar în schema noastră, un eveniment separat reprezintă un topic separat. Un topic separat înseamnă întregul proces pe care l-am descris mai sus. Dezvoltatorul are tendința de a introduce pur și simplu un alt câmp în schema JSON și de a regenera.
În cazul refund-urilor, astfel am ajuns în șase luni la evenimentul evenimentelor. Am avut un metaeveniment numit refund update, care avea un câmp type, descriind în ce constă, de fapt, acest update. De aici am avut "minunate" switch-uri cu validatori care spuneau cum trebuie validat acest eveniment cu acest type.
Versionarea evenimentelor
Pentru validarea mesajelor în Kafka se poate folosi , dar trebuia de la început să integrăm acest lucru și să folosim Confluent. În cazul nostru cu versionarea, trebuie să fim prudenți. Nu va fi întotdeauna posibil să recitim mesajele din replication log, deoarece modelul "s-a dus". În principal, trebuie să construim versiuni astfel încât modelul să fie compatibil înapoi: de exemplu, să facem câmpul temporar opțional. Dacă diferențele sunt prea mari, începem să scriem într-un topic nou, iar clienții se mută atunci când termină de citit vechiul.
Garanția ordinii de citire a partition-urilor
Topicurile din Kafka sunt împărțite în partition-uri. Acest aspect nu este foarte important în timp ce proiectăm entitățile și schimburile, dar devine relevant atunci când decidăm cum să le consumăm și să scalăm.
În mod obișnuit, scrieți într-un singur topic în Kafka. Implicit, se folosește o singură partition, iar toate mesajele acestui topic ajung în ea. Iar consumatorul citește aceste mesaje în mod secvențial. Să presupunem că acum trebuie să extindem sistemul astfel încât mesajele să fie citite de doi consumatori diferiți. Dacă, de exemplu, trimiteți un SMS, se poate spune că Kafka trebuie să facă o partition suplimentară, iar Kafka va începe să distribuie mesajele în două părți - jumătate acolo, jumătate aici.
Cum le împarte Kafka? Fiecare mesaj are un corp (în care stocăm JSON) și are o cheie. La această cheie se poate aplica o funcție hash, care va determina în ce partition va ajunge mesajul.
În cazul nostru cu refunds, acest lucru este important; dacă luăm două partitions, există șansa ca un consumator paralel să proceseze al doilea eveniment înainte de primul, și va fi o problemă. Funcția hash garantează că mesajele cu aceeași cheie ajung în aceeași partition.
Evenimente vs comenzi
Aceasta este o altă problemă cu care ne-am confruntat. Un eveniment este un anumit incident: spunem că ceva s-a întâmplat (something_happened), de exemplu, un item a fost anulat sau a avut loc un refund. Dacă aceste evenimente sunt ascultate de cineva, atunci pentru «item anulat» entitatea refund va fi creată, iar «a avut loc un refund» va fi înregistrat undeva în setări.
Dar de obicei, atunci când proiectați evenimente, nu doriți să le scrieți în zadar - vă bazați pe faptul că cineva le va citi. Există o mare tentație să nu scrieți something_happened (item_canceled, refund_refunded), ci something_should_be_done. De exemplu, itemul este gata pentru returnare.
Pe de o parte, aceasta sugerează cum va fi folosit evenimentul. Pe de altă parte, aceasta nu mai seamănă deloc cu un nume normal de eveniment. În plus, de aici nu este departe de comanda do_something. Dar nu aveți nicio garanție că acest eveniment a fost citit de cineva; iar dacă a fost citit, atunci a fost citit cu succes; iar dacă a fost citit cu succes, înseamnă că s-a făcut ceva, și acel ceva a trecut cu succes. În momentul în care evenimentul devine do_something, devine necesară o reacție, și aceasta este o problemă.
În schimbul asincron în RabbitMQ, când ați citit un mesaj, ați mers pe http, aveți un răspuns - cel puțin că mesajul a fost acceptat. Când ați scris în Kafka, există un mesaj că ați scris în Kafka, dar nu știți nimic despre cum a fost procesat.
Prin urmare, în cazul nostru a fost necesar să introducem un eveniment de răspuns și să configurăm monitorizarea astfel încât, dacă s-au generat un anumit număr de evenimente, într-un anumit interval de timp să vină tot atâtea evenimente de răspuns. Dacă acest lucru nu s-a întâmplat, înseamnă că ceva a mers prost. De exemplu, dacă am trimis evenimentul „item_ready_to_refund”, ne așteptăm ca refund-ul să fie creat, clientul să primească banii înapoi, iar noi să primim evenimentul „money_refunded”. Dar nu este niciodată sigur, de aceea este necesară monitorizarea.
Nuante
Există o problemă destul de evidentă: dacă citiți din topic în mod secvențial, iar un mesaj este defect, consumatorul se oprește și nu veți putea continua. Trebuie să stopați toți consumatorii, să comiteți offset-ul mai departe pentru a continua citirea.
Știam despre asta, ne-am pregătit pentru această situație, și totuși s-a întâmplat. S-a întâmplat deoarece evenimentul a fost valid din punct de vedere al events-bus-ului, evenimentul a fost valid din punct de vedere al validatorului aplicației, dar nu a fost valid din punct de vedere al PostgreSQL-ului, deoarece într-un sistem aveam MySQL cu UNSIGNED INT, iar în sistemul recent scris aveam PostgreSQL doar cu INT. Dimensiunea lui este puțin mai mică, iar Id-ul nu a încăput. Symfony a picat cu o excepție. Sigur că am prins excepția, deoarece ne-am pregătit pentru ea și ne-am propus să comitem acest offset, dar înainte de asta am dorit să incrementăm contorul problemelor, având în vedere că mesajul a fost procesat cu eșec. Contoarele din acest proiect sunt de asemenea stocate în baza de date, iar Symfony a închis deja comunicarea cu baza de date, și a doua excepție a distrus întregul proces fără șanse de a comite offset-ul.
Serviciul a stat așa un timp — din fericire, cu Kafka nu este atât de grav, deoarece mesajele rămân. Când activitatea se va restabili, se vor putea citi. Este convenabil.
Kafka are opțiunea de a fixa un offset la alegere prin uneltele de lucru. Dar pentru a face acest lucru, trebuie să opriți toți consumatorii — în cazul nostru să pregătim o versiune separată în care nu vor fi consumatori, redeployments. Atunci, prin uneltele de lucru, se poate ajusta offset-ul în Kafka și mesajul va trece.
O altă nuanță — log de replicare vs rdkafka.so — este legat de specificitatea proiectului nostru. Avem PHP, iar în PHP, de obicei, toate bibliotecile comunică cu Kafka prin intermediul depozitului rdkafka.so, iar mai departe intervine un fel de wrapper. Poate că sunt dificultăți personale, dar s-a dovedit că a reciti o parte dintr-un text deja parcurs nu este tocmai simplu. În general, au fost probleme de programare.
Revenind la particularitățile lucrului cu partitions, este scris clar în documentație consumers >= topic partitions. Dar am aflat despre asta mult mai târziu decât mi-aș fi dorit. Dacă doriți să scalați și să aveți doi consumatori, aveți nevoie de cel puțin două partitions. Asta înseamnă că, dacă ați avut un singur partition în care s-au acumulat 20 de mii de mesaje, iar acum ați făcut unul nou, numărul mesajelor nu se va echilibra prea curând. Așa că, pentru a avea doi consumatori paraleli, trebuie să vă ocupați de partitions.
Monitorizare
Cred că, din modul în care monitorizăm, va fi și mai clar ce probleme există în abordarea actuală.
De exemplu, numărăm câte produse din baza de date și-au schimbat statusul recent, și, prin urmare, pe baza acestor schimbări ar fi trebuit să aibă loc evenimente, și trimitem acest număr în sistemul nostru de monitorizare. Apoi, din Kafka obținem al doilea număr, câte evenimente au fost de fapt înregistrate. Este evident că diferența dintre aceste două numere ar trebui să fie întotdeauna zero.
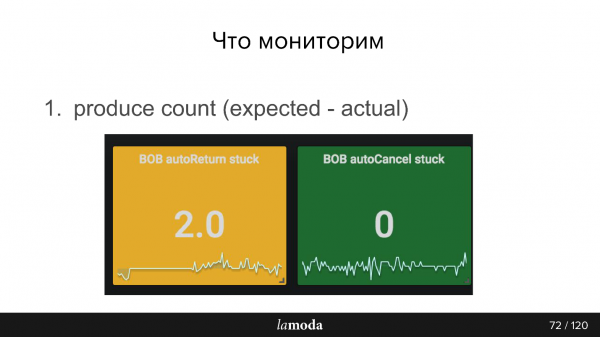
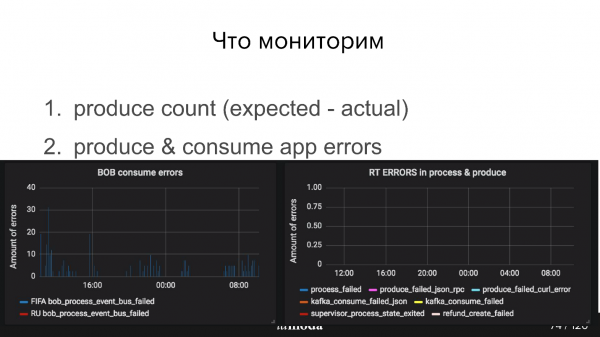
În plus, trebuie să monitorizăm cum stau lucrurile cu producătorul, dacă events-bus a primit mesajele, și cum stau lucrurile cu consumatorul. De exemplu, în graficele de mai jos, la Refund Tool totul este bine, iar la BOB sunt evident unele probleme (vârfuri albastre).
Am mai menționat întârzierile grupului de consumatori. În termeni simpli, acesta este numărul de mesaje neîncărcate. În general, consumatorii noștri funcționează repede, așa că întârzierile sunt de obicei 0, dar uneori poate apărea un vârf temporar. Kafka gestionează acest lucru din cutie, dar trebuie să impuneți un anumit interval.
Există un proiect , care vă va oferi mai multe informații despre Kafka. Acesta returnează pur și simplu, prin API, statutul grupului de consumatori, cum stau lucrurile cu acest grup. În afară de OK și Failed, există și warning, și veți putea afla că consumatorii voștri nu fac față ritmului de producție — nu reușesc să citească ceea ce se scrie. Sistemul este destul de inteligent, este convenabil de utilizat.
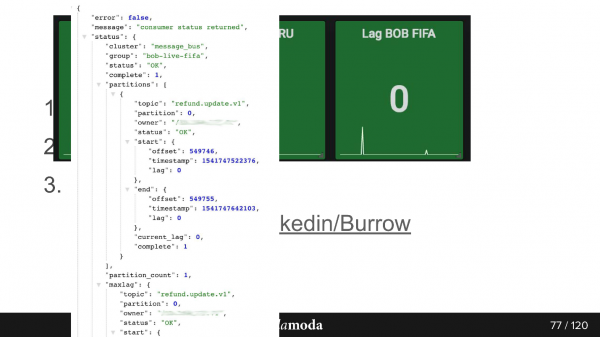
Așa arată răspunsul prin API. Aici grupul bob-live-fifa, partition refund.update.v1, statut OK, lag 0 — ultimul offset final este acesta.
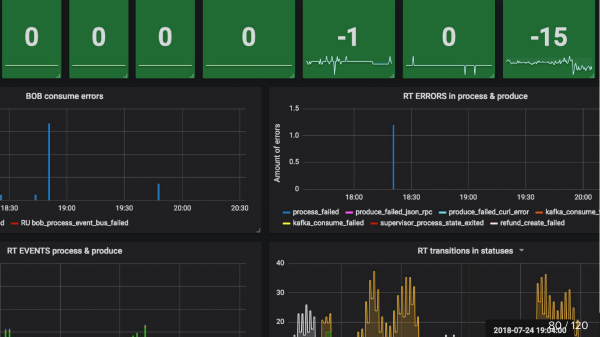
Monitorizare updated_at SLA (stuck) Am menționat deja. De exemplu, un produs a trecut în statutul de pregătit pentru returnare. Setăm un Cron care indică că, dacă în 5 minute obiectul respectiv nu a trecut în statutul de refund (noi returnăm banii foarte rapid prin sistemele de plată), atunci ceva s-a întâmplat cu siguranță greșit și acesta este cu siguranță un caz pentru suport. Așadar, folosim un Cron care citește astfel de situații, iar dacă acestea sunt mai mari decât 0, trimite un alert.
În concluzie, a folosi evenimentele este convenabil atunci când:
- informația este necesară pentru mai multe sisteme;
- rezultatul procesării nu este important;
- sunt puține evenimente sau evenimentele sunt mici.
Ar părea că articolul are un subiect foarte specific - API asincron pe Kafka, dar în legătură cu acesta vreau să recomand multe lucruri.
În primul rând, următorul nu trebuie să așteptăm până în noiembrie, deja în aprilie va fi versiunea sa din St. Petersburg, iar în iunie vom discuta despre sarcini mari în Novosibirsk.
În al doilea rând, autorul raportului, Serghei Zaika, face parte din Comitetul de Program al noii noastre conferințe despre managementul cunoștințelor . Conferința va fi de o zi, are loc pe 26 aprilie, dar programul său este foarte bogat.
Și de asemenea, în mai va avea loc și (cu DevOpsConf inclus) - acolo se pot propune încă teme, pentru a împărtăși experiența proprie și a ne plânge de loviturile primite.
Sursa: habr.com
