

Orice proiect major a început cu câteva servere. La început a fost un server DB, apoi s-au adăugat slave pentru a scala citirile. Și aici intervine o problemă! Există un singur master și multe slave; dacă unul dintre slave se defectează, totul va fi bine, dar dacă masterul se defectează, va fi rău: downtime, administratorii vor încerca să repornească serverul. Ce trebuie să facem? Să rezervăm masterul. Colegul meu Pavel a scris deja despre asta, , dar eu nu voi repeta. În schimb, voi explica de ce aveți nevoie de un Orchestrator pentru MySQL!
Să începem cu întrebarea principală: „Cum vom comuta codul pe o nouă mașină în cazul în care masterul se defectează?”
- Schema cu VIP (IP virtual) îmi place cel mai mult, despre ea vom discuta mai jos. Este cea mai simplă și evidentă, deși are o limitare clară: masterul pe care îl vom rezerva trebuie să se afle în segmentul L2 cu noua mașină, adică putem uita de al doilea DC. De asemenea, dacă respectăm regula că un L2 mare este o problemă, deoarece L2 este doar între rack-uri, iar între rack-uri avem L3, o astfel de schemă are și mai multe limitări.
- Putem scrie numele DNS în cod și să-l rezolvăm prin /etc/hosts. De fapt, nu va exista o rezolvare. Avantajul schemei este că nu există limitarea specifică pentru prima metodă, ceea ce permite organizarea chiar și a cross-DC. Dar apoi apare o întrebare evidentă, cât de repede vom aduce modificarea în /etc/hosts prin Puppet-Ansible.
- Putem modifica puțin a doua metodă: pe toate serverele web să instalăm un DNS de cache, prin care codul va accesa baza de date master. Putem seta TTL 60 pentru această înregistrare DNS. Pare că, cu o implementare corectă, metoda este bună.
- Schema cu descoperirea serviciilor, care implică utilizarea Consul și etcd.
- O variantă interesantă cu . Este necesar să redirecționăm tot traficul către MySQL prin ProxySQL, care poate determina cine este acum master. Apropo, despre una dintre utilizările acestui produs, puteți citi în postarea mea .
Autorul Orchestrator, lucrând la Github, a implementat inițial prima schemă cu VIP, apoi a adaptat schema cu consul.
Schema tipică de infrastructură:
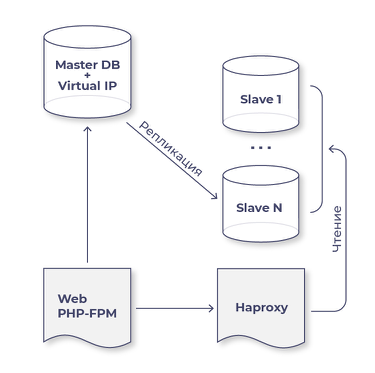
Voi descrie imediat situațiile evidente care trebuie luate în considerare:
- Adresa VIP nu trebuie să fie specificată în configurația niciunuia dintre servere. Să ne imaginăm situația: masterul s-a repornit, iar în timp ce se încarcă, Orchestrator a trecut în modul failover și a făcut din unul dintre slave-uri master; apoi vechiul master s-a repornit, iar acum VIP este pe două mașini. Aceasta este o problemă.
- Pentru orchestrator, va trebui să scriem un script pentru a interacționa cu vechiul și noul maestru. Pe vechi trebuie să executăm ifdown, iar pe noul maestru — ifup vip. Ar fi bine să adăugăm în acest script că, în caz de failover, portul de pe switch-ul vechiului maestru va fi pur și simplu dezactivat, pentru a evita orice split-brain.
- După ce Orchestrator a apelat scriptul dumneavoastră pentru a dezactiva mai întâi VIP și/sau pentru a dezactiva portul de pe switch, iar apoi pe noul maestru a apelat scriptul pentru activarea VIP-ului, nu uitați să folosiți comanda arping pentru a informa pe toți că noul VIP este acum aici.
- Toate slavele trebuie să aibă setarea read_only=1, iar imediat ce promovați un slave la statutul de maestru, aceasta trebuie să devină read_only=0.
- Nu uitați că oricare slave poate deveni maestru, pe care l-am selectat pentru aceasta (Orchestrator dispune de un mecanism întreg de preferințe pentru a selecta care slave să fie considerate ca potențiali maeștri în primul rând, în al doilea rând și care slave să nu fie deloc selectate ca maeștri). Dacă un slave devine maestru, el va păstra încărcătura slave-ului și va adăuga încărcătura maestrului, lucru ce trebuie avut în vedere.
De ce aveți nevoie neapărat de Orchestrator, dacă nu îl aveți?
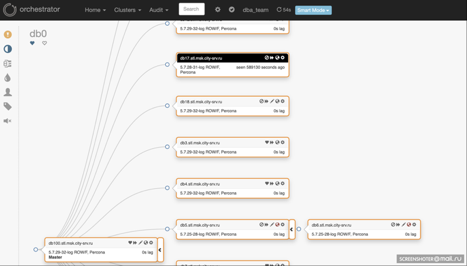
- Orchestrator are o interfață grafică foarte prietenoasă, care afișează întreaga topologie (consultați captura de ecran de mai jos).
- Orchestrator poate urmări care slave au întârziat și unde replicarea a eșuat complet (avem scripturi integrate în Orchestrator pentru a trimite SMS-uri).
- Orchestrator vă indică pe care slave există erori GTID errant.
Interfața Orchestrator:
Ce este GTID errant?
Există două cerințe principale pentru funcționarea Orchestrator:
- Este necesar ca pe toate mașinile din clusterul MySQL să fie activat pseudo GTID, iar la noi este activat GTID.
- Este necesar ca în toate locurile să existe același tip de binloguri, care poate fi statement. Am avut o astfel de configurație, unde pe maestru și pe majoritatea slave-urilor era setat Row, iar pe două dintre ele a rămas istoric modul Mixed. Drept urmare, aceste slave Orchestrator pur și simplu nu a dorit să le conecteze la noul maestru.
Rețineți că cel mai important lucru pentru un slave în producție este consistența sa cu maestrul! Dacă atât pe maestru, cât și pe slave este activat Global Transaction ID (GTID), prin funcția gtid_subset se poate verifica dacă aceleași interogări de modificare a datelor au fost efectuate cu adevărat pe aceste mașini. Puteți citi mai multe despre acest subiect. .
Astfel, Orchestrator vă arată prin eroarea GTID errant că pe slave există tranzacții care nu sunt pe master. De ce se întâmplă asta?
- Pe slave, read_only=1 nu este activat, iar cineva s-a conectat și a executat o interogare de modificare a datelor.
- Pe slave, super_read_only=1 nu este activat, astfel încât un administrator, confundând serverele, s-a conectat și a executat o interogare acolo.
- Dacă ați luat în considerare ambele puncte anterioare, există încă o capcană: în MySQL, interogarea de flush a binlogurilor este, de asemenea, înregistrată în binlog, deci la prima flush pe master și pe toate slavele va apărea GTID errant. Cum se poate evita acest lucru? În versiunea perona-5.7.25-28 a fost introdusă setarea binlog_skip_flush_commands=1, care interzice scrierea flush-urilor în binloguri. Pe site-ul mysql.com există informații despre aceasta. .
Rezumând cele de mai sus. Dacă înca nu doriți să folosiți Orchestrator în modul failover, atunci setați-l în modul de observație. Așa veți avea întotdeauna la îndemână o hartă a interacțiunii între mașinile MySQL și informații vizuale despre tipul de replicare de pe fiecare mașină, dacă slavele sunt întârziate și, cel mai important, cât de consistente sunt cu masterul!
O întrebare evidentă: „Cum ar trebui să funcționeze Orchestrator?”. El ar trebui să aleagă un nou master dintre slavele curente și apoi să le reconecteze pe toate la acesta (tocmai de aceea este necesar GTID; dacă s-ar folosi mecanismul vechi cu binlog_name și binlog_pos, atunci nu ar fi posibil să se schimbe slavele de la masterul curent la unul nou!). Până să avem Orchestrator, a trebuit odată să fac totul manual. Vechea mașină master s-a blocat din cauza unui controler defectuos Adaptec, având aproximativ 10 slave. A trebuit să transfer VIP-ul de pe master pe una dintre slave și să reconectez toate celelalte slave la ea. Câte console a trebuit să deschid, câte comenzi simultane a trebuit să introduc… A trebuit să aștept până la 3 dimineața, să iau sarcina de pe toate slavele, cu excepția a două, să fac prima mașină din aceste două master, să le conectez imediat pe a doua mașină, apoi să reconectez toate celelalte slave la noul master și să reîntorc sarcina. În general, a fost un coșmar...
Cum funcționează Orchestrator când trece în modul failover? Cel mai simplu este să ilustrezi prin exemplul unei situații în care dorim să facem master o mașină mai puternică, mai modernă decât cea actuală.
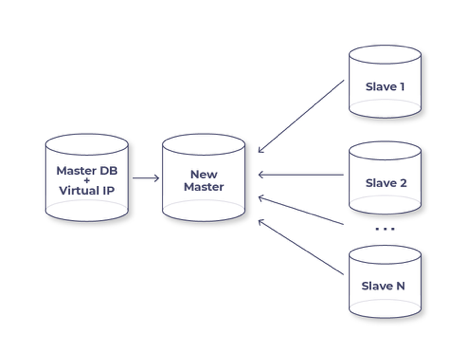
Imaginea ilustrează mijlocul procesului. Ce s-a realizat deja până în acest moment? Am spus că dorim să facem un anumit slave noul master, iar Orchestratorul a început pur și simplu să reconecteze toate celelalte slave la el, în timp ce noul master îndeplinește rolul de mașină de tranziție. În această schemă nu apar erori, toate slavele funcționează, Orchestratorul elimină VIP-ul de pe vechiul master, îl transferă pe noul master, setează read_only=0 și uită de vechiul master. Tot! Timpul de nefuncționare al serviciului nostru este timpul necesar pentru transferul VIP-ului, adică 2-3 secunde.
Asta e tot pentru azi, mulțumesc tuturor. În curând va apărea al doilea articol despre Orchestrator. Într-un cunoscut film sovietic „Garaj”, un personaj a spus: „Nu m-aș duce cu el în recunoaștere!” Așa că Orchestrator, eu m-aș duce cu tine în recunoaștere!
Sursa: habr.com
