

În Sitimobil, folosim baza de date MySQL ca principal depozit pentru datele permanente. Avem mai multe clustere de baze de date pentru diferite servicii și scopuri.
Disponibilitatea constantă a masterului este un indicator critic al funcționalității întregului sistem și al părților sale. Recuperarea automată a clusterului în caz de avarie a masterului reduce semnificativ timpul de reacție la incident și timpul de nefuncționare a sistemului. În acest articol, voi discuta despre schema de asigurare a disponibilității ridicate (HA) a clusterului MySQL pe baza și adreselor IP virtuale (VIP).
Soluția HA bazată pe VIP
Mai întâi, voi prezenta pe scurt ce reprezintă sistemul nostru de stocare a datelor.
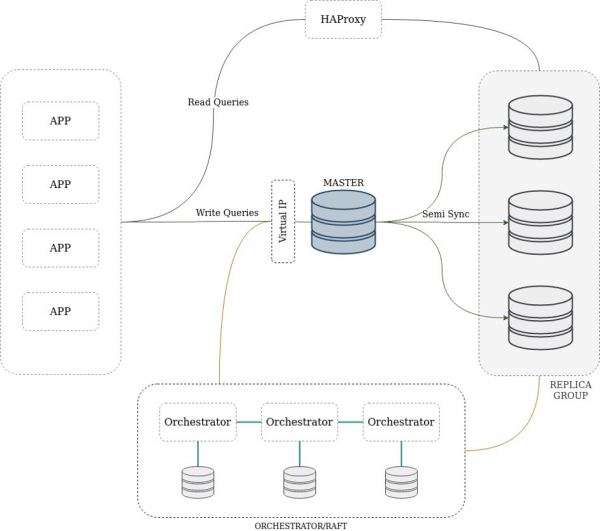
Folosim o schemă clasică de replicare cu un master disponibil pentru scriere și multe replici, care sunt folosite numai pentru citire. Clusterul poate conține un master intermediar — un nod care este atât replică, cât și master pentru altele. Clienții se conectează la replici prin HAProxy, ceea ce permite o distribuție uniformă a încărcăturii și o scalare ușoară. Utilizarea HAProxy se bazează pe motive istorice, iar acum suntem în proces de migrare către ProxySQL.
Replicarea se face în modul semi-sincron, pe baza GTID. Aceasta înseamnă că cel puțin o replică trebuie să scrie tranzacția în jurnal înainte ca aceasta să fie considerată reușită. Acest mod de replicare oferă un echilibru optim între performanță și integritatea datelor în cazul unei defecțiuni a nodului principal. În principal, toate modificările sunt transmise de la master la replici prin Row Based Replication (RBR), dar unele noduri pot avea mixed binlog format.
Orchestratorul actualizează periodic starea topologiei clusterului, analizează informațiile primite și, în cazul unor probleme, poate iniția procedura de recuperare automată. Responsabilitatea pentru procedură revine dezvoltatorului, deoarece aceasta poate fi implementată în mai multe moduri: pe baza VIP, DNS, folosind servicii de descoperire a serviciilor (service discovery) sau mecanisme personalizate.
Una dintre modalitățile simple de restaurare a masterului în cazul unei defecțiuni este utilizarea adreselor VIP flotante.
Ce trebuie să știi despre această soluție înainte de a merge mai departe:
- VIP este o adresă IP care nu este legată de o interfață de rețea fizică specifică. Atunci când un nod eșuează sau în timpul lucrărilor planificate, putem comuta VIP-ul pe un alt resursă cu un timp minim de nefuncționare.
- Eliberarea și alocarea unei adrese IP virtuale sunt operațiuni ieftine și rapide.
- Pentru a lucra cu VIP este necesar accesul la server prin SSH sau utilizarea de utilitare speciale, cum ar fi
keepalived.
Să analizăm problemele posibile cu maestrul nostru și să ne imaginăm cum ar trebui să funcționeze mecanismul de recuperare automată.
A dispărut conectivitatea de rețea către maestru sau a apărut o problemă la nivel de hardware, iar serverul devine inaccesibil.
- Orchestratorul actualizează topologia clusterului, fiecare replică raportează indisponibilitatea maestrului. Orchestratorul inițiază procesul de selectare a unei replici potrivite pentru rolul de nou maestru și începe recuperarea.
- Încercăm să eliberăm VIP-ul de la vechiul maestru - fără succes.
- Replica trece în rolul de maestru. Topologia se restructurează.
- Adaugăm o nouă interfață de rețea cu VIP. Deoarece nu am reușit să eliberăm VIP-ul, în fundal inițiem trimiterea periodică a unei solicitări gratuitous ARP. Această formă de solicitare/răspuns permite actualizarea tabelei de asociație IP și MAC pe switch-urile conectate, notificând astfel despre mutarea VIP-ului nostru. Acest lucru minimizează probabilitatea de
split brainîn cazul revenirii vechiului maestru. - Toate noile conexiuni sunt imediat redirecționate către noul maestru. Conexiunile mai vechi se finalizează cu eșec, iar apelurile la baza de date la nivel de aplicație sunt repetate.
Serverul funcționează în mod normal, s-a produs o defectare la nivelul SGBD-ului.
Algoritmul este similar cu cazul anterior: actualizarea topologiei și inițierea procesului de recuperare. Deoarece serverul este accesibil, eliberăm cu succes VIP-ul de la vechiul maestru, îl mutăm pe cel nou și trimitem câteva solicitări ARP. O eventuală revenire a vechiului maestru nu ar trebui să afecteze clusterul restructurat și funcționarea aplicației.
Alte probleme
Defectarea replicilor sau a masterelor intermediare nu duce la acțiuni automate și necesită intervenție manuală.
Interfațele de rețea virtuale sunt adăugate temporar, ceea ce înseamnă că după repornirea serverului, VIP-ul nu este alocat automat. Fiecare instanță de bază de date pornește în mod implicit în modul de citire, orchestratorul activează automat un nou master pentru scriere și încearcă să stabilească doar citire pe vechiul master. Aceste acțiuni sunt menite să reducă probabilitatea split brain.
În procesul de recuperare pot apărea probleme, despre care ar trebui să se notifice și prin UI-ul orchestratorului, pe lângă instrumentele standard de monitorizare. Am extins REST API-ul adăugând această capacitate ( este în prezent în examinare).
Schema generală a soluției HA este prezentată mai jos.
Alegerea unui nou master
Orchestratorul este destul de inteligent și se străduiește să aleagă ca nou master pe baza următoarelor criterii:
- întârzierea replicii față de master;
- versiunea MySQL a masterului și replicii;
- tipul de replicare (RBR, SBR sau mixed);
- locația în același sau în diferite centre de date;
- existența
GTID eronat— tranzacții care au fost efectuate pe replică și lipsesc de pe master; - de asemenea, se iau în considerare regulile personalizate de selecție.
Nu fiecare replică este un candidat ideal pentru rolul de master. De exemplu, replica poate fi utilizată pentru backup de date sau serverul poate avea o configurație hardware mai slabă. Orchestratorul reguli manuale, prin care se pot stabili preferințele proprii pentru alegerea candidatului de la cele mai preferate la cele ignorate.
Timp de reacție și recuperare
În cazul unui incident, este important să se minimizeze timpul de nefuncționare a sistemului, de aceea să analizăm opțiunile MySQL care influențează construirea și actualizarea topologiei clusterei de către orchestrator:
- — numărul de secunde în care replica așteaptă primirea de noi date sau un semnal heartbeat de la master, înainte ca conexiunea să fie considerată pierdută și să se efectueze reconectarea. Cu cât valoarea este mai mică, cu atât replica poate determina mai repede că legătura cu masterul este întreruptă. Stabilim această valoare la 5 secunde.
- — numărul de secunde între încercările de reconectare. În cazul problemelor de rețea, o valoare scăzută a acestui parametru va permite reconectarea rapidă și va preveni inițierea procesului de recuperare a clusterului. Valoarea recomandată este de 1 secundă.
MASTER_RETRY_COUNT— numărul maxim de încercări de reconectare.MASTER_HEARTBEAT_PERIOD— intervalul în secunde după care masterul trimite un semnal de puls. Implicit este egal cu jumătate din valoareaslave_net_timeout.
Parametrii orchestratorului:
DelayMasterPromotionIfSQLThreadNotUpToDate— dacă este egal cutrue, atunci rolul de master nu va fi aplicat pe replica-candidat până când fluxul SQL al replicii nu va aplica toate tranzacțiile neaplicate din Relay Log. Folosim această opțiune pentru a nu pierde tranzacții în condiții de întârziere a tuturor replicilor-candidate.InstancePollSeconds— frecvența construirea și actualizarea topologiei.RecoveryPollSeconds— frecvența analizei topologiei. În cazul depistării unei probleme, se inițiază recuperarea topologiei. Aceasta, egală cu 1 secundă.
Fiecare nod al clusterului este interogat de orchestrator o dată la InstancePollSeconds secunde. În cazul depistării unei probleme, starea clusterului este actualizată forțatTestarea schemei HA a început cu dezvoltarea unui
Banc de testare
stand de testare local În timpul exercițiilor, alegem una dintre metodele de simulare a problemei: a opri instantaneu masterul folosind
, a încheia procesul în mod elegant și a opri serverul ( kill -9docker-compose stop), a simula probleme de rețea folosindiptables -j REJECT iptables -j DROP sau . Ne așteptăm la următoarele rezultate:orchestratorul va depista probleme cu masterul și va actualiza topologia în maximum 10 secunde;
- procedura de recuperare va demara automat: configurația rețelei se va schimba, rolul de master va trece la replica, topologia se va reconstrui;
- автоматически запустится процедура восстановления: изменится сетевая конфигурация, роль мастера перейдёт к реплике, топология перестроится;
- noul master va deveni disponibil pentru scriere, replicile active nu vor fi pierdute în procesul de reconstrucție;
- datele vor începe să fie scrise în noul master și să fie replicat;
- timpul total de recuperare va fi de maximum 30 de secunde.
După cum știți, sistemul poate acționa diferit în mediile de testare și producție din cauza configurației diferite a hardware-ului și rețelei, diferențelor dintre sarcinile sintetice și reale etc. Prin urmare, periodic desfășurăm exerciții în condiții reale, testând cum se comportă sistemul în cazul pierderii conectivității de rețea sau degradării unor părți ale acestuia. În viitor, dorim să construim o infrastructură complet identică pentru ambele medii și să automatizăm testarea acesteia.
Conclusions
Funcționarea principalului nod al sistemului de stocare a datelor este una dintre sarcinile principale ale echipei SRE și operațiunilor. Implementarea orchestratorului și a soluției HA bazate pe VIP a permis obținerea următoarelor rezultate:
- detectarea fiabilă a problemelor cu topologia cluster-ului DB;
- reacția automată și rapidă la incidentele legate de master, ceea ce reduce timpul de nefuncționare al sistemului.
Cu toate acestea, soluția are limitările și dezavantajele sale:
- extinderea schemei HA pe mai multe centre de date va necesita o rețea L2 unică între acestea;
- înainte de a atribui VIP noului master, trebuie să-l eliberăm de pe cel vechi. Procesul este secvențial, ceea ce crește timpul de recuperare;
- eliberarea VIP necesită acces SSH la server, sau orice alt mod de a apela proceduri la distanță. Deoarece serverul sau DB-ul întâmpină probleme, care au cauzat procesul de recuperare, nu putem fi siguri că eliminarea VIP-ului se va finaliza cu succes. Iar acest lucru poate duce la apariția a două servere cu aceeași adresă IP virtuală și la probleme
split brain.
Pentru a evita split brain, se poate folosi metoda ('Shoot The Other Node In The Head'), care izolează complet sau dezactivează nodul problematic. Există și alte moduri de a implementa înaltă disponibilitate a cluster-ului: combinația de VIP și DNS, detectarea serviciilor și servicii proxy, replicarea sincronă și alte metode, fiecare având propriile dezavantaje și avantaje.
Am vorbit despre abordarea noastră în crearea unui cluster MySQL rezistent la erori. Este simplu de implementat și oferă un nivel acceptabil de fiabilitate în condițiile actuale. Pe măsură ce întreaga sistemă și infrastructura în special evoluează, această abordare va evolua cu siguranță.
Sursa: habr.com
