

În această primăvară, am discutat deja despre unele teme introductive, cum ar fi și . În a doua dintre ele, am promis chiar că vom continua să studiem performanța diferitelor topologii multi-disc în ZFS. Aceasta este un sistem de fișiere de nouă generație, care acum este implementat peste tot: de la la .
Ei bine, astăzi este ziua perfectă pentru a ne familiariza cu ZFS, cititori curioși. Trebuie să știți că, conform estimărilor modeste ale dezvoltatorului OpenZFS, Matt Arens, „este într-adevăr complicat”.
Dar înainte să ajungem la cifre - și vor fi, promit - pentru toate opțiunile de configurație cu opt discuri din ZFS, trebuie să discutăm despre cum modul în care ZFS stochează datele pe disc.
Zpool, vdev și device
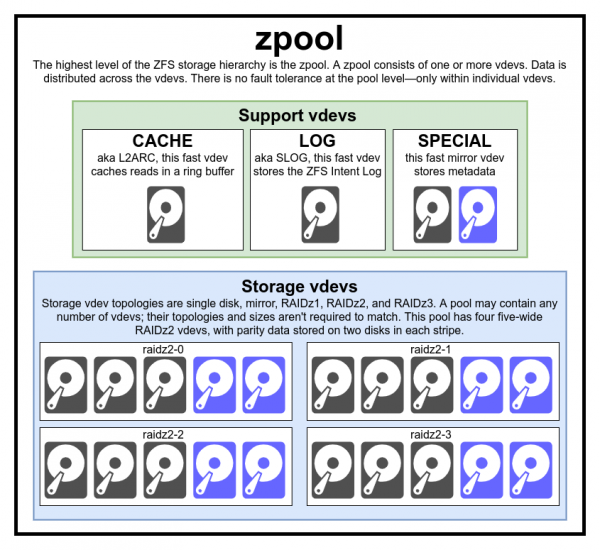
Această diagramă a unui pool complet include trei vdev-uri auxiliare, câte unul din fiecare clasă, și patru pentru RAIDz2
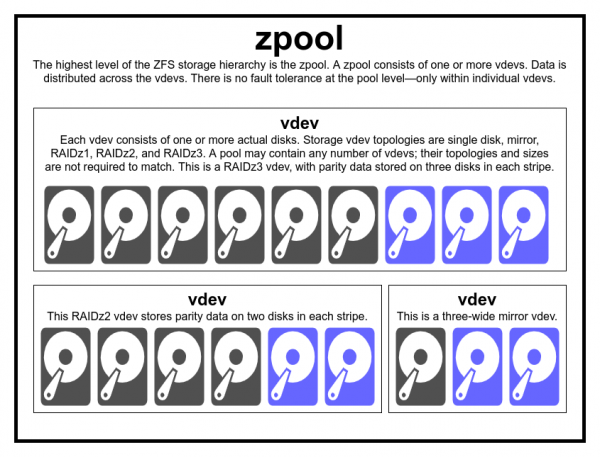
În general, nu există motive pentru a crea un pool din tipuri și dimensiuni necorespunzătoare de vdev - dar dacă doriți, nimic nu vă oprește să faceți asta.
Pentru a înțelege cu adevărat sistemul de fișiere ZFS, trebuie să ne uităm atent la structura sa efectivă. În primul rând, ZFS combină nivelurile tradiționale de gestionare a volumelor și sistemului de fișiere. În al doilea rând, folosește un mecanism de tranzacționare cu copiere la scriere. Aceste caracteristici înseamnă că sistemul este structural foarte diferit de sistemele de fișiere obișnuite și de array-urile RAID. Primul set de blocuri fundamentale pentru înțelegere: este pool-ul de stocare (zpool), dispozitivul virtual (vdev) și dispozitivul real (device).
zpool
Pool-ul de stocare zpool este cea mai înaltă structură ZFS. Fiecare pool conține unul sau mai multe dispozitive virtuale. La rândul său, fiecare dintre acestea conține unul sau mai multe dispozitive reale (device). Pooile virtuale sunt blocuri autonome. Un computer fizic poate conține două sau mai multe pool-uri separate, dar fiecare este complet independent de celelalte. Pool-urile nu pot împărtăși dispozitivele virtuale.
Redundanța ZFS se află la nivelul dispozitivelor virtuale, nu la nivelul pool-urilor. La nivelul pool-urilor nu există absolut nicio redundanță - dacă un dispozitiv vdev sau un vdev special se pierde, atunci împreună cu el se pierde și întregul pool.
Pool-urile de stocare moderne pot supraviețui pierderii cache-ului sau jurnalului dispozitivului virtual - deși pot pierde o cantitate mică de date murdare dacă jurnalul vdev se pierde în timpul unei întreruperi de curent sau a unei defecțiuni a sistemului.
Există o concepție greșită comună că „benzile de date” (stripes) ZFS sunt scrise pe întregul pool. Acest lucru este fals. Zpool nu este deloc un RAID0 amuzant, mai degrabă un cu un mecanism complex și variabil de distribuire.
În cea mai mare parte, înregistrările sunt distribuite între dispozitivele virtuale disponibile conform spațiului liber disponibil, astfel încât teoretic toate vor fi completate simultan. În versiunile mai recente ale ZFS, se ia în considerare utilizarea curentă (utilizarea) vdev - dacă un dispozitiv virtual este semnificativ mai încărcat decât altul (de exemplu, din cauza unei sarcini de citire), acesta va fi sărit temporar pentru scriere, în ciuda faptului că are cel mai mare coeficient de spațiu liber.
Mecanismul de determinare a utilizării, integrat în metodele moderne de distribuire a scrierii ZFS, poate reduce latența și crește lățimea de bandă în perioadele de sarcină neobișnuit de mare - dar aceasta nu este un cec în alb pentru a amesteca fără voie HDD-uri lente și SSD-uri rapide într-un singur pool. Un astfel de pool inegal va funcționa totuși la viteza celui mai lent dispozitiv, adică de parcă ar fi compus în întregime din astfel de dispozitive.
vdev
Fiecare pool de stocare constă din unul sau mai multe dispozitive virtuale (virtual device, vdev). La rândul său, fiecare vdev include unul sau mai multe dispozitive reale. Cele mai multe dispozitive virtuale sunt utilizate pentru stocarea simplă a datelor, dar există câteva clase de vdev auxiliare, inclusiv CACHE, LOG și SPECIAL. Fiecare dintre aceste tipuri de vdev poate avea una dintre cele cinci topologii: dispozitiv unic (single-device), RAIDz1, RAIDz2, RAIDz3 sau oglindă (mirror).
RAIDz1, RAIDz2 și RAIDz3 sunt variante speciale ale ceea ce vechiul a numit RAID cu dublă paritate (diagonală). 1, 2 și 3 se referă la câte blocuri de paritate sunt alocate pentru fiecare bandă de date. În loc de discuri separate pentru asigurarea parității, dispozitivele RAIDz distribuie uniform această paritate pe discuri. Un RAIDz poate pierde atâtea discuri câte blocuri de paritate are; dacă pierde încă unul, va ceda și va duce cu el întregul pool de stocare.
În dispozitivele virtuale mirror (mirror vdev), fiecare bloc este stocat pe fiecare dispozitiv din vdev. Deși cele mai comune sunt oglinzile duble (two-wide), în oglindă poate fi un număr arbitrar de dispozitive – în instalările mari, pentru a îmbunătăți performanța la citire și rezistența la defecte, sunt adesea folosite oglinzi triple. O oglindă vdev poate supraviețui oricărei defecțiuni, atâta timp cât funcționează cel puțin un dispozitiv în vdev.
vdev-urile unice sunt, prin natura lor, periculoase. Un astfel de dispozitiv virtual nu va supraviețui niciunei defecțiuni – iar dacă este folosit ca stocare sau ca vdev special, defecțiunea sa va duce la distrugerea întregului pool. Fiți aici foarte, foarte atenți.
Dispozitivele virtuale CACHE, LOG și SPECIAL pot fi create conform oricărei dintre topologiile enumerate mai sus – dar amintiți-vă că pierderea unui dispozitiv virtual SPECIAL înseamnă pierderea pool-ului, de aceea se recomandă cu tărie o topologie redundantă.
dispozitiv
Probabil că acesta este cel mai simplu termen de înțeles în ZFS – se referă literalmente la un dispozitiv de bloc de acces aleatoriu. Amintiți-vă că dispozitivele virtuale sunt compuse din dispozitive separate, iar pool-ul este format din dispozitive virtuale.
Discurile – magnetice sau cu stare solidă – sunt cele mai frecvente dispozitive de bloc folosite ca elemente de bază ale vdev-ului. Totuși, orice dispozitiv cu un descripitor în /dev este acceptabil – astfel, pot fi folosite întregi matrice RAID hardware ca dispozitive separate.
Un fișier raw simplu este unul dintre cele mai importante alternative ale dispozitelor de bloc, din care poate fi construit un vdev. Pool-urile de test sunt o modalitate foarte convenabilă de a verifica comenzile pool-ului și a vedea câte spațiu este disponibil în pool sau discul virtual din această topologie.
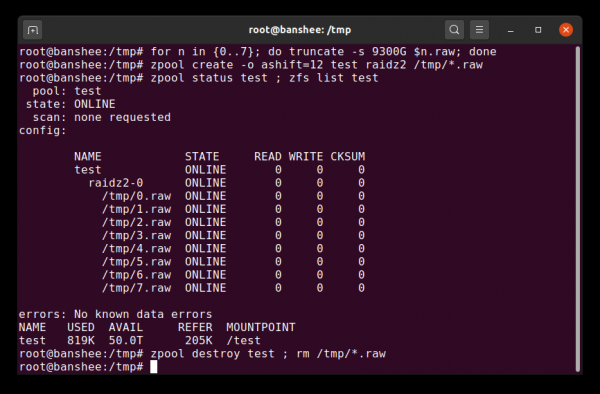
Puteți crea un pool de test din fișiere sparse în câteva secunde – dar nu uitați să ștergeți ulterior tot pool-ul și componentele sale.
Să presupunem că doriți să configurați un server cu opt discuri și intenționați să folosiți discuri de 10 TB (~9300 GiB) – dar nu sunteți sigur care topologie se potrivește cel mai bine nevoilor dumneavoastră. În exemplul de mai sus, construim un pool de test din fișiere sparse în câteva secunde – și acum știm că un vdev RAIDz2 format din opt discuri de 10 TB oferă 50 TiB de capacitate utilă.
O altă clasă specială de dispozitive este SPARE (de rezervă). Dispozitivele hot-swap, spre deosebire de cele obișnuite, aparțin întregului pool, nu unui singur dispozitiv virtual. Dacă un vdev din pool eșuează, iar dispozitivul de rezervă este conectat la pool și disponibil, acesta se va alătura automat vdev-ului afectat.
După ce se conectează la vdev-ul afectat, dispozitivul de rezervă începe să primească copii sau reconstrucții ale datelor care ar trebui să fie pe dispozitivul lipsă. În RAID-ul tradițional, acest lucru se numește recuperare (rebuilding), iar în ZFS, 'recuperare a redundanței' (resilvering).
Este important de menționat că dispozitivele de rezervă nu înlocuiesc permanent dispozitivele defecte. Acestea sunt doar o înlocuire temporară pentru a reduce timpul în care vdev-ul este degradat. După ce administratorul înlocuiește dispozitivul defect din vdev, are loc recuperarea redundanței pentru acest dispozitiv permanent, iar SPARE se deconectează de la vdev și revine la funcția de rezervă pentru întregul pool.
Seturi de date, blocuri și sectoare
Următorul set de blocuri fundamentale pe care trebuie să-l înțelegem în călătoria noastră prin ZFS se referă mai puțin la hardware și mai mult la modul în care sunt organizate și stocate datele în sine. Sărim peste câteva niveluri – cum ar fi metaslab – pentru a nu aglomera detalii, păstrând înțelegerea structurii generale.
Set de date (dataset)
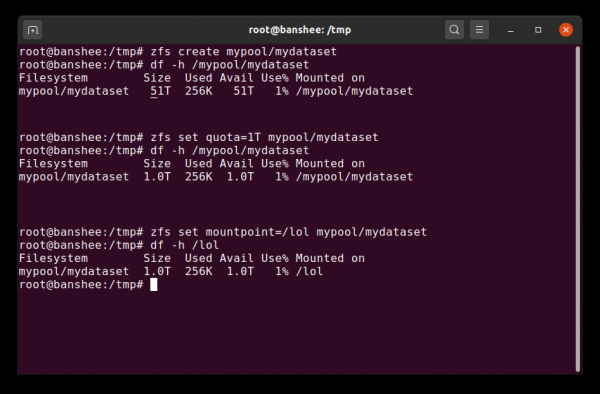
Când creăm pentru prima dată un set de date, acesta arată tot spațiul disponibil al pool-ului. Apoi stabilim o cotă – și schimbăm punctul de montare. Magie!
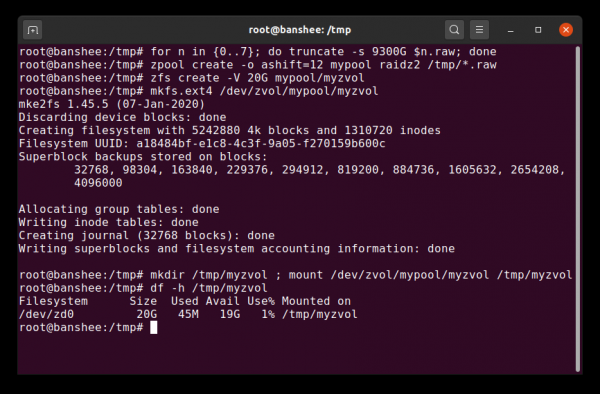
Zvol este, în cea mai mare parte, doar un set de date lipsit de stratul său de sistem de fișiere, pe care îl înlocuim aici cu un sistem de fișiere normal, ext4.
Setul de date ZFS este aproximativ echivalent cu un sistem de fișiere montat standard. La prima vedere, acesta arată „pur și simplu ca un alt folder”. Dar, asemenea sistemelor de fișiere montate obișnuite, fiecare set de date ZFS are propriul său set de proprietăți fundamentale.
În primul rând, un set de date poate avea o cotă alocată. Dacă stabilim zfs set quota=100G poolname/datasetname, atunci nu vei putea scrie în folderul montat /poolname/datasetname cu mai mult de 100 GiB.
Ai observat prezența - și absența - slash-urilor la începutul fiecărei linii? Fiecare set de date are propriul său loc atât în ierarhia ZFS, cât și în ierarhia montării sistemului. În ierarhia ZFS nu există slash inițial - începi cu numele pool-ului și apoi urmezi calea de la un set de date la altul. De exemplu, pool/parent/child pentru un set de date cu numele child sub setul de date părinte parent într-un pool cu un nume creativ pool.
În mod implicit, punctul de montare al setului de date va fi echivalent cu numele său în ierarhia ZFS, cu un slash la început - pool-ul cu numele pool se va monta ca /pool, setul de date parent se montează în /pool/parent, iar setul de date copil child se montează în /pool/parent/child. Totuși, punctul de montare al setului de date în sistem poate fi schimbat.
Dacă specificăm zfs set mountpoint=/lol pool/parent/child, atunci setul de date pool/parent/child se va monta în sistem ca /lol.
În plus față de seturile de date, trebuie să menționăm volumele (zvols). O volumul este aproximativ echivalent cu un set de date, cu excepția faptului că nu are de fapt un sistem de fișiere - este pur și simplu un dispozitiv bloc. Poți, de exemplu, să creezi zvol cu numele mypool/myzvol, apoi să-l formatezi cu un sistem de fișiere ext4 și să montezi acest sistem de fișiere - acum ai un sistem de fișiere ext4, dar cu suport pentru toate funcțiile de securitate ZFS! Poate părea nebun pe un singur computer, dar are mult mai mult sens ca backend la exportarea unui dispozitiv iSCSI.
Unități
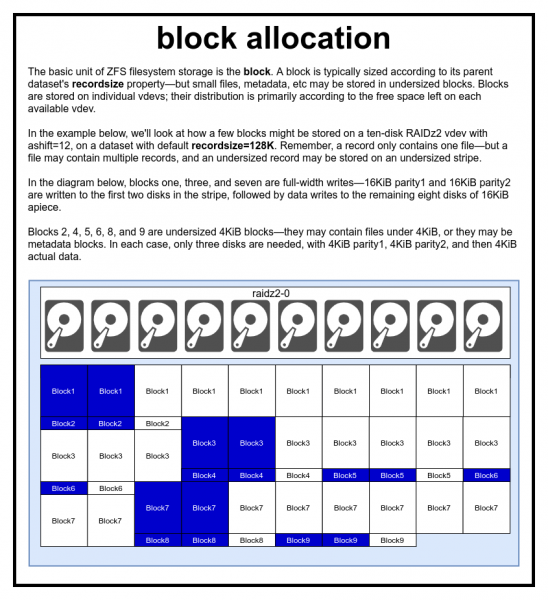
Un fișier este prezentat prin unul sau mai multe blocuri. Fiecare bloc este stocat pe un singur dispozitiv virtual. Dimensinea blocului este de obicei echivalentă cu parametrul recordsize, dar poate fi redusă la 2^ashift, dacă conține metadate sau un fișier mic.
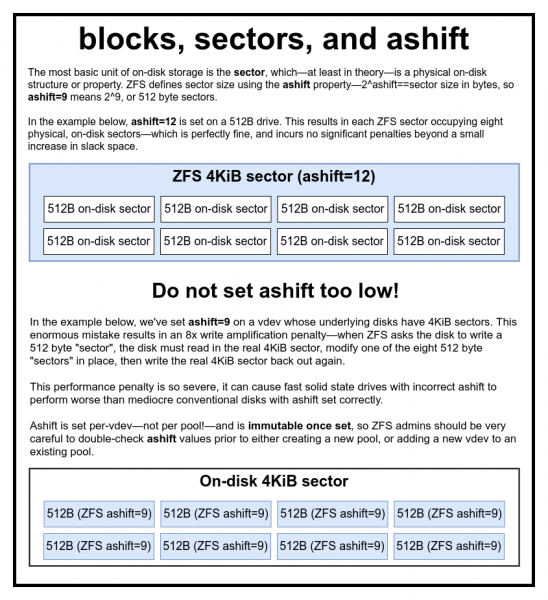
Noi chiar nu cu adevărat glumim în legătură cu daunele enorme de performanță dacă setăm un ashift prea mic.
În pool-ul ZFS, toate datele, inclusiv metadatele, sunt stocate în blocuri. Dimensiunea maximă a blocului pentru fiecare set de date este stabilită în proprietatea recordsize (dimensiunea înregistrării). Dimensiunea înregistrării poate varia, dar aceasta nu va schimba dimensiunea sau locația vreunor blocuri care au fost deja scrise în setul de date - ea se aplică doar pentru noile blocuri pe măsură ce sunt scrise.
Dacă nu este specificat altceva, dimensiunea curentă a înregistrării este, în mod implicit, 128 KiB. Aceasta este, într-un fel, un compromis rezonabil, în care performanța nu va fi ideală, dar nici nu va fi groaznică în majoritatea cazurilor. Dimensiune înregistrare poate fi setată pe orice valoare de la 4K la 1M (cu setări suplimentare recordsize poate fi setată chiar mai mare, dar asta este rar o idee bună).
Fiecare bloc face referire la datele unui singur fișier - nu poți înghesui două fișiere diferite într-un singur bloc. Fiecare fișier este compus din unul sau mai multe blocuri, în funcție de dimensiunea sa. Dacă dimensiunea fișierului este mai mică decât dimensiunea înregistrării, acesta va fi păstrat într-un bloc mai mic - de exemplu, un bloc cu un fișier de 2 KiB va ocupa doar un sector de 4 KiB pe disc.
Dacă fișierul este suficient de mare și necesită mai multe blocuri, atunci toate înregistrările cu acest fișier vor avea dimensiunea recordsize - inclusiv ultima înregistrare, a cărei parte principală poate fi .
Volumele zvol nu au proprietatea recordsize - în loc de aceasta, au o proprietate echivalentă volblocksize..
Sectoare
Ultimul, cel mai de bază element constructiv este sectorul. Aceasta este cea mai mică unitate fizică care poate fi scrisă sau citită de pe dispozitivul de bază. De-a lungul a câteva decenii, majoritatea discurilor au folosit sectoare de 512 octeți. În ultima vreme, majoritatea discurilor sunt configurate cu sectoare de 4 KiB, iar în unele - în special SSD-urile - sectoare de 8 KiB sau chiar mai mari.
În sistemul ZFS există o proprietate care permite setarea manuală a dimensiunii sectorului. Această proprietate ashift. Este oarecum confuz, deoarece ashift este o putere a lui 2. De exemplu, ashift=9 înseamnă dimensiunea sectorului 2^9, sau 512 octeți.
ZFS solicită sistemului de operare informații detaliate despre fiecare dispozitiv de bloc atunci când este adăugat într-un nou vdev și, teoretic, stabilește automat ashift corespunzător pe baza acestor informații. Din păcate, multe discuri mint despre dimensiunea sectorului lor pentru a menține compatibilitatea cu Windows XP (care nu putea interpreta discurile cu alte dimensiuni ale sectorului).
Aceasta înseamnă că administratorul ZFS este puternic sfătuit să cunoască dimensiunea reală a sectorului dispozitivelor sale și să o seteze manual. ashift. Dacă ashift este setat prea mic, numărul de operațiuni de citire/scriere crește astronomic. De exemplu, scrierea de 'sectoare' de 512 biți într-un sector real de 4 KiB necesită prima scriere a 'sectorului', apoi citirea sectorului de 4 KiB, modificarea lui cu al doilea 'sector' de 512 biți, scrierea lui înapoi în noul sector de 4 KiB și așa mai departe pentru fiecare scriere.
În lumea reală, această penalizare afectează unitățile de stocare SSD Samsung EVO, pentru care ar trebui să se aplice ashift=13, dar aceste SSD mint despre dimensiunea lor a sectorului, iar prin urmare, este setat implicit ashift=9. Dacă un administrator de sistem experimentat nu schimbă această setare, atunci acest SSD funcționează mai lent ca un HDD magnetic obișnuit.
În comparație, pentru o dimensiune prea mare ashift nu există practic nicio penalizare. Nu există o reducere reală a performanței, iar creșterea spațiului neutilizat este infinit de mică (sau nulă atunci când compresia este activată). Prin urmare, recomandăm cu tărie chiar și pentru discurile care folosesc într-adevăr sectoare de 512 biți să stabilească ashift=12 sau chiar ashift=13, pentru a privi cu încredere în viitor.
Proprietate ashift se stabilește pentru fiecare dispozitiv virtual vdev, și nu pentru pool, așa cum cred mulți pe o idee greșită - și nu se schimbă după instalare. Dacă accidental ați greșit ashift când adăugați un nou vdev în pool, ați contaminat irevocabil acest pool cu un dispozitiv de performanță scăzută și, în general, nu există altă opțiune decât să distrugeți pool-ul și să începeți din nou. Chiar și eliminarea vdev-ului nu va salva de setarea greșită. ashift!
Mecanismul de copiere la scriere
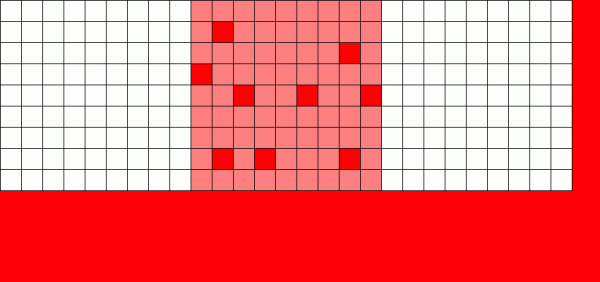
Dacă un sistem de fișiere obișnuit trebuie să rescrie datele - modifică fiecare bloc acolo unde se află.
Sistemul de fișiere cu copiere la scriere scrie o nouă versiune a blocului și apoi deblochează versiunea veche.
Abstract, ignorând poziția fizică reală a blocurilor, cometa noastră de date se simplifică la un „verme de date” care se deplasează de la stânga la dreapta pe harta spațiului disponibil.
Acum putem obține o idee clară despre cum funcționează instantaneele copiei la scriere - fiecare bloc poate aparține mai multor instantanee și va rămâne până când toate instantanee asociate sunt distruse.
Mecanismul copiei la scriere (Copy on Write, CoW) este fundamentele a ceea ce face ZFS un sistem atât de uimitor. Conceptul de bază este simplu - dacă ceri unui sistem de fișiere tradițional să modifice un fișier, va face exact ceea ce ai cerut. Dacă ceri unui sistem de fișiere cu copiere la scriere să facă același lucru, va spune "bine" - dar îți va spune o minciună.
În loc să facă acest lucru, sistemul de fișiere cu copiere la scriere scrie o nouă versiune a blocului modificat și apoi actualizează meta-datele fișierului pentru a rupe legătura cu blocul vechi și a lega noul bloc pe care tocmai l-ai scris.
Detasarea blocului vechi și legarea celui nou se face într-o singură operație, deci nu poate fi întreruptă - dacă întrerupi alimentarea după ce acest lucru s-a întâmplat, ai o nouă versiune a fișierului, iar dacă întrerupi alimentarea mai devreme, ai versiunea veche. În orice caz, nu vor exista conflicte în sistemul de fișiere.
Copierea la scriere în ZFS are loc nu doar la nivelul sistemului de fișiere, ci și la nivelul gestionării discurilor. Aceasta înseamnă că ZFS nu este predispus la o breșă în scriere () - fenomenul în care banda a reușit să fie scrisă doar parțial înainte de defecțiune, provocând deteriorarea array-ului după reboot. Aici banda este scrisă atomic, vdev-ul este întotdeauna consistent, și .
ZIL: jurnalul intențiilor ZFS
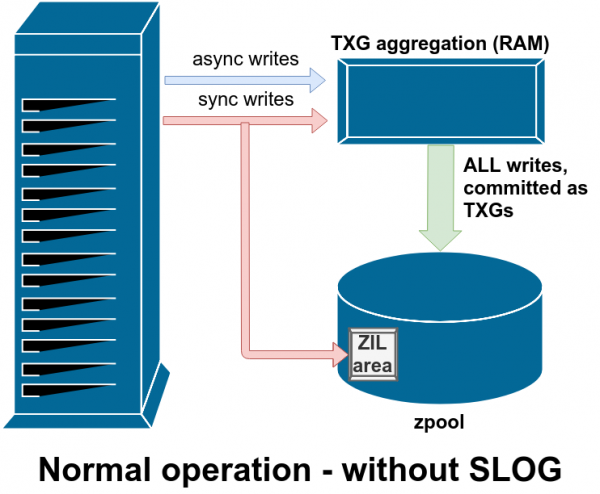
Sistemul ZFS gestionează scrierile sincrone într-un mod special - le salvează temporar, dar imediat în ZIL, înainte de a le scrie mai târziu în mod permanent împreună cu scrierile asincrone.
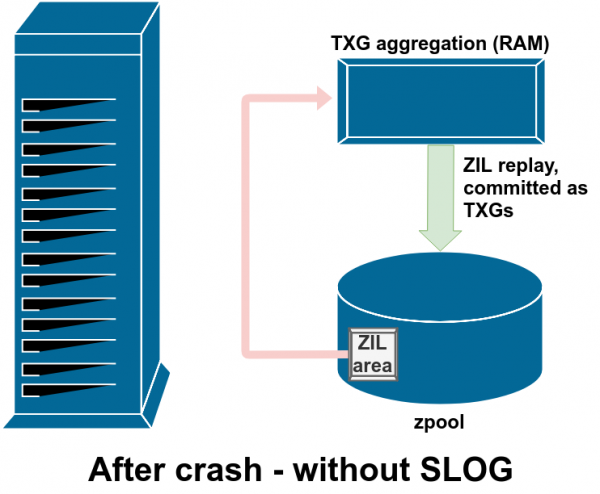
De obicei, datele scrise pe ZIL nu mai sunt niciodată citite. Dar acest lucru este posibil după o defecțiune a sistemului.
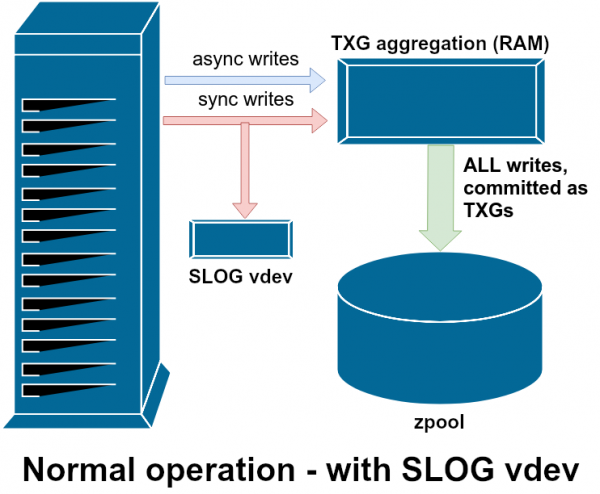
SLOG, sau dispozitivul LOG secundar, este pur și simplu un vdev special — și de preferință foarte rapid — unde ZIL poate fi stocat separat de stocarea principală.
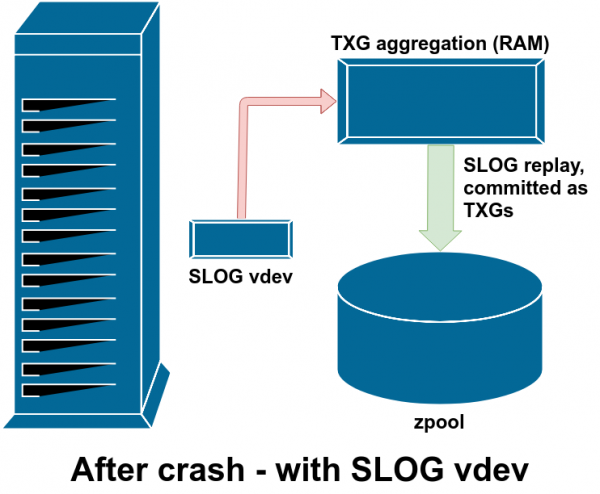
După o defecțiune, toate datele murdare din ZIL sunt reproduse — în acest caz, ZIL se află pe SLOG, deci ele sunt reproduce exact de acolo.
Există două categorii principale de operațiuni de scriere — sincrone (sync) și asincrone (async). Pentru majoritatea sarcinilor de lucru, o mare parte din operațiunile de scriere sunt asincrone — sistemul de fișiere permite agregarea acestora și livrarea lor în pachete, reducând fragmentarea și crescând semnificativ lățimea de bandă.
Scrierile sincrone sunt complet diferite. Când o aplicație solicită o scriere sincronă, aceasta informează sistemul de fișiere: „Trebuie să fixezi asta în memoria non-volatilă, chiar acumiar până atunci nu pot face nimic altceva”. Prin urmare, scrierile sincrone trebuie să fie fixate imediat pe disc — și dacă acest lucru crește fragmentarea sau reduce lățimea de bandă, așa să fie.
ZFS tratează scrierile sincrone diferit de sistemele de fișiere obișnuite — în loc să le scrie imediat în stocarea standard, ZFS le fixează într-o zonă specială de stocare numită jurnalul intențiilor ZFS — ZFS Intent Log sau ZIL. Trucul este că aceste scrieri de asemenea rămân în memorie, fiind aglomerate împreună cu cererile de scriere asincrone obișnuite, pentru a fi mai târziu scrise în stocare ca niște TXG (grupuri de tranzacții, Transaction Groups) complet normale.
În modul normal de funcționare, ZIL este scris și niciodată citit din nou. Când, după câteva momente, scrierile din ZIL sunt fixate în stocarea principală ca TXG-uri standard din RAM, ele se deconectează de la ZIL. Singurul moment când ceva este citit din ZIL este la importul unui pool.
Dacă se întâmplă o defecțiune a ZFS — o defecțiune a sistemului de operare sau o întrerupere a alimentării — când există date în ZIL, aceste date vor fi citite în timpul următorului import al pool-ului (de exemplu, la repornirea sistemului de recuperare). Tot ce se află în ZIL va fi citit, combinat în grupuri TXG, fixat în stocarea principală, și apoi deconectat de la ZIL în timpul procesului de import.
O clasă auxiliară a vdev-ului se numește LOG sau SLOG, un dispozitiv secundar LOG. Are un singur scop — să ofere unui pool un dispozitiv vdev separat și, de preferință, mult mai rapid, cu o rezistență foarte mare la scriere, pentru stocarea ZIL-ului, în loc să stocheze ZIL-ul pe principalul stocare vdev. Însuși ZIL-ul se comportă la fel, indiferent de locul de stocare, dar dacă vdev-ul cu LOG are o performanță foarte mare la scriere, atunci scrierile sincronizate vor avea loc mai rapid.
Adăugarea vdev-ului cu LOG în pool nu va nu poate îmbunătăți performanța scrierilor asincrone — chiar dacă forțezi toate scrierile în ZIL cu zfs set sync=always, ele vor fi în continuare legate la stocarea principală în TXG în același mod și cu aceeași viteză ca și fără jurnal. Singura îmbunătățire directă a performanței este întârzierea scrierii sincronizate (deoarece o viteză mai mare a jurnalului accelerează execuția operațiunilor. sync).
Cu toate acestea, într-un mediu care necesită deja un număr mare de scrieri sincronizate, vdev LOG poate accelera indirect scrierea asincronă și citirea necache-uită. Descărcarea scrierilor ZIL într-un vdev LOG separat înseamnă o concurență mai mică pentru IOPS în stocarea primară, ceea ce, într-o oarecare măsură, îmbunătățește performanța tuturor operațiunilor de citire și scriere.
Snapshot-uri
Mecanismul de copiere la scriere este, de asemenea, o bază necesară pentru instantaneele atomice ZFS și replicarea asincronă incrementală. Într-un sistem de fișiere activ există un arbore de pointeri, care marchează toate înregistrările cu date curente — când faci un snapshot, pur și simplu faci o copie a acestui arbore de pointeri.
Când o înregistrare este rescrisă în sistemul de fișiere activ, ZFS scrie mai întâi o versiune nouă a blocului în spațiul nefolosit. Apoi, deconectează versiunea veche a blocului de sistemul de fișiere curent. Dar dacă un snapshot se referă la blocul vechi, el rămâne neschimbat. Blocul vechi nu va fi de fapt recuperat ca spațiu liber până când toate snapshot-urile care se referă la acest bloc nu vor fi distruse!
Replicare
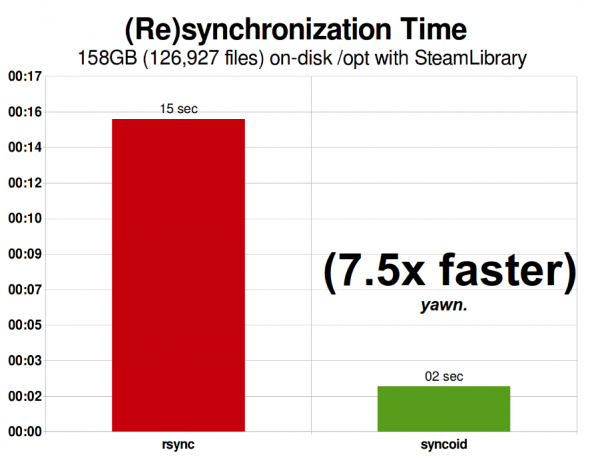
Biblioteca mea Steam în 2015 ocupa 158 GiB și includea 126,927 de fișiere. Aceasta este destul de aproape de situația optimă pentru rsync — replicarea ZFS prin rețea a fost „doar” cu 750% mai rapidă.
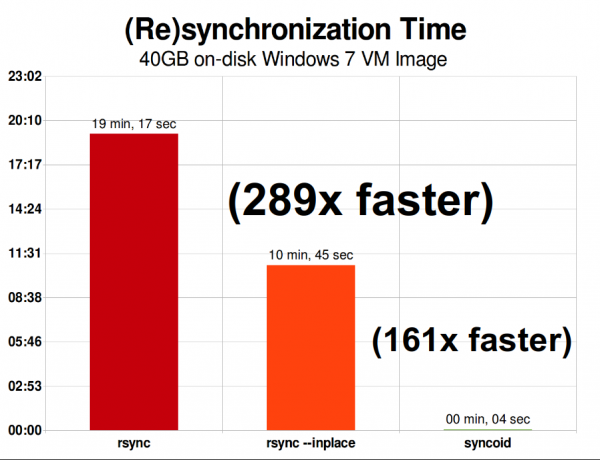
În aceeași rețea, replicarea unui fișier de imagine a mașinii virtuale Windows 7 de 40 de gigabiți este o poveste complet diferită. Replicarea ZFS se desfășoară de 289 de ori mai rapid decât rsync — sau „doar” de 161 de ori mai rapid, dacă știți suficient încât să apelați rsync cu cheia —inplace.
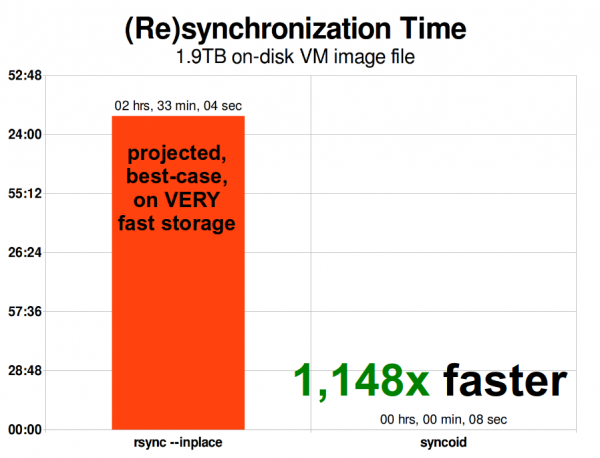
Când imaginea mașinii virtuale se scalează, problemele rsync se scalează odată cu ea. Dimensiunea de 1,9 TiB nu este atât de mare pentru o imagine modernă a mașinii virtuale — dar este suficient de mare pentru ca replicarea ZFS să fie de 1148 de ori mai rapidă decât rsync, chiar și cu argumentul rsync —inplace.
Odată ce înțelegeți cum funcționează instantaneele, va fi simplu să prindem esența replicării. Deoarece o instantanee este pur și simplu un arbore de pointere către înregistrări, urmează că, dacă facem zfs send o instantanee, trimitem atât acest arbore, cât și toate înregistrările asociate. Când trimitem acest zfs send în zfs receive la obiectul țintă, acesta înregistrează atât conținutul efectiv al blocului, cât și arborele de pointere care face referire la blocuri, în setul de date țintă.
Totul devine și mai interesant în zfs send. Acum avem două sisteme, fiecare conținând poolname/datasetname@1, iar dumneavoastră faceți o nouă instantanee poolname/datasetname@2. Prin urmare, în pool-ul inițial aveți datasetname@1 și datasetname@2, iar în pool-ul țintă, deocamdată, doar prima instantanee. datasetname@1.
Deoarece între sursă și destinație avem o instantanee comună, datasetname@1putem face incrementală zfs send peste ea. Când spunem sistemului zfs send -i poolname/datasetname@1 poolname/datasetname@2, acesta compară cele două arbori de pointere. Orice pointere care există doar în @2, evident, fac referire la blocuri noi — astfel încât vom avea nevoie de conținutul acestor blocuri.
În sistemul îndepărtat, procesarea incrementală send este la fel de simplă. Mai întâi, înregistrăm toate înregistrările noi incluse în flux, sendapoi adăugăm pointere la aceste blocuri. Voilà, avem @2 în noul sistem!
Replicarea incrementală ZFS asincronă reprezintă o îmbunătățire considerabilă față de metodele anterioare, care nu se bazau pe instantanee, cum ar fi rsync. În ambele cazuri, sunt transmise doar datele modificate — dar rsync trebuie mai întâi citi să citească toate datele de pe ambele părți de pe disc, pentru a verifica suma și a o compara. Spre deosebire de aceasta, replicarea ZFS nu citește nimic în afară de arborii de pointere — și orice blocuri care nu sunt reprezente în instantaneul comun.
Compresie încorporată
Mecanismul de copiere la scriere simplifică, de asemenea, sistemul de compresie încorporată. Într-un sistem de fișiere tradițional, compresia este problematică - atât versiunea veche, cât și cea nouă a datelor modificate se află în același spațiu.
Dacă analizăm un fragment de date din mijlocul unui fișier, care își începe viața ca un megabyte de zerouri de la 0x00000000 și așa mai departe - este foarte ușor de comprimat la un singur sector pe disk. Dar ce se va întâmpla dacă înlocuim acest megabyte de zerouri cu un megabyte de date necomprimate, cum ar fi JPEG sau zgomot pseudo-aleatoriu? Dintr-o dată, acest megabyte de date va necesita nu unul, ci 256 de sectoare de 4 KiB, iar în acest loc pe disk a fost rezervat doar un singur sector.
ZFS nu are această problemă, deoarece înregistrările modificate sunt întotdeauna scrise în spațiul neutilizat - blocul original ocupă un singur sector de 4 KiB, iar noua înregistrare va ocupa 256, dar aceasta nu este o problemă - fragmentul recent modificat din "mijlocul" fișierului ar fi fost scris în spațiul neutilizat, indiferent dacă dimensiunea sa s-a schimbat sau nu, așa că pentru ZFS este o situație normală.
Compresia încorporată ZFS este dezactivată implicit, iar sistemul oferă algoritmi opționali - printre aceștia se numără LZ4, gzip (1-9), LZJB și ZLE.
- LZ4 — este un algoritm de flux, oferind o compresie și decomprimare extrem de rapidă și câștig de performanță pentru majoritatea cazurilor de utilizare - chiar și pe CPU-uri destul de lent.
- GZIP — un algoritm venerat, pe care toate sistemele Unix îl cunosc și îl iubesc. Poate fi implementat cu niveluri de compresie de la 1 la 9, cu creșterea gradului de compresie și utilizării CPU pe măsură ce se apropie de nivelul 9. Algoritmul se potrivește bine pentru toate utilizările textuale (sau alte opțiuni extrem de comprimabile), dar, în alte cazuri, adesea provoacă probleme cu CPU - utilizați-l cu prudență, în special la niveluri mai ridicate.
- LZJB — algoritmul original din ZFS. Este învechit și nu ar trebui utilizat; LZ4 îl depășește în toate aspectele.
- ZLE — codificarea nivelului zero, Zero Level Encoding. Aceasta nu afectează deloc datele normale, dar comprimă secvențele mari de zerouri. Este utilă pentru seturile de date complet necomprimate (de exemplu, JPEG, MP4 sau alte formate deja comprimate), deoarece ignoră datele necomprimate, dar comprimă spațiul neutilizat în înregistrările finale.
Recomandăm compresia LZ4 pentru practic toate cazurile de utilizare; penalizarea pentru performanță în cazul întâlnirii cu date necomprimate este foarte mică, iar în performanță performanța pentru datele tipice este semnificativă. Copierea imaginii unei mașini virtuale pentru o nouă instalare a sistemului de operare Windows (OS instalat recent, fără date interne) cu compression=lz4 a fost cu 27% mai rapidă decât cu compression=none, pe .
ARC — cache-ul cu înlocuire adaptivă
ZFS este singura sistem de fișiere modern cunoscută care folosește un mecanism propriu de caching pentru citire și nu se bazează pe cache-ul paginilor sistemului de operare pentru a stoca copii ale blocurilor recent citite în memoria RAM.
Deși cache-ul propriu nu este lipsit de probleme — ZFS nu poate răspunde la cereri noi de alocare a memoriei la fel de repede ca nucleul, astfel încât o nouă solicitare malloc() de alocare a memoriei poate eșua dacă necesită memorie RAM ocupată în prezent de ARC. Dar există motive întemeiate pentru a folosi un cache propriu, cel puțin în prezent.
Toate sistemele de operare moderne cunoscute, inclusiv MacOS, Windows, Linux și BSD, folosesc algoritmul LRU (Least Recently Used) pentru implementarea cache-ului paginilor. Acesta este un algoritm primitiv, care urcă blocul cache-uit „în sus în coadă” după fiecare citire și înlocuiește blocurile „în jos în coadă” după cum este necesar pentru a adăuga noi rate de cache (blocuri care ar fi trebuit să fie citite de pe disc, nu din cache) în sus.
În mod obișnuit, algoritmul funcționează bine, dar în sistemele cu mari seturi de date, LRU duce cu ușurință la thrashing — înlocuirea blocurilor frecvent necesare pentru a elibera spațiu pentru blocurile care nu vor mai fi citite din cache.
— un algoritm mult mai sofisticat, care poate fi considerat un cache „ponderat”. După fiecare citire a unui bloc din cache, acesta devine puțin mai „greu” și devine mai greu de eliminat — chiar și după eliminare, blocul este urmărit pentru o anumită perioadă de timp. Blocul care a fost eliminat, dar apoi trebuie citit din nou în cache, va deveni de asemenea „mai greu”.
Rezultatul final al tuturor acestora este un cache cu un coeficient de hit mult mai mare (hit ratio) — raportul dintre hits în cache (citiri efectuate din cache) și misses (citiri de pe disc). Aceasta este o statistică extrem de importantă — nu doar că hits-urile din cache sunt procesate cu mult mai repede, dar misses-urile din cache pot fi, de asemenea, procesate mai repede, deoarece cu cât sunt mai multe hits-uri în cache — cu atât mai puține cereri paralele la disc și astfel, mai puțin timp de așteptare pentru acele misses rămase care trebuie procesate de pe disc.
Concluzie
După ce am studiat semantica de bază a ZFS — cum funcționează copiile la scriere, precum și relațiile dintre pool-urile de stocare, dispozitivele virtuale, blocurile, sectoarele și fișierele, — suntem pregătiți să discutăm despre performanța reală cu cifre reale.
În partea următoare, ne vom concentra pe performanța efectivă a pool-urilor cu vdev-uri mirror și RAIDz, unele în comparație cu altele, dar și în comparație cu topologiile tradiționale RAID din kernelul Linux pe care le-am explorat. .
Inițial am vrut să abordăm doar bazele — tipologiile ZFS în sine — dar după așa de vom fi pregătiți să discutăm despre configurarea avansată și tuning-ul ZFS, inclusiv utilizarea unor tipuri auxiliare de vdev, cum ar fi L2ARC, SLOG și Special Allocation.
Sursa: habr.com
