

În Linux există o mulțime de instrumente pentru depanarea kernel-ului și a aplicațiilor. Majoritatea acestora afectează negativ performanța aplicațiilor și nu pot fi folosite în producție.
Acum câțiva ani a fost — eBPF. Acesta permite trasarea nucleului și a aplicațiilor utilizatorului cu un overhead scăzut și fără a fi necesară recompilarea programelor sau încărcarea de module externe în nucleu.
În prezent, există deja numeroase utilitare aplicative care folosesc eBPF, iar în acest articol vom explora cum să scriem propria utilitară de profilare bazată pe biblioteca . Articolul este bazat pe evenimente reale. Vom parcurge drumul de la apariția problemei până la rezolvarea acesteia, pentru a ilustra cum pot fi utilizate utilitarele existente în situații concrete.
Ceph este lent
Am adăugat un nou gazdă în clusterul Ceph. După migrarea unei părți a datelor pe el, am observat că viteza de procesare a cererilor de scriere era mult mai mică decât pe celelalte servere.
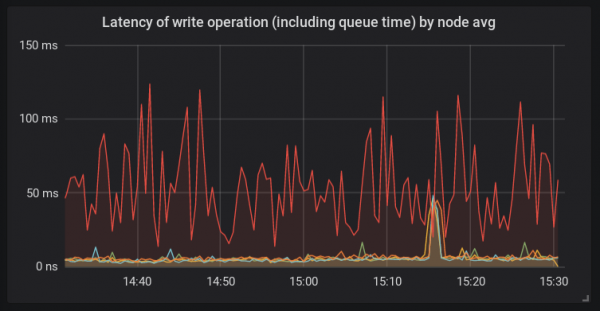
Spre deosebire de alte platforme, pe acest gazdă a fost utilizat bcache și un nou nucleu linux 4.15. Această configurație de gazdă a fost utilizată aici pentru prima dată. Și în acel moment era clar că rădăcina problemei ar fi putut fi orice.
Investigând gazda
Vom începe prin a observa ce se întâmplă în cadrul procesului ceph-osd. Pentru aceasta, vom folosi și (despre care puteți citi mai multe ):
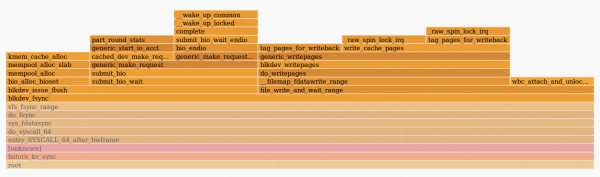
Imaginea ne spune că funcția fdatasync() a consumat mult timp în trimiterea cererii în funcția generic_make_request(). Asta înseamnă că, cel mai probabil, cauza problemelor se află undeva în afara demonului osd. Aceasta poate fi fie nucleul, fie discurile. Iostat arăta o întârziere mare în procesarea cererilor de către discurile bcache.
În timpul verificării gazdei, am descoperit că demonul systemd-udevd consumă mult timp CPU — aproximativ 20% pe mai multe nuclee. Acest comportament ciudat necesită o elucidare. Deoarece Systemd-udevd lucrează cu uevent-uri, am decis să le examinăm prin intermediul udevadm monitor. Se pare că se generau multe evenimente de schimbare pentru fiecare dispozitiv de bloc din sistem. Acesta este un comportament destul de neobișnuit, prin urmare, va trebui să investigăm ce generează toate aceste evenimente.
Folosind Toolkit-ul BCC
Așa cum am constatat deja, nucleul (și demonul ceph în apelul de sistem) petrece mult timp în generic_make_request(). Să încercăm să măsurăm viteza de execuție a acestei funcții. În există deja o utilitară grozavă — funclatency. Vom urmări demonul după PID-ul său cu un interval de 1 secundă între ieșiri și vom afișa rezultatul în milisecunde.
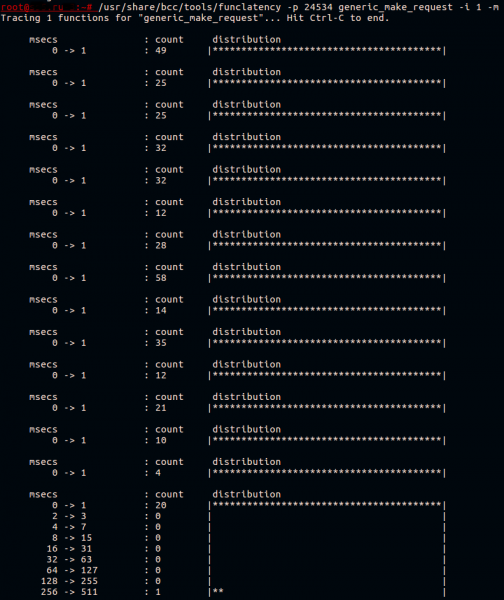
De obicei, această funcție funcționează rapid. Tot ce face este să transmită cererea în coada driver-ului de dispozitiv.
Bcache — este un dispozitiv complex care constă, de fapt, din trei discuri:
- dispozitiv de bază (disc care poate fi pus în cache), în acest caz un HDD lent;
- dispozitiv de cache (disc care face caching), aici este o partiție NVMe a dispozitivului;
- dispozitiv virtual bcache, cu care lucrează aplicația.
Știm că transmiterea cererii încetinește, dar pentru care dintre aceste dispozitive? Să ne ocupăm de asta puțin mai târziu.
Acum știm că uevent-urile provoacă probabil probleme. A găsi ce anume generează acele uevent-uri nu este atât de simplu. Să presupunem că este un software care se lansează periodic. Să vedem ce software este lansat în sistem cu ajutorul scriptului execsnoop din același . Să-l lansăm și să direcționăm ieșirea într-un fișier.
De exemplu, așa:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nu vom prezenta aici întreaga ieșire execsnoop, dar o linie care ne interesează arăta astfel:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1/'
A treia coloană este PPID (PID-ul părintelui) procesului. Procesul cu PID 5802 s-a dovedit a fi unul dintre firele sistemului nostru de monitorizare. La verificarea configurației sistemului de monitorizare au fost găsite parametri greșit setați. Temperatura adaptatorului HBA era măsurată la fiecare 30 de secunde, ceea ce era mult mai des decât era necesar. După ce am schimbat intervalul de verificare la unul mai lung, am constatat că întârzierile în procesarea cererilor pe acest host nu mai ieșeau în evidență față de celelalte hosts.
Dar încă nu este clar de ce dispozitivul bcache încetinea atât de tare. Am pregătit o platformă de testare cu o configurație identică și am încercat să reproducem problema, lansând fio pe bcache, lansând periodic udevadm trigger pentru a genera uevents.
Scrierea uneltelor bazate pe BCC
Vom încerca să scriem o unealtă simplă pentru a urmări și a afișa cele mai lente apeluri generic_make_request(). De asemenea, ne interesează numele discului pentru care a fost apelată această funcție.
Planul este simplu:
- Înregistrăm kprobe pe generic_make_request():
- Salvăm în memorie numele discului, disponibil prin argumentul funcției;
- Salvăm timestamp-ul.
- Înregistrăm kretprobe la întoarcerea din generic_make_request():
- Obținem timestamp-ul curent;
- Căutăm timestamp-ul salvat și îl comparăm cu cel curent;
- Dacă rezultatul este mai mare decât cel stabilit, atunci găsim numele salvat al discului și îl afișăm în terminal.
Kprobes și kretprobes utilizează mecanismul punctelor de oprire pentru a modifica codul funcțiilor în timp real. Puteți citi și , putem observa că ele au o structură identică. Așa că în acest articol vom omite parsarea argumentelor scriptului și vom trece direct la programul BPF. Textul eBPF din scriptul python arată după cum urmează:
bpf_text = “”” # Aici va fi codul programului bpf “””
Pentru schimbul de date între funcții, programele eBPF utilizează
tabele hash struct data_t { u64 pid; u64 ts; char comm[TASK_COMM_LEN]; u64 lat; char disk[DISK_NAME_LEN]; };BPF_HASH(p, u64, struct data_t); BPF_PERF_OUTPUT(events);
Aici înregistrăm o tabelă hash, care se numește
, cu o cheie de tip pu64 și o valoare de tip struct data_t . Tabela va fi disponibilă în contextul programului nostru BPF. Macro-ul BPF_PERF_OUTPUT înregistrează o altă tabelă, numităevents , care este utilizată pentrutransmiterea datelor Când măsurăm întârzierile între apelul unei funcții și returnarea din aceasta, sau între apelurile diferitelor funcții, trebuie să luăm în considerare că datele obținute trebuie să aparțină aceluiași context. Cu alte cuvinte, trebuie să ne amintim de posibila executare paralelă a funcțiilor. Avem posibilitatea de a măsura întârzierea între apelul unei funcții în contextul unui singur proces și returnarea din această funcție în contextul altui proces, dar acesta este, cel mai probabil, inutil. Un exemplu bun în acest sens ar putea fi
utilitarul biolatency struct request , care reflectă o cerere către disk.Apoi trebuie să scriem codul care se va executa la apelarea funcției investigate:
void start(struct pt_regs *ctx, struct bio *bio) { u64 pid = bpf_get_current_pid_tgid(); struct data_t data = {}; u64 ts = bpf_ktime_get_ns(); data.pid = pid; data.ts = ts; bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name); p.update(&pid, &data); }
Aici ca al doilea argument va fi înlocuit primul argument al funcției apelate
. După aceasta obținem PID-ul procesului, în contextul căruia lucrăm, și marcajul temporal curent în nanosecunde. Înscriem toate acestea în structura nou alocată struct data_t data struct data_t dataNumele discului îl obținem din structură bio, care este transmisă la apel generic_make_request(), și îl salvăm în aceeași structură data. Ultimul pas este să adăugăm o înregistrare în tabela de hash despre care s-a menționat anterior.
Funcția următoare va fi apelată la întoarcerea din generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Această funcție este similară cu precedenta: aflăm PID-ul procesului și timestamp-ul, dar nu alocăm memorie pentru o nouă structură data. În schimb, căutăm în tabela de hash o structură deja existentă după cheia == PID-ul curent. Dacă structura este găsită, atunci aflăm numele procesului care rulează și îl adăugăm în aceasta.
Shift-ul binar pe care îl folosim aici este necesar pentru a obține GID-ul firului de execuție, adică PID-ul procesului principal care a lansat firul, în contextul în care lucrăm. Funcția pe care o apelăm returnează atât GID-ul firului, cât și PID-ul său într-o valoare de 64 de biți.
La ieșirea în terminal, momentan nu ne interesează firul, ci procesul principal. După compararea întârzierii obținute cu pragul stabilit, transmitem structura noastră data în spațiul utilizatorului prin tabelă , care este utilizată pentru, după care eliminăm înregistrarea din p.
În scriptul Python care va încărca acest cod, va trebui să înlocuim MIN_US și FACTOR cu pragurile de întârziere și unitățile de timp pe care le vom transmite prin argumente:
bpf_text = bpf_text.replace('MIN_US', str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR', 'data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR', '')
	label = "usec"
Acum trebuie să pregătim programul BPF prin și să înregistrăm probele:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
De asemenea, va trebui să definim . Tabela va fi disponibilă în contextul programului nostru BPF. Macro-ul BPF_PERF_OUTPUT înregistrează o altă tabelă, numită în scriptul nostru, altfel nu vom putea citi nimic:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk", ct.c_char * DISK_NAME_LEN)]
Ultimul pas - ieșirea datelor în terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Scriptul este disponibil pe . Să încercăm să-l rulăm pe platforma de testare, unde se execută fio, scriind pe bcache, și să apelăm udevadm monitor:
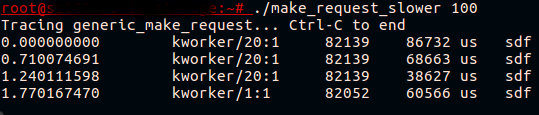
În sfârșit! Acum vedem că ceea ce părea a fi un dispozitiv bcache încetinit este de fapt un apel încetinit generic_make_request() pentru discul cache.
Explorați nucleul
Ce exact încetinește în timpul transferului cererii? Vedem că întârzieri apar chiar înainte de începerea contabilizării cererii, adică contabilizarea cererii specifice pentru statistici ulterioare (\/proc\/diskstats sau iostat) nu a început încă. Acest lucru poate fi verificat cu ușurință prin rularea iostat în timpul reproducerii problemei, fie , care se bazează pe începutul și sfârșitul contabilizării cererilor. Niciuna dintre aceste utilitare nu va arăta probleme pentru cererile către discul cache.
Dacă ne uităm la funcția generic_make_request(), vom vedea că înainte de a începe contabilizarea cererii sunt apelate încă două funcții. Prima este generic_make_request_checks(), care efectuează verificări de legitimitate a cererii în raport cu setările discului. A doua este , care conține un apel interesant la :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
În aceasta, nucleul așteaptă dezghețarea cozii. Să măsurăm întârzierile blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Tracing 1 functions for "blk_queue_enter"... Hit Ctrl-C to end.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Se pare că suntem aproape de soluție. Funcțiile folosite pentru „înghețarea/dezghețarea” cozii sunt și . Acestea sunt utilizate atunci când trebuie să schimbați setările cozii cererilor, potențial periculoase pentru cererile aflate în această coadă. La apelarea blk_mq_freeze_queue() funcția încrementează contorul q->mq_freeze_depth. După aceasta, nucleul așteaptă golirea cozii în .
Timpul de așteptare pentru golirea acestei cozi este echivalent cu întârzierea discului, deoarece nucleul așteaptă finalizarea tuturor operațiunilor în așteptare. Odată ce coada este goală, se aplică modificările configurației. După care este apelat , care decrementează contorul freeze_depth.
Acum știm suficient pentru a remedia situația. Comanda udevadm trigger va duce la aplicarea configurațiilor pentru dispozitivul bloc. Aceste configurații sunt descrise în regulile udev. Putem afla ce anume ''congelează'' coada, încercând să le modificăm prin sysfs sau consultând codul sursă al nucleului. De asemenea, putem încerca utilitarul BCC , care va afișa în terminal traseele stivei nucleului și ale spațiului utilizator pentru fiecare apel blk_freeze_queue, de exemplu:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Regulile udev se schimbă destul de rar și de obicei acest lucru se întâmplă sub control. Prin urmare, vedem că chiar și aplicarea valorilor deja definite provoacă un vârf de întârziere a transferului cererii de la aplicație la disc. Desigur, generarea de evenimente udev când nu există modificări în configurația discurilor (de exemplu, dispozitivul nu este conectat/deconectat) nu este o practică foarte bună. Cu toate acestea, putem ajuta nucleul să nu facă muncă inutilă și să nu ''congeleze'' coada cererilor, dacă nu este necesar. repară situația.
Concluzie
eBPF este un instrument foarte flexibil și puternic. În articol, am analizat un caz practic și am demonstrat o mică parte din ceea ce este posibil de realizat. Dacă sunteți interesat de dezvoltarea de utilitare BCC, merită să aruncați o privire pe , care descrie bine bazele funcționării.
Există și alte instrumente interesante pentru depanare și profilare, bazate pe eBPF. Unul dintre ele este , care permite scrierea de comenzi puternice de o linie și programe mici într-un limbaj asemănător awk. Altul este , care permite colectarea de metrici de nivel scăzut cu rezoluție înaltă direct pe serverul vostru Prometheus, cu posibilitatea de a obține ulterior vizualizări frumoase și chiar alerte.
Sursa: habr.com
