

Dacă infrastructura dumneavoastră IT crește prea repede, va veni un moment în care va trebui să alegeți - să creșteți liniar resursele umane pentru suport sau să începeți automatizarea. Până la un anumit punct, am trăit în prima paradigmă, iar apoi a început un drum lung către Infrastructure-as-Code.
Desigur, NSPK nu este un startup, dar o astfel de atmosferă a domnit în companie în primii ani de existență, iar aceștia au fost ani foarte interesanți. Mă numesc , de mai bine de 10 ani susțin infrastructura Linux cu cerințe ridicate de disponibilitate. M-am alăturat echipei NSPK în ianuarie 2016 și, din păcate, nu am prins chiar de la începutul existenței companiei, dar am venit într-un moment de mari schimbări.
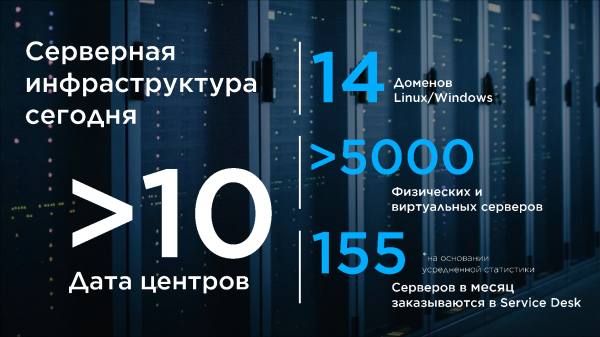
În general, se poate spune că echipa noastră furnizează companiei 2 produse. Primul - infrastructura. Mailul trebuie să funcționeze, DNS-ul trebuie să funcționeze, iar controllerele de domeniu trebuie să vă permită accesul la servere, care nu ar trebui să se oprească. Peisajul IT al companiei este imens! Acestea sunt sisteme business&mission critical, cu cerințe de disponibilitate pentru unele - 99.999. Al doilea produs - serverele în sine, fizice și virtuale. Trebuie să avem grijă de cele existente și să livrăm noi în mod regulat clienților din numeroasele departamente. În acest articol, vreau să pun accentul pe modul în care am dezvoltat infrastructura care răspunde de ciclul de viață servere.
Începutul călătoriei
La începutul călătoriei, stiva noastră de tehnologii arăta astfel:
OS CentOS 7
Controllerele de domeniu FreeIPA
Automatizare - Ansible(+Tower), Cobbler
Toate acestea erau distribuite în 3 domenii, dispersate pe mai multe centre de date. Într-un centru de date - sisteme de birou și terenuri de testare, în celelalte PRODUCTION.
Crearea serverelor arăta într-un anumit moment astfel:
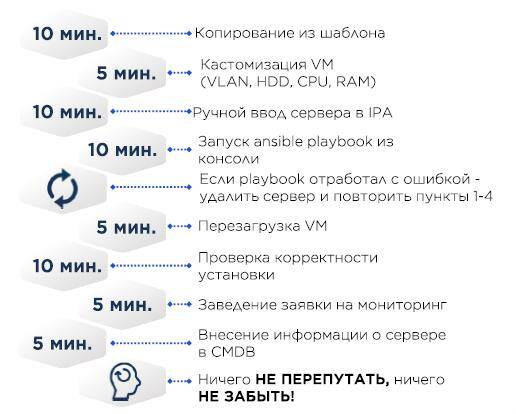
În șablonul VM CentOS minim și un minim necesar, cum ar fi un corect /etc/resolv.conf, restul venind prin Ansible.
CMDB - Excel.
Dacă serverul este fizic, atunci în loc să copiem mașina virtuală pe el, se instalează OS prin Cobbler - în configurația Cobbler se adaugă adresele MAC ale serverului țintă, serverul obține o adresă IP prin DHCP, iar apoi se instalează OS-ul.
La început, am încercat chiar să facem un fel de management al configurației în Cobbler. Dar în timp, aceasta a început să aducă probleme cu portabilitatea configurațiilor atât către alte centre de date, cât și în codul Ansible pentru pregătirea VM-urilor.
În acea perioadă, mulți dintre noi percepeau Ansible ca pe o extensie convenabilă a Bash-ului și nu ne-am zgârcit în utilizarea structurilor cu shell, sed. Practic, Bashsible. Acest lucru ducea, în cele din urmă, la situația în care, dacă un playbook nu funcționa dintr-un anumit motiv pe server, era mai simplu să ștergem serverul, să corectăm playbook-ul și să-l rulăm din nou. Practic, nu exista o versiune a scripturilor, nici portabilitate a configurațiilor.
De exemplu, am dorit să schimbăm o configurație pe toate serverele:
- Modificăm configurația pe serverele existente din segmentul logic / centru de date. Uneori nu se întâmplă într-o zi - cerințele de disponibilitate și legea numerelor mari nu permit aplicarea tuturor modificărilor dintr-o dată. Iar unele modificări sunt potențial distrugătoare și necesită repornirea unor servicii - de la servicii la întregul sistem de operare.
- Corectăm în Ansible
- Corectăm în Cobbler
- Repetăm de N ori pentru fiecare segment logic / centru de date
Pentru ca toate modificările să decurgă fără probleme, trebuie să luăm în considerare o mulțime de factori, iar modificările sunt constante.
- Refactorizarea codului Ansible, a fișierelor de configurație
- Modificarea practicilor interne de best practice
- Modificări în urma analizei incidentelor / avariilor
- Modificarea standardelor de securitate, atât interne, cât și externe. De exemplu, PCI DSS este completat anual cu cerințe noi.
Creșterea infrastructurii și începutul drumului
Numărul de servere / domenii logice / centre de date a crescut, iar împreună cu ele au crescut și erorile în configurații. La un moment dat, am ajuns la trei direcții în care trebuie să ne dezvoltăm managementul configurației:
- Automatizare. Așa cum este posibil, trebuie să evităm factorul uman în operațiunile repetate.
- Repetabilitate. Gestionarea infrastructurii este mult mai simplă atunci când este previzibilă. Configurația serverelor și instrumentele pentru pregătirea acestora trebuie să fie identice peste tot. Acest lucru este la fel de important pentru echipele de produs - aplicația trebuie să ajungă garantat în mediu de producție după testare, configurată similar cu cea de testare.
- Simplitate și transparență în efectuarea modificărilor în managementul configurației.
A mai rămas să adăugăm câteva instrumente.
Ca depozit de cod, am ales GitLab CE, nu în ultimul rând datorită modulelor CI / CD integrate.
Depozitul de secrete - Hashicorp Vault, inclusiv datorită API-ului său excelent.
Testarea configurațiilor și a rolurilor Ansible – Molecule+Testinfra. Testele decurg mult mai repede dacă conectați mitogen la Ansible. În paralel, am început să scriem o CMDB proprie și un orchestrator pentru implementare automată (în imagine, deasupra Cobbler), dar aceasta este o poveste complet diferită, despre care colegul meu și principalul dezvoltator al acestor sisteme va povesti în viitor.
Alegerea noastră:
Molecule + Testinfra
Ansible + Tower + AWX
Lumea Serverelor + DITNET (Dezvoltare proprie)
Cobbler
Gitlab + GitLab runner
Hashicorp Vault
Apropo, despre rolurile Ansible. La început a fost una, după câteva refactorizări au devenit 17. Recomand cu tărie să descompuneți monolitul în roluri idempotente, care pot fi apoi rulate separat, și, suplimentar, se pot adăuga etichete. Am împărțit rolurile pe funcționalitate – rețea, jurnalizare, pachete, hardware, molecule etc. În general, ne-am păstrat strategia de mai jos. Nu insist că aceasta este adevărul în unicitate, dar la noi a funcționat.
- Copierea serverelor din „imaginea de aur” – rău!Printre principalele dezavantaje – nu știți în ce stare sunt imaginile acum și că toate modificările vor ajunge în toate imaginile din fermele de virtualizare.
- Folosiți fișierele de configurație implicite cât mai puțin posibil și conveniți cu celelalte departamente că sunteți responsabil pentru fișierele de sistem principale., de exemplu:
- Lăsați /etc/sysctl.conf gol, configurațiile ar trebui să fie doar în /etc/sysctl.d/. Implicitul dvs. în un singur fișier, personalizat pentru aplicație în altul.
- Folosiți fișiere de suprascriere pentru a edita unitățile systemd.
- Template toate configurațiile și înlocuiți-le complet, pe cât posibil, fără sed și analogii în playbook-uri.
- Refactorizând codul sistemului de gestionare a configurațiilor:
- Descompuneți sarcinile în entități logice și rescrieți monolitul în roluri.
- Folosiți linters! Ansible-lint, yaml-lint, etc.
- Schimbați abordarea! Fără bashsible. Trebuie să descrieți starea sistemului.
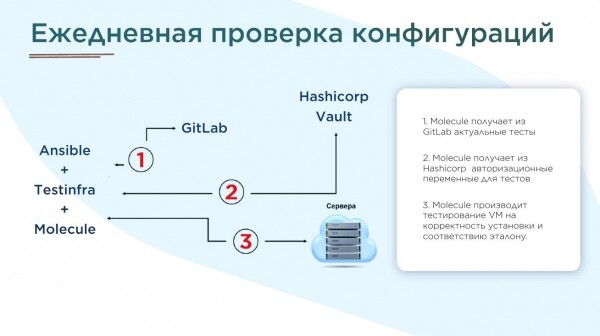
- Pentru toate rolurile Ansible trebuie scrise teste în molecule și să generați rapoarte o dată pe zi.
- În cazul nostru, după pregătirea testelor (peste 100), s-au găsit aproximativ 70000 de erori. Am corectat timp de câteva luni.

Implementarea noastră
Așadar, rolurile Ansible erau gata, template-izate și verificate de lintere. Și chiar și giturile ridicate peste tot. Dar întrebarea livrării fiabile a codului în diferite segmente a rămas deschisă. Am decis să sincronizăm cu scripturi. Arată astfel:
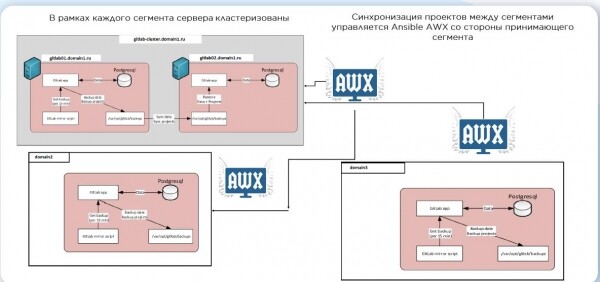
După ce modificările au fost primite, CI este declanșat, se creează un server de test, se aplică rolurile și se testează cu molecule. Dacă totul este în regulă, codul este direcționat către ramura de producție. Totuși, nu aplicăm automat noul cod pe serverele existente. Este un fel de oprire necesară pentru a menține disponibilitatea ridicată a sistemelor noastre. Când infrastructura devine uriașă, intervine și legea marilor numere – chiar dacă ești sigur că modificarea este inofensivă, aceasta poate duce la consecințe neplăcute.
Sunt și multe opțiuni pentru a crea servere. În cele din urmă, am ales scripturi personalizate în Python. Iar pentru CI, Ansible:
- name: create1.yml - Crearea unei VM dintr-un șablon
  vmware_guest:
    hostname: "{{datacenter}}".domain.ro
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.ro
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Iată la ce am ajuns, sistemul continuă să viețuiască și să se dezvolte.
- 17 roluri Ansible pentru configurarea serverului. Fiecare rol este destinat să rezolve o sarcină logică separată (logare, audit, autorizarea utilizatorilor, monitorizare etc.).
- Testarea rolurilor. Molecule + TestInfra.
- Dezvoltare proprie: CMDB + Orchestrator.
- Timpul de creare a serverului este de aproximativ 30 de minute, fiind automatizat și practic independent de coada de sarcini.
- Stare/nume uniform al infrastructurii în toate segmentele – playbook-uri, depozite, elemente de virtualizare.
- Verificarea zilnică a stării serverelor cu generarea de rapoarte despre discrepanțele față de etalon.
Sper ca povestea mea să fie utilă celor care sunt la început de drum. Ce stivă de automatizare folosiți voi?
Sursa: habr.com
