

În acest articol, voi explica cum am abordat problema rezilienței PostgreSQL, de ce a devenit importantă pentru noi și ce am realizat în final.
Avem un serviciu cu o încărcare mare: 2,5 milioane de utilizatori la nivel mondial, 50K+ utilizatori activi în fiecare zi. Serverele noastre se află în Amazone, într-o singură regiune din Irlanda: avem constant în funcțiune 100+ diverse servere, dintre care aproape 50 sunt servere cu baze de date.
Întregul backend este o aplicație monolitică mare, stateful, scrisă în Java, care menține o conexiune websocket constantă cu clientul. Când mai mulți utilizatori lucrează simultan pe aceeași tablă, toți văd modificările în timp real, deoarece fiecare modificare este salvată în baza de date. Avem aproximativ 10K cereri pe secundă către bazele noastre de date. În timpul unui vârf de încărcare, în Redis scriem între 80-100K cereri pe secundă.
De ce am trecut de la Redis la PostgreSQL
Inițial, serviciul nostru a funcționat cu Redis, un magazin de tip key-value care stochează toate datele în memoria RAM. server.
Avantajele Redis:
- Viteză de răspuns foarte rapidă, deoarece totul este stocat în memorie;
- Facilitatea de backup și replicare.
Dezavantajele Redis pentru noi:
- Lipsa tranzacțiilor reale. Am încercat să le imităm la nivelul aplicației noastre. Din păcate, nu a funcționat întotdeauna bine și a necesitat scrierea unui cod foarte complex.
- Volumul de date este limitat de capacitatea memoriei. Pe măsură ce cantitatea de date crește, memoria va crește, iar în cele din urmă vom ajunge la limita caracteristicilor instanței alese, ceea ce în AWS necesită oprirea serviciului nostru pentru a schimba tipul de instanță.
- Este necesar să menținem constant un nivel scăzut de latență, deoarece avem un număr foarte mare de cereri. Nivelul optim de latență pentru noi este de 17-20 ms. La un nivel de 30-40 ms, primim răspunsuri lente la cererile aplicației noastre și degradarea serviciului. Din păcate, acest lucru s-a întâmplat în septembrie 2018, când una dintre instanțele Redis a avut dintr-un motiv oarecare o latență de două ori mai mare decât de obicei. Pentru a rezolva problema, am oprit serviciul în mijlocul zilei lucrătoare pentru întreținere neplanificată și am înlocuit instanța problematică Redis.
- Este ușor să obții inconsistențe în date chiar și în cazul unor erori minore în cod și apoi să cheltui mult timp scriind cod pentru a corecta aceste date.
Am avut în vedere dezavantajele și am realizat că este necesar să ne mutăm pe ceva mai convenabil, cu tranzacții normale și o dependență mai mică de latență. Am efectuat cercetări, am analizat numeroase opțiuni și am ales PostgreSQL.
Ne mutăm pe noua bază de date de 1,5 ani și am transferat doar o mică parte din date, așa că acum lucrăm simultan cu Redis și PostgreSQL. Detalii despre etapele mutării și tranziția datelor între baze sunt scrise în articolul colegului meu.
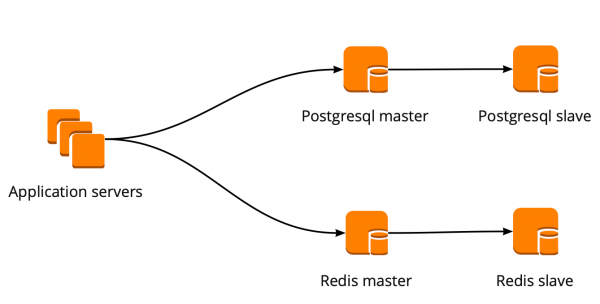
Când am început să ne mutăm, aplicația noastră lucra direct cu baza de date și se conecta la masterul Redis și PostgreSQL. Clusterul PostgreSQL era format dintr-un master și o replică cu replicare asincronă. Așa arăta schema de lucru cu bazele:
Implementarea PgBouncer
În timp ce ne mutam, produsul a evoluat și numărul utilizatorilor și al serverelor care lucrau cu PostgreSQL a crescut, iar noi am avut o lipsă de conexiuni. PostgreSQL creează un proces separat pentru fiecare conexiune și consumă resurse. Numărul de conexiuni poate fi crescut doar până la un anumit punct, altfel există riscul de a obține o funcționare neoptimizată a bazei de date. O opțiune ideală în această situație ar fi alegerea unui manager de conexiuni care să se interpune între bază.
Am avut două opțiuni pentru managerul de conexiuni: Pgpool și PgBouncer. Dar primul nu suportă modul de lucru tranzacțional cu baza de date, așa că am ales PgBouncer.
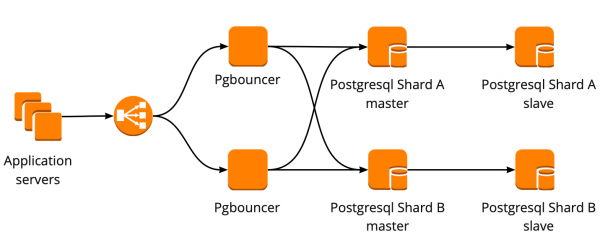
Am configurat următoarea schemă de lucru: aplicația noastră se conectează la un PgBouncer, în spatele căruia se află masterele PostgreSQL, iar în spatele fiecărui master există o replică cu replicare asincronă.
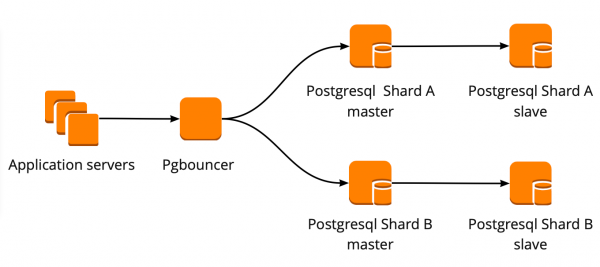
În același timp, nu am putut stoca întreaga cantitate de date în PostgreSQL și pentru noi viteza de lucru cu baza a fost importantă, așa că am început să shard-uim PostgreSQL la nivel de aplicație. Schema descrisă mai sus este relativ convenabilă pentru acest lucru: la adăugarea unui nou shard, este suficient să actualizăm configurația PgBouncer și aplicația poate lucra imediat cu noul shard.
Fiabilitatea PgBouncer
Această schemă a funcționat până când singurul instanț PgBouncer a căzut. Ne aflăm în AWS, unde toate instanțele sunt rulate pe hardware care se defectează periodic. În astfel de cazuri, instanța se mută pur și simplu pe un nou hardware și continuă să funcționeze. Exact asta s-a întâmplat cu PgBouncer, însă acesta a devenit indisponibil. Ca rezultat al acestei defecțiuni, serviciul nostru a fost indisponibil timp de 25 de minute. AWS recomandă pentru astfel de situații să se utilizeze redundanța la nivel de utilizator, ceea ce nu a fost implementat la noi în acel moment.
După aceasta, ne-am gândit serios la disponibilitatea PgBouncer și a clusterelor PostgreSQL, deoarece o situație similară ar putea să se repete cu orice instanță din contul nostru AWS.
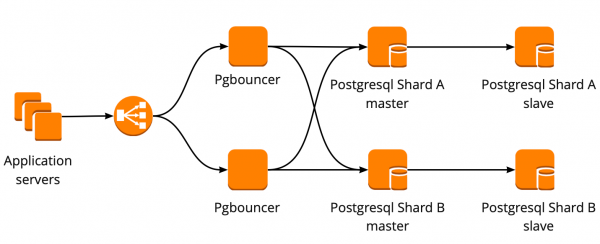
Planul nostru de redundanță pentru PgBouncer a fost construit astfel: toate serverele aplicației se conectează la Network Load Balancer, sub care se află doi PgBouncer. Fiecare PgBouncer se uită către aceleași mastere PostgreSQL ale fiecărui shard. În cazul în care instanța AWS ar cădea din nou, tot traficul va fi redirecționat prin celălalt PgBouncer. Redundanța Network Load Balancer este asigurată de AWS.
Această schemă permite adăugarea fără probleme a unor noi servere PgBouncer.
Crearea unui cluster PostgreSQL rezistent la defecțiuni
În rezolvarea acestei probleme, am analizat diferite opțiuni: failover personalizat, repmgr, AWS RDS, Patroni.
Scripturi personalizate
Pot monitoriza activitatea masterului și, în cazul căderii acestuia, pot promova replica la master și actualiza configurația PgBouncer.
Avantajele acestei abordări constau în simplitatea maximă, deoarece scrieți scripturile singuri și înțelegeți exact cum funcționează.
Dezavantaje:
- Masterul ar fi putut să nu fi murit; în schimb, ar fi putut avea loc o defecțiune de rețea. Failover-ul, fără a ști asta, va promova replica la master, iar vechiul master va continua să funcționeze. Ca rezultat, vom avea două servere în rol de master și nu vom ști pe care dintre ele se află ultimele date actualizate. Această situație este cunoscută și sub numele de split-brain;
- Am rămas fără replică. În configurația noastră, avem un master și o replică; după comutare, replica este promovată la master, iar noi nu mai avem replici, astfel că trebuie să adăugăm manual o nouă replică;
- Este necesar un monitorizare suplimentară a activității failover-ului, având în vedere că avem 12 sharde PostgreSQL, ceea ce înseamnă că trebuie să monitorizăm 12 clustere. Când numărul shardurilor crește, trebuie să nu uităm să actualizăm și failover-ul.
Un failover scris de mână pare foarte complex și necesită suport neobișnuit. Cu un cluster PostgreSQL, aceasta va fi cea mai simplă opțiune, dar nu se scalează, așa că nu se potrivește pentru noi.
Repmgr
Replication Manager pentru clustere PostgreSQL, care poate gestiona funcționarea clusterului PostgreSQL. Cu toate acestea, nu are failover automat „din cutie”, așa că va trebui să scriem propriul „wrapper” deasupra soluției existente. Așadar, totul ar putea fi chiar mai complicat decât cu scripturile scrise de mână, de aceea nu am încercat nici măcar Repmgr.
AWS RDS
Suportă tot ce avem nevoie, poate face backup-uri și suportă pool-uri de conexiuni. Are comutare automată: când masterul moare, replica devine noul master, iar AWS schimbă înregistrarea DNS la noul master, în timp ce replicile pot fi în zone diferite.
Dezavantajele includ lipsa unor setări fine. Un exemplu de setări fine sunt restricțiile pentru conexiunile TCP pe instanțele noastre, ceea ce, din păcate, nu poate fi realizat în RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
În plus, prețul pentru AWS RDS este aproape de două ori mai mare decât prețul obișnuit al instanței, ceea ce a fost motivul principal pentru a renunța la această soluție.
Patroni
Acesta este un șablon în python pentru gestionarea PostgreSQL cu o documentație bună, failover automat și cod sursă pe github.
Avantajele Patroni:
- Fiecare parametru de configurare este descris, este clar cum funcționează fiecare;
- Failover-ul automat funcționează din cutie;
- Scris în python, iar deoarece noi scriem mult în python, ne va fi mai ușor să rezolvăm problemele și, poate, chiar să ajutăm dezvoltarea proiectului;
- Gestionează complet PostgreSQL, permite modificarea configurației imediat pe toate nodurile clusterului, iar dacă aplicarea noii configurații necesită repornirea clusterului, se poate face din nou cu ajutorul Patroni.
Dezavantaje:
- Din documentație nu este clar cum să lucrăm corect cu PgBouncer. Deși este greu de numit un dezavantaj, deoarece sarcina Patroni este de a gestiona PostgreSQL, iar cum se vor face conexiunile către Patroni — este deja problema noastră;
- Există puține exemple de implementare a Patroni la volume mari, în timp ce există multe exemple de implementări de la zero.
În concluzie, pentru a crea un cluster rezistent la defecțiuni, am ales exact Patroni.
Procesul de implementare a Patroni
Până la Patroni, aveam 12 sharduri PostgreSQL configurate cu un master și o replică cu replicare asincronă. Serverele aplicației se conectau la bazele de date prin intermediul Network Load Balancer-ului, care era în spatele a două instanțe cu PgBouncer, urmate de toate serverele PostgreSQL.
Pentru a implementa Patroni, a trebuit să alegem un magazin de configurație distribuit pentru cluster. Patroni funcționează cu sisteme distribuite de stocare a configurațiilor, cum ar fi etcd, Zookeeper, Consul. De fapt, avem un cluster Consul complet funcțional în producție, care lucrează împreună cu Vault și mai mult nu îl folosim. Un motiv excelent pentru a începe să folosim Consul pentru scopul său.
Cum funcționează Patroni cu Consul
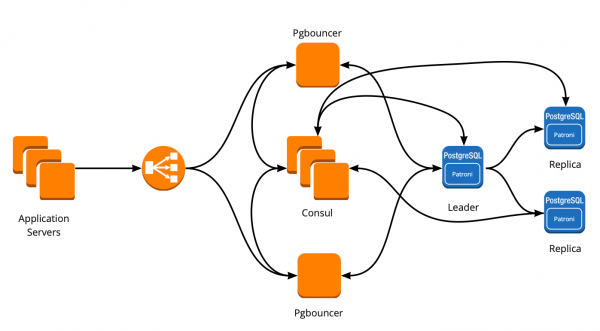
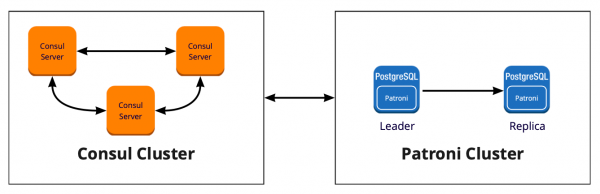
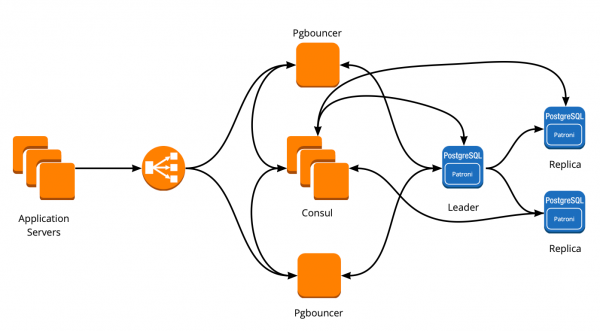
Avem un cluster Consul, care constă din trei noduri și un cluster Patroni, care are un lider și o replică (în Patroni, masterul se numește lider al clusterului, iar slabe-urile sunt replici). Fiecare instanță a clusterului Patroni trimite constant către Consul informații despre starea clusterului. Prin urmare, din Consul se poate afla întotdeauna configurația curentă a clusterului Patroni și cine este liderul în acel moment.
Pentru a conecta Patroni la Consul, este suficient să studiem documentația oficială, care menționează că trebuie să specificăm gazda în format http sau https, în funcție de modul în care lucrăm cu Consul, și schema de conectare, opțional:
host: gazda:port pentru punctul de terminare Consul, în format: http(s)://gazda:port
scheme: (opțional) http sau https, implicit http
Pare simplu, dar aici apar capcane. Lucrăm cu Consul printr-o conexiune securizată prin https și configurația noastră de conectare va arăta astfel:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Dar asta nu funcționează. La pornire, Patroni nu se poate conecta la Consul, deoarece încearcă totuși să folosească http.
Să înțelegem problema a ajutat codul sursă al Patroni. E bine că este scris în python. Se pare că parametrul gazdă nu este analizat, iar protocolul trebuie specificat în scheme. Iată cum arată un bloc de configurație funcțional pentru a lucra cu Consul la noi:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Așadar, am ales un depozit pentru configurație. Acum trebuie să înțelegem cum va comuta PgBouncer configurațiile sale atunci când liderul din clusterul Patroni se schimbă. În documentație nu există un răspuns pentru această întrebare, deoarece nu este descrisă în general interacțiunea cu PgBouncer.
În căutarea unei soluții, am găsit un articol (din păcate nu-mi amintesc numele), unde era menționat că Consul-template a ajutat foarte mult în legătura dintre PgBouncer și Patroni. Aceasta ne-a stimulat să explorăm funcționarea Consul-template.
Se pare că Consul-template monitorizează constant configurația clusterului PostgreSQL în Consul. La schimbarea liderului, acesta actualizează configurația PgBouncer și trimite o comandă pentru a o reîncărca.
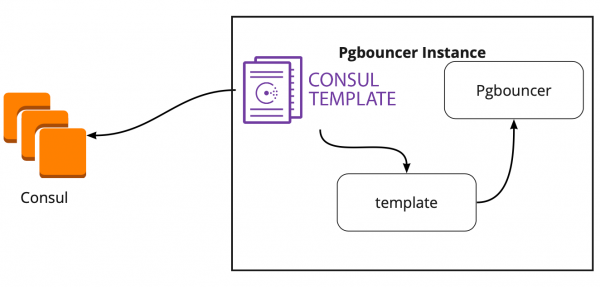
Un mare avantaj al template-ului este că acesta este stocat sub formă de cod, astfel încât, atunci când adăugăm un nou shard, este suficient să facem un nou commit și să actualizăm template-ul automat, menținând principiul Infrastructure as Code.
Noua arhitectură cu Patroni
În rezultat, am obținut o schemă de lucru de acest fel:
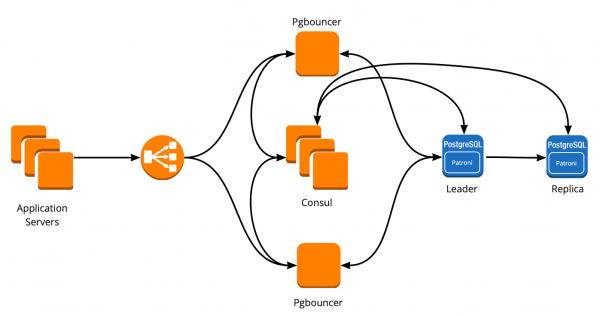
Toate serverele aplicației se conectează la balansor → în spatele său sunt două instanțe PgBouncer → pe fiecare instanță rulează Consul-template, care monitorizează starea fiecărui cluster Patroni și se asigură de actualitatea configurației PgBouncer, care trimite cereri către liderul actual al fiecărui cluster.
Testare manuală
Această schemă, înainte de a fi lansată în producție, a fost testată pe un mediu de testare mic și am verificat funcționarea comutării automate. Am deschis un tablou, am mutat un sticker și în acel moment am „ucis” liderul clusterului. În AWS, pentru aceasta, este suficient să oprești instanța prin consolă.
Sticker-ul revenea înapoi în 10-20 de secunde, după care începea din nou să se miște normal. Așadar, clusterul Patroni a reacționat corect: a schimbat liderul, a trimis informația în Consul, iar Consul-template a preluat imediat această informație, a înlocuit configurația PgBouncer și a trimis o comandă pentru reload.
Cum să supraviețuiești sub o sarcină mare și să menții un timp minim de nefuncționare?
Totul funcționează excelent! Dar apar întrebări noi: Cum va funcționa sub o sarcină mare? Cât de repede și în siguranță putem implementa totul în producție?
Răspunsul la prima întrebare ne ajută un mediu de testare, pe care îl folosim pentru testarea de încărcare. Acesta este complet identic cu mediul de producție din punct de vedere arhitectural și are date de test generate, care sunt aproximativ egale ca volum cu cele din producție. Decidem pur și simplu să „omorâm” unul dintre masterele PostgreSQL în timpul testului și să vedem ce se întâmplă. Dar înainte de aceasta, este important să verificăm desfășurarea automată, deoarece în acest mediu avem mai multe sharduri PostgreSQL, așa că vom obține o testare excelentă a scripturilor de configurare înainte de producție.
Ambele sarcini par ambițioase, dar avem PostgreSQL 9.6. Poate ne actualizăm direct la 11.2?
Decidem să facem acest lucru în 2 etape: mai întâi să actualizăm versiunea la 11.2, apoi să lansăm Patroni.
Actualizarea PostgreSQL
Pentru o actualizare rapidă a versiunii PostgreSQL, este necesar să folosiți opțiunea -k, care creează legături hard pe disc și nu necesită copierea datelor dumneavoastră. Pe bazele de date cu 300-400 GB, actualizarea durează 1 secundă.
Avem multe sharduri, așa că actualizarea trebuie să fie realizată în mod automat. Pentru aceasta, am scris un playbook Ansible, care execută întregul proces de actualizare pentru noi:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--legătură </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Aici este important de menționat că înainte de a lansa upgrade-ul, trebuie să-l executăm cu parametru —check, pentru a fi siguri de posibilitatea upgrade-ului. De asemenea, scriptul nostru face înlocuirea fișierelor de configurare în timpul upgrade-ului. Scriptul nostru a fost finalizat în 30 de secunde, ceea ce este un rezultat excelent.
Lansarea Patroni
Pentru a rezolva a doua problemă, este suficient să ne uităm la configurația Patroni. În repository-ul oficial există un exemplu de configurație cu initdb, care este responsabil pentru inițializarea unei noi baze la prima lansare a Patroni. Dar, deoarece avem deja o bază gata, am eliminat pur și simplu această secțiune din configurație.
Când am început să instalăm Patroni pe un cluster PostgreSQL deja existent și să-l lansăm, ne-am confruntat cu o nouă problemă: ambele servere se lansau ca lider. Patroni nu știe nimic despre starea anterioară a cluster-ului și încearcă să pornească ambele servere ca două clustere separate cu același nume. Pentru a rezolva această problemă, este necesar să ștergem directorul cu date pe slave:
rm -rf /var/lib/postgresql/Aceasta trebuie să fie făcută doar pe slave!
Când se conectează o replică curată, Patroni face un basebackup de la lider și îl restabilește pe replică, apoi ajunge la starea actuală prin jurnalul wal.
O altă dificultate cu care ne-am confruntat este că toate clusterele PostgreSQL sunt, în mod implicit, numite main. Când fiecare cluster nu știe nimic despre altul, este în regulă. Dar când doriți să folosiți Patroni, toate clusterele trebuie să aibă un nume unic. Soluția este să schimbați numele clusterului în configurația PostgreSQL.
Test de încărcare
Am efectuat un test care imită activitatea utilizatorilor pe tableau. Când încărcarea a atins valoarea noastră medie zilnică, am repetat exact același test și am oprit un instance cu liderul PostgreSQL. Failover-ul automat a funcționat așa cum ne așteptam: Patroni a schimbat liderul, Sconsul-template a actualizat configurația PgBouncer și a trimis comanda de reload. Din graficele noastre în Grafana, a fost vizibil că au existat întârzieri de 20-30 de secunde și un volum mic de erori de la serverele asociate cu conexiunea la baza de date. Aceasta este o situație normală, astfel de valori sunt acceptabile pentru failover-ul nostru și cu siguranță sunt mai bune decât downtime-ul serviciului.
Iesirea Patroni în producție
În final, am obținut următorul plan:
- Deploy-ul Sconsul-template pe serverele PgBouncer și lansarea;
- Actualizarea PostgreSQL la versiunea 11.2;
- Schimbarea numelui clusterului;
- Lansarea clusterului Patroni.
În acest timp, schema noastră permite realizarea primului punct practic în orice moment, putem scoate pe rând fiecare PgBouncer din funcțiune și efectua deploy-ul și lansarea consul-template. Așa am procedat.
Pentru o desfășurare rapidă, am folosit Ansible, deoarece toate playbook-urile le-am testat deja în mediu de testare, iar timpul de execuție al scenariului complet a fost de la 1,5 la 2 minute pentru fiecare shard. Am putea să desfășurăm totul pe rând pe fiecare shard fără a opri serviciul nostru, dar ar fi trebuit să oprim fiecare PostgreSQL timp de câteva minute. În acest caz, utilizatorii al căror date sunt pe acest shard nu ar fi putut lucra în mod normal în acest timp, iar acest lucru pentru noi este inacceptabil.
Soluția a fost un maintenance planificat, care se desfășoară la fiecare 3 luni. Acest interval este rezervat pentru lucrări de întreținere programate, când oprim complet serviciul nostru și actualizăm instanțele bazelor de date. Mai rămăsese o săptămână până la următorul interval și am decis să așteptăm și să ne pregătim suplimentar. În timpul așteptării, ne-am asigurat suplimentar: pentru fiecare shard PostgreSQL am ridicat câte o replică de rezervă în caz de eșec, pentru a păstra cele mai recente date, și am adăugat câte o nouă instanță pentru fiecare shard, care va deveni noua replică în clusterul Patroni, astfel încât să nu executăm comanda pentru ștergerea datelor. Toate acestea au ajutat la minimizarea riscurilor de eroare.
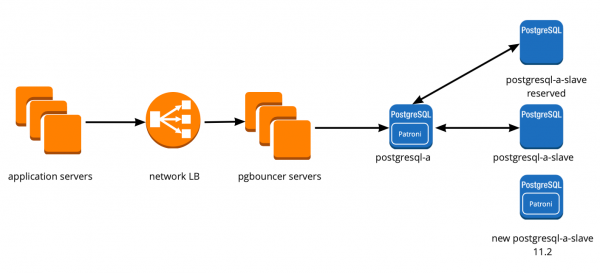
Am repornit serviciul nostru, totul a funcționat corespunzător, utilizatorii au continuat să lucreze, dar pe grafice am observat o încărcare anormal de mare pe serverele Consul.
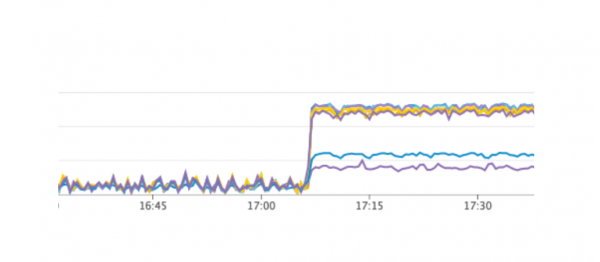
De ce nu am observat asta pe mediu de testare? Această problemă ilustrează foarte bine necesitatea de a urma principiul Infrastructure as Code și de a dezvolta întreaga infrastructură, începând cu mediile de testare și terminând cu production. Altfel, este foarte ușor să întâlnești o problemă similară cu cea pe care am avut-o noi. Ce s-a întâmplat? Consul a apărut mai întâi pe production, iar apoi pe mediile de testare, iar în final pe mediile de testare versiunea Consul era mai recentă decât pe production. Chiar într-unul dintre release-uri a fost rezolvată o scurgere de CPU când se lucra cu consul-template. Așadar, am actualizat Consul, rezolvând astfel problema.
Repornire cluster Patroni
Cu toate acestea, am întâmpinat o nouă problemă, despre care nici nu bănuiai. Când actualizăm Consul, pur și simplu eliminăm nodul Consul din cluster folosind comanda consul leave → Patroni se conectează la un alt server Consul → totul funcționează. Dar când am ajuns la ultima instanță din clusterul Consul și i-am trimis comanda consul leave, toate clusterele Patroni s-au repornit, iar în loguri am văzut următoarea eroare:
EROARE: get_cluster
Înapoi la apelul recent:
...
RetryFailedError: 'Limita de reîncercare a fost depășită'
EROARE: Eroare de comunicare cu DCS
<b>LOG: sistemul de baze de date este oprit</b>
Clusterul Patroni nu a putut obține informații despre propriul cluster și s-a repornit.
Pentru a găsi o soluție, ne-am adresat autorilor Patroni printr-o problemă pe GitHub. Aceștia au propus îmbunătățiri ale fișierelor noastre de configurare:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Am reușit să repetăm problema pe mediu de testare și am testat acolo aceste setări, dar, din păcate, ele nu au funcționat.
Problema rămâne nerezolvată. Plănuim să încercăm următoarele soluții:
- Utilizarea agentului Consul pe fiecare instanță a clusterei Patroni;
- Corectarea problemei în cod.
Ne este clar locul în care apare eroarea: probabil, problema se află în utilizarea timeout-ului implicit, care nu este suprascris prin fișierul de configurare. La eliminarea ultimei instanțe Consul din cluster, întreg clusterul Consul se blochează pentru mai mult de o secundă, din acest motiv Patroni nu poate obține starea clusterului și repornește complet întregul cluster.
Din fericire, nu am întâmpinat alte erori.
Sumar privind utilizarea Patroni
După lansarea cu succes a Patroni, am adăugat câte o replică suplimentară în fiecare cluster. Acum, în fiecare cluster există o formă de cvorum: un lider și două replici, pentru a asigura protecție în cazul unui split-brain la comutare.
Pe producție, Patroni funcționează de mai bine de trei luni. În acest timp, ne-a scos de multe ori din impas. Recent, în AWS, liderul unuia dintre clustere a murit, failover-ul automat s-a activat și utilizatorii au continuat să lucreze. Patroni și-a îndeplinit sarcina principală.
Un mic sumar al utilizării Patroni:
- Ușurința de a schimba configurația. Este suficient să schimbi configurația pe o instanță și aceasta se va aplica la întregul cluster. Dacă este necesară repornirea pentru aplicarea noii configurații, Patroni va anunța acest lucru. Patroni poate reporni întregul cluster cu un singur comandă, ceea ce este deosebit de convenabil.
- Failover-ul automat funcționează și ne-a salvat deja.
- Actualizarea PostgreSQL fără downtime pentru aplicație. Este necesar mai întâi să actualizezi replicile la noua versiune, apoi să schimbi liderul în clusterul Patroni și să actualizezi vechiul lider. În timpul acestui proces se efectuează testarea necesară a failover-ului automat.
Sursa: habr.com
