

Principala mea activitate constă în, în mare parte, desfășurarea sistemelor de software, astfel că petrec mult timp încercând să răspund la astfel de întrebări:
- Programul funcționează pentru dezvoltator, dar pentru mine nu. De ce?
- Ieri programul a funcționat la mine, dar astăzi nu. De ce?
Aceasta este o formă de depanare, care diferă puțin de depanarea obișnuită a software-ului. Depanarea obișnuită se referă la logica codului, în timp ce depanarea desfășurării se referă la interacțiunea dintre cod și mediu. Chiar dacă rădăcina problemei este o eroare logică, faptul că pe o mașină totul funcționează, iar pe alta nu, înseamnă că problema are într-un fel legătură cu mediul.
De aceea, în loc de unelte obișnuite pentru depanare precum gdb am un alt set de unelte pentru depanarea desfășurării. Iar instrumentul meu preferat pentru a combate problema de tipul «De ce acest software nu funcționează pentru mine?» se numește strace.
Ce este strace?
— este un instrument pentru «urmărirea apelurilor de sistem». A fost creat inițial pentru Linux, dar aceleași funcționalități de depanare pot fi folosite și cu unelte pentru alte sisteme ( sau ).
Utilizarea principală este extrem de simplă. Trebuie doar să rulați strace cu orice comandă, iar acesta va trimite în dump toate apelurile de sistem (de fapt, mai întâi probabil va trebui să instalați strace) strace):
$ strace echo Hello
...Snip lots of stuff...
write(1, "Hellon", 6)                  = 6
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ exited with 0 +++
Ce sunt aceste apeluri de sistem? Este ceva de genul API pentru nucleul sistemului de operare. Cu mult timp în urmă, software-ul avea acces direct la «hardware-ul» pe care funcționa. De exemplu, dacă trebuia să afișeze ceva pe ecran, interacționa cu porțile sau registrele afișate în memorie pentru dispozitivele video. Când sistemele de calcul cu multitasking au devenit populare, a început haosul, deoarece diferite aplicații se luptau pentru «hardware». Eroarea dintr-o aplicație putea afecta funcționarea altora, dacă nu întreaga sistemă în ansamblu. Atunci în CPU au apărut moduri de privilegiu (sau «protecția în cerc»). Cel mai privilegiat devenea nucleul: acesta avea acces complet la «hardware», generând aplicații cu privilegii mai reduse, care trebuiau să solicite acces de la nucleu pentru a interacționa cu «hardware» — prin apeluri de sistem.
La nivel binar, apelul sistemului diferă puțin de un apel simplu de funcție, totuși majoritatea programelor folosesc un wrapper în biblioteca standard. Adică, biblioteca standard POSIX C conține apelul funcției write(), care conține tot codul dependent de arhitectură pentru apelul sistemului write.
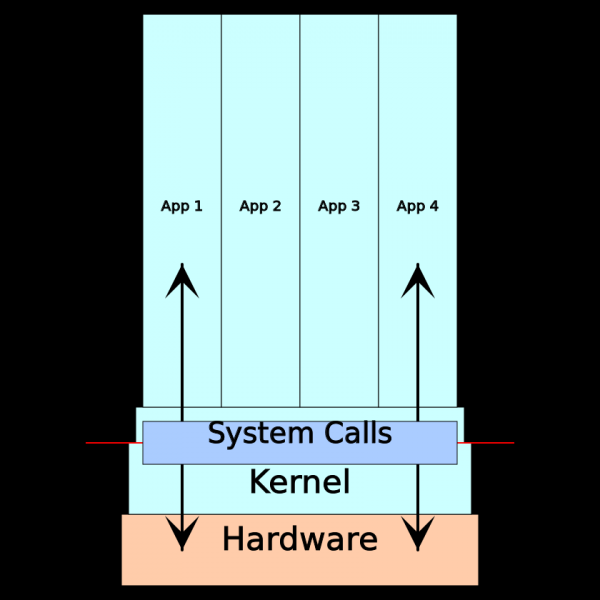
Pe scurt, orice interacțiune a unei aplicații cu mediul său (sistemele computerizate) se realizează prin apeluri de sistem. Deci, atunci când software-ul de pe o mașină funcționează, iar pe alta nu, ar fi bine să verifici rezultatele de urmărire a apelurilor de sistem. Dacă vrem să fim mai specifici, iată o listă de momente tipice care pot fi analizate prin urmărirea apelurilor de sistem:
- Intrare-ieșire pe consolă
- Intrare-ieșire de rețea
- Acces la sistemul de fișiere și intrare-ieșire de fișiere
- Gestionarea duratei de viață a proceselor/thredurilor
- Gestionare de nivel scăzut a memoriei
- Acces la driverele dispozitivelor speciale
Când să folosești strace?
Teoretic, strace este utilizat cu orice programe din spațiul utilizatorului, deoarece orice program din spațiul utilizatorului trebuie să efectueze apeluri de sistem. Funcționează mai eficient cu programe compilabile, de nivel scăzut, dar poate funcționa și cu limbaje de nivel înalt precum Python, dacă reușești să te descurci prin zgomotul suplimentar al mediului de execuție și al interpretului.
În toată splendoarea strace își arată adevărata valoare în timpul depanării software-ului care funcționează bine pe o mașină, dar pe alta încetează brusc să funcționeze, generând mesaje confuze despre fișiere, permisiuni sau încercări nereușite de a executa anumite comenzi sau ceva asemănător... Din păcate, nu se potrivește foarte bine cu problemele de nivel înalt, cum ar fi erorile de verificare a certificatului. De obicei, este nevoie de o combinație strace, uneori și instrumente de nivel mai înalt (cum ar fi instrumentul de linie de comandă openssl pentru depanarea certificatului).
De exemplu, să luăm în considerare lucrul pe un server izolat, dar urmărirea apelurilor de sistem poate fi efectuată și pe platforme de implementare mai complexe. Trebuie doar să alegi instrumentele potrivite.
Exemplu de depanare simplă
Spuneți că doriți să rulați o aplicație server fantastică foo, dar obțineți următoarea eroare:
$ foo
Eroare deschidere fișier de configurare: Nu există astfel de fișier sau director
Se pare că nu a reușit să găsească fișierul de configurare scris de tine. Asta se întâmplă deoarece, uneori, atunci când managerii de pachete compilează aplicația, ei redefinește locația așteptată a fișierelor. Iar dacă urmezi manuall de instalare pentru o distribuție, în alta găsești fișierele într-o locație complet diferită de cea așteptată. Problema ar fi putut fi rezolvată în câteva secunde dacă mesajul de eroare ar fi indicat unde ar trebui căutat fișierul de configurare, dar nu spune asta. Așadar, unde să căutăm?
Dacă ai acces la codul sursă, îl poți citi și totul va fi clar. Este un plan de rezervă bun, dar nu cea mai rapidă soluție. Poți folosi un debugger pas cu pas, cum ar fi gdb , și să vezi ce face aplicația, dar este mult mai eficient să folosești un instrument special conceput pentru a arăta interacțiunile cu mediul: strace.
Ieșire strace poate părea excesiv, dar vestea bună este că o mare parte din el poate fi ignorată fără grijă. Este adesea util să folosești operatorul -o pentru a salva rezultatele traseului într-un fișier separat:
$ strace -o /tmp/trace foo
Eroare la deschiderea fișierului de configurare: Nu există astfel de fișier sau director
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 variabile */) = 0
brk(NULL) = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK) = -1 ENOENT (Nu există astfel de fișier sau director)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3) = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3) = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186) = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (Nu există astfel de fișier sau director)
dup(2) = 3
fcntl(3, F_GETFL) = 0x2 (flag O_RDWR)
brk(NULL) = 0x56363b3fb000
brk(0x56363b41c000) = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Eroare la deschiderea fișierului de configurare"..., 60) = 60
close(3) = 0
exit_group(1) = ?
+++ ieșire cu 1 +++
Aproape toată prima pagină a ieșirii strace — este de obicei o pregătire la un nivel inferior pentru a începe. (Multe apeluri mmap, mprotect, brk pentru lucruri de tip descoperire a memoriei la un nivel inferior și maparea bibliotecilor dinamice.) De obicei, în timpul depanării, ieșirile strace sunt mai bine citite de la sfârșit. La baza va fi apelul write, care generează un mesaj de eroare. Ne uităm mai sus și vedem primul apel de sistem eronat — apelul openat, care dă eroarea ENOENT („fișier sau director nerecunoscut“), încercând să deschidă /etc/foo/config.json. Aici ar trebui să se afle fișierul de configurare.
A fost doar un exemplu, dar aș spune că 90% din timpul în care folosesc strace, nu trebuie să execut nimic mai complicat decât asta. Mai jos este un ghid detaliat pentru depanare:
- A te supăra din cauza unui mesaj vag de eroare de sistem din program
- A relansa programul cu strace
- A găsi în rezultatele de urmărire un mesaj de eroare
- A merge mai sus, până dai peste primul apel de sistem eșuat
Este foarte probabil ca apelul de sistem din pasul 4 să arate ce a mers prost.
Indicații
Înainte de a prezenta un exemplu de depanare mai complex, vă voi arăta câteva metode pentru o utilizare eficientă strace:
man - este prietenul vostru
Pe multe sisteme *nix, lista completă a apelurilor de sistem către kernel poate fi obținută rulând man syscalls. Veți vedea lucruri precum brk(2), ceea ce înseamnă că mai multe informații pot fi obținute rulând man 2 brk.
Mici capcane: man 2 fork îmi arată pagina pentru shell fork() în GNU libc, care, se pare, este implementată prin apelul clone(). Semantica apelului fork rămâne aceeași, dacă scriu un program care utilizează fork(), și rulez o urmărire - nu voi găsi apeluri fork, în locul lor vor fi clone(). Astfel de capcane doar complică lucrurile dacă începem să comparăm sursa cu rezultatul strace.
Folosiți -o pentru a salva rezultatul într-un fișier
strace poate genera un output extins, astfel că este adesea util să păstrați rezultatele urmăririi în fișiere separate (cum este exemplul de mai sus). De asemenea, ajută la evitarea confuziei între output-ul programului și cel strace din consolă.
Folosiți -s pentru a vizualiza mai multe date ale argumentului
Cu siguranță ați observat că a doua parte a mesajului de eroare nu este arătată în exemplul de urmărie de mai sus. Acest lucru se datorează faptului că strace implicit arată doar primii 32 de biți ai argumentului de linie. Dacă doriți să vedeți mai mult, adăugați ceva de genul -s 128 la apelul strace.
-u facilitează urmărirea fișierelor, socket-urilor etc.
"Totul este fișier" înseamnă că sistemele *nix efectuează toate operațiile de intrare-ieșire folosind descriptorii de fișiere, fie că este vorba de un fișier, de rețea sau de canale între procese. Acest lucru este convenabil pentru programare, dar complică urmărirea a ceea ce se întâmplă de fapt atunci când vedeți un total read și write în rezultatele urmăririi apelurilor de sistem.
Adăugând operatorul -u, veți forța strace să annotateze fiecare descriptor de fișier în output cu o notă, la ce se referă.
Atașați-vă la un proces deja pornit cu -p**
După cum se va vedea în exemplul de mai jos, uneori este necesar să urmăriți un program care este deja în execuție. Dacă știți că este pornit ca proces 1337 (să zicem, din output-urile ps), atunci puteți urmări-l astfel:
$ strace -p 1337
...output-ul urmăririi apelurilor de sistem...
Este posibil să aveți nevoie de drepturi de root.
Folosiți -f pentru a urmări procesele fiice.
strace implicit, tracează doar un singur proces. Dacă acest proces generează procese fiice, atunci este posibil să vezi apelul de sistem pentru generarea procesului fiu, dar apelurile de sistem ale procesului fiu nu vor fi afișate.
Dacă credeți că eroarea este în procesul fiu, folosiți operatorul -f, aceasta va activa trasarea lui. Dezavantajul este că ieșirea vă va confunda și mai mult. Când strace trasează un singur proces sau o singură ramură, arată un singur flux de evenimente ale apelurilor. Atunci când trasează mai multe procese în același timp, este posibil să vedeți începutul unui apel, întrerupt de un mesaj <unfinished …>, apoi o mulțime de apeluri pentru alte ramuri de execuție, iar abia apoi finalizarea primului cu <… foocall resumed>. Sau separați toate rezultatele trasării în fișiere diferite, folosind de asemenea operatorul -ff (detalii în pe strace).
Filtrați trasarea folosind -e
După cum vedeți, rezultatul trasării este o adevărată grămadă de toate apelurile posibile de sistem. Cu ajutorul flag-ului -e puteți filtra trasarea (vezi. pe strace). Principalul avantaj este că a rula trasarea cu filtrare este mai rapid decât a face o trasare completă și apoi grep`a. Dacă trebuie să fim cinstiți, de obicei nu-mi pasă deloc.
Nu toate erorile sunt rele.
Un exemplu simplu și comun este un program care caută un fișier în mai multe locuri, cum ar fi un shell care caută în care coș de reciclare se află fișierul executabil:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (Nu există un astfel de fișier sau director)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (Nu există un astfel de fișier sau director)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
Heuristica tip «ultimul apel eșuat înainte de mesajul de eroare» este bună pentru a găsi erori relevante. Oricum, este logic să începi din spate.
Înțelegerea apelurilor de sistem este ajutată foarte bine de ghidurile de programare în limbajul C.
Apelurile standard către bibliotecile C nu sunt apeluri de sistem, ci doar un strat subțire de suprafață. Așadar, dacă înțelegi puțin cum și ce trebuie făcut în C, îți va fi mai ușor să te descurci cu rezultatele trasării apelului de sistem. De exemplu, dacă ai probleme cu debugging-ul apelurilor de sistem de rețea, consultă clasicul .
Un exemplu de debugging mai complex.
Am spus deja că un exemplu simplu de depanare este ceva cu care mă confrunt în majoritatea cazurilor în lucru cu strace. Cu toate acestea, uneori este nevoie de o adevărată investigație, așa că iată un exemplu real de depanare mai complicat.
— un programator de sarcini, o altă implementare a demonului *nix cron. Este instalat pe server, dar când cineva încearcă să editeze programul, iată ce se întâmplă:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Bine, deci bcron a încercat să scrie un fișier, dar nu a reușit și nu recunoaște de ce. Să examinăm strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
Aproape la final există un mesaj de eroare write, dar de data aceasta ceva este diferit. În primul rând, nu există o eroare de apel de sistem relevantă care să fi apărut înainte. În al doilea rând, se vede că undeva cineva a citit deja mesajul de eroare. Pare că adevărata problemă este în altă parte, iar bcrontab doar reproduce mesajul.
Dacă privim man 2 read, putem vedea că primul argument (3) este un descriptor de fișier, pe care *nix îl folosește pentru toate procesările de intrare-ieșire. Cum aflăm ce reprezintă descriptorul de fișier 3? În acest caz specific, putem rula strace cu operatorul -u (vezi mai sus), și acesta va povesti automat, totuși, pentru a calcula lucruri de genul acesta, este util să știm cum să citim și să analizăm rezultatele urmăririi.
Sursa descriptorului de fișier poate fi unul dintre numeroasele apeluri de sistem (totul depinde de ce este descriptorul - pentru consolă, socket de rețea, fișier propriu zis sau altceva), însă indiferent de caz, căutăm apelurile returnând 3 (adică căutăm „= 3” în rezultatele urmăririi). În acest rezultat sunt 2: openat în partea de sus și socket în mijloc. openat deschide fișierul, dar close(3) după aceea va arăta că este închis din nou. (Capcana: descriptorii de fișier pot fi reutilizați atunci când sunt deschiși și închiși). Apelul socket() se potrivește, deoarece este ultimul înainte de read(), și se dovedește că bcrontab lucrează cu ceva prin socket. Linia următoare arată că descriptorul de fișier este legat de unix domain socket pe calea /var/run/bcron-spool.
Deci, trebuie să găsim procesul legat de unix socket de cealaltă parte. Pentru acest scop există câteva trucuri elegante, și ambele vor fi utile pentru depanarea desfășurărilor de server. Primul — să folosim netstat sau un mai nou ss (starea socketului). Ambele comenzi arată conexiunile de rețea active ale sistemului și iau operatorul -l pentru a descrie socketurile ascultătoare, precum și operatorul -p pentru a afișa programele conectate la socket ca și clienți. (Există mult mai multe opțiuni utile, dar pentru această sarcină sunt suficiente aceste două.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
Aceasta indică faptul că ascultătorul este comanda inixserver, care funcționează cu ID-ul procesului 20629. (Și, din întâmplare, utilizează descriptorul de fișier 3 ca socket.)
Al doilea instrument cu adevărat util pentru găsirea aceleași informații se numește lsof. Acesta listează toate fișierele deschise (sau descriptorii de fișiere) în sistem. Sau se poate obține informații despre un fișier specific:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
Procesul 20629 este un server de lungă durată, așa că se poate atașa la acesta strace folosind ceva de genul strace -o /tmp/trace -p 20629. Dacă se editează sarcina cron în alt terminal — vom obține rezultatele urmării cu eroarea care apare. Iată rezultatul:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Va fi reluato dacă SA_RESTART este setat)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Nu există procese copil)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Va fi reluato dacă SA_RESTART este setat)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Nu există procese copil)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(Ultim accept() nu va fi finalizat în timpul urmării.) Iarăși, din păcate, acest rezultat nu conține eroarea pe care o căutăm. Nu vedem niciun mesaj pe care bcrontag l-ar fi trimis socketului sau l-ar fi primit de la acesta. În locul lor, strict managementul proceselor (clone, wait4, SIGCHLD Și așa mai departe.) Acest proces generează un proces copil, care, după cum ne-am dat seama, execută treaba reală. Și dacă trebuie să-i urmărim urma, adăugați la apel strace -f. Iată ce vom găsi căutând mesajul de eroare în noul rezultat cu strace -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permisiune refuzată)
21470 write(1, "32:ZNu s-a putut crea fișierul temporar f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Nu există un astfel de fișier sau director)
21470 exit_group(111)                   = ?
21470 +++ a ieșit cu 111 +++
Iată, acum avem ceva. Procesul 21470 primește eroarea „permisiune refuzată” când încearcă să creeze un fișier la calea tmp/spool.21470.1573692319.854640 (referitor la directorul de lucru curent). Dacă am fi știut pur și simplu directorul de lucru curent, am fi știut și calea completă și am fi putut afla de ce procesul nu poate crea fișierul său temporar în el. Din păcate, procesul a ieșit deja, așa că nu putem folosi pur și simplu lsof -p 21470 pentru a găsi directorul curent, dar putem lucra invers - căutând apeluri de sistem pentru PID 21470, care schimbă directorul. (Dacă nu sunt, PID 21470 a moștenit probabil asta de la părinte, și aceasta deja prin lsof -p nu se poate afla.) Acest apel de sistem este chdir (ceea ce nu e greu de aflat cu ajutorul motoarelor de căutare moderne). Iată rezultatul căutărilor inverse pe baza rezultatelor de urmărire, până la serverul PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 variabile */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permisiune refuzată)
21470 write(1, "32:ZNu s-a putut crea fișierul temporar f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Nu există un astfel de fișier sau director)
21470 exit_group(111)                   = ?
21470 +++ a ieșit cu 111 +++
(Dacă te pierzi, poate că ar trebui să citești postul meu anterior . Așadar, serverul PID 20629 nu a obținut permisiunea de a crea un fișier la calea /var/spool/cron/tmp/spool.21470.1573692319.854640. Cel mai probabil, motivul este setările clasice de permisiune ale sistemului de fișiere. Să verificăm:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
Iată unde este problema! Serverul rulează ca cron utilizator, dar doar root are permisiunea de a scrie în directorul /var/spool/cron/tmp/. O simplă comandă chown cron /var/spool/cron/tmp/ va rezolva bcron a funcționa corect. (Dacă problema nu se află aici, atunci următorul suspect cel mai plauzibil este un modul de securitate al nucleului precum SELinux sau AppArmor, așa că aș verifica jurnalul de mesaje al nucleului folosind dmesg.)
În concluzie
Pentru un începător, rezultatele urmăririi apelurilor de sistem pot fi copleșitoare, dar sper că am arătat că acestea sunt o modalitate rapidă de a depana o întreagă gamă de probleme comune de implementare. Imaginează-ți că încerci să depanezi un mediu multiproces bcron, folosind un debugger pas cu pas.
Analiza retroactivă a rezultatelor urmăririi de-a lungul lanțului apelurilor de sistem necesită abilități, dar așa cum am spus, aproape întotdeauna, folosind strace, obțin pur și simplu rezultatul urmăririi și caut erori, începând de la final. În orice caz, strace îmi economisește o mulțime de timp în procesul de depanare. Sper că va fi util și pentru tine.
Sursa: habr.com
