

Câțiva ani în urmă, Kubernetes în blogul oficial GitHub. De atunci, a devenit tehnologia standard pentru desfășurarea serviciilor. Acum, Kubernetes gestionează o parte semnificativă din serviciile interne și publice. Pe măsură ce clusterele noastre au crescut, iar cerințele de performanță au devenit mai stricte, am început să observăm că în unele servicii pe Kubernetes apar întâmplător întârzieri care nu pot fi explicate prin încărcarea aplicației în sine.
Practic, în aplicații apare o întârziere de rețea aparent aleatorie de până la 100 ms sau mai mult, ceea ce duce la timeout-uri sau încercări suplimentare. Se aștepta ca serviciile să răspundă la cereri mult mai repede de 100 ms. Dar acest lucru nu este posibil dacă însuși conexiunea durează atât de mult. Separat, am observat că cererile MySQL foarte rapide, care ar fi trebuit să dureze milisecunde, MySQL le trata într-adevăr în milisecunde, dar din perspectiva aplicației solicitante, răspunsul dura 100 ms sau mai mult.
A devenit imediat clar că problema apare doar la conectarea la un nod Kubernetes, chiar și atunci când apelul venea din exteriorul Kubernetes. Cel mai simplu este să reproducem problema într-un test , care este lansat de orice gazdă internă, testează serviciul Kubernetes pe un anumit port și înregistrează în mod sporadic întârzieri mari. În acest articol, vom explora cum am reușit să identificăm cauza acestei probleme.
Eliminăm complexitatea inutilă din lanțul spre eșec
Reproducând aceeași problemă, am dorit să ne concentrăm asupra problemei și să eliminăm straturile inutile de complexitate. Inițial, în fluxul dintre Vegeta și pod-urile pe Kubernetes erau prea multe elemente. Pentru a determina o problemă de rețea mai profundă, este necesar să excludem unele dintre ele.
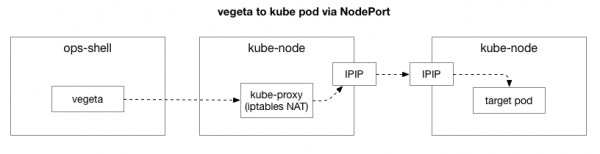
Clientul (Vegeta) stabilește o conexiune TCP cu orice nod din cluster. Kubernetes funcționează ca o rețea overlay (peste rețeaua existentă a centrului de date), care folosește , adică încapsulează pachetele IP din rețeaua overlay în pachetele IP ale centrului de date. La conectarea la primul nod se efectuează o traducere a adreselor de rețea (NAT) cu urmărirea stării pentru conversia adresei IP și portului nodului Kubernetes într-o adresă IP și port în rețeaua overlay (în special, a pod-ului cu aplicația). Pentru pachetele primite, se execută o secvență inversă de acțiuni. Aceasta este o sistem complex cu un număr mare de stări și multe elemente care se actualizează și se schimbă constant pe măsură ce se desfășoară și se mută serviciile.
Utilitarul tcpdump în testul Vegeta oferă o întârziere în timpul handshake-ului TCP (între SYN și SYN-ACK). Pentru a elimina această complexitate suplimentară, se poate folosi hping3 pentru simple "ping-uri" cu pachete SYN. Verificăm dacă există o întârziere în pachetul de răspuns, iar apoi resetăm conexiunea. Putem filtra datele, incluzând doar pachetele de peste 100 ms, și obținem o variantă mai simplă pentru reproducerea problemei, comparativ cu testul complet de nivel 7 în Vegeta. Iată "ping-urile" nodului Kubernetes folosind TCP SYN/SYN-ACK pe "portul nodului" serviciului (30927) cu un interval de 10 ms, filtrat după cele mai lente răspunsuri:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Se poate observa imediat primul lucru. Din numerele de ordine și timpii se vede că acestea nu sunt congestii unice. Întârzierea se acumulează frecvent și, în cele din urmă, este procesată.
De asemenea, dorim să descoperim ce componente ar putea fi implicate în apariția congestiei. Poate că este vorba despre unele dintre cele sute de reguli iptables în NAT? Sau despre probleme cu tunelarea IPIP în rețea? Una dintre metodele de a verifica acest lucru este să examinăm fiecare pas al sistemului, excluzându-l. Ce se va întâmpla dacă eliminăm NAT și logica firewall-ului, lăsând doar partea IPIP:
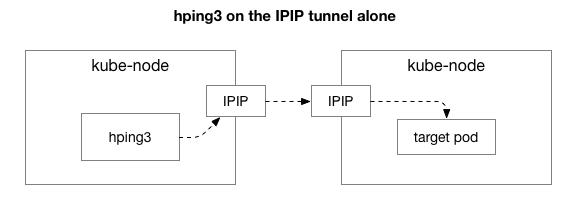
Din fericire, Linux permite accesul direct la stratul de overlay IP, dacă mașina se află în aceeași rețea:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Din rezultatele obținute, problema este încă prezentă! Aceasta exclude iptables și NAT. Așadar, problema este în TCP? Să vedem cum decurge un ping ICMP obișnuit:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Rezultatele arată că problema nu a dispărut. Poate este un tunel IPIP? Să simplificăm și mai mult testul:
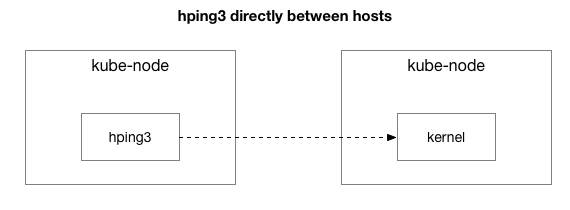
Toate pachetele sunt trimise între aceste două gazde?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Am simplificat situația la două noduri Kubernetes, care își trimit orice pachet, chiar și ping ICMP, unul altuia. Ei totuși observă o întârziere, dacă gazda țintă este "rea" (unele fiind mai rele decât altele).
Acum ultima întrebare: de ce apare întârzierea doar pe serverele kube-node? Și se întâmplă atunci când kube-node este expeditor sau receptor? Din fericire, e destul de ușor de aflat, trimițând un pachet de pe un gazdă din afara Kubernetes, dar cu același "receptor cunoscut rău". După cum vedem, problema nu a dispărut:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Apoi, vom efectua aceleași cere de la kube-node sursa anterioară către gazda externă (ceea ce exclude gazda sursă, deoarece ping-ul include atât componenta RX, cât și TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 statistica hping ---
 22352 pachete transmise, 22350 pachete primite, 1% pierdere de pachete
 timp de răspuns min/med/max = 0.2/7.6/1010.6 ms
După analizarea capturilor de pachete cu întârziere, am obținut informații suplimentare. În special, expeditorul (în partea de jos) observă acest timeout, în timp ce receptorul (în partea de sus) nu vede — vezi coloana Delta (în secunde):
În plus, dacă ne uităm la diferența în ordinea pachetelor TCP și ICMP (după numerele de ordine) pe partea receptorului, pachetele ICMP sosesc întotdeauna în aceeași ordine în care au fost trimise, dar cu momente diferite. În același timp, pachetele TCP se intercalează uneori, iar o parte dintre ele rămân blocate. În special, dacă analizăm porturile pachetelor SYN, pe partea expeditorului acestea sunt în ordine, dar pe partea receptorului nu sunt.
Există o diferență subtilă în modul în care ale serverelor moderne (precum în centrul nostru de date) procesează pachetele care conțin TCP sau ICMP. Atunci când sosesc pachete, adaptatorul de rețea "hash-ează conexiunea", adică încearcă să împarte conexiunile în cozi și să trimite fiecare coadă pe un nucleu de procesor separat. Pentru TCP, acest hash include atât adresa IP sursă, cât și cea destinație și portul. Cu alte cuvinte, fiecare conexiune este hash-uită (potențial) diferit. Pentru ICMP, doar adresele IP sunt hash-uite, deoarece nu există porturi.
O altă observație nouă: în această perioadă vedem întârzieri ICMP în toate comunicațiile între cele două gazde, în timp ce pentru TCP nu există. Acest lucru ne indică faptul că cauza este probabil legată de hash-urarea cozii RX: este aproape sigur că congestia apare în procesarea pachetelor RX, nu în trimiterea răspunsurilor.
Acest lucru exclude din lista posibilelor cauze trimiterea pachetelor. Acum știm că problema cu procesarea pachetelor există pe partea de recepție pe unele servere kube-node.
Analizăm procesarea pachetelor în nucleul Linux
Pentru a înțelege de ce problema apare la receptor pe unele servere kube-node, să ne uităm la modul în care nucleul Linux procesează pachetele.
Revenind la cea mai simplă implementare tradițională, placa de rețea primește un pachet și trimite nucleului Linux, care informa că există un pachet care trebuie procesat. Nucleul oprește alte sarcini, trece la contextul handler-ului de întrerupere, procesează pachetul și apoi revine la sarcinile curente.
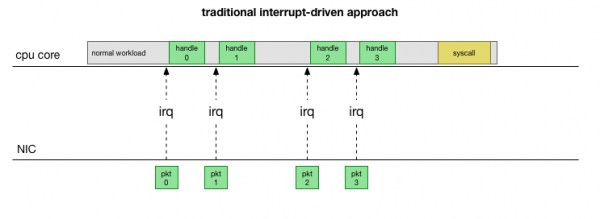
Această comutare de context se desfășoară lent: poate că întârzierea a fost invizibilă pe plăcile de rețea de 10 megabiți în anii '90, dar pe plăcile moderne 10G, cu o capacitate maximă de 15 milioane de pachete pe secundă, fiecare nucleu al unui mic server cu opt nuclee poate fi întrerupt de milioane de ori pe secundă.
Pentru a nu fi necesară procesarea constantă a întreruperilor, acum mulți ani, în Linux a fost adăugat : API-ul de rețea utilizat de toate driverele moderne pentru creșterea performanței la viteze mari. La viteze mici, nucleul încă primește întreruperi de la placa de rețea în modul vechi. Odată ce sosesc suficiente pachete care depășesc un anumit prag, nucleul dezactivează întreruperile și încep să interogheze adaptorul de rețea, preluând pachetele în loturi. Procesarea se desfășoară în softirq, adică în după apelurile de sistem și întreruperile hardware, când nucleul (spre deosebire de spațiul utilizatorilor) este deja activat.
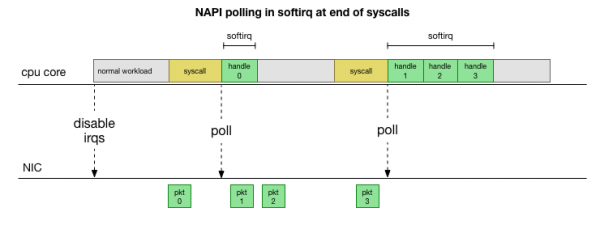
Acest lucru este mult mai rapid, dar generează o altă problemă. Dacă sunt prea multe pachete, tot timpul este dedicat procesării pachetelor de la placa de rețea, iar procesele din spațiul utilizatorului nu reușesc efectiv să golească aceste cozi (citind din conexiuni TCP etc.). În cele din urmă, cozile se umplu și începem să pierdem pachete. Încercând să găsească un echilibru, nucleul stabilește un buget pentru numărul maxim de pachete procesate în contextul softirq. Odată ce acest buget este depășit, un fir de execuție separat ksoftirqd (veți vedea unul dintre acestea în ps fiecare nucleu), care procesează aceste softirq în afara căii obișnuite de syscall/intrerupere. Acest fir este programat cu ajutorul planificatorului standard de procese, care încearcă să aloce resursele în mod echitabil.
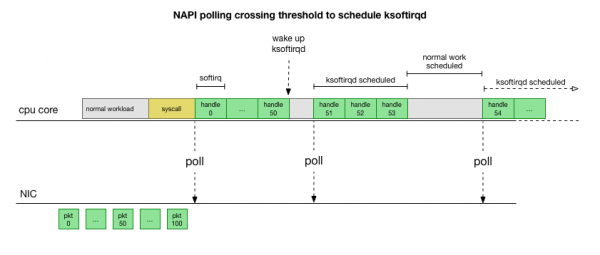
Studiind cum nucleul procesează pachetele, se poate observa că există o anumită probabilitate de apariție a blocajelor. Dacă apelurile softirq sosesc mai rar, pachetele vor trebui să aștepte un timp pentru a fi procesate în coada RX de pe placa de rețea. Acest lucru se poate datora unei sarcini care blochează nucleul procesorului sau altceva care împiedică nucleul să execute softirq.
Restrângem procesarea la nucleu sau metodă
Zilele de întârziere softirq sunt doar o ipoteză deocamdată. Dar are sens, și știm că se observă ceva foarte asemănător. Așadar, următorul pas este să confirmăm această teorie. Și dacă se confirmă, atunci să găsim cauza întârzierilor.
Să ne întoarcem la pachetele noastre lente:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Așa cum am discutat anterior, aceste pachete ICMP sunt hash-uite într-o coadă NIC RX și procesate de un singur nucleu CPU. Dacă vrem să înțelegem cum funcționează Linux, este util să știm unde (pe care nucleu CPU) și cum (softirq, ksoftirqd) sunt procesate aceste pachete pentru a urmări procesul.
Acum este momentul să folosim instrumente care permit monitorizarea în timp real a funcționării nucleului Linux. Aici am folosit . Această suită de instrumente permite scrierea unor programe mici în C, care interceptă funcții ale nucleului și bufferizează evenimentele într-un program Python de spațiu utilizator, care poate să le proceseze și să îți returneze rezultatul. Hook-urile pentru funcții arbitrari în nucleu sunt complicate, dar utilitarul este proiectat pentru a oferi maximă siguranță și este destinat monitorizării exact acestor probleme de producție, care sunt greu de reprodus în mediu de testare sau dezvoltare.
Planul aici este simplu: știm că nucleul procesează aceste pachete ICMP, așa că vom pune un hook pe funcția nucleului , care primește un pachet ICMP "echo request" și inițiază trimiterea unui răspuns ICMP "echo response". Putem identifica pachetul prin creșterea numărului icmp_seq, care arată hping3 sus.
Cod pare complicat, dar nu este atât de înfricoșător pe cât pare. Funcția icmp_echo transmite struct sk_buff *skb: acesta este pachetul cu solicitarea "echo request". Putem să-l urmărim, să extragem secvența echo.sequence (care se potrivește cu icmp_seq de la hping3 mai sus), și să o trimitem în spațiul utilizator. De asemenea, este util să capturăm numele curent al procesului/id-ul. Mai jos sunt rezultatele pe care le vedem direct în timpul procesării pachetelor de către nucleu:
TGID    PID     NUMELE PROCESULUI    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Aici trebuie observat că în contextul softirq procesele care au efectuat apeluri de sistem vor apărea ca „procese”, deși în realitate nucleul gestionează în mod sigur pachetele în contextul nucleului.
Cu acest instrument putem stabili legătura între procesele specifice și pachetele specifice care arată întârzieri în hping3. Facem un simplu grep pe această captură pentru valori specifice icmp_seq. Pachetele care corespund valorilor de icmp_seq menționate mai sus au fost marcate împreună cu RTT-ul lor, pe care l-am observat mai sus (valorile așteptate ale RTT pentru pachetele pe care le-am filtrat din cauza valorilor RTT de sub 50 ms sunt indicate între paranteze):
TGID    PID     NUMELE PROCESULUI    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Rezultatele ne spun câteva lucruri. În primul rând, toate aceste pachete sunt gestionate de contextul ksoftirqd/11. Aceasta înseamnă că pentru această pereche specifică de mașini, pachetele ICMP au fost hash-uite pe nucleul 11 al părții care primește. De asemenea, vedem că la fiecare blocaj sunt prezente pachete care sunt gestionate în contextul apelului de sistem cadvisor. Apoi ksoftirqd își asumă sarcina și procesează coada acumulată: exact numărul de pachete care s-au acumulat după cadvisor.
Faptul că înainte de asta mereu funcționează cadvisor, implică participarea sa în problemă. Ironia este că scopul este „analiză a utilizării resurselor și caracteristicilor de performanță ale containerelor rulate”, nu să provoace această problemă de performanță.
Ca și în alte aspecte ale funcționării containerelor, acesta este un instrument extrem de avansat, de la care s-ar putea să ne așteptăm la probleme de performanță în anumite circumstanțe neprevăzute.
Ce face cadvisor, care întârzie coada de pachete?
Acum avem o înțelegere destul de bună despre cum se produce eșecul, ce proces îl provoacă și pe ce CPU. Vedem că din cauza blocării stricte, nucleul Linux nu reușește să planifice la timp ksoftirqd. Și vedem că pachetele sunt procesate în contextul cadvisor. Logica sugerează că cadvisor întreprinde un syscall lent, după care sunt procesate toate pachetele acumulate în acest timp:
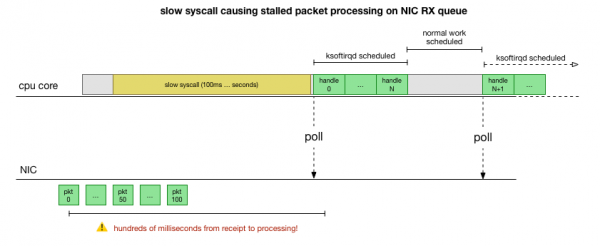
Aceasta este teoria, dar cum o putem verifica? Ceea ce putem face este să urmărim activitatea nucleului CPU pe parcursul întregului proces, să găsim punctul în care depășirea bugetului de pachete se produce și se invocă ksoftirqd, și apoi să ne uităm puțin mai devreme – ce anume a funcționat pe nucleul CPU imediat înainte de acest moment. Este ca un raze X al CPU-ului la fiecare câteva milisecunde. Ar trebui să arate cam așa:
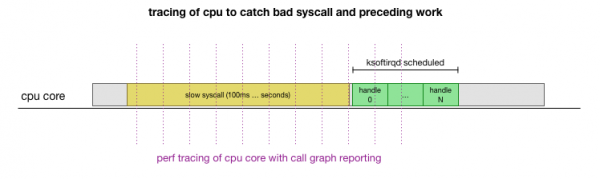
Este convenabil că totul poate fi realizat cu instrumentele existente. De exemplu, cu o periodicitate specificată, verifică nucleul CPU specificat și poate genera un grafic al apelurilor sistemului în funcțiune, incluzând atât spațiul utilizatorului, cât și nucleul Linux. Putem lua această înregistrare și să o procesăm cu un mic fork al programului de Brendan Gregg, care păstrează ordinea trasării stivei. Putem salva trasările stivei pe o linie la fiecare 1 ms și apoi să extragem și să păstrăm un eșantion pentru 100 de milisecunde înainte ca acesta să ajungă în trasare ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Iată rezultatele:
(sute de urme care arată asemănător)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Aici sunt multe lucruri, dar cel mai important este că găsim modelul „cadvisor înainte de ksoftirqd”, pe care l-am mai văzut anterior în traiectoria ICMP. Ce înseamnă asta?
Fiecare linie este o traiectorie a CPU-ului la un moment dat. Fiecare apel în josul stivei dintr-o linie este separat prin punct și virgulă. În mijlocul liniilor vedem syscall-ul apelat: read(): .... ;do_syscall_64;sys_read; .... Astfel, cadvisor petrece mult timp pe apelul de sistem read(), care se referă la funcțiile mem_cgroup_* (partea superioară a stivei de apeluri/sfârșitul liniei).
În traiectoria apelurilor este incomod să vezi ce anume este citit, așa că vom rula strace și vom vedea ce face cadvisor și vom găsi apeluri de sistem mai lungi de 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Așa cum ne așteptam, aici vedem apeluri lente read(). Din conținutul operațiunilor de citire și context mem_cgroup se vede că aceste apeluri read() se referă la fișierul memory.stat, care arată utilizarea memoriei și limitele cgroup (tehnologia de izolare a resurselor în Docker). Instrumentul cadvisor interoghează acest fișier pentru a obține informații despre utilizarea resurselor pentru containere. Să verificăm dacă nucleul sau cadvisor face ceva neașteptat:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~$
Acum putem reproduce bug-ul și înțelegem că nucleul Linux se confruntă cu o patologie.
De ce este atât de lentă operațiunea de citire?
În acest stadiu, este mult mai ușor să găsim mesaje ale altor utilizatori despre probleme similare. Se pare că în trackerul cadvisor acest bug a fost raportat ca , dar nimeni nu a observat că întârzierea se reflectă aleatoriu și în stiva de rețea. A fost într-adevăr observat că cadvisor consumă mai mult timp de procesor decât era de așteptat, dar acest lucru nu a fost considerat o problemă serioasă, deoarece serverele noastre au multe resurse de procesor, așa că nu s-a investigat problema în detaliu.
Problema este că grupurile de control (cgroups) țin cont de utilizarea memoriei în interiorul spațiului de nume (container). Când toate procesele din acest cgroup se termină, Docker eliberează grupul de control al memoriei. Totuși, „memoria” nu este doar memoria procesului. Deși memoria proceselor nu mai este utilizată, se pare că nucleul alocă și conținut cache, cum ar fi dentries și inodes (metadate ale directoarelor și fișierelor), care sunt cache-uite în memory cgroup. Din descrierea problemei:
cgroups-zombie: grupuri de control care nu au procese și au fost șterse, dar pentru care memoria este încă alocată (în cazul meu, din cache-ul dentry, dar poate fi de asemenea alocată din cache-ul paginilor sau tmpfs).
Verificarea de către nucleu a tuturor paginilor din cache la eliberarea cgroup-ului poate fi foarte lentă, de aceea a fost ales un proces leneș: așteptați ca aceste pagini să fie solicitate din nou și doar atunci, când memoria este cu adevărat necesară, să curățați, în sfârșit, cgroup-ul. Până atunci, cgroup-ul este în continuare considerat la colectarea statisticilor.
Din punct de vedere al performanței, au sacrificat memoria pentru viteză: accelerarea curățării inițiale prin menținerea unei cantități minime de memorie cache. Asta e în regulă. Când nucleul folosește ultima parte a memoriei cache, cgroup se curăță în cele din urmă, astfel încât nu poate fi considerată o „scurgere”. Din păcate, implementarea specifică a mecanismului de căutare memory.stat în această versiune a nucleului (4.9), combinată cu volumul uriaș de memorie de pe serverele noastre, duce la necesitatea unui timp mult mai mare pentru recuperarea ultimelor date memorizate și curățarea cgroup-urilor zombie.
Se pare că pe unele dintre nodurile noastre au fost atât de multe cgroup-uri zombie încât citirea și întârzierile depășeau o secundă.
O soluție pentru problema cadvisor-ului este de a elibera imediat cache-urile dentries/inodes din întreaga sistemă, ceea ce elimină instantaneu întârzierile de citire și întârzierile de rețea pe gazdă, deoarece eliminarea cache-ului implică paginile cache ale cgroup-urilor zombie, care sunt, de asemenea, eliberate. Nu este o soluție, dar confirmă cauza problemei.
Se pare că în versiunile mai noi ale nucleului (4.19+) performanța apelurilor a fost îmbunătățită, memory.statastfel încât trecerea la acest nucleu rezolva problema. Între timp, aveam instrumentele necesare pentru a detecta nodurile problematice din clusterele Kubernetes, pentru a le elimina elegant și a le reporni. Am inspectat toate clusterele, am găsit noduri cu întârzieri semnificative și le-am repornit. Acest lucru ne-a oferit timp pentru a actualiza OS-ul pe celelalte servere.
În concluzie
Deoarece acest bug oprea procesarea cozii NIC RX timp de sute de milisecunde, a provocat simultan atât întârzieri mari pe conexiunile scurte, cât și întârzieri la mijlocul conexiunii, de exemplu, între cererile MySQL și pachetele de răspuns.
Înțelegerea și susținerea performanței celor mai fundamentale sisteme, cum ar fi Kubernetes, este esențială pentru fiabilitatea și viteza tuturor serviciilor bazate pe acestea. Toate sistemele implementate beneficiază de îmbunătățirile de performanță ale Kubernetes.
Sursa: habr.com
