

Cu cât sistemul este mai complex, cu atât se îmbogățește cu tot felul de alerte. Și devine necesar să reacționăm la aceste alerte, să le agregăm și să le vizualizăm. Cred că este o situație cunoscută de mulți, până la o ticăială nervoasă.
Soluția despre care vom vorbi nu este cea mai neașteptată, dar căutarea unui articol complet pe această temă nu dă rezultate.
Prin urmare, am decis să împărtășesc experiența FunCorp și să povestesc despre cum este organizat procesul de urgență, cine sună, de ce și cum putem vizualiza totul.
Ce este PagerDuty?
Așadar, pentru a rezolva toate aceste sarcini, am început să căutăm un instrument convenabil. După o căutare scurtă, ne-am decis asupra PagerDuty. PD ni s-a părut o soluție destul de completă și concisă, cu multe integrații și setări. Ce reprezintă ea?
Pe scurt, PagerDuty este o platformă pentru gestionarea incidentelor, care poate procesa incidentele primite prin diverse integrații, poate organiza rotația echipelor de urgență și oferă alerte către inginerul de urgență în funcție de nivelul incidentului (pentru un nivel ridicat — apel, pentru un nivel scăzut — notificare prin aplicație/sms).
Cine este inginerul de urgență?
Probabil că aceasta este prima întrebare cu care trebuie să începem configurarea PD.
La FunCorp, la fel ca în alte companii, există o funcție onorifică de inginer de urgență. Aceasta este predată de la un inginer la altul o dată pe zi. Există așa-numita primă și a doua linie de răspuns la alertele din PagerDuty. Să presupunem că apare o alertă de înaltă prioritate, iar dacă după 10 minute de la apelul către inginerul din prima linie nu există reacție (adică nu a fost schimbată în statusul acceptat sau rezolvat), apelul se duce la al doilea inginer de urgență. Aceasta se configurează în PagerDuty prin Politicile de escaladare.
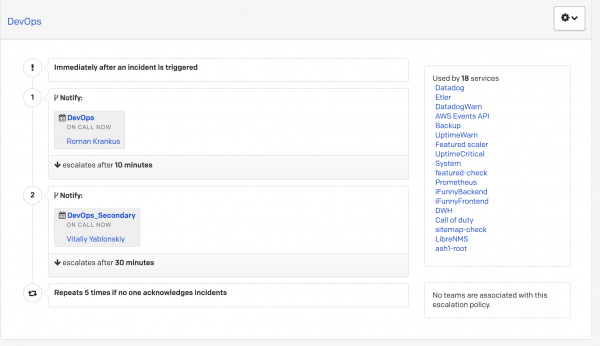
Dacă și al doilea inginer nu răspunde, atunci notificarea revine la inginerul de urgență principal.
Astfel, orice alertă primită de înaltă prioritate nu poate rămâne neprocesată.
Acum să vedem de unde pot veni incidentele.
Ce integrații folosim?
În PD se adună multe incidente diverse de la diferite servicii. Avem în prezent în jur de 25 de astfel de servicii și pentru a le gestiona folosim câteva integrații predefinite.
- Prometheus
Principalul sistem de colectare a metrilor este Prometheus. Despre acesta s-au scris deja multe pe Habr, așa că voi menționa doar că avem mai multe instanțe pentru diferite medii: una colectează metrice de pe mașinile virtuale și containere, alta — din serviciile Amazon, iar a treia — de pe „echipamentele fizice”. În principal, Telegraf este utilizat ca exportator de metrice.
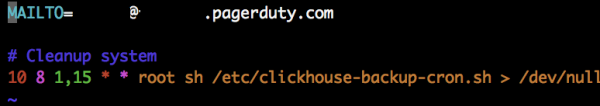
Aici, de asemenea, cred că totul este clar din nume. Această integrare este folosită pentru a trimite notificări de la anumite scripturi care sunt rulate prin cron. PD vă oferă o adresă la care trimiteți emailuri. La crearea unui serviciu cu această integrare, puteți seta prioritățile în care incidentele primite vor fi procesate, precum și cum să fie generate alertele (pentru fiecare email primit, pentru un email primit + o anumită regulă etc.).
- Slack
În opinia mea, este o integrare destul de interesantă. Există situații în care se întâmplă ceva, dar nu sunt acoperite de incidente. De aceea, am adăugat integrarea din Slack pentru crearea de incidente. Adică, în Slack-ul corporativ poți scrie /callofduty все тормозит и скоро сломается și PD va procesa acest lucru și va trimite incidentul inginerului de gardă.
Facem:
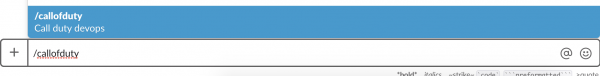
Vedem:
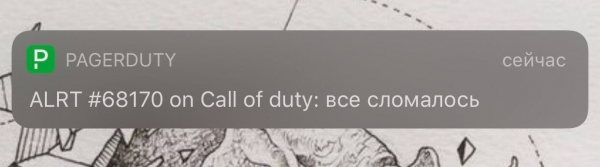
- API
Integrarea prin HTTP. Aici, de fapt, nu este nimic special, doar o cerere POST cu un corp în format JSON. De exemplu, din lucruri interesante: o folosim pentru monitorizarea externă prin . Acest serviciu verifică disponibilitatea site-urilor noastre din diferite colțuri ale lumii. În cazul în care primim un cod de răspuns inacceptabil (de exemplu, 502), se creează un incident, iar apoi totul urmează lanțul descris mai sus. În StatusCake există, de asemenea, posibilitatea de a monitoriza URL-uri interne, expirarea certificatului SSL sau a domeniului.
- LibreNMS
Aceasta este încă un sistem de monitorizare, despre care puteți citi mai multe pe site-ul lor . Cu ajutorul lui, monitorizăm interfețele de rețea și iDRAC de pe servere.
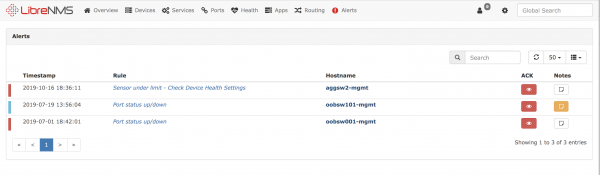
Au mai fost și astfel de integrare, cum ar fi Datadog, CloudWatch. Detalii despre ce s-a întâmplat cu acestea pot fi vizualizate .
Vizualizare
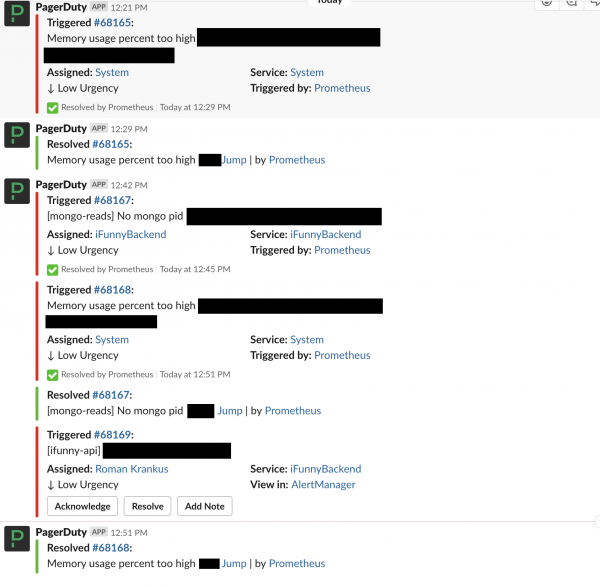
Principalul sistem de informare despre incidente este Slack. Toate incidentele primite în PD sunt scrise într-un chat special, iar dacă statusul lor se schimbă, acest lucru este de asemenea reflectat în chat.
Când a apărut oportunitatea de a afișa date utile pe ecranele monitoarelor suspendate de tavan, ne-am dat seama brusc că noi (în departamentul devops) nu avem ce să afișăm pe ele. Există minunata Grafana, dar aceasta nu poate acoperi totul, iar angajații reacționează la alerte, nu la grafice.
După o căutare amănunțită, dar nereușită pe GitHub pentru un "board" concis și informativ pentru PD, am decis să scriem unul propriu — doar cu ceea ce avem nevoie. Deși inițial ideea a fost de a afișa interfața PD pe ecran, aceasta arăta și mai incomod.
Pentru a-l scrie, este suficient să obții un cheie de la PD cu permisiuni read-only.
Iată ce am realizat:
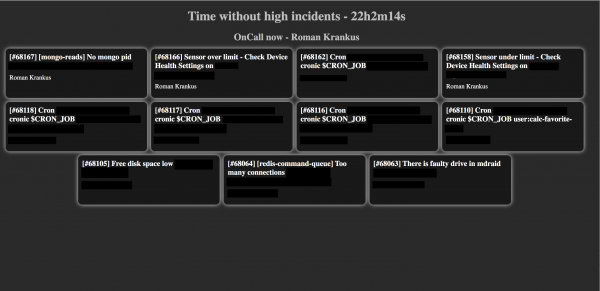
Pe ecran sunt afișate incidentele deschise actuale, numele inginerului de serviciu curent din programul ales și timpul fără un incident de înaltă prioritate (panoul cu incidentul de înaltă prioritate va fi evidențiat cu roșu).
.
În cele din urmă, am obținut un panou de control convenabil pentru vizualizarea tuturor incidentelor noastre. Aș fi bucuros dacă experiența noastră ar fi utilă pentru cineva dintre voi.
Sursa: habr.com
