

Cum să citesc acest articol: îmi cer scuze pentru faptul că textul a ieșit atât de lung și haotic. Pentru a economisi timpul dumneavoastră, încep fiecare capitol cu o introducere „Ce am învățat”, în care în câteva propoziții rezum esența capitolului.
„Arată-mi doar soluția!” Dacă doriți doar să vedeți la ce am ajuns, treceți la capitolul „Devin mai inventiv”, dar consider că este mai interesant și util să citiți despre eșecuri.
Recent am fost însărcinat să configurez procesul de prelucrare a unui volum mare de secvențe ADN inițiale (tehnic, este un SNP-chip). A fost necesar să obținem rapid date despre o anumită locație genetică (care se numește SNP) pentru modelare ulterioară și alte sarcini. Cu ajutorul R și AWK, am reușit să curăț și să organizez datele în mod natural, accelerând semnificativ procesarea cererilor. A fost un proces greu pentru mine și a necesitat numeroase iterații. Acest articol vă va ajuta să evitați unele dintre greșelile mele și va demonstra ce am obținut în cele din urmă.
Pentru început, câteva explicații introductive.
Date
Centrul nostru universitar de prelucrare a informațiilor genetice ne-a furnizat date sub formă de TSV în volum de 25 Tb. Am primit aceste date împărțite în 5 pachete, comprimate Gzip, fiecare conținând aproximativ 240 de fișiere de patru gigaocteți. Fiecare rând conținea date pentru un SNP al unei persoane. În total au fost transmise date pentru ~2,5 milioane de SNP-uri și ~60 de mii de persoane. Pe lângă informațiile SNP în fișiere erau numeroase coloane cu numere, reflectând diferite caracteristici, cum ar fi intensitatea citirii, frecvența diferitelor alele etc. În total erau aproximativ 30 de coloane cu valori unice.
Scop
Așa cum se întâmplă în orice proiect de gestionare a datelor, cel mai important a fost să stabilim cum vor fi utilizate datele. În acest caz vom adapta în principal modele și fluxuri de lucru pentru SNP pe baza SNP-urilor. Adică ne vor fi necesare date doar pentru un singur SNP deodată. Trebuia să învăț cum să extrag în cel mai simplu, rapid și ieftin mod toate înregistrările relevante pentru unul dintre cele 2,5 milioane de SNP-uri.
Cum să nu facem acest lucru
Voi cita un clișeu potrivit:
Nu am eșuat de o mie de ori, am descoperit doar o mie de moduri de a nu prelucra o mulțime de date într-un format convenabil pentru cereri.
Prima încercare
Ce am învățat: nu există o modalitate ieftină de a analiza 25 TB deodată.
După ce am urmat la Universitatea Vanderbilt cursul „Metode avansate pentru procesarea datelor mari”, am fost sigur că totul va merge bine. Probabil că îmi va lua o oră sau două să configurez serverul Hive pentru a rula prin toate datele și a raporta rezultatele. Din moment ce datele noastre sunt stocate în AWS S3, am folosit serviciul , care permite aplicarea interogărilor Hive SQL pe datele din S3. Nu trebuie să configurezi/crezi un cluster Hive și plătești doar pentru datele pe care le cauți.
După ce i-am arătat lui Athena datele și formatul acestora, am rulat câteva teste cu interogări asemănătoare:
select * from intensityData limit 10;Și am obținut rapid rezultate bine structurate. Gata.
Până nu am încercat să folosim datele în muncă...
Mi s-a cerut să extrag toată informația despre SNP pentru a o testa pe model. Am lansat interogarea:
select * from intensityData
where snp = 'rs123456';
...și am început să aștept. După opt minute și peste 4 TB de date solicitate, am obținut rezultatul. Athena percepe o taxă pentru volumul de date găsite, de 5 $ pe terabyte. Așadar, această interogare unică m-a costat 20 $ și opt minute de așteptare. Pentru a rula modelul pe toate datele, ar fi trebuit să aștept 38 de ani și să plătesc 50 milioane $. Evident, nu ne-a convenit.
Trebuie să folosești Parquet...
Ce am învățat: fii atent la dimensiunea fișierelor tale Parquet și la organizarea acestora.
La început, am încercat să remediez situația, convertind toate TSV-urile în . Acestea sunt convenabile pentru lucrul cu seturi mari de date, deoarece informația este stocată în format coloană: fiecare coloană se află într-un segment propriu de memorie/disc, spre deosebire de fișierele text, unde liniile conțin elemente din fiecare coloană. Și dacă trebuie să găsești ceva, este suficient să citești coloana necesară. În plus, în fiecare fișier, fiecare coloană stochează un interval de valori, așa că, dacă valoarea căutată nu se află în intervalul coloanei, Spark nu va pierde timp scanând întregul fișier.
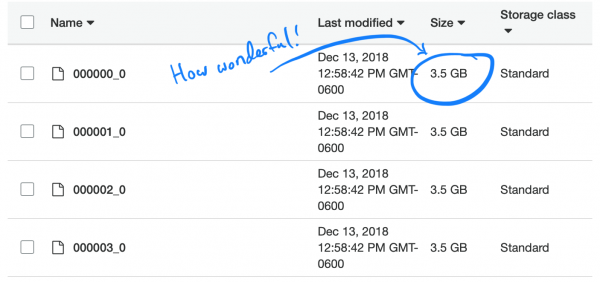
Am lansat o sarcină simplă pentru a transforma TSV-urile noastre în Parquet și am încărcat fișierele noi în Athena. A durat aproximativ 5 ore. Dar când am rulat interogarea, a durat aproape la fel de mult timp și a costat puțin mai puțin. Problema este că Spark, încercând să optimizeze sarcina, a desfăcut un chunk TSV și l-a pus într-un chunk Parquet propriu. Și deoarece fiecare chunk era destul de mare și conținea înregistrări complete ale multor persoane, fiecare fișier conținea toate SNP-urile, așa că Spark a trebuit să deschidă toate fișierele pentru a extrage informațiile necesare.
Interesant este că tipul de compresie utilizat implicit (și recomandat) în Parquet — snappy — nu este divizibil (splitable). Prin urmare, fiecare executor a stat blocat pe sarcina de desfășurare și încărcare a setului de date complet de 3,5 GB.
Să analizăm problema
Ce am învățat: sortarea este dificilă, mai ales dacă datele sunt distribuite.
Mi s-a părut că acum am înțeles miezul problemei. Trebuia doar să sortezi datele după coloana SNP, nu după persoane. Atunci, într-un chunk de date separat, ar exista mai multe SNP-uri, și atunci функцияв Parquet, „deschide doar dacă valoarea se află în interval”, ar ieși în evidență. Din păcate, a sortat miliarde de rânduri, dispersate pe cluster, s-a dovedit a fi o sarcină dificilă.
Eu, la cursul de algoritmi din facultate: „Uf, nimănui nu-i pasă de complexitatea computațională a tuturor acestor algoritmi de sortare”
Eu încercând să sorteze pe o coloană într-un tabel de 20TB: „De ce durează atât de mult?” tabel: „De ce durează atât de mult?” dificultăți.
— Nick Strayer (@NicholasStrayer)
AWS cu siguranță nu vrea să returneze banii pe motiv că „sunt un student distrat”. După ce am rulat sortarea pe Amazon Glue, aceasta a funcționat 2 zile și a eșuat.
Ce zici de partiționare?
Ce am învățat: partițiile în Spark trebuie să fie echilibrate.
Apoi, mi-a venit ideea de a partiționa datele pe cromozomi. Sunt 23 (și încă câteva, dacă luăm în considerare ADN-ul mitocondrial și regiunile necorespunzătoare).
Acest lucru va permite împărțirea datelor în porții mai mici. Dacă adaug în funcția de export Spark în scriptul Glue doar o linie partition_by = "chr", datele ar trebui să fie distribuite în băi (buckets).
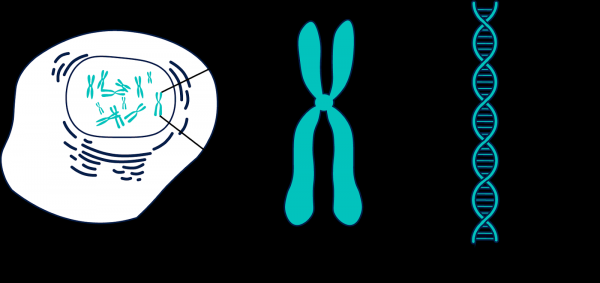
Genomul este compus din numeroase fragmente care se numesc cromozomi.
Din păcate, acest lucru nu a funcționat. Cromozomii au dimensiuni diferite, ceea ce înseamnă și o cantitate diferită de informații. Asta înseamnă că sarcinile pe care Spark le trimitea lucrătorilor nu erau echilibrate și se desfășurau lent, deoarece unele noduri terminau mai repede și stăteau inactiv. Totuși, sarcinile au fost finalizate. Dar la solicitarea unui SNP, dezechilibrul a provocat din nou probleme. Costul procesării SNP-urilor în cromozomii mai mari (adică de unde vrem să obținem datele) a fost redus cu aproximativ 10 ori. Mult, dar nu suficient.
Și dacă împărțim în partiții și mai mici?
Ce am învățat: nu încercați niciodată să faceți 2,5 milioane de partiții.
Am decis să merg până la capăt și am partitionat fiecare SNP. Acest lucru a garantat dimensiuni egale ale partițiilor. A FOST O IDEE PROASTĂ. Am folosit Glue și am adăugat o linie inocentă partition_by = 'snp'. Sarcina s-a lansat și a început să ruleze. O zi mai târziu, am verificat și am văzut că în S3 nu era nimic salvat, așa că am oprit sarcina. Se pare că Glue salva fișiere intermediare într-un loc ascuns în S3, și multe fișiere, poate câteva milioane. Ca urmare, greșeala mea m-a costat peste o mie de dolari și nu a fost pe placul mentorului meu.
Partitionare + sortare
Ce am învățat: este încă greu să sortezi, la fel ca să configurezi Spark.
Ultima mea încercare de partitionare a fost să partitionez cromozomii și apoi să sortez fiecare partiție. În teorie, aceasta ar fi accelerat fiecare interogare, deoarece datele dorite despre SNP ar fi trebuit să se afle în câteva blocuri Parquet în limita unui interval dat. Din păcate, sortarea chiar și a datelor împărțite s-a dovedit a fi o sarcină dificilă. Ca urmare, am trecut la EMR pentru un cluster personalizat și am folosit opt instanțe puternice (C5.4xl) și Sparklyr pentru a crea un flux de lucru mai flexibil…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…totuși, sarcina nu a fost finalizată. Am configurat în multe feluri: am crescut alocarea de memorie pentru fiecare executor de interogări, am folosit noduri cu mai multă memorie, am aplicat variabile de difuzare (broadcasting variable), dar de fiecare dată s-au dovedit a fi soluții temporare, iar treptat executanții au început să eșueze până când totul s-a oprit.
Update: așa că începe.
— Nick Strayer (@NicholasStrayer)
Devin mai inventiv
Ce am învățat: unele date speciale necesită soluții speciale.
Fiecare SNP are o valoare de poziție. Această valoare reprezintă numărul de baze aflate pe cromozomul său. Este o modalitate bună și naturală de a organiza datele noastre. La început, am dorit să efectuez partajarea pe regiuni ale fiecărui cromozom. De exemplu, pozițiile 1 — 2000, 2001 — 4000 și așa mai departe. Problema constă în faptul că SNP-urile nu sunt distribuite uniform pe cromozomi, astfel încât dimensiunea grupurilor va varia semnificativ.
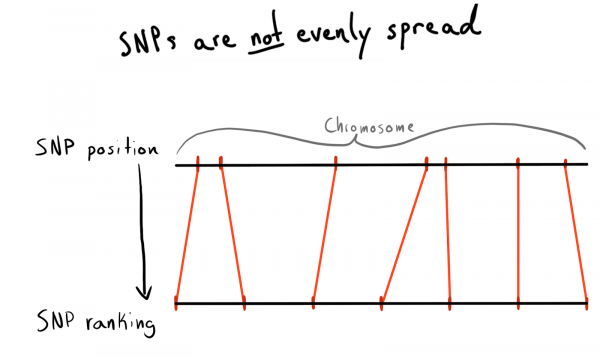
În rezultatul final, am ajuns la o divizare pe categorii (rang) a pozițiilor. Pe datele deja încărcate, am rulant o interogare pentru a obține lista SNP-urilor unice, pozițiile și cromozomii lor. Apoi, am sortat datele în fiecare cromozom și am grupat SNP-urile în grupe (bin) de dimensiuni specifice. Să spunem, câte 1000 SNP-uri. Aceasta mi-a oferit o corelație a SNP-urilor cu grupul din cromozom.
În cele din urmă, am format grupuri (bin) de câte 75 SNP-uri, iar motivul îl voi explica mai jos.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rang = 1:n()
    bin = floor(rang/snps_per_bin)
  ) %>%
  ungroup()
Prima încercare cu Spark
Ce am învățat: unirea în Spark funcționează rapid, dar partajarea este încă costisitoare.
Am vrut să citesc acest mic set de date (2,5 milioane de rânduri) în Spark, să-l unesc cu datele brute și apoi să-l partajez pe baza noii coloane adăugate. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Am folosit sdf_broadcast(), astfel încât Spark să știe că trebuie să trimită setul de date către toate nodurile. Acest lucru este util atunci când datele sunt de dimensiuni mici și sunt necesare pentru toate sarcinile. Altfel, Spark încearcă să fie inteligent și își distribuește datele pe măsură ce este necesar, ceea ce poate duce la încetiniri.
Și din nou, planul meu nu a funcționat: sarcinile au funcționat o vreme, au finalizat unirea, iar apoi, ca executorii lansați prin partajare, au început să eșueze.
Adaug AWK
Ce am învățat: nu dormiți când vă învață bazele. Cu siguranță cineva a rezolvat problema voastră încă din anii 1980.
Până în acest moment, motivul tuturor eșecurilor mele cu Spark a fost amestecarea datelor în cluster. Poate că situația se poate îmbunătăți prin preprocesare. Am decis să încerc să separ datele brute pe coloane de cromozomi, astfel sperând să ofer Spark-ului date „pre-partajate”.
Am căutat pe StackOverflow cum să împart pe baza valorilor coloanelor și am găsit Cu AWK, poți să împarți un fișier text pe baza valorilor coloanelor, efectând scrierea într-un script, în loc să trimiți rezultatele în stdout.
Pentru test, am scris un script Bash. Am descărcat unul dintre TSV-urile arhivate, apoi l-am dezarhivat cu ajutorul gzip și l-am trimis la awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30"<"chunked/"$chr"_chr"$15".csv"}'
A funcționat!
Umplerea nucleelor
Ce am învățat: gnu parallel — este o chestie magică, toată lumea ar trebui să o folosească.
Împărțirea mergea destul de lent, și când am pornit htop, pentru a verifica utilizarea puterii (și costisitorului) EC2 instance, m-am trezit că folosesc doar un nucleu și aproximativ 200 MB de memorie. Pentru a rezolva problema și a nu pierde o grămadă de bani, a trebuit să găsesc o modalitate de a paraleliza munca. Din fericire, în cartea complet uimitoare de Jeron Laningham am găsit un capitol dedicat paralelizării. Din acesta am învățat despre gnu parallel, o metodă foarte flexibilă de implementare a multi-threading în Unix.
Când am pornit împărțirea folosind noul proces, totul a fost grozav, dar a mai rămas un punct de blocaj — descărcarea obiectelor S3 pe disc nu era foarte rapidă și nu era complet paralelizată. Pentru a remedia acest lucru, am făcut următoarele:
- Am descoperit că pot implementa etapa de descărcare S3 direct în pipeline, eliminând complet stocarea intermediară pe disc. Aceasta înseamnă că pot evita scrierea datelor brute pe disc și pot folosi un stocare și mai mică, deci și mai ieftină pe AWS.
- Comanda
aws configure set default.s3.max_concurrent_requests 50a crescut semnificativ numărul de thread-uri folosite de AWS CLI (în mod implicit sunt 10). - Am trecut pe un EC2 instance optimizat pentru viteză de rețea, cu litera n în nume. Am descoperit că pierderea puterii de calcul utilizând instanțele n este mai mult decât compensată de creșterea vitezei de descărcare. Pentru majoritatea sarcinilor am folosit c5n.4xl.
- Am schimbat
gzippe , acest instrument gzip care poate face chestii grozave pentru a paraleliza o sarcină de dezarhivare care nu era inițial paralelizată (acest lucru a ajutat cel mai puțin).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Aceste etape sunt combinate între ele pentru a funcționa foarte rapid. Datorită creșterii vitezei de descărcare și renunțării la scrierea pe disc, acum am putut procesa un pachet de 5 terabyte în doar câteva ore.
Nu există nimic mai dulce decât să vezi toate nucleele pentru care plătești pe AWS fiind utilizate. Datorită gnu-parallel, pot dezarhiva și împărți un CSV de 19 giga la fel de repede cum îl pot descărca. Nici măcar nu am reușit să fac Spark să ruleze acest lucru.
— Nick Strayer (@NicholasStrayer)
Acest tweet ar fi trebuit să menționeze 'TSV'. Din păcate.
Utilizarea datelor reanalizate
Ce am învățat: Spark iubește datele necomprimate și nu îi place să combine particiile.
Acum datele erau stocate în S3 într-un format necompresat (într-o formă separată) și semiordonat, iar eu puteam reveni la Spark. M-a așteptat o surpriză: din nou nu am reușit să obțin rezultatul dorit! A fost foarte greu să-i spun lui Spark cum erau particiile. Și chiar și când am făcut asta, s-a dovedit că erau prea multe particii (95 de mii), iar când am folosit coalesce pentru a reduce numărul la limite rezonabile, a stricat partizionarea mea. Sunt sigur că se poate rezolva, dar după câteva zile de căutări nu am găsit o soluție. În cele din urmă, am finalizat toate sarcinile în Spark, deși a durat ceva timp, iar fișierele mele Parquet împărțite nu erau foarte mici (~200 Kb). Cu toate acestea, datele erau acolo unde trebuie.
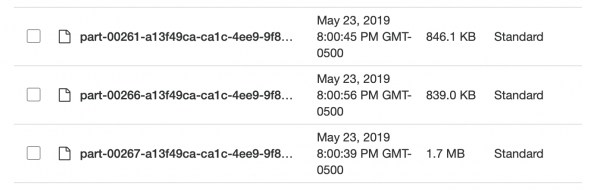
Prea mici și diferite, minunat!
Testarea interogărilor locale în Spark
Ce am învățat: în Spark sunt prea multe costuri în plus pentru a rezolva sarcini simple.
Încărcând datele într-un format bine gândit, am reușit să testez viteza. Am configurat un script R pentru a porni un server Spark local, apoi am încărcat un cadru de date Spark din depozitul Parquet specificat (bin). Am încercat să încarc toate datele, dar nu am reușit să fac Sparklyr să recunoască partionarea.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Începe un cronometru
start_time <- Sys.time()

# Încarcă binul dorit în Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Subset bin la snp și apoi colectează local
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Execuția a durat 29,415 secunde. Mult mai bine, dar nu suficient de bine pentru testarea în masă a ceva. În plus, nu am putut accelera procesul folosind caching, deoarece când am încercat să cachez cadrul de date în memorie, Spark cădea întotdeauna, chiar și când am alocat mai mult de 50 GB de memorie pentru un set de date care cântărea mai puțin de 15.
Întoarcerea la AWK
Ce am învățat: array-urile associative în AWK sunt foarte eficiente.
Îmi dădeam seama că pot obține o viteză mai mare. Mi-am amintit de minunatul Am citit despre o caracteristică interesantă numită „”. Practic, acestea sunt perechi cheie-valoare, care dintr-un motiv oarecare au fost numite diferit în AWK, motiv pentru care nu m-am gândit prea mult la ele. mi-a amintit că termenul „mase asociative” este mult mai vechi decât termenul „pereche cheie-valoare”. Chiar și dacă vă , acest termen nu îl veți găsi acolo, dar veți găsi mase asociative! În plus, „pereche cheie-valoare” este asociat în cea mai mare parte cu bazele de date, astfel că este mult mai logic să comparăm cu hashmap. Am realizat că pot folosi aceste mase asociative pentru a conecta SNP-urile mele cu tabela de grupuri (tabela bin) și datele brute fără a utiliza Spark.
Pentru asta, în scriptul AWK am folosit blocul BEGIN. Este un fragment de cod care se execută înainte ca prima linie de date să fie trimisă în corpul principal al scriptului.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Comanda while(getline...) a încărcat toate liniile din grupul CSV (bin), a setat prima coloană (numele SNP) ca cheie pentru masa asociativă bin și al doilea valor (grupul) ca valoare. Apoi, în blocul { }, care se execută pentru toate liniile din fișierul principal, fiecare linie este trimisă către fișierul de ieșire, care primește un nume unic în funcție de grupul său (bin): ..._bin_"bin[$1]"_....
Variabile batch_num și chunk_id corespundeau datelor furnizate de pipeline, ceea ce a permis evitarea unei stări de competiție, și fiecare fir de execuție, pornit parallel, scria în propriul său fișier unic.
Deoarece toate datele brute le-am organizat în foldere pe cromozomi, rămase după experimentul meu anterior cu AWK, acum puteam scrie un alt script Bash pentru a procesa câte un cromozom pe rând și a trimite în S3 datele partitionate mai adânc.
DESIRED_CHR='13'

# Descarcă datele cromozomului din s3 și împarte în binuri
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'citind {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Combină toate segmentele proceselor paralele în fișiere unice și încarcă în rds folosind R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'comprimând bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
În script sunt două secțiuni parallel.
În prima secțiune, datele sunt citite din toate fișierele care conțin informații despre cromozomul necesar, apoi aceste date sunt distribuite pe fire, care împart fișierele în grupuri corespunzătoare (bin). Pentru a evita o stare de competiție în care mai multe fire scriu într-un singur fișier, AWK le transmite numele fișierelor pentru a scrie datele în locuri diferite, de exemplu, chr_10_bin_52_batch_2_aa.csv. Ca rezultat, pe disc se creează numeroase fișiere mici (pentru aceasta am folosit volume EBS de un terabyte).
Conducta din a doua secțiune parallel parcurge grupurile (bin) și combină fișierele lor separate într-un CSV comun cu cat, după care le trimite la export.
Translare în R?
Ce am învățat: se poate accesa stdin și stdout din scriptul R, ceea ce înseamnă că poate fi utilizat în conductă.
În scriptul Bash, ați putut observa următoarea linie: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Aceasta traduce toate fișierele concatenate ale grupului (bin) în scriptul R de mai jos. {} este o metodă specială parallel, care inseră direct în comanda în sine orice date trimise în fluxul specificat. Opțiunea {#} oferă un ID unic al firului de execuție, iar {%} reprezintă numărul slotului de sarcină (se repetă, dar niciodată simultan). Lista tuturor opțiunilor poate fi găsită în
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Când variabila file("stdin") este transmisă în readr::read_csv, datele traduse în scriptul R sunt încărcate într-un cadru, care apoi sub formă de .rds-fișier este scris direct în S3 cu ajutorul aws.s3 în S3.
RDS este ca o versiune mai simplă a Parquet, fără rafinamentele unui depozit de coloane.
După finalizarea scriptului Bash, am obținut un pachet de .rds-fișiere aflate în S3, ceea ce mi-a permis să folosesc compresie eficientă și tipuri încorporate.
În ciuda utilizării R-ului lent, totul a funcționat foarte rapid. Nu este de mirare că fragmentele R responsabile de citirea și scrierea datelor sunt bine optimizate. După testarea pe un cromozom de dimensiune medie, sarcina s-a finalizat pe o instanță C5n.4xl în aproximativ două ore.
Limitările S3
Ce am învățat: datorită implementării inteligente a căilor, S3 poate gestiona multe fișiere.
M-am îngrijorat dacă S3 va putea gestiona numeroase fișiere trimise către ea. Aș fi putut face numele fișierelor semnificative, dar cum va căuta S3 după ele?
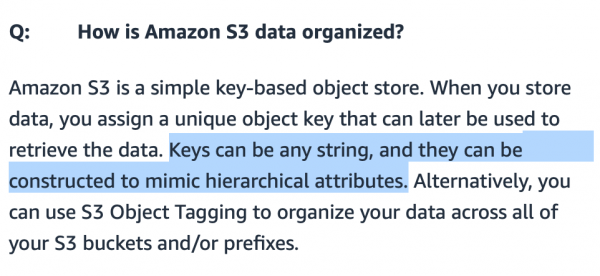
Folderele din S3 sunt doar pentru aspect, de fapt, sistemul nu îi pasă de simbol /.
Se pare că S3 reprezintă calea către un anumit fișier sub formă de cheie simplă într-un fel de tabel de hash sau bază de date bazată pe documente. Bucket-ul poate fi considerat un tabel, iar fișierele — înregistrări în acel tabel.
Deoarece viteza și eficiența sunt importante pentru a obține profit în Amazon, nu e surprinzător că acest sistem „cheie-ca-drum-către-fișier” este optimizat extraordinar. Am încercat să găsesc un echilibru: astfel încât să nu fie nevoie să fac multe cereri get, dar cererile să fie rapide. S-a dovedit că este cel mai bine să fac aproximativ 20.000 de fișiere binare. Cred că, dacă continui să optimizez, aș putea obține o creștere a vitezei (de exemplu, făcând un bucket special doar pentru date, reducând astfel dimensiunea tabelului de căutare). Dar pentru experimente suplimentare nu mai era timp și nici bani.
Ce zici de compatibilitatea încrucișată?
Ce am învățat: principala cauză a pierderii timpului este optimizarea prematură a metodei tale de stocare.
În acest moment, este foarte important să te întrebi: „De ce să folosești un format de fișier proprietar?” Motivul constă în viteza de încărcare (fișierele CSV comprimate gzip se încărcau de 7 ori mai lent) și compatibilitatea cu fluxurile noastre de lucru. Pot să îmi revizuiesc decizia dacă R poate încărca ușor fișiere Parquet (sau Arrow) fără a introduce povara Spark. În laboratorul nostru, toată lumea folosește R, iar dacă va trebui să transform datele într-un alt format, voi avea în continuare datele originale text, așa că pot să rulez din nou pipeline-ul.
Împărțirea sarcinilor
Ce am învățat: nu încerca să optimizezi sarcinile manual, lasă asta computerului.
Am debugat fluxul de lucru pe un singur cromozom, acum trebuie să procesez toate celelalte date.
Am vrut să ridic câteva instanțe EC2 pentru transformare, dar în același timp eram îngrijorat că voi obține o sarcină extrem de dezechilibrată în diferitele sarcini de procesare (la fel cum Spark a suferit din cauza partițiilor dezechilibrate). De asemenea, nu îmi plăcea să ridic câte o instanță pentru fiecare cromozom, deoarece există o limită implicită de 10 instanțe pentru conturile AWS.
Atunci am decis să scriu un script în R pentru a optimiza sarcinile de procesare.
Mai întâi am cerut S3 să calculeze cât de mult spațiu în stocare ocupă fiecare cromozom.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Extrage cromozomul din numele fișierului
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Împarte pentru a obține valoarea în GB


# Un tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … cu încă 17 rânduri
Apoi am scris o funcție care ia dimensiunea totală, amestecă ordinea cromozomilor, îi împarte în grupuri num_jobs și raportează cât de mult diferă dimensiunile tuturor sarcinilor de procesare.
num_jobs <- 7
# Cât ar fi fiecare sarcină dacă ar fi împărțită perfect?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Un tibble: 1 x 2
     sd data

1  153.
Apoi am rulat o mie de amestecări folosind purrr și am selectat cea mai bună.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Astfel am obținut un set de sarcini foarte asemănătoare ca dimensiune. Apoi a mai rămas doar să învârt scriptul meu Bash anterior într-un mare ciclu for. Aducerea acestei optimizări mi-a luat aproximativ 10 minute. Și este mult mai puțin decât aș fi cheltuit pentru a crea sarcinile manual în cazul unui dezechilibru. De aceea consider că nu am greșit cu această optimizare prealabilă.
pentru DESIRED_CHR în "16" "9" "7" "21" "MT"
do
# Cod pentru procesarea unui singur cromozom
fi
La final adaug comanda de oprire:
sudo shutdown -h now … și a ieșit! Folosind AWS CLI am pornit instanțe și prin opțiunea user_data le-am transmis scripturile Bash pentru sarcinile lor de procesare. Acestea s-au executat și s-au oprit automat, așa că nu am plătit pentru putere de calcul excesivă.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Să împachetăm!
Ce am învățat: API-ul ar trebui să fie simplu pentru a facilita utilizarea și flexibilitatea.
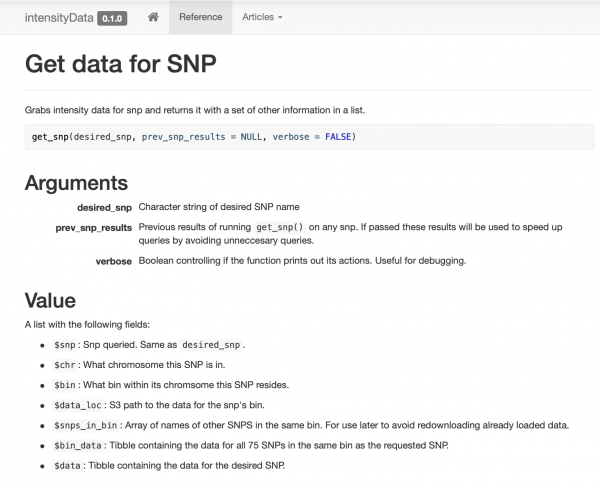
În sfârșit, am obținut datele în locul și forma dorită. Rămânea să simplific cât mai mult procesul de utilizare a datelor, astfel încât colegii mei să aibă ușurință. Am vrut să fac un API simplu pentru a crea solicitări. Dacă în viitor decid să trec la .rds Referitor la fișierele Parquet, aceasta ar trebui să fie o problemă pentru mine, nu pentru colegi. Pentru aceasta, am decis să creez un pachet intern R.
Am compilat și documentat un pachet foarte simplu, care conține doar câteva funcții pentru accesarea datelor, în jurul funcției get_snp. De asemenea, am creat pentru colegi un site , astfel încât să poată vizualiza ușor exemplele și documentația.
Caching inteligent
Ce am învățat: dacă datele tale sunt bine pregătite, va fi ușor să le cachezi!
Deoarece unul dintre fluxurile de lucru aplica aceleași modele de analiză pe pachetul SNP, am decis să folosesc gruparea (binning) în favoarea mea. Când datele sunt transmise prin SNP, toată informația din grup (bin) este atașată la obiectul returnat. Asta înseamnă că cererile mai vechi pot (în teorie) accelera procesarea cererilor noi.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Când am compilat pachetul, am efectuat multe benchmark-uri pentru a compara viteza folosind diferite metode. Recomand să nu neglijezi acest lucru, pentru că uneori rezultatele sunt neașteptate. De exemplu, dplyr::filter s-a dovedit mult mai rapid pentru capturarea rândurilor prin filtrare bazată pe indexare, iar obținerea unei coloane din cadrul de date filtrat a funcționat mult mai repede decât utilizarea sintaxei de indexare.
Rețineți că obiectul prev_snp_results conține cheia snps_in_bin. Aceasta este un array al tuturor SNP-urilor unice din grup (bin), care permite verificarea rapidă dacă datele din cererea anterioară există deja. De asemenea, facilitează parcurgerea ciclică a tuturor SNP-urilor din grup (bin) cu ajutorul acestui cod:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Rezultate
Acum putem (și am început să facem serios) să rulăm modele și scenarii care ne erau anterior inaccesibile. Cel mai bine este că colegii mei din laborator nu trebuie să se gândească la toate aceste complexități. Ei au pur și simplu o funcție care funcționează.
Și deși pachetul îi scutește de detalii, am încercat să fac formatul datelor suficient de simplu încât să poată înțelege, în cazul în care mâine dispar…
Viteza a crescut semnificativ. De obicei, scanăm fragmente funcțional semnificative ale genomului. În trecut nu puteam face acest lucru (era prea costisitor), dar acum, datorită structurii de grup (bin) și caching-ului, pentru o cerere SNP durează în medie mai puțin de 0,1 secunde, iar utilizarea datelor este atât de scăzută încât costurile pentru acestea sunt derizorii.
Recent, am fost pus responsabil cu gestionarea a peste 25 TB de date brute de genotipare pentru laboratorul meu. Când am început, utilizarea Spark dura 8 minute și costa 20 de dolari pentru a interoga un SNP. După ce am folosit AWK + pentru procesare, acum durează mai puțin de o zecime de secundă și costă 0,00001 dolari. Câștigul meu personal este.
— Nick Strayer (@NicholasStrayer)
Concluzie
Acest articol nu este un ghid. Soluția a fost personalizată și, aproape cu siguranță, nu este optimă. Mai degrabă, este o poveste despre aventură. Vreau ca alții să înțeleagă că asemenea soluții nu apar complet formate în minte, ci sunt rezultatul încercărilor și erorilor. În plus, dacă căutați un specialist în analiză de date, rețineți că pentru a utiliza eficient aceste instrumente este nevoie de experiență, iar experiența costă bani. Mă bucur că am avut fonduri să plătesc, dar mulți alții, care ar putea face aceeași muncă mai bine decât mine, nu vor avea niciodată această ocazie din cauza lipsei de bani, chiar și pentru o tentativă.
Instrumentele pentru big data sunt universale. Dacă aveți timp, aproape sigur că puteți scrie o soluție mai rapidă, aplicând curățarea „inteligentă” a datelor, stocarea și metodele de extragere. În final, totul se reduce la analiza costurilor și beneficiilor.
Ce am învățat:
- nu există o modalitate ieftină de a procesa 25 TB deodată;
- fiți atenți la dimensiunea fișierelor Parquet și organizarea acestora;
- partițiile în Spark trebuie să fie echilibrate;
- niciodată să nu încercați să faceți 2,5 milioane de partiții;
- sortarea este în continuare dificilă, la fel de mult ca și configurarea Spark;
- uneori, date speciale necesită soluții specializate;
- îmbinarea în Spark funcționează rapid, dar partiționarea este în continuare costisitoare;
- nu adormi când ți se predau bazele, cu siguranță cineva a rezolvat problema ta încă din anii 1980;
gnu parallel— este un lucru magic, toată lumea ar trebui să o folosească;- Spark preferă datele necomprimate și nu le place să combine partițiile;
- există prea multe suprasarcini în Spark pentru a rezolva sarcini simple;
- array-urile asociative în AWK sunt foarte eficiente;
- pot fi accesate
stdinșistdoutdintr-un script R, ceea ce înseamnă și utilizarea sa în proces. - datorită implementării inteligente a căilor S3, poate gestiona multe fișiere;
- principala cauză a pierderii timpului este optimizarea prematură a metodei tale de stocare;
- nu încerca să optimizezi sarcinile manual, lasă să o facă computerul;
- API-ul ar trebui să fie simplu pentru simplicitatea și flexibilitatea utilizării;
- dacă datele tale sunt bine pregătite, va fi ușor să le cachezi!
Sursa: habr.com
