

Salut, Habr!
Îți reamintim că a apărut un nou articol extrem de interesant și util despre modelele Kubernetes. Totul a început cu "" lui Brendan Burns, iar, de altfel, activitatea noastră în acest domeniu . Astăzi, îți propunem să citești un articol din blogul MinIO, care rezumă tendințele și specificul modelelor de stocare a datelor în Kubernetes.
Kubernetes a schimbat fundamental modelele tradiționale de dezvoltare și implementare a aplicațiilor. Acum, echipele pot dezvolta, testa și implementa o aplicație în câteva zile — în medii diferite, toate acestea în cadrul clusterelor Kubernetes. O astfel de muncă cu tehnologiile din generațiile anterioare ocupa de obicei săptămâni întregi, dacă nu luni.
Această accelerare a devenit posibilă datorită abstracției oferite de Kubernetes — adică, datorită faptului că Kubernetes se ocupă de interacțiunile cu detaliile de nivel inferior ale mașinilor fizice sau virtuale, permițând utilizatorilor să declare, printre altele, procesorul necesar, volumul de memorie dorit și numărul de instanțe ale containerelor. Având în vedere că un imens comunitate se ocupă de suportul Kubernetes, iar domeniul de aplicare al Kubernetes continuă să se extindă, acesta conduce cu un avans considerabil între toate platformele de orchestrare a containerelor.
Pe măsură ce utilizarea Kubernetes se extinde, confuzia cu privire la modelele de stocare a datelor utilizate în acesta crește.
Într-o competiție generală pentru o parte din acest "tort" Kubernetes (adică, pentru stocarea datelor), atunci când vine vorba de stocarea datelor, mesajul devine cufundat într-un zgomot puternic.
Kubernetes întruchipează modelul modern de dezvoltare și implementare a aplicațiilor, precum și gestionarea acestora. Acest model modern separă stocarea datelor de procesare. Pentru a înțelege pe deplin această separare în contextul Kubernetes, este necesar să înțelegem ce sunt aplicațiile cu salvare a stării și cele fără salvare a stării, precum și cum se îmbină aceste concepte cu stocarea datelor. Aici, abordarea REST API utilizată de S3 are avantaje evidente în comparație cu abordarea POSIX/CSI caracteristică altor soluții.
În acest articol vom discuta despre modele de stocare a datelor în Kubernetes și vom aborda în mod special dezbaterea despre aplicațiile care funcționează cu și fără stocare persistentă, pentru a înțelege în profunzime care este diferența dintre ele și de ce este importantă. În textul de mai jos, vor fi explorează aplicațiile și modelele de stocare a datelor utilizate în lumina celor mai bune practici pentru lucrul cu containere și Kubernetes.
Containere fără stocare persistentă
Containerele sunt, prin natura lor, ușoare și efemere. Acestea pot fi oprite, șterse sau desfășurate pe un alt nod în câteva secunde. Într-un sistem mare de orchestrare a containerelor, astfel de operațiuni se desfășoară constant, iar utilizatorii aproape că nu observă aceste schimbări. Totuși, mutările sunt posibile doar dacă containerul nu are nicio dependență de nodul pe care se află. Despre aceste containere se spune că funcționează fără stocare persistentă.
Containere cu stocare persistentă
Dacă un container stochează date pe dispozitive local conectate (sau pe un dispozitiv bloc), atunci stocarea datelor pe care se află va trebui mutată pe un nou nod împreună cu containerul – în caz de eșec. Acest lucru este important, deoarece, în caz contrar, aplicația rulată în container nu va putea funcționa corect, deoarece trebuie să acceseze datele stocate pe suporturi locale. Despre aceste containere se spune că funcționează cu stocare persistentă.
Dintr-o perspectivă pur tehnică, containerele cu stocare persistentă pot fi, de asemenea, mutate pe alte noduri. Acest lucru este de obicei realizat prin intermediul sistemelor de fișiere distribuite sau a stocărilor de date de rețea atașate la toate nodurile pe care funcționează containerele. Astfel, containerele au acces la volume pentru stocarea persistentă a datelor, iar informațiile sunt stocate pe discuri dispersate în rețea. Această metodă o voi numi „abordarea containerelor cu stocare persistentă”, iar în restul articolului voi continua să îi spun așa pentru a menține uniformitatea.
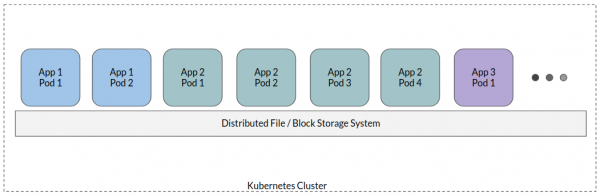
În abordarea tipică a containerelor cu păstrarea stării, toate modulele aplicațiilor se atașează la un sistem de fișiere distribuit - astfel se obține un fel de stocare comună, în care se află toate datele aplicațiilor. Chiar dacă pot exista unele variații, aceasta este o abordare la nivel înalt.
Acum să analizăm de ce abordarea containerelor cu păstrarea stării în lumea orientată spre cloud este un antipattern.
Proiectarea aplicațiilor orientate spre cloud
În mod tradițional, aplicațiile foloseau baze de date pentru stocarea structurată a informațiilor și discuri locale sau sisteme de fișiere distribuite, unde erau stocate toate datele nestructurate sau chiar semi-structurate. Pe măsură ce volumul datelor nestructurate creștea, dezvoltatorii și-au dat seama că POSIX este prea "vorbăreț", asociat cu costuri semnificative și, în cele din urmă, împiedică funcționarea aplicației atunci când se trece la scale cu adevărat mari.
Acest lucru a contribuit semnificativ la apariția unui nou standard de stocare a datelor, adică stocările orientate spre cloud, care funcționează predominant pe baza REST API și înlătură aplicația de greutatea întreținerii stocării locale de date. În acest caz, aplicația intră, de fapt, în modul fără păstrarea stării (deoarece starea se află în stocarea distantă). Aplicațiile moderne sunt construite de la zero având în vedere acest factor. De obicei, orice aplicație modernă care procesează date de orice fel (jurnale, metadate, BLOB-uri etc.) este construită pe o paradigmă orientată spre cloud, în care starea este mutată într-un sistem software dedicat pentru stocarea acesteia.
Abordarea containerelor cu păstrarea stării forțează întreaga această paradigmă să revină exact la început!
Când folosești interfețele POSIX pentru stocarea datelor, aplicațiile funcționează similar cu modul în care ar salva starea, ceea ce le face să se îndepărteze de cele mai importante principii ale designului bazat pe cloud, adică de capacitatea de a varia dimensiunile fluxurilor de lucru ale aplicației în funcție de încărcătura de intrare, de a se muta pe un nou nod imediat ce nodul actual eșuează etc.
Dacă ne uităm mai atent la această situație, observăm că atunci când alegem un stocare a datelor ne confruntăm din nou și din nou cu dilema „POSIX versus REST API”, DAR cu o agravare suplimentară a problemelor POSIX, cauzată de natura distribuită a mediilor Kubernetes. În special,
- POSIX este vorbăreț: semantica POSIX cere asocierea fiecărei operații cu metadate și descriitori de fișiere, care ajută la menținerea stării operației. Aceasta duce la costuri semnificative, fără o valoare reală. API-urile pentru stocarea obiectelor, în special S3 API, s-au dezbărat de aceste cerințe, permițând aplicației să execute acțiunea și apoi să „uită” de apel. Răspunsul sistemului de stocare a datelor indică dacă acțiunea a fost executată cu succes sau nu. În caz de eșec, aplicația poate efectua o repetare.
- Limitările rețelei: Într-un sistem distribuit se presupune că ar putea exista multiple aplicații care încearcă să scrie date pe același mediu de stocare atașat. Așadar, nu doar că aplicațiile vor concura între ele pentru lățimea de bandă (pentru a trimite datele pe mediu), dar însăși sistemul de stocare va concura pentru această lățime, distribuind datele pe discurile fizice. Din cauza vorbărețului POSIX, numărul apelurilor de rețea crește de mai multe ori. Pe de altă parte, S3 API oferă o delimitare clară a apelurilor de rețea între cele care vin de la client la server și cele care au loc în interiorul serverului.
- Securitate: Modelul de securitate POSIX este conceput pentru a implica activ oamenii: administratorii configurează nivelurile de acces specifice pentru fiecare utilizator sau grup. Această paradigmă este greu de adaptat la o lume orientată spre cloud. Aplicațiile moderne depind de modele de securitate legate de API, unde drepturile de acces sunt stabilite sub formă de seturi de politici, conturi de serviciu, acreditive temporare etc.
- Gestionabilitate: Containerele cu stocare persistentă generează anumite costuri legate de gestionare. Este vorba despre sincronizarea accesului paralel la date, despre asigurarea coerenței datelor; toate acestea necesită o analiză atentă a tiparelor de acces la date care ar trebui utilizate. Este necesar să se instaleze, să se controleze și să se configureze programe suplimentare, nemaivorbind de eforturile suplimentare necesare dezvoltării.
Interfața de stocare a containerelor de date
Deși interfața de stocare a containerelor (CSI) a ajutat considerabil la extinderea nivelului volumelor Kubernetes, transferând parțial aceste funcții către furnizori terți de stocare, a contribuit totodată la convingerea greșită că abordarea containerelor cu stocare persistentă este metoda recomandată pentru stocarea datelor în Kubernetes.
CSI a fost dezvoltat ca un standard pentru furnizarea unor sisteme arbitrare de stocare bloc și fișier pentru aplicațiile moștenite atunci când se utilizează Kubernetes. Așa cum a fost demonstrat în acest articol, singura situație în care abordarea containerelor cu stocare persistentă (și CSI în forma sa actuală) este fezabilă este atunci când aplicația însăși este un sistem moștenit, în care nu se poate adăuga suport pentru API-ul de stocare a obiectelor.
Este important să înțelegem că, folosind CSI în forma sa actuală, adică montând volumele în timpul utilizării aplicațiilor moderne, ne vom confrunta aproximativ cu aceleași probleme care au existat și în sistemele în care stocarea datelor era organizată în stil POSIX.
O abordare de calitate superioară
În acest caz, este important să înțelegem că majoritatea aplicațiilor nu sunt, prin natura lor, concepute să funcționeze cu păstrarea stării sau fără păstrarea stării. Acest comportament depinde de arhitectura generală a sistemului și de opțiunile specifice alese în timpul proiectării. Să discutăm puțin despre aplicațiile care păstrează starea.
În principiu, toate datele aplicațiilor pot fi clasificate în câteva tipuri mari:
- Datele jurnalelor
- Datele etichetelor de timp
- Datele tranzacțiilor
- Metadatele
- Imaginile containerelor
- Datele blob (obiecte binare mari)
Toate aceste tipuri de date sunt foarte bine suportate pe platformele moderne de stocare a datelor, iar există mai multe platforme orientate către cloud, adaptate pentru livrarea datelor în fiecare dintre aceste formate specifice. De exemplu, datele tranzacțiilor și metadatele pot fi stocate într-o bază de date orientată pe cloud modernă, cum ar fi CockroachDB, YugaByte etc. Imaginile containerelor sau datele blob pot fi stocate în registrul Docker bazat pe MinIO. Datele etichetelor de timp pot fi stocate într-o bază de date pentru serii temporale, cum ar fi InfluxDB etc. Să nu ne adâncim în detaliile fiecărui tip de date și aplicații corespunzătoare, dar ideea generală este de a evita stocarea persistentă a datelor bazate pe montarea locală a discurilor.
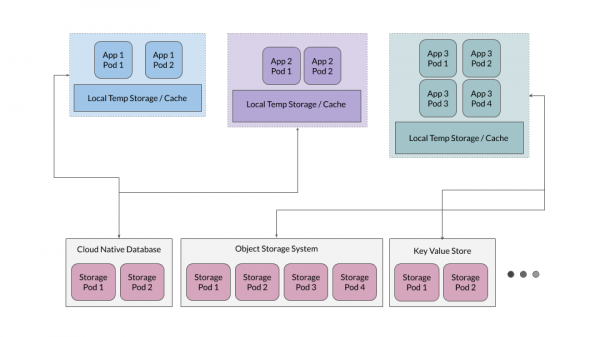
În plus, adesea se dovedește eficient să se ofere un nivel de caching temporar, care să servească aplicațiilor ca un fel de stocare a fișierelor temporare, dar aplicațiile nu ar trebui să depindă de acest nivel ca sursă de adevăr.
Stocarea pentru aplicațiile cu păstrarea stării
Deși în majoritatea cazurilor este util să menținem aplicațiile fără păstrarea stării, acele aplicații care sunt concepute pentru a stoca date – de exemplu, bazele de date, stocările de obiecte, stocările de chei și valori – trebuie să păstreze starea. Să analizăm de ce aceste aplicații sunt desfășurate pe Kubernetes. Ca exemplu, să luăm MinIO, dar principii similare se aplică și altor sisteme mari de stocare a datelor orientate către cloud.
Aplicațiile orientate pe cloud sunt concepute pentru a maximiza eficiența utilizării flexibilității caracteristice containerelor. Aceasta înseamnă că nu se fac presupuneri cu privire la mediul în care vor fi desfășurate. De exemplu, MinIO utilizează un mecanism intern de codificare redundantă (erasure coding), care oferă sistemului o suficientă reziliență pentru a rămâne funcțional chiar și în cazul defectării a jumătate din discuri. De asemenea, MinIO gestionează integritatea și securitatea datelor prin utilizarea propriului hashing și criptare la nivel de server.
Pentru astfel de aplicații orientate pe cloud, cele mai convenabile soluții de stocare de rezervă sunt volumele persistente locale (PV). Un PV local oferă posibilitatea de a stoca datele neprelucrate, în timp ce aplicațiile care rulează deasupra acestor PV colectează informații care permit scalarea datelor și gestionarea cerințelor de date în creștere.
Această abordare este mult mai simplă și scalațională comparativ cu PV bazate pe CSI, care introduc propriile niveluri de gestionare a datelor și redundanță în sistem; problema este că aceste niveluri intră de obicei în conflict cu aplicațiile proiectate cu conceptul de păstrare a stării.
O mișcare sigură către decuplarea datelor de calcul
În acest articol am discutat despre modul în care aplicațiile se reorientează pentru a funcționa fără păstrarea stării, adică stocarea datelor este separată de calculele efectuate asupra acestora. În concluzie, vom examina câteva exemple reale ale acestei tendințe.
, celebra platformă de analiză a datelor, a fost tradițional utilizată cu păstrarea stării și desfășurată în sistemul de fișiere HDFS. Totuși, pe măsură ce Spark se mută într-o lume orientată pe cloud, această platformă este tot mai des utilizată fără păstrarea stării, folosind `s3a`. Spark utilizează s3a pentru a transmite starea către alte sisteme, în timp ce containerele Spark funcționează complet fără păstrarea stării. Alți mari jucători din domeniul analizei datelor mari, în special, , , de asemenea, se îndreaptă spre a funcționa cu separarea stocării datelor de calculele efectuate asupra acestora.
Modele similare se regăsesc și pe alte platforme analitice majore, precum Presto, Tensorflow to R, Jupyter. Exportând starea în sisteme de stocare în cloud de la distanță, devine mult mai simplu să gestionați aplicația dvs. și să o scalați. În plus, aceasta contribuie la portabilitatea aplicației în diverse medii.
Sursa: habr.com
