

În acest articol, voi vorbi despre cum proiectul la care lucrez s-a transformat dintr-un monolit mare într-un set de microservicii.
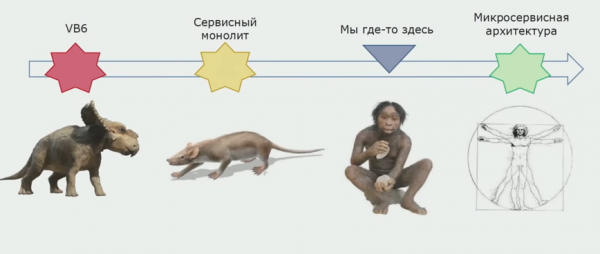
Proiectul și-a început povestea acum ceva timp, la începutul anilor 2000. Primele versiuni au fost scrise în Visual Basic 6. Pe măsură ce timpul a trecut, a devenit clar că dezvoltarea în acest limbaj va fi dificil de întreținut pe termen lung, deoarece IDE-ul și limbajul în sine evoluau încet. La sfârșitul anilor 2000, s-a decis trecerea la un C# mai promițător. Noua versiune a fost scrisă paralel cu îmbunătățirea versiunii vechi, iar treptat, din ce în ce mai mult cod a fost scris în .NET. Backend-ul în C# s-a orientat inițial spre o arhitectură de servicii, cu toate că în timpul dezvoltării s-au folosit biblioteci comune cu logică, iar serviciile erau lansate într-un singur proces. A rezultat o aplicație pe care noi o numeam „monolitul de servicii”.
Unul dintre puținele avantaje ale unei astfel de combinații era posibilitatea serviciilor de a se apela reciproc prin intermediul unei API externe. Existau premise clare pentru tranziția către o arhitectură mai corectă de servicii și, în perspectivă, chiar spre o arhitectură de microservicii.
Am început lucrul la decompunere în jurul anului 2015. Deocamdată nu am atins o stare ideală - au rămas părți ale marelui proiect, care se numesc greu monolite, dar nici microservicii nu se aseamănă. Cu toate acestea, progresul este semnificativ.
Despre asta voi vorbi în articol.
Cuprins
Arhitectura și problemele soluției existente
Inițial, arhitectura arăta în felul următor: UI - aplicație separată, partea monolitică a fost scrisă în Visual Basic 6, aplicația în .NET era un set de servicii interconectate, lucrând cu o bază de date destul de mare.
Dezavantajele soluției anterioare
Punct unic de eșec
Am avut un punct unic de eșec: aplicația .NET rula într-un singur proces. Dacă apărea o problemă în oricare dintre module, întreaga aplicație se bloca și trebuia repornită. Având în vedere că automatizăm un număr mare de procese pentru diferiți utilizatori, o eroare în unul dintre acestea făcea ca toți să nu poată lucra pentru o perioadă. Iar în cazul unei erori de programare, nu ajuta nici rezervarea.
Lista de modificări
Această problemă este în principal organizațională. Aplicația noastră are mulți clienți, iar toți doresc să-și aducă modificările cât mai repede. În trecut, era imposibil să facem acest lucru în paralel, iar toți clienții trebuie să aștepte la rând. Acest proces provoca frustrare în rândul afacerii, deoarece trebuiau să demonstreze că sarcina lor are valoare. Iar echipa de dezvoltare își petrecea timpul organizând această listă de așteptare. Asta lua mult timp și efort, iar produsul nu putea să se schimbe la fel de repede cum și-ar fi dorit.
Utilizarea ineficientă a resurselor
Când implementam servicii într-un proces unic, întotdeauna copiam complet configurația de la server la server. Ne-am dorit să plasăm serviciile cele mai solicitate separat, pentru a nu risipi resursele și a obține o gestionare mai flexibilă a schemei noastre de desfășurare.
Dificultăți în implementarea tehnologiilor moderne
O problemă cunoscută de toți dezvoltatorii: există dorința de a introduce tehnologii moderne în proiect, dar nu există posibilitatea. Într-o soluție monolitică mare, orice actualizare a bibliotecii curente, cu atât mai puțin trecerea la una nouă, devine o sarcină destul de complicată. Trebuie să dovedim îndelung echipei că aceasta va aduce mai multe beneficii decât nervii pierduți.
Complexitatea livrării modificărilor
Aceasta a fost cea mai gravă problemă - eliberam versiuni la fiecare două luni.
Fiecare versiune devenea o adevărată catastrofă pentru bancă, în ciuda testării și eforturilor dezvoltatorilor. Afacerea înțelegea că o parte din funcționalitate nu va funcționa la începutul săptămânii. Iar dezvoltatorii știau că îi așteaptă o săptămână de incidente serioase.
Dorința de a schimba situația exista la toată lumea.
Așteptările de la microservicii
Livrarea componentelor pe măsură ce sunt gata. Livrarea componentelor pe măsură ce devin disponibile, datorită decompoziției soluției și separării diferitelor procese.
Echipe mici de produse. Acest lucru este important deoarece este dificil de gestionat o echipă mare care lucrează la un vechi monolit. O astfel de echipă a fost nevoită să lucreze conform unui proces strict, iar dorința era de mai multă creativitate și independență. Numai echipele mici își puteau permite acest lucru.
Izolarea serviciilor în procese separate. Ideal ar fi fost să se izoleze în containere, dar un număr mare de servicii scrise pe .NET Framework rulează doar pe Windows. Acum apar servicii pe .NET Core, dar sunt încă puține.
Flexibilitatea desfășurării. Ar fi fost util să combinăm serviciile așa cum avem nevoie, nu așa cum impune codul.
Utilizarea unor tehnologii noi. Acest lucru este interesant pentru orice programator.
Problemele tranziției
Desigur, dacă ar fi fost simplu să împărțim monolitul în microservicii, nu ar fi fost nevoie să discutăm despre asta la conferințe și să scriem articole. Există multe capcane în acest proces, voi descrie principalele care ne-au împiedicat.
Prima problemă tipic pentru majoritatea monolitilor: legătura logicii de afaceri. Atunci când scriem un monolit, dorim să reutilizăm clasele noastre pentru a nu scrie cod suplimentar. Dar în momentul trecerii la microservicii, aceasta devine o problemă: tot codul este destul de rigid legat, iar separarea serviciilor este dificilă.
La începutul lucrărilor, în depozit erau peste 500 de proiecte și peste 700.000 de linii de cod. Aceasta este o soluție destul de mare și a doua problemă. Pur și simplu a lua și a împărți în microservicii nu părea posibil.
The third problem — lipsa infrastructurii necesare. Practic, ne ocupam cu copierea manuală a codului sursă pe servere.
Cum să treci de la monolit la microservicii
Separarea microservicilor
În primul rând, ne-am definit de la început că separarea microservicilor este un proces iterativ. Ni s-a cerut întotdeauna să desfășurăm simultan dezvoltarea sarcinilor de afaceri. Cum vom realiza acest lucru tehnic — este deja problema noastră. De aceea, ne-am pregătit pentru un proces iterativ. Altminteri nu va fi posibil, dacă aveți o aplicație mare și nu este inițial pregătită pentru a fi rescrisă.
Ce metode folosim pentru a evidenția microserviciile?
Prima metodă — a performa modulele existente ca servicii. În acest sens, am avut noroc: erau deja servicii implementate care funcționau pe protocolul WCF. Acestea erau separate în ansambluri distincte. Le-am mutat individual, adăugând unui fiecare ansamblu un mic modul de lansare. Acesta a fost scris cu ajutorul bibliotecii minunate Topshelf, care permite rularea aplicației atât ca serviciu, cât și ca aplicație de consolă. Este convenabil pentru depanare, deoarece nu sunt necesare proiecte suplimentare în soluție.
Serviciile erau legate prin logica de afaceri, deoarece utilizau ansambluri comune și lucrând cu o bază de date comună. Erau greu de numit microservicii în sensul pur. Cu toate acestea, puteam oferi aceste servicii separat, în procese diferite. Acest lucru a permis deja reducerea influenței reciproce, diminuând problema dezvoltării paralele și a punctului unic de eșec.
Ansamblul cu gazda este doar o singură linie de cod în clasa Program. Lucrul cu Topshelf l-am ascuns într-o clasă auxiliară.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
A doua metodă de extragere a microserviciilor: a le crea pentru a rezolva sarcini noi. Dacă în acest proces monolitul nu crește, este deja excelent, înseamnă că ne îndreptăm în direcția corectă. Pentru a aborda sarcini noi, am încercat să facem servicii separate. Dacă era o oportunitate, creăm servicii mai "canonice", care gestionează complet modelul lor de date, cu o bază de date separată.
La fel ca mulți, am început cu serviciile de autentificare și autorizare. Acestea sunt perfecte pentru acest lucru. Sunt independente, de obicei au un model de date separat. Ele nu interacționează direct cu monolitul, ci doar monolitul le solicită pentru rezolvarea anumitor sarcini. Aceste servicii pot marca începutul tranziției către o nouă arhitectură, le putem utiliza pentru a ne perfecționa infrastructura, a încerca diverse abordări legate de bibliotecile de rețea etc. În organizația noastră nu există echipe care să nu fi reușit să implementeze un serviciu de autentificare.
A treia metodă de extragere a microserviciilor, pe care îl folosim, este oarecum specific pentru noi. Este vorba despre extragerea logicii de afaceri din stratul UI. Principala noastră aplicație UI este desktop, fiind scrisă în C#, la fel ca și backend-ul. Dezvoltatorii au greșit periodic și au mutat în UI părți ale logicii care ar fi trebuit să existe în backend și să fie reutilizate.
Dacă ne uităm la un exemplu real din codul părții UI, observăm că o mare parte din această soluție conține adevărata logică de afaceri, care este utilă în alte procese, nu doar pentru construirea formularului UI.
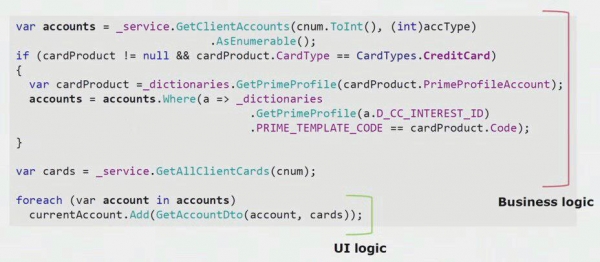
Ceva logică reală în UI există doar în ultimele câteva linii. Am mutat-o pe server pentru a putea fi reutilizată, reducând astfel dimensiunea UI și atingând o arhitectură corectă.
A patra și cea mai importantă metodă de extragere a microserviciilor, care permite reducerea monolitului, este extragerea serviciilor existente cu refacere. Atunci când extragem modulele existente așa cum sunt, rezultatul nu întotdeauna îi mulțumește pe dezvoltatori, iar procesul de afaceri s-ar putea să fi devenit depășit de la crearea funcționalității. Prin refactoring, putem susține un nou proces de afaceri, deoarece cerințele comerciale se schimbă constant. Putem îmbunătăți codul sursă, elimina defectele cunoscute, crea un model de date de calitate superioară. Se acumulează multe avantaje.
Separarea serviciilor cu refacere este strâns legată de conceptul de context limitat. Acest concept provine din proiectarea orientată pe obiect. Se referă la o porțiune a modelului de domeniu, în care toți termenii dintr-un limbaj unificat sunt definiți fără ambiguitate. Să ne uităm la exemplul contextului asigurărilor și facturilor. Avem o aplicație monolitică, și este necesar să lucrăm cu factura în asigurări. Ne așteptăm ca dezvoltatorul să găsească într-o altă construcție clasa existentă „Factură”, să facă referire la ea din clasa „Asigurare”, iar noi să obținem un cod funcțional. Principiul DRY va fi respectat, sarcina va fi finalizată mai repede prin utilizarea codului existent.
Se dovedește că contexturile pentru conturi și asigurări sunt interconectate. Când apar noi cerințe, această legătură va crea dificultăți în dezvoltare, crescând complexitatea unei logici de afaceri deja complicate. Pentru a rezolva această problemă, trebuie să identificăm limitele dintre contexte în cod și să eliminăm încălcările acestora. De exemplu, pentru asigurări, este foarte posibil să fie suficient un număr de cont de 20 de caractere de la Banca Centrală și data deschiderii contului.
Pentru a separa aceste contexte limitate și a începe procesul de extragere a microserviciilor dintr-o soluție monolitică, am folosit o abordare de creare a API-urilor externe în cadrul aplicației. Dacă știam că un anumit modul trebuie să devină un microserviciu sau să se modifice într-un anumit mod în cadrul procesului, făceam imediat apeluri la logica care aparține altui context limitat, prin apeluri externe. De exemplu, prin REST sau WCF.
Am decis ferm că nu ne vom feri de codul care va necesita realizarea de tranzacții distribuite. În cazul nostru, s-a dovedit a fi destul de ușor să respectăm această regulă. Până acum nu am avut situații în care să fie necesare tranzacții distribuite stricte — coerența finală între module s-a dovedit a fi suficientă.
Să luăm un exemplu concret. Avem conceptul de orchestrator — un canal care procesează entitatea „cerere”. Acesta creează în ordine clientul, contul și cardul bancar. Dacă clientul și contul sunt create cu succes, iar crearea cardului eșuează, cererea nu trece în statusul „reușit” și rămâne în statusul „cardul nu a fost creat”. În viitor, o activitate de fundal o va prelua și o va finaliza. Sistemul rămâne o vreme în stare de incoerență, dar acest lucru este, în general, acceptabil pentru noi.
În cazul în care va apărea totuși o situație în care va trebui să păstrăm coerent o parte din date, cel mai probabil vom opta pentru consolidarea serviciului, pentru a putea procesa aceasta într-un singur proces.
Să luăm un exemplu de extragere a unui microserviciu. Cum putem să-l ducem relativ sigur în producție? În acest exemplu, avem o parte separată din sistem — modulul de servicii salariale, unul dintre segmentele de cod pe care dorim să-l transformăm în microserviciu.
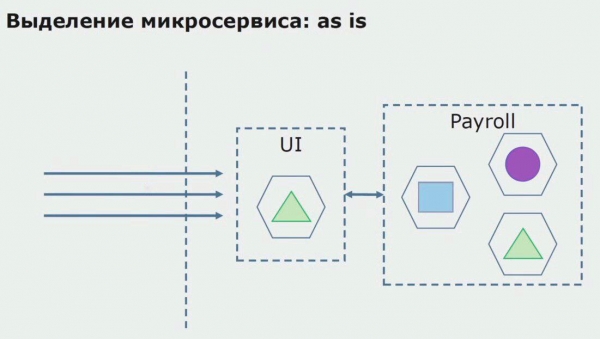
În primul rând, creăm un microserviciu, rescriind codul. Îmbunătățim anumite aspecte care nu ne-au mulțumit. Implementăm noile cerințe de afaceri ale clientului. Adăugăm în legătura dintre UI și backend un API Gateway, care va asigura transmiterea apelurilor.
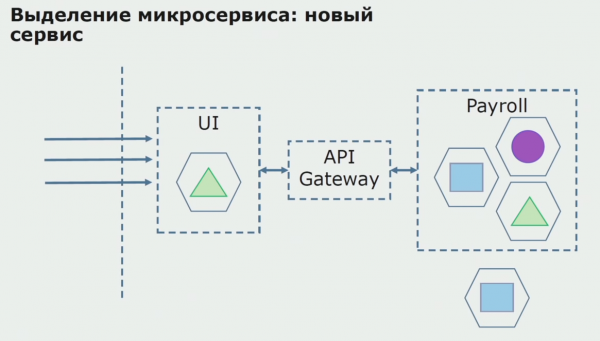
Apoi, lansăm această configurație în exploatare, dar într-o stare pilot. Majoritatea utilizatorilor noștri continuă să lucreze cu procesele de afaceri vechi. Pentru utilizatorii noi, dezvoltăm o nouă versiune a aplicației monolitice, care nu mai conține acest proces. Practic, avem, în mod pilot, o legătură între monolit și microserviciu.
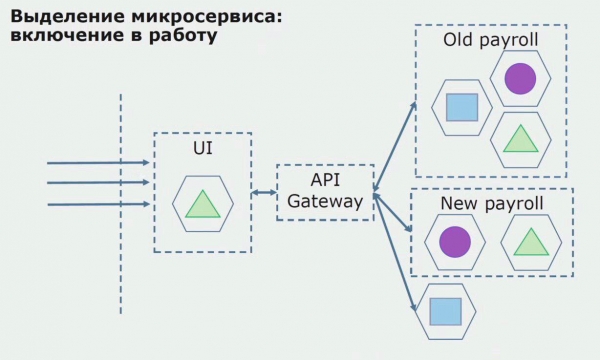
În cazul unui pilot de succes, realizăm că noua configurație este cu adevărat funcțională, putem elimina din ecuație vechiul monolit și lăsa noua configurație în locul vechiului sistem.
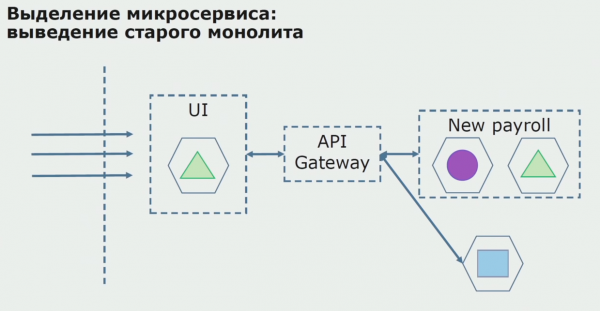
În total, folosim aproape toate metodele existente de separare a codului sursă al monolitului. Toate acestea ne permit să reducem dimensiunea părților aplicației și să le migrăm pe biblioteci noi, creând un cod sursă de mai bună calitate.
Lucrul cu Baza de Date
BD-ul este mai dificil de separat decât codul sursă, deoarece conține nu doar schema curentă, ci și datele istorice acumulate.
BD-ul nostru, ca multe altele, a avut o altă problemă importantă - dimensiunea huge. Această BD a fost proiectată conform unei logici de afaceri complicate a monolitului, iar între tabelele diferitelor contexte limitate s-au acumulat legături.
În cazul nostru, pe lângă toate problemele (o bază de date mare, multe legături, uneori granițe neclare între tabele) a apărut o problemă întâlnită în multe proiecte mari: utilizarea modelului de bază de date partajată. Datele erau extrase din tabele prin view-uri, prin replicare și erau livrate în alte sisteme, unde era necesară această replicare. Ca urmare, nu am putut separa tabelele într-o schemă distinctă, deoarece acestea erau utilizate activ.
În separare, ne ajută tocmai acea fragmentare în contexte limitate din cod. Aceasta ne oferă, în general, o imagine destul de bună despre cum separăm datele la nivelul bazei de date. Înțelegem care tabele aparțin aceluiași context limitat și care altuia.
Am aplicat două metode globale pentru separarea bazei de date: separarea tabelelor existente și separarea cu refacere.
Separarea tabelelor existente este o metodă care se aplică bine atunci când structura datelor este de calitate, satisfacă cerințele de business și este acceptabilă pentru toți. În acest caz, putem aloca tabelele existente într-un schelet separat.
Separarea cu refacere este necesară atunci când modelul de afaceri s-a schimbat considerabil, iar tabelele nu ne mai satisfac deloc.
Separarea tabelelor existente. Trebuie să definim ce ne propunem să separăm. Fără această cunoaștere, nimic nu va funcționa, iar aici ne va ajuta separarea contextelor limitate în cod. De obicei, dacă reușim să înțelegem limitele contextelor în codul sursă, devine clar ce tabele ar trebui incluse în lista de separare.
Să ne imaginăm că avem o soluție în care două module ale monolitului interacționează cu o bază de date. Trebuie să facem astfel încât doar un modul să interacționeze cu zona de tabele separate, iar celălalt să înceapă să interacționeze cu acesta prin API. Pentru început, este suficient ca doar scrierea să se desfășoare prin API. Aceasta este o condiție necesară pentru a putea vorbi despre independența microserviciilor. Relațiile de citire pot rămâne, atâta timp cât nu există mari probleme în acest sens.
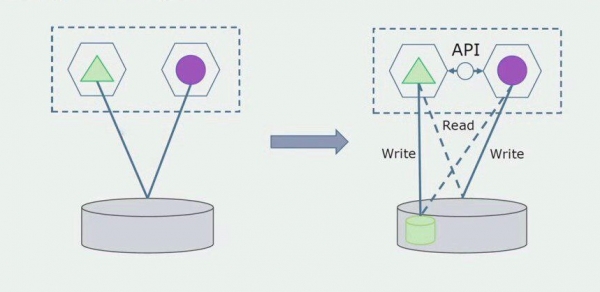
Următorul pas va fi să extragem codul care lucrează cu tabelele separate, fie cu refacere, fie fără, într-un microserviciu separat și să-l rulăm într-un proces sau container separat. Acesta va fi un serviciu separat cu legătura la baza de date a monolitului și la acele tabele care nu sunt direct legate de acesta. Monolitul va continua să interacționeze prin citire cu partea separată.
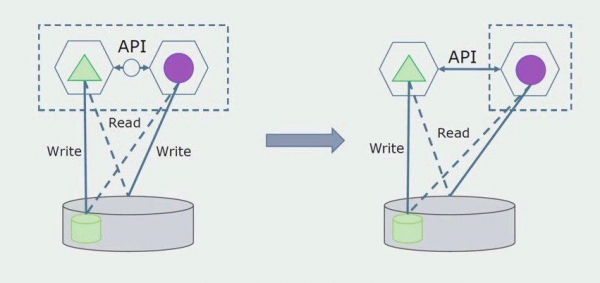
Mai târziu, vom elimina această legătură, adică citirea datelor din aplicația monolitică din tabelele separate va fi, de asemenea, transferată pe API.
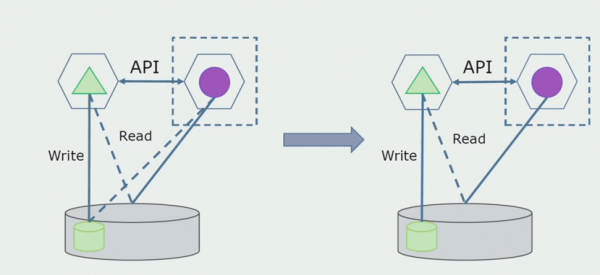
Apoi, vom separa din baza de date comună tabelele cu care lucrează doar noul microserviciu. Putem muta tabelele într-un schelet separat sau chiar într-o bază de date fizică separată. A rămas legătura de citire între microserviciu și baza de date a monolitului, dar nu este nimic grav în acest sens, în această configurație poate funcționa destul de mult timp.
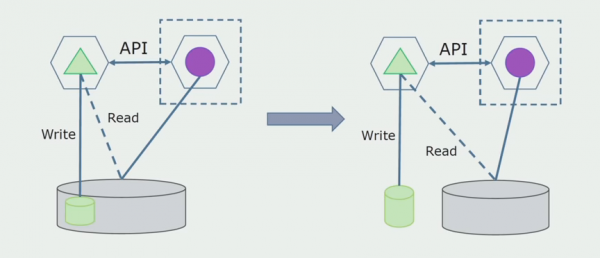
Ultimul pas este să eliminăm complet toate legăturile. În acest caz, poate fi necesară migrarea datelor din baza de date principală. Uneori, va trebui să reutilizăm în mai multe baze de date anumite date sau dicționare replicate din sisteme externe. Acest lucru se întâmplă periodic la noi.
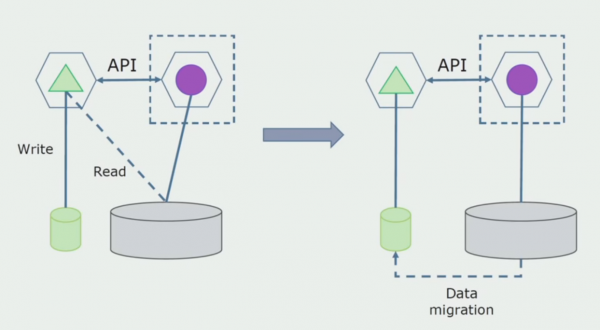
Secția de reprocesare. Această metodă este foarte asemănătoare cu prima, doar că merge în ordine inversă. În această etapă, se definește imediat o nouă bază de date și un nou microserviciu, care interacționează cu monolitul prin API. Totuși, rămâne un set de tabele din baza de date pe care dorim să le eliminăm în viitor. Nu o mai avem nevoie, deoarece în noul model am înlocuit-o.
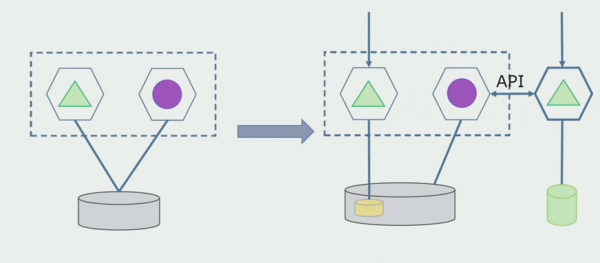
Pentru ca acest sistem să funcționeze, cel mai probabil va fi nevoie de o perioadă de tranziție.
Apoi sunt două abordări posibile.
Primul: duplicăm toate datele în noile și vechile baze de date. În acest caz, avem un surplus de date, pot apărea probleme de sincronizare. Dar astfel putem lua doi clienți diferiți. Unul va lucra cu noua versiune, iar celălalt cu vechea.
Al doilea: separăm datele pe baza unui criteriu de afaceri. De exemplu, în sistemul nostru existau 5 produse care erau stocate în vechea bază de date. Cel de-al șaselea, în cadrul noii provocări de afaceri, îl plasăm în noua bază de date. Dar ne va trebui un API Gateway, care să sincronizeze aceste date și să arate clientului de unde și ce să ia.
Ambele abordări sunt funcționale, alegeți în funcție de situație.
După ce ne asigurăm că totul funcționează, o parte din monolitul care interacționează cu vechile structuri de baze de date poate fi oprită.
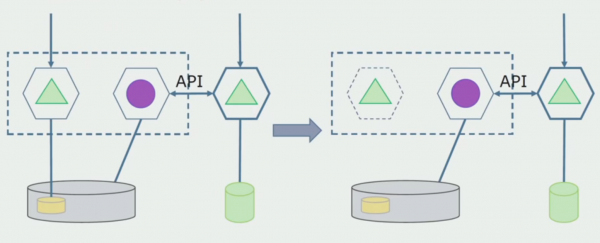
Ultimul pas va fi eliminarea vechilor structuri de date.
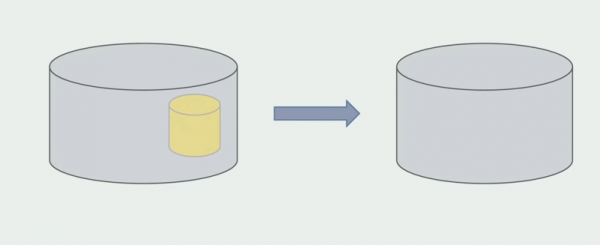
În concluzie, putem spune că avem probleme cu baza de date: este mai greu de lucrat în comparație cu codul sursă, mai greu de separat, dar se poate și trebuie făcut. Am găsit câteva modalități care permit acest lucru destul de sigur, pentru că, totuși, să greșești cu datele este mai simplu decât cu codul sursă.
Lucrul cu codul sursă
Așa arăta schema codului sursă când am început să analizăm proiectul monolitic.
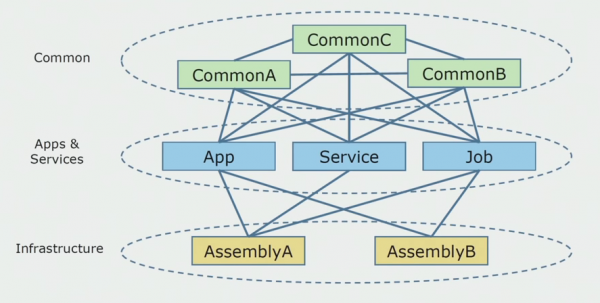
Ea poate fi împărțită în trei straturi. Acesta este stratul modulelor, plugin-urilor, serviciilor și activităților active. De fapt, acestea erau punctele de intrare în soluția monolitică. Toate acestea erau strâns legate de stratul Common. În acesta se afla logica de afaceri pe care serviciile o utilizau împreună, precum și numeroase conexiuni. Fiecare serviciu și plugin folosea până la 10 sau mai multe colecții comune, în funcție de dimensiunea lor și de conștiința dezvoltatorilor.
Am avut noroc, aveam biblioteci de infrastructură pe care le puteam folosi separat.
Uneori apărea situația în care anumite obiecte Common nu se refereau de fapt la acest strat, ci erau biblioteci de infrastructură. Acest lucru se rezolva prin renaming.
Cele mai mari îngrijorări erau cauzate de contextul limitat. Se întâmpla ca 3-4 contexte să se amestece într-o singură colecție Common și să se utilizeze unul pe altul în cadrul unor funcții de afaceri comune. Trebuia să ne dăm seama unde putea fi acestea împărțite și pe ce limite și ce să facem în continuare cu maparea acestei împărțiri în colecțiile de cod sursă.
Am formulat câteva reguli pentru procesul de împărțire a codului.
Primul: nu ne mai doream partajarea logicii de afaceri între servicii, activități și plugin-uri. Vream să facem logica de afaceri independentă în cadrul microserviciilor. Pe de altă parte, microserviciile,în ideal, sunt percepute ca servicii care există complet independent. Cred că această abordare este oarecum risipitoare și este greu de realizat, deoarece, de exemplu, serviciile scrise în C# vor fi totuși conectate prin biblioteca standard. Sistemul nostru este scris în C#, iar alte tehnologii nu au fost folosite până acum. Așa că am decis că ne putem permite să folosim colecții tehnice comune. Principalul lucru este că nu trebuie să existe fragmente de logică de afaceri în ele. Dacă aveți o învelitoare convenabilă peste ORM pe care o folosiți, atunci copierea ei din serviciu în serviciu este foarte costisitoare.
Echipa noastră este adeptă a designului orientat pe obiect, așa că arhitectura „în straturi” ni s-a potrivit perfect. Fundamentul serviciilor noastre a fost o construcție cu logica de domeniu, care conține doar logica de afaceri și este lipsită de legături cu infrastructura. În acest fel, putem îmbunătăți independent construcția de domeniu pentru a rezolva problemele legate de cadre.
În această etapă ne-am confruntat cu prima problemă serioasă. Serviciul trebuia să se refere la o construcție de domeniu, iar logica voiam să fie independentă, iar principiul DRY ne-a dat mari bătăi de cap. Dezvoltatorii doreau să reutilizeze clase din construcții adiacente pentru a evita duplicarea, iar în rezultat domeniile au început din nou să se conecteze între ele. Am analizat rezultatele și am decis că, poate, problema se regăsește și în organizarea depozitului de cod sursă. Aveam un depozit mare în care erau toate codurile sursă. Era foarte greu să construim o soluție pentru întregul proiect pe mașina locală. Așadar, pentru părți ale proiectului se creau soluții mici separate, iar nimeni nu interzicea adăugarea unei construcții comune sau de domeniu și reutilizarea acesteia. Singurul instrument care nu ne permitea să facem acest lucru era revizia de cod. Dar uneori și aceasta dădea greș.
Atunci am început să trecem la un model cu depozite separate. Logica de afaceri a încetat să se scurgă din serviciu în serviciu, domeniile au devenit realmente independente. Contextul limitat este susținut mai clar. Cum reaplicăm bibliotecile de infrastructură? Le-am separat într-un depozit distinct, apoi le-am plasat în pachete Nuget, pe care le-am stocat în Artifactory. La orice modificare, construcția și publicarea au loc automat.
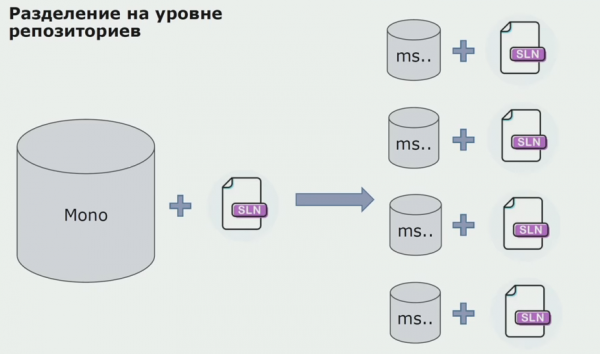
Serviciile noastre au început să se referă la pachetele interne de infrastructură exact așa cum se referă la cele externe. Descărcăm bibliotecile externe din Nuget. Pentru a lucra cu Artifactory, unde am plasat aceste pachete, am utilizat doi manageri de pachete. În depozitele mici am folosit, de asemenea, Nuget. În depozitele cu mai multe servicii am folosit Paket, care asigură o mai bună coerență a versiunilor între module.
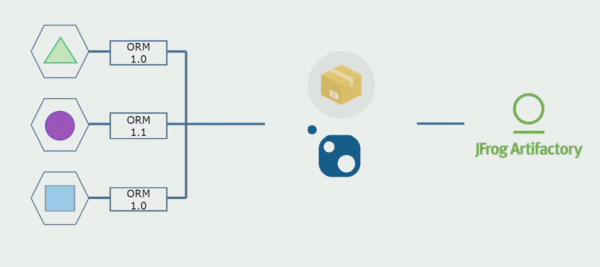
Prin urmare, lucrând la codul sursă, modificând puțin arhitectura și separând repositoarele, facem serviciile noastre mai independente.
Problemele infrastructurii
Cele mai multe dezavantaje ale tranziției la microservicii sunt legate de infrastructură. Veți avea nevoie de desfășurare automată, vor fi necesare noi biblioteci pentru funcționarea infrastructurii.
Instalarea manuală în medii
Inițial, soluția pentru medii era instalată manual. Pentru a automatiza acest proces, am creat un pipeline CI/CD. Am ales procesul de livrare continuă, deoarece desfășurarea continuă nu este înca acceptabilă din punct de vedere al proceselor de afaceri. Prin urmare, desfășurarea în producție se realizează cu un buton, iar pentru testare — automat.
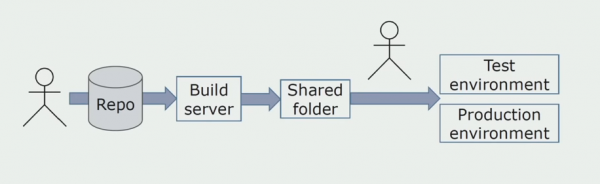
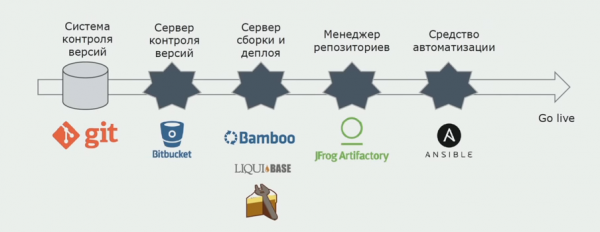
Folosim Atlassian, Bitbucket pentru stocarea codurilor sursă și Bamboo pentru compilare. Ne place să scriem scripturi de compilare în Cake, deoarece este același C#. Pachetele gata vin în Artifactory, iar Ansible se transferă automat pe serverele de testare, după care pot fi testate imediat.
Logare separată
La vremea respectivă, una dintre ideile monolitului era asigurarea unei jurnalizări comune. De asemenea, a trebuit să înțelegem ce să facem cu jurnalele separate care se află pe discuri. Jurnalele noastre sunt scrise în fișiere text. Am decis să folosim stack-ul standard ELK. Nu am scris în ELK direct prin furnizori, ci am decis să îmbunătățim jurnalele text și să înregistrăm ID-ul de urmărire sub forma unui identificator, adăugând numele serviciului, astfel încât aceste jurnale să poată fi ulterior analizate.
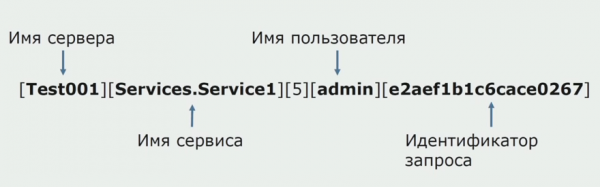
Cu ajutorul Filebeat, avem posibilitatea de a colecta jurnalele noastre de servere, apoi de a le transforma, folosind Kibana pentru a construi interogări în UI și a vedea cum a fost apelul între servicii. ID-ul de urmărire ajută foarte mult în acest sens.
Testarea și depanarea serviciilor interconectate
Inițial, nu înțelegeam pe deplin cum să depurăm serviciile dezvoltate. Cu monolitul, era simplu, îl puneam în funcțiune pe mașina locală. La fel am încercat și cu microserviciile, dar uneori, pentru a lansa un microserviciu, trebuie să lansăm și alte câteva, ceea ce este incomod. Am realizat că trebuie să trecem la un model în care lăsăm pe mașina locală doar serviciul sau serviciile pe care vrem să le debuggăm. Celalalte servicii sunt folosite de pe servere care coincid cu configurația din producție. După depanare, în timpul testării, pentru fiecare sarcină pe serverul de testare sunt livrate doar serviciile modificate. Astfel, soluția este testată în forma în care va fi în viitor pe producție.
Există servere pe care sunt instalate doar versiunile de producție ale serviciilor. Aceste servere sunt necesare în caz de incidente, pentru verificarea livrării înainte de deploy și pentru instruiri interne.
Am adăugat un proces de testare automată folosind biblioteca populară Specflow. Testele sunt executate automat cu NUnit imediat după implementarea din Ansible. Dacă acoperirea sarcinii este complet automată, nu este nevoie de testare manuală. Cu toate acestea, uneori este necesară o testare manuală suplimentară. Pentru a determina ce teste să rulăm pentru o sarcină specifică, folosim etichete în Jira.
În plus, a crescut nevoia de testare de stres, care anterior era efectuată doar în cazuri rare. Pentru a lansa testele folosim JMeter, pentru stocarea acestora — InfluxDB, iar pentru construirea graficelor procesului — Grafana.
Ce am reușit?
În primul rând, am eliminat conceptul de „versiune”. Au dispărut versiunile monstruoase de două luni, când această mașină era implementată în mediu de producție, afectând temporar procesele de afaceri. Acum, lansăm servicii în medie la fiecare 1,5 zile, grupându-le, deoarece intră în exploatare după aprobat.
În sistemul nostru nu există defecte fatale. Dacă am lansat un microserviciu cu o eroare, atunci funcționalitatea asociată va fi afectată, iar întreaga restul funcționalității nu va suferi. Acest lucru îmbunătățește semnificativ experiența utilizatorului.
Putem gestiona schema de implementare. Se pot delimita grupuri de servicii separat de celelalte soluții, dacă este necesar.
În plus, am redus semnificativ problema cu long backlog-ul de modificări. Avem echipe de produse dedicate, care lucrează la o parte din servicii în mod independent. Aici se pot aplica bine procesul Scrum. O echipă specifică poate avea un proprietar de produs distinct, care îi stabilește sarcinile.
Rezumat
- Microserviciile sunt potrivite pentru descompunerea sistemelor complexe. În proces, începem să înțelegem ce există în sistemul nostru, ce contexte limitate avem și unde sunt granițele lor. Acest lucru permite distribuirea corectă a modificărilor pe module și evitarea confuziei codului.
- Microserviciile oferă avantaje organizaționale. Se vorbește adesea despre ele doar ca despre o arhitectură, dar orice arhitectură este necesară pentru a răspunde nevoilor afacerii, nu este un scop în sine. Prin urmare, putem spune că microserviciile sunt excelente pentru a rezolva sarcini de echipe mici, având în vedere popularitatea actuală a Scrum.
- Divizarea este un proces iterativ. Nu poți lua o aplicație și să o separi pur și simplu în microservicii. Produsul rezultat va fi puțin probabil funcțional. Când se delimitează microserviciile, este benefic să rescriem legatul existent, adică să-l transformăm în cod care ne place și care satisface mai bine nevoile afacerii în ceea ce privește funcționalitatea și viteza.
O mică avertizare: costurile tranziției la microservicii sunt destul de semnificative. A durat mult timp pentru a rezolva problema infrastructurii. De aceea, dacă aveți o aplicație mică care nu necesită scalare specifică, dacă nu există un număr mare de clienți care se bat pentru atenția și timpul echipei dvs., poate că microserviciile nu sunt ceea ce aveți nevoie astăzi. Este destul de scump. Dacă începeți procesul cu microservicii, costurile inițiale vor fi mai mari decât dacă același proiect ar începe cu dezvoltarea unui monolit.
P.S. O poveste mai emoțională (și ca și cum ar fi personal pentru dvs.) – pe .
Aici este versiunea completă a raportului.
Sursa: habr.com
