

Primul API al MeuStoc a apărut acum 10 ani. În tot acest timp, am lucrat la versiunile existente ale API-ului și dezvoltăm altele noi. Iar câteva versiuni ale API-ului au fost deja „îngropate”.
În acest articol vor fi multe informații: cum a fost creat API-ul, de ce este necesar pentru serviciile cloud, ce le oferă utilizatorilor, pe ce obstacole am dat peste și ce dorim să facem în continuare.
Mă numesc Oleg Alekseev , sunt director tehnic și co-fondator al MeuStoc.
De ce să facem un API pentru serviciu
Clienții noștri, care sunt zeci de mii de antreprenori, folosesc activ soluții cloud: servicii bancare, magazine online, gestiune a stocurilor, CRM. Te conectezi la unul — și deja devine greu să te oprești. Iar acum al cincilea, al optulea, al zecelea serviciu face munca antreprenorilor mai ușoară, dar utilizatorii transferă manual datele între aceste servicii cloud. Munca devine un coșmar.
O soluție evidentă este să oferim utilizatorilor posibilitatea de a transfera date între serviciile cloud. De exemplu, să importe și să exporte date ca fișiere, care apoi pot fi încărcate în serviciul dorit. De obicei, fișierele sunt adaptate la formatul fiecărui serviciu. Este o muncă manuală mai mult sau mai puțin simplă, dar odată cu creșterea numărului acestor servicii, devine tot mai complicat de realizat.
Prin urmare, următorul pas este API-ul. Cu acesta, serviciul cloud câștigă prin interconectarea mai multor servicii într-un singur punct. Apariția unei astfel de ecosisteme atrage clienți noi datorită oportunităților suplimentare. Un produs cu o funcționalitate nouă devine mai avantajos și util.
Dacă se creează interfețe proprii de programare, acestea atrag vânzători externi, sub formă de programatori care cunosc produsul datorită API-ului. Aceștia încep să construiască soluții bazate pe API-ul propus și câștigă bani din automatizarea sarcinilor clienților lor.
Sistemul de contabilitate al MeuStoc se bazează pe procese simple. Principalul lucru este lucrul cu documentele primare, posibilitatea de a efectua recepția și livrarea bunurilor, obținerea de rapoarte pentru afaceri pe baza documentelor primare. De asemenea, există transferul de date, de exemplu către contabilitatea cloud, și obținerea acestora din sistemele bancare sau din punctele de vânzare cu amănuntul. De asemenea, lucrăm cu magazinele online: obținem informații despre produse și trimitem date despre stocuri.
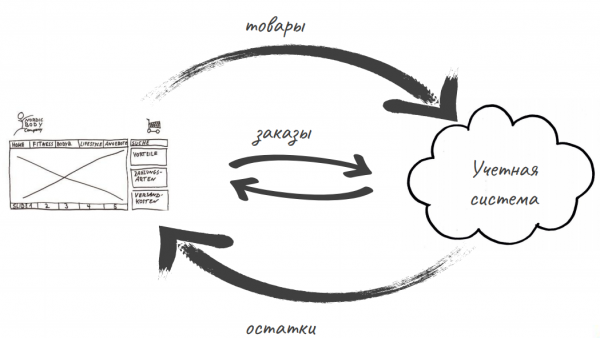
Primul API al MeuStoc
În cei 10 ani de activitate a MeuStoc cu API, am acumulat diverse integrații care permit schimbul de date, lucrul cu băncile, efectuarea de plăți și utilizarea telefoniei externe.
În primul an, am creat posibilitatea de a exporta orice date în format XML. Atunci, utilizatorilor le era mult mai clar și mai familiar să păstreze datele offline, nu în vreun cloud, și le-am oferit acest lucru. Exportul era inițiat printr-un export manual din interfață. Așadar, acest API nu putea fi numit încă.
Atunci am început colaborarea cu compania Rusagro — ei foloseau deja un ERP „matur” pentru planificarea producției și vânzărilor, iar încărcarea vagoanelor la fabrici era automatizată în MeuStoc. Așa au apărut primele începuturi ale unui API adevărat: schimbul între serviciul nostru și ERP se realiza prin trimiterea unui fișier mare cu date despre toate tipurile de documente.
Aceasta era o opțiune bună pentru schimbul de date în vrac, dar împreună cu documentele trebuia să transmitem și dependențele acestora: informații despre produse, parteneri și depozite. O astfel de amestecătură nu este greu de generat la export, dar este destul de greu de descompus la import, deoarece în același pachet ajung toate informațiile: atât despre documentele noi, cât și despre cele existente.
Primul XML API nu a durat mult — după doi ani am început restructurarea lui. Chiar de la începutul activității sale, am făcut câteva greșeli în construirea interfeței de programare.
Cum a fost realizat XML API: ilustrație de la unul dintre arhitecții noștri. Apropo, așteptați articolele lui.
Iată greșelile noastre principale:
- Markup-ul JAXB a fost realizat direct pe entity beans. Pentru comunicarea cu baza de date, folosim Hibernate, iar pe aceleași bean-uri a fost realizat markup-ul JAXB. Această greșeală a apărut aproape imediat: orice actualizare a structurii de date ducea la necesitatea de a anunța urgent pe toți cei care folosesc API-ul, fie prin construirea de soluții temporare care să asigure compatibilitatea cu structura de date anterioară.
- API a evoluat ca un fel de supliment, și inițial nu am definit ce parte a produsului reprezintă. Nu ne-am gândit nici măcar dacă API-ul este ceva important, dacă trebuie să menținem compatibilitatea înapoi pentru primii săi clienți. La un moment dat, numărul utilizatorilor API-ului era de aproximativ 5% din numărul total, și nu am acordat atenție acestora. Filtrarea universală realizată la vremea respectivă a dus la faptul că am devenit utilizați ca backend. Această filtrare nu era deloc GraphQL, dar era ceva similar — funcționa printr-o mulțime de parametri închisi în interogarea de solicitare. Cu un instrument atât de puternic, utilizatorilor le-a fost greu să se abțină, și ne-au redirecționat solicitările astfel încât acestea să fie trimise direct de la UI-urile magazinelor lor online. Situația a fost o surpriză neplăcută, deoarece oferirea unui astfel de serviciu ar trebui să necesite o tarifare diferită și o înțelegere complet diferită a API-ului ca produs.
- Din cauza faptului că API-ul s-a dezvoltat nu ca un produs principal, documentația API-ului a fost realizată și publicată ca o măsură de urgență — prin inginerie inversă. Această abordare pare a fi destul de simplă și convenabilă, dar contravine contractului de muncă. Aceasta este când există un anumit component cu o schemă de funcționare prestabilită. Dezvoltatorul îl implementează conform acestei scheme și sarcinii, componentul este testat, clientul primește un produs care corespunde viziunii analistului. Ingineria inversă, pe de altă parte, oferă piaței un produs care pur și simplu există: cu soluții improvizate, decizii ciudate și „biciclete” în loc de funcționalitatea dorită.
- Întreaga flux de solicitări care venea prin API putea fi analizat nu mai mult decât un log de Nginx sau un server de aplicații. Aceasta nu permitea să fie identificate domeniile tematice, decât să fie împărțit pe utilizatori și abonați. Dacă nu există posibilitatea de a regla înregistrarea aplicației sau a clienților, analiza situației devine imposibilă. Această problemă a afectat în mică măsură dezvoltarea API-ului, mai mult fiind vorba despre înțelegerea cererii sale și a funcționalității sale.
Încercarea numărul două: REST API
În 2010, am încercat să construim un sistem de schimb cu un serviciu de contabilitate online — BuxSoft. Nu a funcționat. Totuși, în procesul de integrare a apărut un API complet funcțional: un serviciu REST de schimb, unde nu existau derapaje precum apelurile RPC pentru operațiuni. Toată comunicarea cu API-ul a fost redusă la un mod standard pentru REST: în stringul de cerere se conține denumirea entității, iar operațiunea care se efectuează cu ea este specificată prin metoda http. Am adăugat filtrare în funcție de momentul actualizării entităților, iar utilizatorii au avut posibilitatea de a construi replicări cu sistemele lor.
În același an, a apărut un API pentru exportul stocurilor și a bunurilor disponibile. Utilizatorii au avut acces prin API la cele mai valoroase părți ale sistemului — schimbul de documente primare și datele de calcul referitoare la stocuri și costurile bunurilor.
În decembrie 2015, RetailCRM a publicat prima bibliotecă externă pentru accesarea API-ului nostru. A fost utilizată destul de activ, iar în același timp, popularitatea serviciului în general a crescut, iar încărcarea pe API a crescut mai repede decât pe interfața web. Odată, creșterea s-a transformat într-un salt al încărcării.
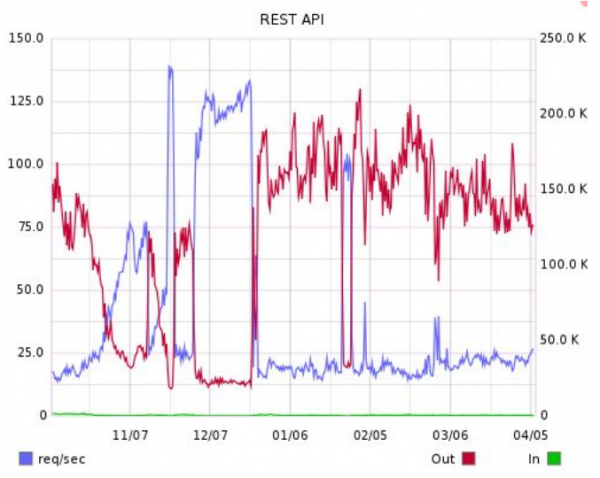
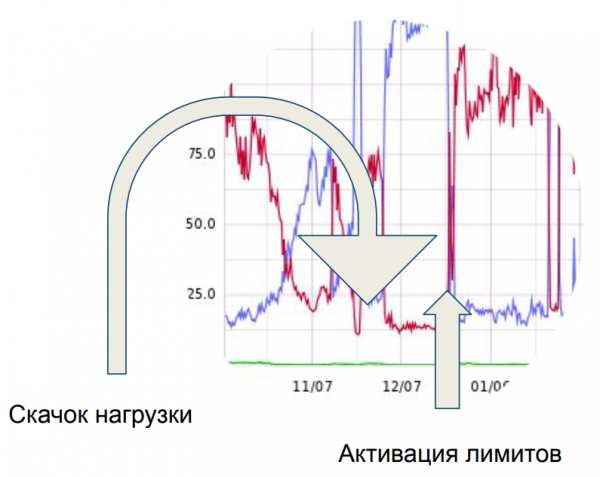
Și acest salt, la care se referă săgeata din stânga, a dus la o mare uimire a serverului care deservesc API-ul nostru. O săptămână am încercat să înțelegem ce anume generează această încărcare. S-a dovedit că acestea erau exact acele cereri transmise către API-ul nostru de front-end-urile clienților. Aproximativ 50 de clienți au consumat totul. Atunci am realizat una dintre greșelile noastre — absența totală a limitelor.
În cele din urmă, am introdus o limită pentru numărul de cereri simultane. De pe un singur cont, acum putea fi deschise simultan nu mai mult de două cereri. Acest lucru este suficient pentru a funcționa în modul de replicare pentru schimbul de date în mod de lot. Iar cei care doreau să ne utilizeze ca backend au fost nevoiți să se conformeze mai mult tarifelor, deoarece au introdus în instrumentele lor software lucrul cu mai multe conturi.
Puntăm lucrurile în ordine
Începând din 2014, cererea pentru API-ul existent a devenit o parte importantă a afacerii, iar API-ul genera cel mai mare volum de date în schimbul de informații cu clienții. În 2015, am lansat un proiect pentru aducerea API-ului în ordine. Am ales formatul JSON în loc de XML și am început să îl construim pe baza caracteristicilor pe care le-am identificat în implementarea versiunii anterioare:
- Posibilitatea de a gestiona versiunile. Versiunea permite dezvoltarea unei noi versiuni, fără a afecta aplicația existentă și fără a perturba utilizatorii.
- Posibilitatea utilizatorului de a vedea metadatele în răspunsul pe care îl primește.
- Posibilitatea de a schimba documente mari. Dacă procesăm un document cu un număr de articole mai mare de 4-5 mii, acesta devine o problemă pentru server: tranzacție lungă, cerere http lungă. Am construit un mecanism special care permite actualizarea documentului pe părți și gestionarea articolelor individuale din acest document, trimițându-le pe server.
- Instrumente pentru replicare — au existat și în versiunea anterioară.
- Limite de încărcare — ca un moștenitor al capcanelor în care am călcat în versiunea anterioară. Am introdus limite pentru numărul de cereri într-un interval de timp, numărul de cereri paralele și cererile de la o adresă IP.
De atunci, am lansat două versiuni minore ale API-ului și am inițiat mai multe API-uri specializate, dar, în general, abordarea a rămas neschimbată. Formatul actualizat de schimb și noua arhitectură au permis corectarea deficiențelor din API mult mai repede.
API-ul MeuStoc astăzi
Astăzi, API-ul MeuStoc rezolvă multe probleme:
- schimb de date cu magazinele online, sisteme de contabilitate, bănci;
- obținerea datelor de calcul, rapoartelor;
- utilizat ca backend pentru aplicațiile client — aplicațiile noastre mobile și casa de marcat pe desktop funcționează prin API
- trimiterea notificărilor despre modificările datelor din MeuStoc — webhooks;
- telefoniia;
- sisteme de loialitate.
Pe baza API-ului, directorul nostru general, Askar Rakhimberdiev a scris în patru ore un bot de Telegram, care preia prin API stocurile:
Acum cifrele uscate.
Iată statistica noastră pentru vechiul API REST:
- 400 companii;
- 600 utilizatori;
- 2 milioane de cereri pe zi;
- 200 Gb/zi trafic ieșit.
Și iată la ce am ajuns în toate API-urile MeuStoc:
- peste 70 de integrații (o parte dintre ele pot fi vizualizate aici );
- 8500 de companii;
- 12 000 de utilizatori;
- 46 de milioane de cereri pe zi;
- 2 Tb/zi trafic ieșit.
Ce urmează
Planurile de dezvoltare a API-ului sunt în discuții active. Ne străduim să luăm în considerare experiența de utilizare oferită de utilizatori. Nu totul poate fi realizat imediat, dar o nouă versiune a API-ului cu metadate mai convenabile și o structură mai compactă, OAuth pentru autentificare și API pentru aplicațiile integrate în interfață este aproape.
Puteți urmări noutățile pe un site special dedicat dezvoltatorilor care integrează cu MoimSklad: .
Sursa: habr.com
