

Bună tuturor! Sunt dezvoltator backend, scriu microservicii în Java + Spring. Lucrez într-o echipă de dezvoltare a produselor interne la Tinkoff.
În echipa noastră, deseori se pune problema optimizării interogărilor în SGBD. Vrem mereu să fie puțin mai rapid, dar nu întotdeauna putem utiliza indecși well-planned – uneori trebuie să căutăm soluții alternative. În timpul uneia dintre aceste căutări pe internet pentru optimizări raționale în lucrul cu Baza de Date, am găsit , autor al cărții SQL Performance Explained. Este acel tip rar de bloguri unde poți citi toate articolele în succesiune.
Vreau să traduc pentru voi un scurt articol scris de Markus. Poate fi numit într-o oarecare măsură un manifest care încearcă să atragă atenția asupra problemei vechi, dar în continuare actuale, a performanței operațiunii offset conform standardului SQL.
În unele locuri voi completa autorul cu explicații și observații. Toate aceste locuri vor fi marcate ca „pr.” pentru claritate.
Introducere scurtă
Cred că mulți știu cât de problematică și lentă devine lucrul cu selecțiile paginilor prin offset. Știați că poate fi destul de simplu înlocuită cu o construcție mai performantă?
Așadar, cuvântul cheie offset indică bazei de date să sară peste primele n înregistrări din interogare. Totuși, baza de date trebuie să citească încă aceste prime n înregistrări de pe disc, în ordinea specificată (pr.: aplicați sortarea, dacă este specificată), și abia după aceea va putea returna înregistrările începând cu n+1 și mai departe. Cel mai interesant este că problema nu este în implementarea specifică a SGBD, ci în definiția inițială conform standardului:
…the rows are first sorted according to the and then limited by dropping the number of rows specified in the from the beginning…
-SQL:2016, Part 2, 4.15.3 Derived tables (pr.: este acum cel mai utilizat standard)
Punctul cheie aici este că offset primește un singur parametru - numărul de înregistrări care trebuie să fie ignorate, și atât. Urmând o astfel de definiție, SGBD poate doar să recupereze toate înregistrările și apoi să elimine cele inutile. Este evident că o astfel de definiție a offset-ului obligă la realizarea de muncă suplimentară. Și nu contează dacă este SQL sau NoSQL.
Încă puțină durere
Problemele offset nu se termină aici, și iată de ce. Dacă între citirile a două pagini de date de pe disc o altă operațiune adaugă o nouă înregistrare, ce se va întâmpla în acest caz?
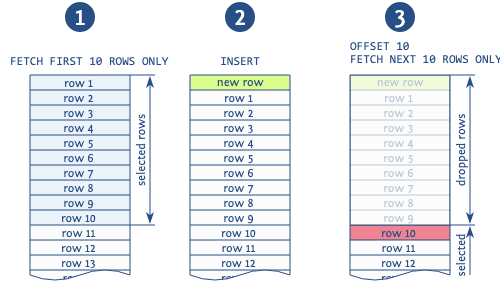
Când se folosește offset pentru a sări peste înregistrările de pe paginile anterioare, într-o situație în care se adaugă o nouă înregistrare între operațiunile de citire a diferitelor pagini, cel mai probabil veți obține duplicate (notă: acest lucru este posibil atunci când citim paginat folosind construcția order by, atunci o nouă înregistrare poate apărea în mijlocul rezultatelor noastre).
Figura ilustrează clar această situație. Baza citește primele 10 înregistrări, după care se adaugă o nouă înregistrare, ceea ce deplasează toate înregistrările citite cu 1. Apoi, baza ia o nouă pagină cu următoarele 10 înregistrări și începe nu cu a 11-a, așa cum ar trebui, ci cu a 10-a, duplicând această înregistrare. Există și alte anomalii legate de utilizarea acestei expresii, dar aceasta este cea mai comună.
După cum am stabilit, acestea nu sunt probleme specifice ale unui anumit SGBD sau implementărilor sale. Problema constă în definiția paginării conform standardului SQL. Spunem SGBD-ului ce pagină trebuie să extragă sau câte înregistrări să sară. Baza pur și simplu nu poate optimiza o astfel de interogare, deoarece informațiile sunt insuficiente.
De asemenea, merită menționat că aceasta nu este o problemă a unui cuvânt cheie specific, ci mai degrabă a semanticii interogării. Există câteva sintaxe identice din punct de vedere al problemei:
- Cuvântul cheie offset, așa cum am menționat anterior.
- Construcția din două cuvinte cheie limit [offset] (deși limit în sine nu este chiar atât de rău).
- Filtrarea pe baza limitelor inferioare, construită pe numerotarea rândurilor (de exemplu, row_number(), rownum etc.).
Toate aceste expresii spun pur și simplu câte rânduri trebuie să fie sărite, fără nicio informație sau context suplimentar.
Mai departe în acest articol, cuvântul cheie offset este folosit ca o generalizare a tuturor acestor variante.
Viața fără OFFSET
Acum să ne imaginăm cum ar fi lumea noastră fără toate aceste probleme. Se pare că viața fără offset nu este atât de complicată: putem selecta doar acele rânduri pe care nu le-am văzut încă (notă: adică cele care nu erau pe pagina anterioară), folosind o condiție în where.
În acest caz, ne bazăm pe faptul că selecțiile se execută asupra unui set ordonat (vechiul și bunul order by). Deoarece avem un set ordonat, putem folosi un filtru destul de simplu pentru a obține doar acele date care se află după ultima înregistrare a paginii anterioare:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Și acesta este principiul acestui abordări. Desigur, atunci când sortăm pe multe coloane, totul devine mai interesant, dar ideea rămâne aceeași. Este important de menționat că această construcție este aplicabilă în multe -soluții.
Această abordare se numește metoda seek sau paginarea pe baze de chei. Ea rezolvă problema rezultatelor fluctuante (exemplu: situația cu înregistrările dintre citirile paginilor, descrisă anterior) și, bineînțeles, ceea ce toți iubim, funcționează mai repede și mai stabil decât offset-ul clasic. Stabilitatea constă în faptul că timpul de procesare a cererii nu crește proporțional cu numărul tabelei solicitate (exemplu: dacă doriți să aflați mai multe despre diferitele metode de paginare, puteți . De asemenea, puteți găsi benchmarkuri comparative pentru diferite metode).
Unul dintre slide-uri , că paginarea pe chei, desigur, nu este omnipotentă — are propriile limitări. Cea mai semnificativă este că nu are capacitatea de a citi pagini aleatorii (exemplu: neconsecutiv). Totuși, în epoca derulării infinite (exemplu: pe front-end) aceasta nu este o problemă atât de mare. Specificarea numărului paginii pentru un clic — este oricum o soluție slabă la dezvoltarea UI (exemplu: opinia autorului articolului).
Și ce se întâmplă cu instrumentele?
Paginarea pe chei nu se potrivește adesea din cauza lipsei de suport instrumental pentru această metodă. Cele mai multe dintre instrumentele de dezvoltare, inclusiv diferite cadre, nu oferă opțiuni privind modul în care va fi executată paginarea.
Situația este agravată de faptul că metoda descrisă necesită suport continuu în tehnologiile utilizate — începând de la DBMS și terminând cu executarea cererii AJAX în browser în timpul derulării infinite. În loc să specificați doar numărul paginii, acum va trebui să specificați un set de chei pentru toate paginile deodată.
Totuși, numărul de cadre care susțin paginarea pe chei crește treptat. Iată ce există în prezent:
- pentru Java;
- pentru Ruby;
- și pentru Django;
- pentru Python;
- — API de criterii pentru implementările JPA;
- pentru Perl;
- , мапер для Node.js .
(Observație: unele linkuri au fost eliminate datorită faptului că, la momentul traducerii, unele biblioteci nu au fost actualizate din 2017-2018. Dacă sunteți interesat, puteți verifica sursa.)
Chiar în acest punct aveți nevoie de ajutorul dumneavoastră. Dacă dezvoltați sau susțineți un cadru care folosește cumva paginarea, vă rog, vă implor, să oferiți o suport nativ pentru paginarea pe chei. Dacă aveți întrebări sau aveți nevoie de ajutor, voi fi încântat să ajut (, , ) (observație: din experiența mea de comunicare cu Markus, pot spune că el abordează cu adevărat cu entuziasm această temă).
Dacă folosiți soluții gata făcute, care credeți că merită sprijin pentru paginarea pe chei, - creați o cerere sau chiar propuneți o soluție gata, dacă este posibil. De asemenea, puteți menționa această articol în link.
Concluzie
Motivul pentru care o abordare atât de simplă și utilă, cum ar fi paginarea pe chei, este rar întâlnită, nu constă în faptul că este greu de realizat tehnic sau necesită eforturi mari. Principalul motiv este că mulți s-au obișnuit să vadă și să lucreze cu offset - această abordare este dictată chiar de standard.
Ca urmare, puțini se gândesc să schimbe abordarea față de paginare, iar din această cauză suportul instrumentar din partea cadrelor și bibliotecilor se dezvoltă lent. Prin urmare, dacă împărtășiți ideea și scopul paginării fără offset, - ajutați la răspândirea acesteia!
Sursa:
Autor: Markus Winand
Sursa: habr.com
