

Vă rugăm, nu vă grăbiți să trageți concluzii pe baza titlului! Avem argumente solide în sprijinul său și le-am ambalat cât mai compact posibil. Vă prezentăm un articol despre conceptul și principiile de funcționare ale noului nostru sistem de stocare a datelor, a cărui lansare a avut loc în ianuarie 2020.
Din punctul nostru de vedere, principalul avantaj competitiv al familiei de sisteme de stocare Dorado V6 este tocmai performanța și fiabilitatea menționate în titlu. Da, da, așa de simplu este, iar despre ce soluții ingenioase și mai puțin ingenioase ne-am atins acest „simplu”, astăzi vom discuta.
Pentru a revela mai bine potențialul sistemelor de nouă generație, vom vorbi despre modelele superioare ale gamei (modelele 8000, 18000). Dacă nu se menționează altceva, acestea sunt cele la care ne referim.
Câteva cuvinte despre piață
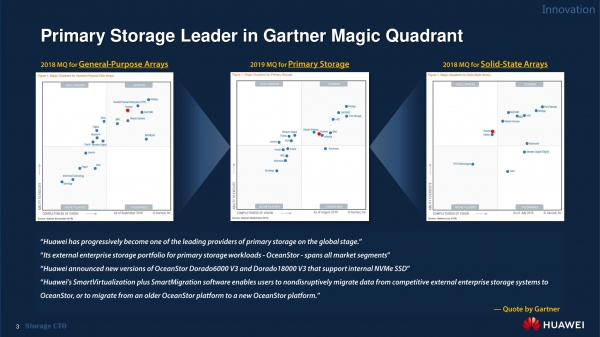
Pentru a înțelege mai bine poziția soluțiilor Huawei pe piață, să ne referim la un criteriu de măsurare verificat — „„ de la Gartner. Acum doi ani, în sectorul array-urilor de discuri de uz general, compania noastră se afla cu siguranță în grupul liderilor, avându-i în față doar pe NetApp și Hewlett Packard Enterprise. Poziția Huawei pe piața sistemelor de stocare pe bază de flash în 2018 a fost caracterizată de statutul de „pretendent”, dar ceva lipsea pentru a atinge poziții de lider.
În 2019, Gartner a combinat cele două sectoare menționate anterior într-unul — „Stocare principală”. Ca urmare, Huawei s-a regăsit din nou în cadranul liderilor, alături de furnizori precum IBM, Hitachi Vantara și Infinidat.
Pentru a clarifica tabloul, trebuie să menționăm că 80% din datele pentru analiza Gartner sunt colectate pe piața americană, ceea ce duce la o distorsiune semnificativă în favoarea companiilor care sunt bine reprezentate în SUA. Între timp, furnizorii orientați spre piețele europene și asiatice se găsesc într-o poziție dezavantajată. Chiar și în ciuda acestui lucru, anul trecut produsele Huawei au ocupat un loc respectabil în cadranul din dreapta sus și, conform verdictului Gartner, „pot fi recomandate pentru utilizare”.
Ce este nou în Dorado V6
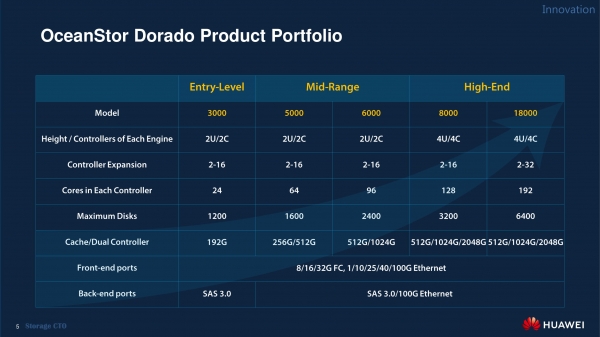
Gama de produse Dorado V6 este reprezentată, în special, de sistemele de nivel de bază din seria 3000. Aflate inițial echipate cu două controlere, acestea pot fi extinse orizontal până la 16 controlere, 1200 de unități și 192 GB de cache. De asemenea, sistemul va fi dotat cu porturi externe Fibre Channel (8 / 16 / 32 Gb/s) și Ethernet (1 / 10 / 25 / 40 / 100 Gb/s).
De remarcat, în prezent, se diminuează utilizarea protocoalelor care nu au succes comercial, așa că, la început, am decis să renunțăm la suportul pentru Fibre Channel over Ethernet (FCoE) și Infiniband (IB). Acestea vor fi adăugate în versiunile ulterioare ale firmware-ului. Suportul NVMe over Fabric (NVMe-oF) este disponibil „din cutie” peste Fibre Channel. În următorul firmware, programat pentru lansare în luna iunie, este planificat suportul pentru modul NVMe over Ethernet. În opinia noastră, setul menționat mai sus va acoperi pe deplin nevoile majorității clienților Huawei.
Accesul la fișiere în versiunea curentă a firmware-ului nu este disponibil și va apărea într-una din actualizările viitoare, mai aproape de sfârșitul anului. Implementarea este planificată la nivel nativ, de către controlerele cu porturi Ethernet, fără utilizarea echipamentului suplimentar.
Principala diferență a modelului Dorado V6 din seria 3000 față de cele mai vechi este că în backend suportă un singur protocol — SAS 3.0. Prin urmare, unitățile de stocare pot fi utilizate doar cu acest interface. Din punctul nostru de vedere, performanța oferită în acest mod este pe deplin suficientă pentru un dispozitiv de acest tip.
Sistemele Dorado din seriile V6 5000 și 6000 se încadrează în categoria soluțiilor de clasă medie. De asemenea, sunt realizate în format 2U și sunt echipate cu două controlere. Ele se deosebesc între ele prin performanță, numărul de procesoare, numărul maxim de unități și volumul cache-ului. Totodată, din punct de vedere arhitectural și ingineresc, Dorado V6 5000 și 6000 sunt identice și au un aspect similar.
La clasa hi-end se încadrează sistemele Dorado V6 din seriile 8000 și 18000. Realizate în dimensiunea 4U, acestea au în mod implicit o arhitectură separată, în care controlerele și unitățile de stocare sunt despărțite. În configurația minimă, ele pot fi dotate cu doar două controlere, deși clienții cer, în general, instalarea a patru sau mai multe.
Dorado V6 8000 se scalează orizontal la 16 controlere, iar Dorado V6 18000 la 32. Aceste sisteme sunt echipate cu procesoare diferite, cu un număr variat de nuclee și dimensiuni ale cache-ului. Identitatea soluțiilor ingineresti este păstrată, la fel ca în modelele din clasa mid-end.
Rafturile 2U cu dischete sunt conectate prin RDMA cu o lățime de bandă de 100 Gbps. Backend-ul Dorado V6 din seriile superioare suportă de asemenea SAS 3.0, dar mai degrabă ca măsură de precauție în cazul în care SSD-urile cu acest tip de interfață vor scădea semnificativ în preț. Atunci va apărea oportunitatea economică de a le folosi, chiar și cu o performanță mai scăzută. În prezent, diferența de preț între SSD-urile cu interfețe SAS și NVMe este atât de mică, încât nu suntem pregătiți să recomandăm o astfel de soluție.
În interiorul controller-ului
Controlerele Dorado V6 sunt realizate pe baza noastră de componente proprii. Niciun procesor Intel, niciun ASIC de la Broadcom. Astfel, toate componentele plăcii de bază, la fel ca și aceasta, sunt complet scutite de riscurile asociate cu presiunea sancțiunilor din partea companiilor americane. Cei care au văzut echipamentele noastre cu propriii ochi, au observat cu siguranță etichetele cu bandă roșie sub logo. Aceasta indică absența componentelor americane din produs. Aceasta este direcția oficială a Huawei - trecerea la componente fabricate intern sau, în orice caz, produse în țări care nu urmează politica SUA.
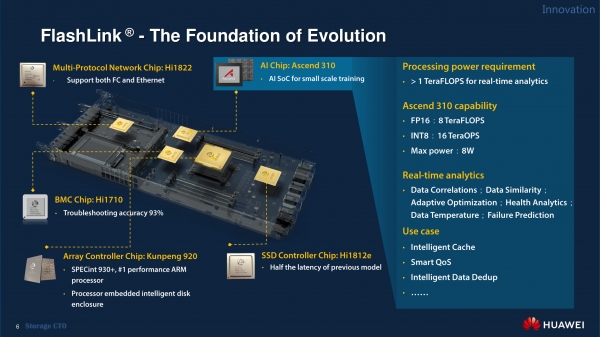
Iată ce poate fi observat pe placa de control.
- Interfața de rețea universală (cip Hisilicon 1822), responsabilă pentru conectarea la Fibre Channel sau Ethernet.
- Cipul BMC, adică Hisilicon 1710, care asigură accesibilitatea la distanță a sistemului, pentru managementul și monitorizarea complet funcțională a acestuia. Cipuri similare sunt folosite de asemenea în serverele noastre și în alte soluții.
- Procesorul central, care este un cip Kunpeng 920 fabricat de Huawei, construit pe arhitectura ARM. Acesta este prezentat în schema de mai sus, deși în alte controlere pot fi instalate modele diferite, cu un număr diferit de nuclee, o frecvență de ceas diferită etc. De la model la model, numărul de procesoare într-un singur controller variază. De exemplu, în seriile superioare ale Dorado V6, pe o placă sunt patru.
- Controller SSD (chip Hisilicon 1812e), which supports the connection of both SAS and NVMe drives. Additionally, Huawei manufactures SSDs independently, but does not produce the NAND cells themselves, preferring to source them from four of the world's largest manufacturers in the form of uncut silicon wafers. Cutting, testing, and packaging into chips is carried out by Huawei itself, after which they are released under its own brand.
- Artificial intelligence chip — Ascend 310. By default, it is not present on the controller and is mounted via a separate card that occupies one of the slots allocated for network adapters. The chip is used to ensure intelligent caching behavior, manage performance, or handle deduplication and compression processes. All these tasks can be performed by the central processing unit, but the AI chip allows for much more efficient execution.
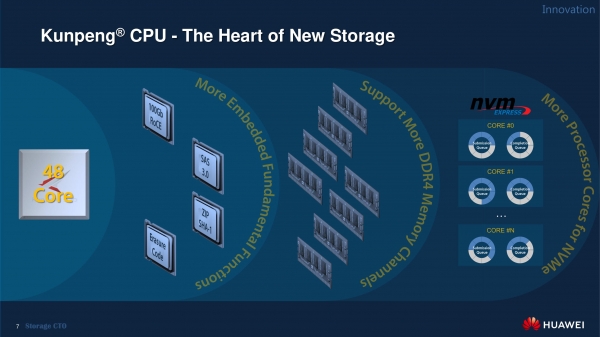
About Kunpeng processors
The Kunpeng processor is a system on a chip (SoC), which includes not only the computing block but also hardware modules that accelerate various processes, such as checksum calculations or executing erasure coding. It also has hardware support for SAS, Ethernet, DDR4 (from six to eight channels), etc. This allows Huawei to create storage controllers that rival traditional Intel solutions in performance.
Moreover, proprietary solutions based on ARM architecture enable Huawei to create complete server solutions and offer them to its customers as an alternative to x86.
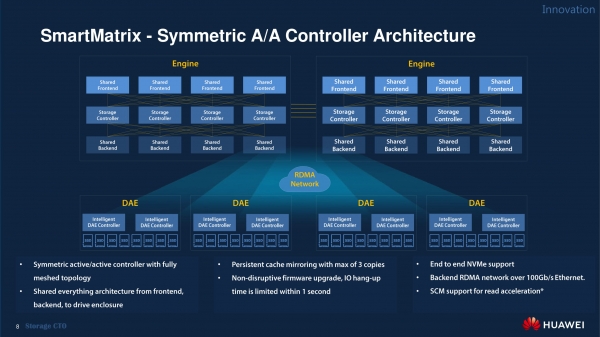
The new Dorado V6 architecture…
The internal architecture of the Dorado V6 high-end series storage system is represented by four main subdomains (factories).
The first factory serves as a common frontend (network interfaces responsible for communication with the SAN factory or hosts).
The second is a set of controllers, each of which can 'reach' any frontend network card via the RDMA protocol as well as to an adjacent 'engine', which is a box with four controllers, along with shared power supply and cooling blocks. Currently, high-end Dorado V6 models can be equipped with two such 'engines' (thus, eight controllers).
A treia fabrică răspunde de backend și este compusă din plăci de rețea RDMA 100G.
În cele din urmă, a patra fabrică „în hardware” este reprezentată de rafturi inteligente conectabile cu stocare.
O astfel de structură simetrică dezvăluie întregul potențial al tehnologiei NVMe și garantează performanță și fiabilitate ridicată. Procesul de intrare-ieșire este maximizat prin paralelizare pe procesoare și nuclee, asigurând citiri și scrieri simultane în multiple fluxuri.
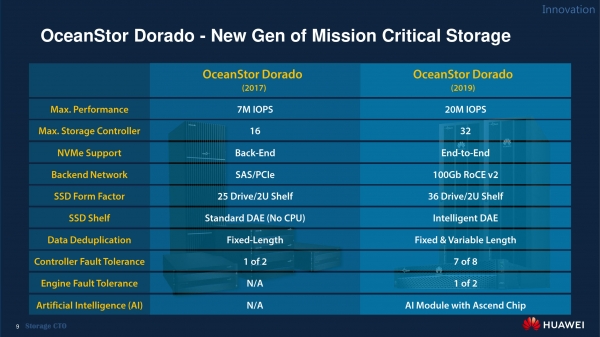
…și ce ne-a oferit aceasta
Performanța maximă a soluțiilor Dorado V6 depășește de aproximativ trei ori rezultatele sistemelor din generația anterioară (de același tip) și poate ajunge până la 20 milioane IOPS.
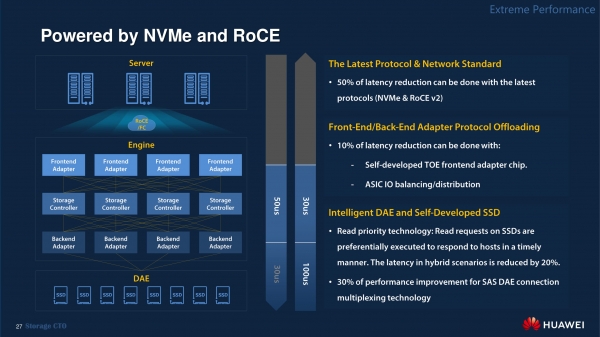
Aceasta se datorează faptului că în generația trecută a dispozitivelor, suportul NVMe era prezent doar pe rafturile de extensie cu stocare. Acum, însă, este prezent la toate etapele, de la gazdă la SSD. Rețeaua de backend a suferit și ea modificări: SAS/PCIe a fost înlocuită cu RoCEv2 cu o lățime de bandă de 100 Gbps.
S-a schimbat și formatul SSD-ului. Dacă anterior pe un raft de 2U se aflau 25 de unități, acum acesta a fost extins la 36 de discuri de format palm-sized. În plus, rafturile au devenit „mai inteligente”. Fiecare din ele are acum un sistem de toleranță la erori format din două controlere bazate pe cipuri ARM, similare cu cele instalate în controlerele centrale.
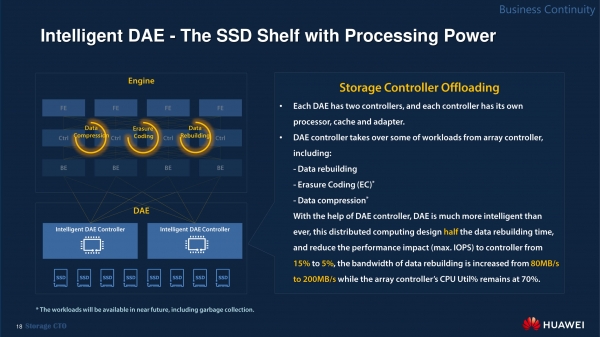
Deocamdată, ele se ocupă doar cu reorganizarea datelor, dar cu lansarea noilor firmware-uri, vor fi adăugate compresia și erasure coding, ceea ce va reduce sarcina pe controlerele principale de la 15% la 5%. Transferul unei părți din sarcini pe raft eliberează, de asemenea, lățimea de bandă a rețelei interne. Toate acestea cresc semnificativ potențialul de scalabilitate al sistemului.
Compresia și deduplicarea în SSD-uri de generația precedentă se desfășurau cu blocuri de lungime fixă. Acum, s-a adăugat un mod de operare cu blocuri de lungime variabilă, care trebuie activat manual. Firmware-urile ulterioare ar putea schimba această situație.
De asemenea, o mențiune scurtă despre toleranța la erori. Dorado V3 își păstra funcționabilitatea dacă unul dintre cele două controlere eșua. Dorado V6 va asigura disponibilitatea datelor chiar și în cazul în care șapte controlere din opt vor eșua secvențial sau patru dintr-un singur „motor” vor eșua simultan.
Fiabilitate din perspectiva economiei
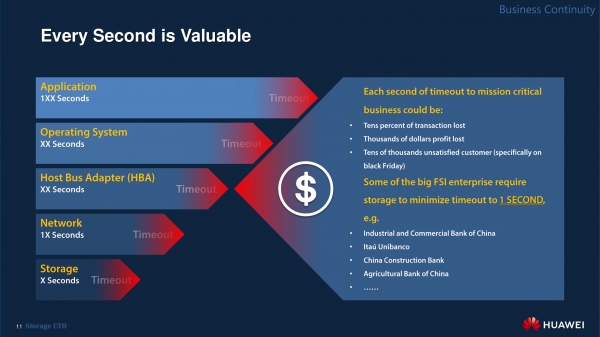
Recent surveys among Huawei customers have investigated which individual components of IT infrastructure the company considers acceptable. In general, respondents were tolerant of a hypothetical situation where an application doesn't respond for several hundred seconds. For the operating system or bus host adapter, critical downtime was determined to be tens of seconds (essentially, the reboot time). Even stricter requirements are imposed on the network: its bandwidth should not drop for more than 10–20 seconds. Unsurprisingly, the most critical failures identified by respondents were storage system outages. From the perspective of business representatives, downtime of the storage systems should not exceed... several seconds a year!
In other words, if a bank's client application is unresponsive for 100 seconds, it is unlikely to cause catastrophic consequences. However, if the storage system is down for the same amount of time, business halts and significant financial losses are probable.
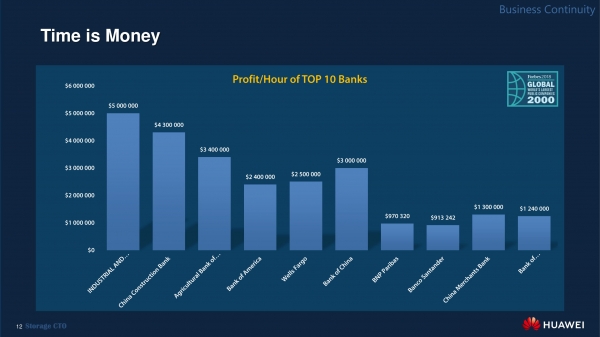
The diagram above shows the hourly operational costs for ten largest banks (data from Forbes in 2017). Agree, if your company approaches the size of Chinese banks, justifying the need to acquire a storage system for several million dollars will not be particularly difficult. The reverse statement is also true: if a business does not incur significant losses during downtime, it is unlikely to invest in high-end storage systems. In any case, it is important to have an understanding of how big the hole may form in your wallet while the sysadmin deals with the failed storage system.
One second for emergency switch-over
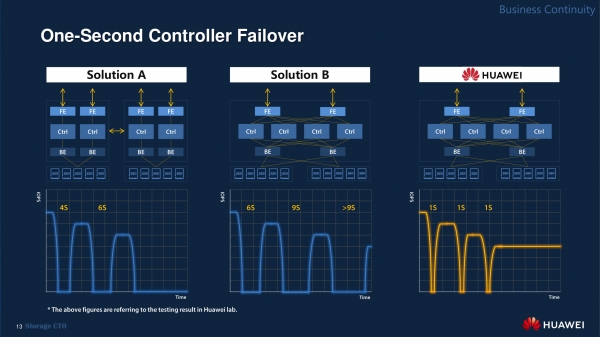
In Solution A, as illustrated above, you can see our previous generation system, Dorado V3. Its four controllers operate in pairs, and cache copies are maintained only in two controllers. Controllers within a pair can redistribute the load. At the same time, as you can see, there are no "factories" for frontend and backend, so each shelf with drives connects to a specific controller pair.
În diagrama Soluției B este prezentată o soluție actuală pe piață de la alt furnizor (ai recunoscut-o?). Aici există atât fabrici frontend, cât și backend, iar unitățile de stocare sunt conectate direct la patru controlere. Totuși, în funcționarea algoritmilor interni ai sistemului există nuanțe care nu sunt evidente la prima vedere.
În dreapta este prezentată arhitectura noastră actuală a SFA Dorado V6 cu întreaga gamă de elemente interne. Să analizăm cum aceste sisteme reacționează la o situație tipică — defectarea unuia dintre controlere.
În sistemele clasice, cum ar fi Dorado V3, perioada necesară pentru redistribuirea sarcinii în cazul unei defecțiuni ajunge până la patru secunde. În acest timp, intrările și ieșirile sunt complet suspendate. În soluția Soluției B de la colegii noștri, în ciuda unei arhitecturi mai moderne, timpul de nefuncționare în caz de defecțiune este chiar mai mare — șase secunde.
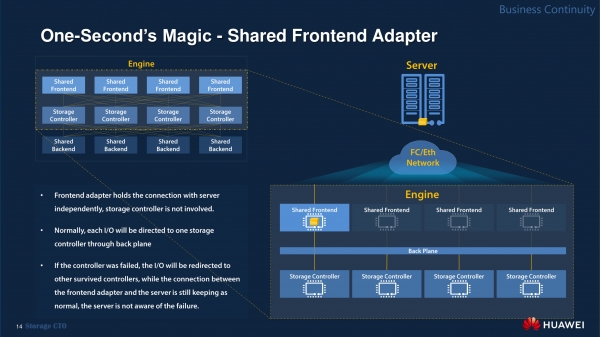
SFA Dorado V6 își restabilește funcționarea în doar o secundă după o defecțiune. Acest rezultat este obținut datorită unei medii interne RDMA uniforme, care permite controlerului să acceseze memoria 'străină'. Un alt aspect important este existența fabricii frontend, care menține ruta pentru gazdă constantă. Portul rămâne același, iar sarcina este pur și simplu trimisă către controlerele funcționale prin intermediul driverilor de multipassing.
Defecțiunea celui de-al doilea controler în Dorado V6 se gestionează în aceeași schemă în decurs de o secundă. La Dorado V3, acest lucru durează aproximativ șase secunde, iar soluția de la alt furnizor — nouă. Pentru multe SGBD-uri, astfel de intervale nu mai pot fi considerate acceptabile, deoarece în acest timp sistemul trece în modul de standby și încetează să funcționeze. Acest lucru se referă în primul rând la SGBD-uri care constau din mai multe volume.
Defecțiunea celui de-al treilea controler în Soluția A nu poate fi suportată. Pur și simplu din cauza faptului că se pierde accesul la o parte din discurile cu date. În schimb, Soluția B în această situație își restabilește funcționalitatea, la fel ca în cazul anterior, în nouă secunde.
Ce se întâmplă cu Dorado V6? O secundă.
Ce se poate face într-o secundă
Aproape nimic, dar nu avem nevoie de mai mult. Reiterăm că în Dorado V6, clasa hi-end, fabrica frontend-ului este separată de fabrica controllerelor. Asta înseamnă că nu există porturi strict dedicate unui anumit controller. Reconstrucția în caz de defecțiune nu implică căutarea unor căi alternative sau reinițializarea multipass-ului. Sistemul continuă să funcționeze așa cum a funcționat.
Rezistență la numeroase defecțiuni
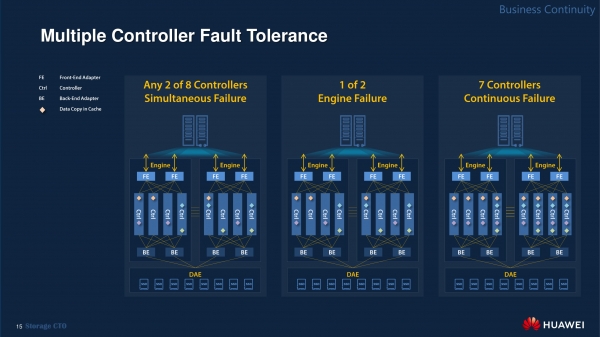
Modelele superioare Dorado V6 fac față fără probleme simultanei defecțiuni a două oricărui (!) controlere din componenta oricăror „motoare”. Acest lucru a fost posibil deoarece soluția acum păstrează trei copii ale cache-ului. Prin urmare, chiar și în cazul unei defecțiuni duble, se va găsi întotdeauna o copie integrală.
Defecțiunea sincronă a tuturor celor patru controlere din unul dintre „motoare” nu va cauza efecte fatale, deoarece toate cele trei copii ale cache-ului sunt distribuite în fiecare moment între „motoare”. Sistemul monitorizează respectarea acestei logici de funcționare.
În cele din urmă, un scenariu foarte puțin probabil este defecțiunea succesivă a șapte controlere din opt. Intervalul minim acceptabil pentru menținerea funcționării între defecțiuni individuale este de 15 minute. În acest timp, sistemul de stocare reușește să execute operațiile necesare pentru migrarea cache-ului.
Ultimul controller rămas va asigura funcționarea stocării de date și va menține cache-ul timp de cinci zile (valoarea implicită, care poate fi ușor modificată în setări). După aceasta, cache-ul va fi dezactivat, dar funcționarea sistemului de stocare va continua.
Actualizări care nu deranjează
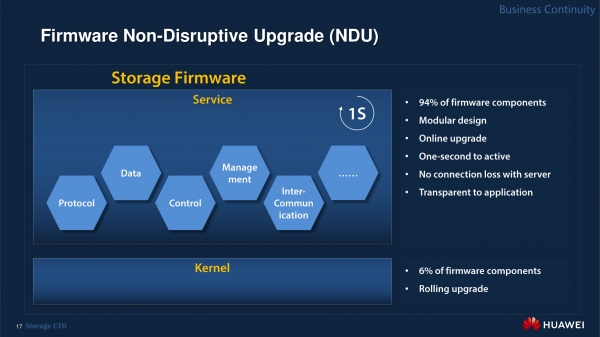
Noul sistem de operare Dorado V6 permite actualizarea firmware-ului sistemului de stocare fără a reporni controllerele.
Sistemul de operare, la fel ca în cazul soluțiilor anterioare, este bazat pe Linux, însă multe procese operaționale au fost mutate din nucleu în modul utilizator. Majoritatea funcțiilor, cum ar fi cele responsabilă de deduplicare și compresie, sunt acum demoni care rulează în fundal. Datorită acestui fapt, pentru actualizarea modulelor individuale nu este nevoie să schimbi întregul sistem de operare. De exemplu, pentru a adăuga suport pentru un nou protocol, va trebui doar să opriți modulul software corespunzător și să lansați noul.
Este clar că întrebările legate de actualizarea sistemului rămân, deoarece și nucleul poate conține elemente care necesită actualizare. Totuși, din observațiile noastre, acestea reprezintă mai puțin de 6% din total. Acest lucru permite repornirea controlerelor de zeci de ori mai rar decât înainte.
Soluții rezistente la catastrofe și soluții de înaltă disponibilitate (HA/DR)
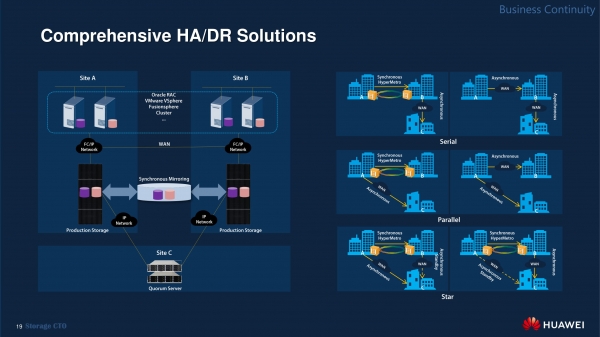
Dorado V6 este pregătită „din cutie” pentru integrarea în soluții geo-distribuite, clustere la nivelul orașului (metro) și centre de date „triple”.
În stânga, în ilustrația de mai sus, se află deja cunoscutul metro-cluster. Două stocări de date funcționează în modul active/active la o distanță de până la 100 km una de cealaltă. O astfel de infrastructură, având unul sau mai multe servere de quorum, poate fi suportată de soluții ale diferitelor companii, inclusiv sistemul nostru de operare cloud FusionSphere. Caracteristicile canalului dintre locații devin deosebit de importante în aceste proiecte, toate celelalte sarcini fiind preluate de funcția HyperMetro, disponibilă, din nou, „din cutie”. Este posibilă integrarea prin Fibre Channel, dar și prin iSCSI în rețele IP, dacă apare o astfel de necesitate. Nu mai este nevoie de o opticǎ „întunecată” dedicată, deoarece sistemul poate comunica prin canalele existente.
La construirea unor astfel de sisteme, singura cerință hardware pentru stocare este să aloce porturi pentru replicare. Este suficient să achiziționezi o licență, să lansezi serverele de quorum - fizice sau virtuale - și să asiguri conectivitate IP către controlere (10 Mbit/s, 50 ms).
Această arhitectură poate fi ușor adaptată la un sistem cu trei centre de date (vezi partea dreaptă a ilustrației). De exemplu, când două centre de date funcționează în modul metro-cluster, iar a treia locație, situată la o distanță de peste 100 km, folosește replicarea asincronă.
Sistemul susține tehnologii diverse pentru diferite scenarii de afaceri, care vor fi implementate în cazul unui exces major.
Sustenabilitatea metro-clusterului în caz de mai multe defecțiuni
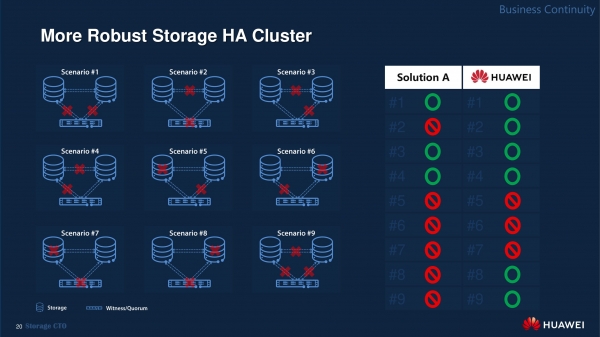
Mai sus și mai jos este prezentat, de asemenea, un metro-cluster clasic, format din două stocări și un server de quorum. După cum puteți observa, în șase din cele nouă scenarii posibile de defecțiuni multiple, infrastructura noastră va menține funcționalitatea.
De exemplu, în al doilea scenariu, în cazul în care serverul de quorum fail și sincronizarea între site-uri nu funcționează, sistemul rămâne productiv, deoarece cel de-al doilea site încetează activitatea. Un astfel de comportament este deja încorporat în algoritmii integrați.
Chiar și după trei eșecuri, accesul la informații poate fi păstrat, dacă intervalul dintre ele a fost de cel puțin 15 secunde.
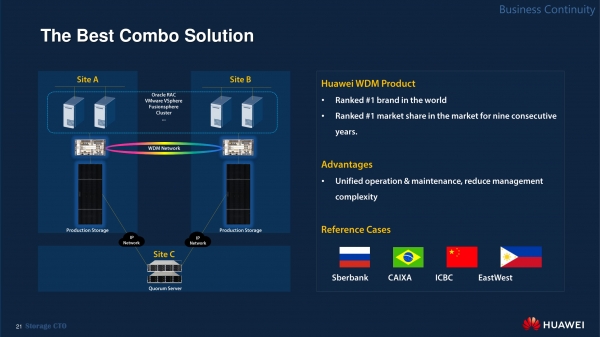
Asul din mânecă
Reamintim că Huawei produce nu doar storage-uri, ci și o gamă completă de echipamente de rețea. Indiferent de furnizorul de storage pe care îl alegeți, dacă între site-uri se utilizează o rețea WDM, în 90% din cazuri aceasta va fi construită pe soluțiile companiei noastre. Se ridică întrebarea inevitabilă: de ce să aduni un zoo de sisteme, când tot „hardware-ul” garantat compatibil poate fi obținut de la un singur furnizor?
Despre performanță
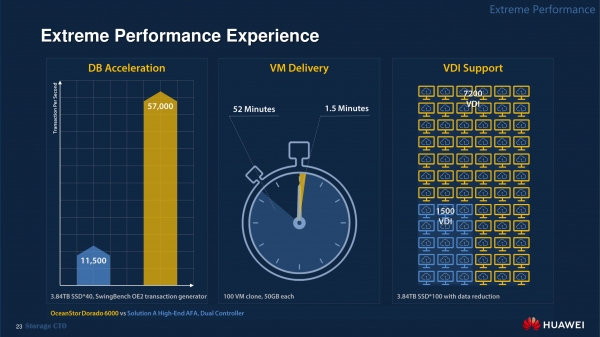
Probabil că nimeni nu mai trebuie să convingă pe cineva că trecerea la storage-uri All-Flash permite reducerea semnificativă a cheltuielilor pentru întreținerea infrastructurii, deoarece toate operațiunile de rutină sunt efectuate de câteva ori mai repede. Toți furnizorii de echipamente similare confirmă acest lucru. Între timp, mulți furnizori încep să fie evazivi atunci când vine vorba de scăderea performanței la activarea diferitelor moduri de funcționare ale storage-urilor.
În domeniul nostru, este o practică comună ca storage-urile să fie oferite pentru testare timp de una-două zile. Furnizorul rulează un test de 20 de minute pe un sistem gol, obținând rezultate impresionante de performanță. Dar în exploatarea reală, apar rapid „capcanele ascunse”. Deja după o zi, valorile frumoase ale IOPS se reduc la jumătate sau chiar la o treime, iar dacă storage-ul este umplut la 80%, devin și mai mici. Activarea RAID 5 în loc de RAID 10 pierde încă 10-15%, iar în modul metro-cluster, performanța se reduce și mai mult.
Tot ce este enumerat mai sus nu se aplică la Dorado V6. Clienții noștri au posibilitatea de a efectua un test de performanță în weekend sau cel puțin pe timpul nopții. Atunci se manifestă procesul de colectare a deșeurilor, iar activarea diferitelor opțiuni — precum snapshot-urile și replicarea — devine clară în ceea ce privește impactul asupra valorii IOPS obținute.
În Dorado V6, instantaneele și RAID-ul cu paritate au un impact practic neglijabil asupra performanței (3–5% în loc de 10-15%). Colectarea de gunoaie (umplerea celulelor de stocare cu zerouri), compresia, deduplicarea pe sistemul de stocare, când este ocupat în proporție de 80%, vor influența întotdeauna viteza generală de procesare a cererilor. Dar ceea ce face Dorado V6 interesant este că, indiferent de combinația de funcții și mecanisme de protecție pe care le activați, performanța finală a sistemului de stocare nu va scădea sub 80% din valoarea obținută fără sarcină.
Încărcarea echilibrată
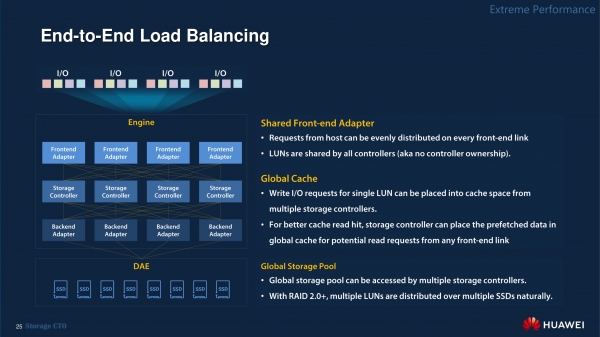
Performanța ridicată a Dorado V6 este obținută prin echilibrarea la fiecare etapă, și anume:
- multipassing;
- utilizarea mai multor conexiuni dintr-un singur gazd;
- prezența unei fabrici frontend;
- paralelizarea activității controlerelor de stocare;
- distribuția sarcinii pe toate dispozitivele de stocare la nivel RAID 2.0+.
În principiu, aceasta este o practică comună. În zilele noastre, puțini păstrează toate datele pe un singur LUN: toată lumea încearcă să aibă fie opt, fie patruzeci, sau chiar mai mult. Aceasta este o abordare evidentă și corectă, pe care o împărtășim. Dar dacă sarcina dvs. necesită un singur LUN, care este mai ușor de întreținut, soluțiile noastre arhitecturale permit obținerea unei performanțe de 80% din cea disponibilă utilizând mai multe LUN-uri.
Planificarea dinamică a încărcării procesoarelor
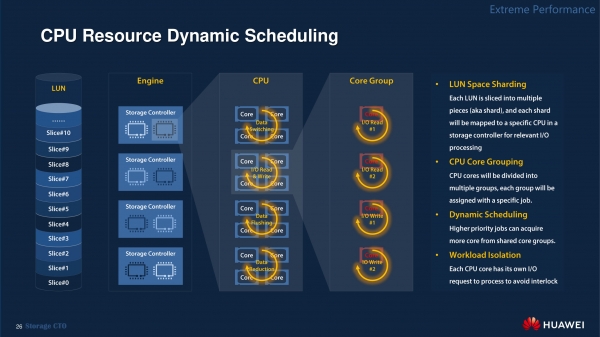
Distribuția sarcinii pe procesoare la utilizarea unui singur LUN este implementată astfel: sarcinile sunt împărțite la nivel de LUN în «shard-uri» mici, fiecare dintre ele fiind asociate rigid cu un anumit controler în «motor». Acest lucru este realizat pentru a preveni pierderea performanței în timp ce sistemul «sara» cu acest fragment de date între diferitele controlere.
Un alt mecanism de păstrare a performanței ridicate este programarea dinamică, în care nucleele de procesor pot fi alocate pentru diverse grupuri de sarcini. De exemplu, dacă în prezent sistemul este inactiv la nivel de deduplicare și compresie, o parte a nucleelor poate fi activată pentru a gestiona intrarea-ieșirea. Sau invers. Toate acestea se realizează automat și transparent pentru utilizator.
Datele despre încărcarea curentă a fiecărui nucleu Dorado V6 nu sunt afișate în interfața grafică, dar prin linia de comandă se poate accesa OS-ul controlerului și se poate utiliza comanda habituală Linux. top.
Suport NVMe și RoCE
Așa cum s-a menționat deja, în prezent, Dorado V6 suportă complet NVMe over Fibre Channel 'din cutie' și nu necesită licențe. La mijlocul anului, va apărea suportul pentru modul NVMe over Ethernet. Pentru utilizarea completă a acestuia, este necesar un suport Ethernet cu acces direct în memorie (DMA) versiunea v2.0 atât din partea sistemului de stocare, cât și din partea comutatoarelor și adaptorilor de rețea. De exemplu, precum Mellanox ConnectX-4 sau ConnectX-5. De asemenea, pot fi utilizate plăcile de rețea bazate pe cipurile noastre. Suportul RoCE ar trebui să fie implementat la nivelul sistemului de operare.
În general, considerăm că Dorado V6 este un sistem orientat spre NVMe. În ciuda suportului existent pentru Fibre Channel și iSCSI, se planifică o tranziție către Ethernet cu viteză mare și RDMA.
O fărâmă de marketing
Datorită faptului că sistemul Dorado V6 are o mare rezistență la defecțiuni, se scalează bine pe orizontală, suportă diverse tehnologii de migrare etc., efectul economic al achiziționării acestuia se face simțit odată cu începerea utilizării intensive a sistemului de stocare. Vom continua să ne străduim să facem deținerea sistemului cât mai profitabilă, chiar dacă în prima etapă nu este vizibil.
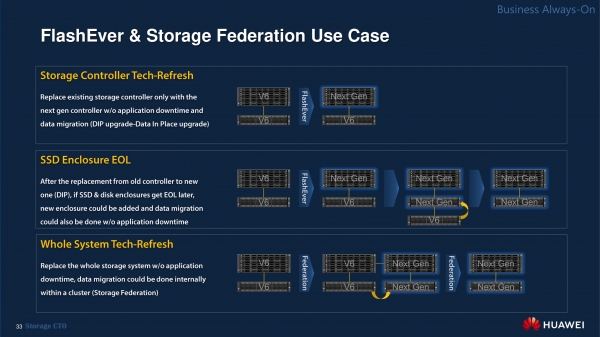
În special, am creat programul FLASH EVER, legat de extinderea ciclului de viață al sistemului de stocare și conceput pentru a reduce cât mai mult posibil sarcina clientului în timpul actualizărilor.
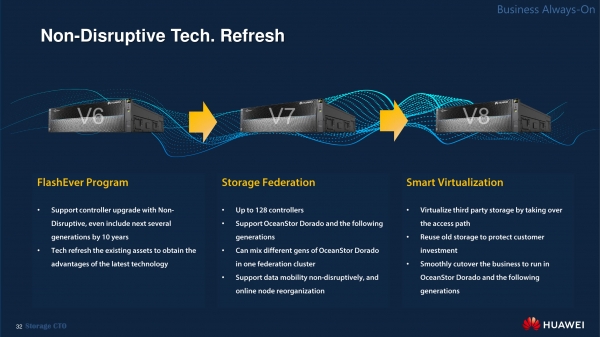
Această programă include o serie de măsuri:
- posibilitatea înlocuirii treptate a controlerelor și rafturilor cu discuri cu versiuni noi fără a înlocui echipamentele în întregime (pentru sistemele Dorado V6 din gama hi-end);
- posibilitatea stocării federative (combinarea diferitelor versiuni Dorado într-un singur cluster hibrid al sistemului de stocare);
- virtualizare inteligentă (posibilitatea de a utiliza echipamente ale terțelor părți ca parte a soluției Dorado).
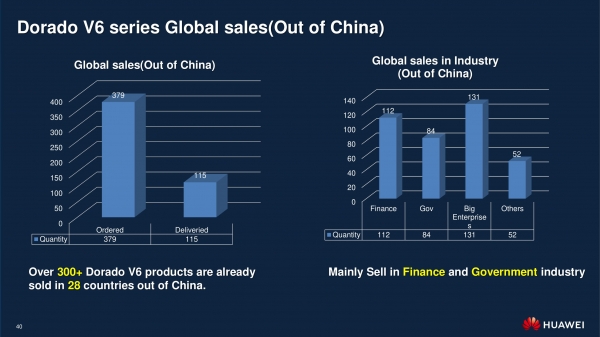
Să menționăm că situația complicată din lume a avut un impact minim asupra perspectivelor comerciale ale noului sistem. Deși lansarea oficială a Dorado V6 a avut loc abia în ianuarie, vedem o cerere semnificativă pentru acesta în China, precum și un interes mare din partea partenerilor ruși și internaționali din domeniul financiar și din structurile guvernamentale.
Pe lângă altele, în contextul pandemiei, oricât ar dura aceasta, se pune cu atât mai urgent problema asigurării angajaților de la distanță cu birouri virtuale. În acest proces, Dorado V6 ar putea de asemenea să rezolve multe dintre aceste întrebări. În acest scop, depunem toate eforturile necesare, inclusiv am ajuns practic la un acord pentru includerea noului sistem în lista de compatibilitate VMware.
***
Apropo, nu uitați de numeroasele noastre webinarii, care se desfășoară nu doar în segmentul rusofon, ci și la nivel global. Lista webinariilor pentru aprilie este disponibilă la .
Sursa: habr.com
