

Salut, Habr! Vă prezint traducerea articolului autorii Burak Yavuz, Brenner Heintz și Denny Lee, care a fost pregătit înainte de începerea cursului de la OTUS.
Datele, la fel ca experiența noastră, se acumulează și evoluează constant. Pentru a nu rămâne în urmă, modelele noastre mentale despre lume trebuie să se adapteze la noi date, unele dintre ele conținând noi dimensiuni - noi modalități de a observa lucruri despre care anterior nu aveam cunoștință. Aceste modele mentale nu sunt foarte diferite de schemele de tabele, care determină modul în care clasificăm și procesăm noua informație.
Aceasta ne conduce la problema gestionării schemelor. Pe măsură ce cerințele și sarcinile de afaceri se schimbă în timp, structura datelor tale se schimbă. Delta Lake facilitează implementarea ușoară a noilor dimensiuni atunci când datele se schimbă. Utilizatorii au acces la o semantica simplă pentru gestionarea schemelor tabelelor lor. Aceste instrumente includ impunerea schemei (Schema Enforcement), care protejează utilizatorii de contaminarea neintenționată a tabelelor lor cu erori sau date nedorite, precum și evoluția schemei (Schema Evolution), care permite adăugarea automată de coloane noi cu date valoroase în locuri corespunzătoare. În acest articol, ne vom aprofunda în utilizarea acestor instrumente.
Înțelegerea schemelor de tabele
Fiecare DataFrame din Apache Spark conține o schemă care definește forma datelor, cum ar fi tipurile de date, coloanele și metadatele. Cu Delta Lake, schema tabelei este păstrată în format JSON în cadrul jurnalului de tranzacții.
Ce este impunerea schemei?
Impunerea schemei (Schema Enforcement), cunoscută și sub denumirea de validarea schemei (Schema Validation), este un mecanism de protecție în Delta Lake care garantează calitatea datelor, respingând înregistrările care nu se conformează schemei tabelei. La fel ca o gazdă la recepția unui restaurant popular, care acceptă doar rezervări, aceasta verifică dacă fiecare coloană de date introdusă în tabel se află în lista corespunzătoare de coloane așteptate (cu alte cuvinte, dacă fiecare are „rezervare”), și respinge orice înregistrări cu coloane care nu sunt în listă.
Cum funcționează impunerea schemei?
Delta Lake utilizează validarea schemelor la scriere, ceea ce înseamnă că toate noile înregistrări în tabel sunt verificate pentru compatibilitate cu schema tabelului țintă în timpul scrierii. Dacă schema nu este compatibilă, Delta Lake anulează complet tranzacția (datele nu sunt scrise) și generează o excepție pentru a informa utilizatorul despre neconcordanță.
Pentru a determina compatibilitatea înregistrării, Delta Lake utilizează următoarele reguli. DataFrame-ul scris:
- nu poate conține coloane suplimentare care nu sunt în schema tabelului țintă. Și invers, totul este în regulă dacă datele de intrare nu conțin toate coloanele din tabel — acestor coloane li se vor atribui valori nule.
- nu poate avea tipuri de date ale coloanelor care diferă de tipurile de date ale coloanelor din tabelul țintă. Dacă o coloană din tabelul țintă conține date de tip StringType, dar coloana corespunzătoare din DataFrame conține date de tip IntegerType, aplicarea forțată a schemei va genera o excepție și va împiedica executarea operației de scriere.
- nu poate conține nume de coloane care diferă doar prin caz. Asta înseamnă că nu poți avea coloane cu numele 'Foo' și 'foo' definite în același tabel. Deși Spark poate fi utilizat într-un mod care distinge sau nu distinge cazurile (implicite), Delta Lake păstrează cazul, dar este insensibil în cadrul stocării schemei. Parquet este sensibil la caz la stocare și returnarea informațiilor despre coloană. Pentru a evita posibile erori, coruperea datelor sau pierderea acestora (cu care ne-am confruntat personal în Databricks), am decis să adăugăm această restricție.
Pentru a ilustra acest lucru, să ne uităm la ceea ce se întâmplă în codul de mai jos atunci când încercăm să adăugăm unele coloane recent generate în tabelul Delta Lake, care nu este încă configurat pentru a le accepta.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
În loc să adauge automat coloanele noi, Delta Lake impune schema și oprește scrierea. Pentru a ajuta la identificarea coloanei (sau coloanelor) care cauzează neconcordanța, Spark afișează ambele scheme din stiva de erori pentru comparație.
Care este beneficiul aplicării forțate a schemei?
Deoarece aplicarea forțată a schemei reprezintă un control destul de strict, aceasta este un instrument excelent pentru a fi utilizat ca un gardian al unui set de date curat, complet transformat, gata pentru producție sau consum. De obicei, este aplicat tabelor care oferă date în mod direct:
- Algoritmilor de învățare automată
- Dashboard-urilor BI
- Analizei datelor și instrumentelor de vizualizare
- Oricărei sisteme de producție care necesită scheme semantice strict structurate și tipizate.
Pentru a-și pregăti datele pentru această barieră finală, mulți utilizatori folosesc o arhitectură simplă „multi-hop” care aduce treptat structură în tabelele lor. Pentru a afla mai multe despre aceasta, puteți consulta articolul
Desigur, aplicarea forțată a schemei poate fi utilizată oriunde în pipeline-ul dumneavoastră, dar țineți cont că scrierea în flux într-un tabel în acest caz poate fi frustrantă, deoarece, de exemplu, ați uitat că ați adăugat o coloană suplimentară în datele de intrare.
Prevenirea diluării datelor
Până în acest punct, vă puteți întreba de ce atâta agitație? La urma urmei, uneori, o eroare neașteptată de „necorespundere a schemei” vă poate împiedica în fluxul de lucru, mai ales dacă sunteți nou în Delta Lake. De ce să nu permit doar schemei să se schimbe astfel încât să pot salva DataFrame-ul meu, indiferent de situație?
Așa cum spune vechea zicală, „o uncie de prevenție valorează o livră de tratament”. La un moment dat, dacă nu vă ocupați de aplicarea schemei, problemele de compatibilitate a tipurilor de date își vor ridica capul urât — surse aparent omogene de date brute pot conține cazuri limită, coloane deteriorate, mapări prost formate sau alte lucruri terifiante care bântuie coșmarurile. Cea mai bună abordare este să opriți acești dușmani la poartă — prin aplicarea forțată a schemei — și să vă ocupați de ei la lumină, nu mai târziu, când încep să hoinărească în adâncurile întunecate ale codului dumneavoastră de lucru.
Aplicarea forțată a schemei asigură că schema tabelului nu se va schimba, decât dacă confirmați personal variația modificării. Aceasta previne "diluația" datelor, care poate apărea atunci când coloanele noi sunt adăugate atât de des încât tabelele valoroase, compacte își pierd semnificația și utilitatea din cauza inundației de date. Încurajându-vă să fiți intenționat, să stabiliți standarde ridicate și să așteptați calitate înaltă, aplicarea forțată a schemei face exact ceea ce a fost destinat — ajutându-vă să rămâneți de bună-credință, iar tabelele dumneavoastră să rămână curate.
Dacă, în urma unei examinări ulterioare, decideți că de fapt nevoie doriți să adăugați o coloană nouă — nicio problemă, mai jos este o soluție pe o linie. Soluția este evoluția schemei!
Ce este evoluția schemei?
Evoluția schemei este o funcție care le permite utilizatorilor să modifice cu ușurință schema actuală a tabelului în conformitate cu datele care se schimbă în timp. Este cel mai des utilizată în operațiuni de adăugare sau scriere, pentru a adapta automat schema pentru a include una sau mai multe coloane noi.
Cum funcționează evoluția schemei?
Urmând exemplul din secțiunea anterioară, dezvoltatorii pot utiliza cu ușurință evoluția schemei pentru a adăuga coloane noi care au fost anterior respinse din cauza neconcordanței cu schema. Evoluția schemei este activată prin adăugarea .option('mergeSchema', 'true') la comanda dumneavoastră Spark .write sau .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Pentru a vizualiza schema, rulați următoarea interogare Spark SQL
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 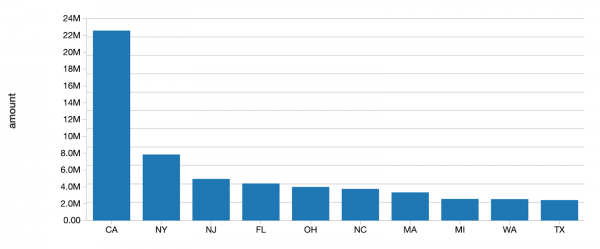
Ca alternativă, puteți seta această opțiune pentru întreaga sesiune Spark, adăugând spark.databricks.delta.schema.autoMerge = True în configurația Spark. Dar folosiți această opțiune cu precauție, deoarece aplicarea forțată a schemei nu vă va mai avertiza despre neconcordanțele neintenționate cu schema.
Prin adăugarea parametrului mergeSchema, toate coloanele care sunt prezente în DataFrame, dar lipsesc în tabelul țintă, sunt adăugate automat la sfârșitul schemei în cadrul tranzacției de scriere. De asemenea, pot fi adăugate câmpuri încorporate, iar acestea vor fi adăugate și la sfârșitul coloanelor respective ale structurii.
Inginerii și cercetătorii pot folosi această opțiune pentru a adăuga coloane noi (posibil o metrică recent urmărită sau o coloană cu indicatorii vânzărilor din această lună) în tabelele existente de producție pentru învățarea automată, fără a afecta modelele existente, bazate pe coloanele mai vechi.
Următoarele tipuri de modificări ale schemei sunt acceptabile în cadrul evoluției schemei în timpul adăugării sau rescrierii unei tabele:
- Adăugarea de coloane noi (aceasta este cea mai comună situație)
- Modificarea tipurilor de date din NullType -> orice alt tip sau promovarea din ByteType -> ShortType -> IntegerType
Alte modificări, neacceptate în cadrul evoluției schemei, necesită ca schema și datele să fie rescrise prin adăugare .option("overwriteSchema", "true"). De exemplu, în cazul în care coloana „Foo” a fost inițial de tip integer, iar noua schemă ar fi de tip string, atunci toate fișierele Parquet (datele) ar trebui să fie rescrise. Aceste modificări includ:
- eliminarea coloanelor
- modificarea tipului de date al unei coloane existente (in situ)
- renumirea coloanelor care diferă doar prin caz (de exemplu, „Foo” și „foo”)
În cele din urmă, cu următoarea versiune Spark 3.0, va fi complet susținut DDL explicit (folosind ALTER TABLE), ceea ce va permite utilizatorilor să efectueze următoarele acțiuni asupra schemelor de tabele:
- adăugarea de coloane
- modificarea comentariilor asupra coloanelor
- configurarea proprietăților tabelei care definesc comportamentul tabelei, de exemplu, stabilirea duratei de păstrare a jurnalului de tranzacții.
Care este beneficiul evoluției schemei?
Evoluția schemei poate fi utilizată întotdeauna când intenționați să modificați schema tabelei dvs. (spre deosebire de cazurile în care ați adăugat accidental coloane în DataFrame-ul dvs. care nu ar fi trebuit să fie acolo). Aceasta este cea mai simplă metodă de a migra schema dvs., deoarece adaugă automat numele corecte ale coloanelor și tipurile de date fără a necesita declarația lor explicită.
Concluzie
Aplicarea forțată a schemei respinge orice coloane noi sau alte modificări ale schemei care nu sunt compatibile cu tabelul dumneavoastră. Stabilind și menținând aceste standarde ridicate, analiștii și inginerii pot avea încredere că datele lor au cea mai înaltă integritate, permițându-le să ia decizii de afaceri mai eficiente.
Pe de altă parte, evoluția schemei completează aplicarea forțată, simplificând modificările presupuse automate ale schemei. La urma urmei, nu ar trebui să fie o dificultate — adăugarea unei coloane.
Aplicarea forțată a schemei este yang, în timp ce evoluția schemei este yin. Folosite împreună, aceste funcții facilitează supresia zgomotului și ajustarea semnalului.
De asemenea, am dori să mulțumim lui Mukul Murti și Pranav Anand pentru contribuția lor la acest articol.
Alte articole din această serie:
Articole conexe
Sursa: habr.com
