

Continuarea traducerii unei cărți mici:
„Understanding Message Brokers”,
autor: Jakub Korab, editura: O’Reilly Media, Inc., data publicării: iunie 2017, ISBN: 9781492049296.
Partea precedent tradusă:
CAPITOLUL 3
Kafka
Kafka a fost dezvoltată la LinkedIn pentru a ocoli unele dintre limitările tradiționalelor brokeri de mesaje și a evita necesitatea de a configura mai mulți brokeri de mesaje pentru diferite interacțiuni „punct la punct”, așa cum este descris în această carte în secțiunea „Scalabilitate verticală și orizontală” de pe pagina 28. Scenariile de utilizare în LinkedIn s-au bazat în principal pe absorbția unidirecțională a unor volume foarte mari de date, cum ar fi clicurile pe pagini și jurnalele de acces, permițând în același timp utilizarea acestor date de către mai multe sisteme, fără a afecta performanța producătorilor sau a altor consumatori. De fapt, motivul existenței Kafka este acela de a obține o arhitectură de schimb de mesaje, așa cum este descrisă în Universal Data Pipeline.
Având în vedere acest obiectiv final, s-au ivit și alte cerințe. Kafka trebuie să:
- Fie extrem de rapidă
- Oferă un throughput mare în gestionarea mesajelor
- Să susțină modelele „Publisher-Subscriber” și „Point-to-Point”
- Să nu se încetinească odată cu adăugarea consumatorilor. De exemplu, performanța atât a coadelor, cât și a topicelor în ActiveMQ se deteriorează pe măsură ce crește numărul de consumatori pe destinație
- Să fie scalabilă orizontal; dacă un broker care stochează (persists) mesaje poate face acest lucru doar la viteza maximă a discului, atunci are sens să ieșim din limitele unui singur exemplu de broker pentru a crește performanța
- Să limiteze accesul la stocare și reextracția mesajelor
Pentru a atinge toate acestea, Kafka adoptă o arhitectură care redefinește rolurile și responsabilitățile clienților și brokerilor de mesaje. Modelul JMS este foarte orientat spre broker, care este responsabil pentru distribuția mesajelor, iar clienții trebuie să se ocupe doar de trimiterea și primirea mesajelor. Kafka, pe de altă parte, este orientată spre client, clientul asumându-și multe funcții tradiționale ale brokerului, cum ar fi distribuirea corectă a mesajelor relevante între consumatori, obținând în schimb un broker extrem de rapid și scalabil. Pentru cei care au lucrat cu sisteme tradiționale de mesagerie, lucrul cu Kafka necesită schimbări fundamentale de mentalitate.
Această direcție de inginerie a dus la crearea unei infrastructuri de mesagerie capabilă să crească cu multe ordine de mărime lățimea de bandă comparativ cu un broker obișnuit. Așa cum vom vedea, această abordare vine cu compromisuri, ceea ce înseamnă că Kafka nu este potrivită pentru anumite tipuri de sarcini și software stabilit.
Modelul unificat de destinație
Pentru a îndeplini cerințele descrise mai sus, Kafka a combinat mesageria de tip „publicare-abonare” și „punct-la-punct” într-un singur tip de destinație — subiect. Acest lucru îi confundă pe cei care au lucrat cu sisteme de mesagerie, unde termenul „subiect” se referă la un mecanism de difuzare, din care (din subiect) citirea nu este fiabilă (este nondurabil). Subiectele din Kafka ar trebui considerate un tip hibrid de destinație, conform definiției date în introducerea acestei cărți.
În restul acestui capitol, dacă nu indicăm altfel, termenul „subiect” se va referi la subiectul Kafka.
Pentru a înțelege pe deplin cum se comportă subiectele și ce garanții oferă, trebuie mai întâi să examinăm cum sunt implementate în Kafka.
Fiecare subiect din Kafka are propriul jurnal.
Producătorii care trimit mesaje în Kafka adaugă aceste mesaje în jurnal, iar consumatorii citesc din jurnal folosind indicatoare care se deplasează constant înainte. Periodic, Kafka șterge cele mai vechi părți ale jurnalului, indiferent dacă mesajele din aceste părți au fost citite sau nu. O componentă centrală a designului Kafka este că brokerul nu se preocupă de faptul că mesajele au fost citite sau nu - aceasta este responsabilitatea clientului.
Termenii „jurnal” și „indicător” nu sunt întâlniți în . Acești termeni bine cunoscuți sunt folosiți aici pentru a ajuta la înțelegere.
Această modelare este complet diferită de ActiveMQ, unde mesajele din toate cozi sunt stocate într-un singur jurnal, iar brokerul marchează mesajele ca fiind șterse după ce au fost citite.
Să ne aprofundăm acum și să discutăm despre jurnalul unui topic mai în detaliu.
Jurnalul Kafka constă din mai multe partiții (). Kafka garantează o ordonare strictă în fiecare partiție. Aceasta înseamnă că mesajele scrise într-o partiție într-o anumită ordine vor fi citite în aceeași ordine. Fiecare partiție este implementată sub forma unui fișier de jurnal ciclic (rolling) care conține un subset (subset) al tuturor mesajelor trimise către topic de producătorii săi. Topicul creat conține, în mod implicit, o partiție. Ideea de partiții este conceptul central al Kafka pentru scalarea orizontală.
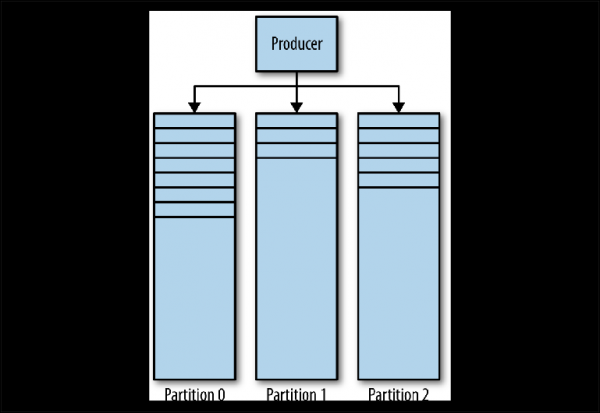
Figura 3-1. Partițiile Kafka
Când un producător trimite un mesaj într-un topic Kafka, decide în care partiție să trimită mesajul. Vom discuta despre acest lucru mai în detaliu mai târziu.
Citirea mesajelor
Clientul care dorește să citească mesajele gestionează un indicător numit grup de consumatori (consumer group), care indică deplasamentul (offset) mesajului din partiție. Deplasamentul este o poziție cu un număr crescător care începe de la 0 la începutul partiției. Acest grup de consumatori, la care se face referire în API printr-un identificator group_id definit de utilizator, corespunde unui consumator sau sistem logic..
Cele mai multe sisteme care utilizează mesagerie citesc datele din adresa destinatarului prin intermediul mai multor instanțe și fluxuri pentru procesarea paralelă a mesajelor. Astfel, de obicei, vor exista multe instanțe de consumatori care partajează același grup de consumatori.
Problema citirii poate fi prezentată astfel:
- Un topic are mai multe partiții
- Mai multe grupuri de consumatori pot folosi un topic simultan
- Un grup de consumatori poate avea mai multe instanțe separate
Aceasta este o problemă netrivială de tip „mulți la mulți”. Pentru a înțelege cum gestionează Kafka relațiile dintre grupurile de consumatori, instanțele de consumatori și partiții, să analizăm o serie de scenarii de citire care devin treptat mai complexe.
Consumatori și grupuri de consumatori
Să luăm ca punct de plecare un topic cu o singură partiție ().
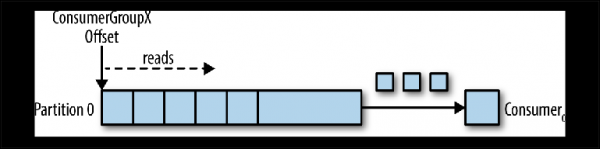
Figura 3-2. Consumatorul citește din partiție
Când o instanță de consumator se conectează cu propriul său group_id la acest topic, îi este alocată o partiție pentru citire și un offset în acea partiție. Poziția acestui offset este configurată în client ca un pointer către cea mai recentă poziție (cel mai nou mesaj) sau cea mai veche poziție (cel mai vechi mesaj). Consumatorul solicită (polls) mesaje din topic, ceea ce duce la citirea secvențială a acestora din jurnal.
Poziția offset-ului este comisă periodic înapoi în Kafka și este păstrată, ca mesaje în topicul intern _consumer_offsets. Mesajele citite totuși nu sunt eliminate, spre deosebire de un broker obișnuit, iar clientul poate derula (rewind) offset-ul pentru a reprocessa mesajele deja vizualizate.
Când un al doilea consumator logic se conectează, folosind un alt group_id, el gestionează un al doilea pointer, care nu depinde de primul (). Astfel, topicul Kafka funcționează ca o coadă, în care există un singur consumator și, ca un topic obișnuit de tip publisher-subscriber (pub-sub), la care sunt abonați mai mulți consumatori, având avantajul suplimentar că toate mesajele sunt păstrate și pot fi procesate de mai multe ori.
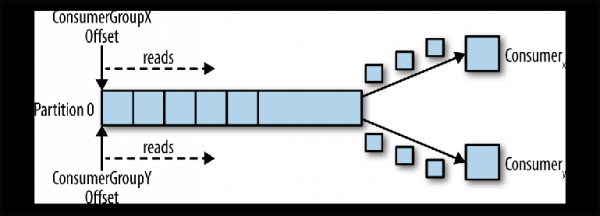
Figura 3-3. Doi consumatori din grupuri de consumatori diferite citesc din aceeași partiție
Consumatori în grupul de consumatori
Când o instanță a consumatorului citește date dintr-o partiție, aceasta controlează complet pointerul și procesează mesajele, așa cum a fost descris în secțiunea anterioară.
Dacă mai multe instanțe ale consumatorilor au fost conectate cu același group_id la un topic care are o partiție, atunci instanței care s-a conectat ultima îi va fi transferat controlul asupra pointerului, iar de atunci înainte va primi toate mesajele ().
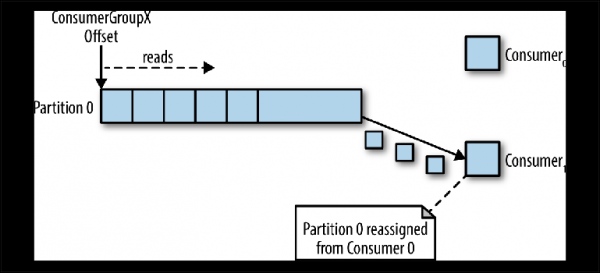
Figura 3-4. Două consumatoare din aceeași grupă de consumatori citesc din aceeași partiție
Acest mod de procesare, în care numărul de instanțe ale consumatorilor depășește numărul de partiții, poate fi considerat o variație a consumatorului monopol. Acest lucru poate fi util dacă ai nevoie de o clasterizare „activ-în așteptare” (sau „plictisită-călduță”) a instanțelor tale de consumatori, deși funcționarea paralelă a mai multor consumatori („activ-activ” sau „plictisită-plictisită”) este mult mai tipică decât consumatorii în modul de așteptare.
Comportamentul de distribuție a mesajelor descris mai sus poate fi surprinzător în comparație cu modul în care funcționează o coadă JMS obișnuită. În acest model, mesajele trimise într-o coadă vor fi distribuite uniform între cele două consumatoare.
Cel mai adesea, atunci când creăm mai multe instanțe ale consumatorilor, facem acest lucru fie pentru procesarea paralelă a mesajelor, fie pentru creșterea vitezei de citire, fie pentru îmbunătățirea rezilienței procesului de citire. Deoarece datele dintr-o partiție pot fi citite simultan doar de o singură instanță a consumatorului, cum se realizează acest lucru în Kafka?
Un mod de a face acest lucru este să folosești o singură instanță a consumatorului pentru a citi toate mesajele și a le trimite într-un pool de thread-uri. Deși această abordare crește capacitatea de procesare, sporește complexitatea logicii consumatorilor și nu îmbunătățește reziliența sistemului de citire. Dacă o instanță a consumatorului se oprește din cauza unei pene de curent sau a unui eveniment similar, citirea se oprește.
Modul canonical de a rezolva această problemă în Kafka este să folosești unOnumăr mai mare de partiții.
Partiționare
Partițiile sunt mecanismul principal pentru paralelizarea citirii și scalarea subiectului dincolo de capacitatea unui singur broker. Pentru a înțelege mai bine acest lucru, să analizăm situația în care există un subiect cu două partiții, iar un consumator se abonează la acest subiect ().
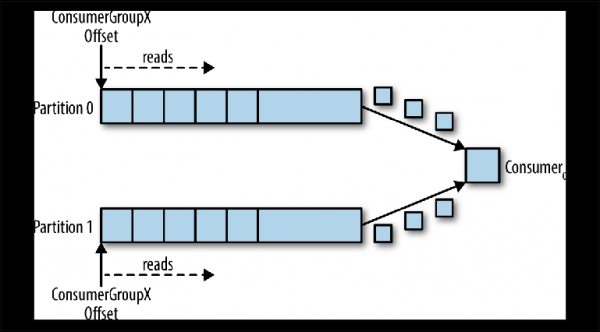
Figura 3-5. Un consumator citește din mai multe partiții
În acest scenariu, consumatorului i se oferă control asupra pointerilor corespunzători group_id-ului său în ambele partiții și începe citirea mesajelor din ambele partiții.
Când la acest subiect se adaugă un consumator suplimentar pentru același group_id, Kafka își reasignează (reallocate) una dintre partiții de la primul la al doilea consumator. După aceea, fiecare instanță a consumatorului va citi dintr-o partiție a subiectului ().
Pentru a asigura procesarea mesajelor în paralel în 20 de fire, aveți nevoie de cel puțin 20 de partiții. Dacă există mai puține partiții, veți avea consumatori care nu vor avea nimic de procesat, așa cum s-a discutat anterior în cazul consumatorilor monopol.
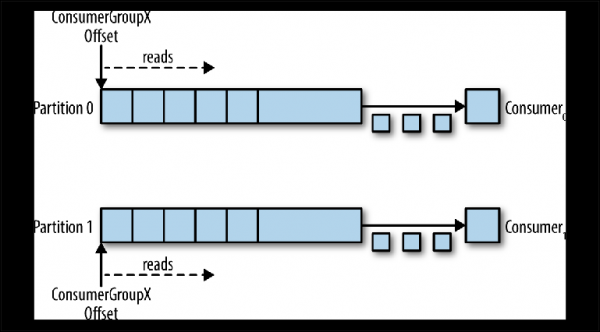
Figura 3-6. Doi consumatori din aceeași grupă de consumatori citesc din diferite partiții
Această schemă reduce semnificativ complexitatea funcționării brokerului Kafka comparativ cu distribuția mesajelor necesară pentru susținerea unei cozi JMS. Aici nu trebuie să vă faceți griji cu privire la următoarele aspecte:
- Care consumator ar trebui să primească următorul mesaj, pe baza distribuirii circulare (round-robin), a capacității curente a bufferelor de preluare sau a mesajelor anterioare (ca în cazul grupurilor de mesaje JMS).
- Ce mesaje au fost trimise către care consumatori și dacă acestea ar trebui să fie livrate din nou în caz de eșec.
Tot ceea ce trebuie să facă brokerul Kafka este să transmită în mod secvențial mesajele consumatorului, atunci când acesta le solicită.
Cu toate acestea, cerințele pentru paralelizarea citirii și retrimiterea mesajelor eșuate nu dispar — responsabilitatea pentru acestea se transferă simplu de la broker la client. Aceasta înseamnă că ele trebuie să fie considerate în codul dumneavoastră.
Trimiterea mesajelor
Responsabilitatea de a decide în care partiție să fie trimis un mesaj revine producerului acestui mesaj. Pentru a înțelege mecanismul prin care se face acest lucru, trebuie mai întâi să analizăm ce anume trimitem de fapt.
În timp ce în JMS folosim o structură de mesaj cu metadate (antete și proprietăți) și un corp care conține sarcina utilă (payload), în Kafka, un mesaj este un pereche „cheie-valoare”. Sarcina utilă a mesajului este trimisă ca valoare (value). Cheia, pe de altă parte, este folosită în principal pentru partajare și ar trebui să conțină o cheie specifică logicii de afaceri, astfel încât să plaseze mesajele corelate în aceeași partiție.
În Capitolul 2, am discutat scenariul pariurilor online, când evenimentele corelate trebuie să fie procesate în ordinea corectă de către un consumator:
- Contul utilizatorului este configurat.
- Banii sunt transferați în cont.
- Se face o pariu, care scoate bani din cont.
Dacă fiecare eveniment reprezintă un mesaj trimis într-un topic, în acest caz, cheia naturală va fi identificatorul contului.
Când un mesaj este trimis folosind Kafka Producer API, acesta este redirecționat către funcția de partajare, care, având în vedere mesajul și starea curentă a cluster-ului Kafka, returnează identificatorul partiției în care mesajul ar trebui să fie trimis. Această funcție este implementată în Java prin intermediul interfeței Partitioner.
Această interfață arată astfel:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementarea Partitioner pentru determinarea partiției folosește, în mod implicit, algoritmul de hashing al cheii (general-purpose hashing algorithm over the key) sau rotirea (round-robin), dacă cheia nu este specificată. Această valoare implicită funcționează bine în majoritatea cazurilor. Totuși, în viitor, poate doriți să scrieți propria metodă.
Scrierea propriei strategii de partajare
Să luăm un exemplu în care doriți să trimiteți metadate împreună cu sarcina utilă a mesajului. Sarcina utilă în exemplul nostru este instrucțiunea de a face un depozit în contul de joc. Instrucțiunea este ceea ce am dori să nu modificăm garantat în timpul transmiterii și vrem să ne asigurăm că doar sistemul de încredere superior poate iniția această instrucțiune. În acest caz, sistemele emitent și receptor se pun de acord să utilizeze o semnătură pentru a verifica autentificarea mesajului.
Într-un JMS obișnuit, pur și simplu definim proprietatea „semnătură a mesajului” și o adăugăm la mesaj. Cu toate acestea, Kafka nu ne oferă un mecanism pentru transmiterea metadatelor — doar cheie și valoare.
Deoarece valoarea reprezintă sarcina utilă a transferului bancar (bank transfer payload), integritatea căreia vrem să o menținem, nu avem altă opțiune decât să definim structura de date pentru utilizarea în cheie. Presupunând că avem nevoie de un identificator al contului pentru partitionare, deoarece toate mesajele referitoare la cont trebuie să fie procesate în ordine, vom veni cu următoarea structură JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Deoarece valoarea semnăturii va varia în funcție de sarcina utilă, strategia de hashing implicită a interfeței Partitioner nu va grupa în mod fiabil mesajele corelate. Prin urmare, va trebui să scriem propria noastră strategie care va analiza această cheie și va partitiona valoarea accountId.
Kafka include checksum-uri pentru a detecta deteriorarea mesajelor în stocare și are un set complet de funcții de securitate. Chiar și așa, uneori apar cerințe specifice industriei, cum ar fi cea menționată mai sus.
Strategia personalizată de partitionare trebuie să garanteze că toate mesajele corelate se vor afla în aceeași partiție. Deși aceasta pare simplă, cerința poate fi complicată de importanța ordonării mesajelor corelate și cât de fixat este numărul de partiții din topic.
Numărul de partiții din topic poate varia în timp, deoarece acestea pot fi adăugate dacă traficul depășește așteptările inițiale. Astfel, cheile mesajelor pot fi legate de partiția în care au fost trimise inițial, implicând o parte din starea care trebuie distribuită între instanțele producătorului.
Un alt factor de avut în vedere este uniformitatea distribuirii mesajelor între partiții. În general, cheile nu sunt distribuite uniform în mesaje, iar funcțiile de hash nu garantează o distribuție echitabilă a mesajelor pentru un set mic de chei.
Este important de menționat că, indiferent de modul în care decideți să împărțiți mesajele, separatorul în sine poate necesita reutilizare.
Să luăm în considerare cerința replicării datelor între clustere Kafka situate în diferite locații geografice. În acest scop, Kafka vine cu un instrument de linie de comandă numit MirrorMaker, care este utilizat pentru a citi mesajele dintr-un cluster și a le transmite într-un alt cluster.
MirrorMaker trebuie să înțeleagă cheile topicului replicat pentru a menține ordinea relativă între mesaje în timpul replicării între clustere, deoarece numărul de partitii pentru acest topic poate să nu coincidă între cele două clustere.
Strategiile personalizate de partizionare sunt relativ rare, deoarece hashingul sau rotirea implicită funcționează cu succes în majoritatea scenariilor. Cu toate acestea, dacă aveți nevoie de garanții stricte de ordonare sau trebuie să extrageți metadate din sarcinile utile, atunci partizionarea este ceva la care ar trebui să vă gândiți mai în detaliu.
Avantajele scalabilității și performanței Kafka sunt datorate transferării unor responsabilități tradiționale ale broker-ului către client. În acest caz, se ia decizia de a distribui mesaje potențial corelate între mai mulți consumatori care funcționează în paralel.
Brokerii JMS trebuie, de asemenea, să se ocupe de aceste cerințe. Interesant este că mecanismul de livrare a mesajelor corelate aceluiași consumator, realizat prin JMS Message Groups (un tip de strategie de echilibrare a încărcării sticky load balancing (SLB)), necesită, de asemenea, ca expeditorul să eticheteze mesajele ca fiind corelate. În cazul JMS, brokerul este responsabil pentru livrarea acestui grup de mesaje corelate unui consumator din mulți și pentru transferul dreptului de proprietate asupra grupului dacă consumatorul se întrerupe.
Acorduri pentru producător
Particionarea nu este singurul aspect de luat în considerare atunci când trimiteți mesaje. Să examinăm metodele send() ale clasei Producer din Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Este important de menționat că ambele metode returnează un Future, ceea ce indică faptul că operațiunea de trimitere nu se efectuează imediat. Drept urmare, mesajul (ProducerRecord) este înregistrat în buffer-ul de trimitere pentru fiecare partiție activă și este transmis brokerului printr-un fir de fundal în biblioteca clientului Kafka. Deși acest lucru face ca operațiunea să fie incredibil de rapidă, înseamnă că o aplicație prost scrisă poate pierde mesaje dacă procesul său se oprește.
Ca întotdeauna, există o modalitate de a face operațiunea de trimitere mai fiabilă în detrimentul performanței. Dimensiunea acestui buffer poate fi setată la 0, iar firul de trimitere al aplicației va fi forțat să aștepte până la finalizarea transmiterii mesajului către broker, după cum urmează:
RecordMetadata metadata = producer.send(record).get();Încă o dată despre citirea mesajelor
Citirea mesajelor are complexități suplimentare despre care trebuie să ne gândim. Spre deosebire de API-ul JMS, care poate lansa un listener de mesaje (message listener) în răspuns la sosirea unui mesaj, interfața Consumer Kafka doar interoghează (polling). Să examinăm mai în detaliu metoda poll (), folosită în acest scop:
ConsumerRecords poll(long timeout);Valoarea returnată de metodă este o structură deContainere care conține mai multe obiecte ConsumerRecord din potențial mai multe partiții. ConsumerRecord este el însuși un obiect holder pentru o pereche cheie-valoare cu metadate corespunzătoare, cum ar fi partiția din care a fost obținut.
Așa cum s-a discutat în Capitolul 2, trebuie să ne amintim constant ce se întâmplă cu mesajele după procesarea lor cu succes sau eșuată, de exemplu, dacă clientul nu poate procesa mesajul sau dacă se oprește. În JMS, acest lucru era gestionat prin modul de confirmare (acknowledgement mode). Brokerul va șterge fie mesajul procesat cu succes, fie va re livra mesajul neprocesat sau eșuat (cu condiția ca tranzacțiile să fi fost utilizate).
Kafka funcționează complet diferit. Mesajele nu sunt șterse în broker după citire, iar responsabilitatea pentru ceea ce se întâmplă în cazul unei erori revine codului care face citirea.
Așa cum am menționat anterior, grupul de consumatori este legat de offset-ul din jurnal. Poziția din jurnal asociată acestui offset corespunde următorului mesaj care va fi emis ca răspuns la poll ()Momentele în care această deplasare crește au o semnificație crucială la citire.
Revenind la modelul de citire prezentat anterior, procesarea mesajului constă în trei etape:
- Extrage mesajul pentru citire.
- Procesează mesajul.
- Confirmă mesajul.
Consumatorul Kafka vine cu o opțiune de configurare enable.auto.commit. Aceasta este o setare implicită utilizată frecvent, așa cum se întâmplă de obicei cu setările care conțin cuvântul „auto”.
Până la Kafka 0.10, clientul care utiliza acest parametru trimitea deplasarea ultimului mesaj citit la următoarea apelare poll () după procesare. Asta însemna că orice mesaje care au fost deja extrase (fetched) puteau fi procesate din nou, dacă clientul le-a procesat deja, dar a fost distrus neașteptat înainte de apel. poll ()Întrucât brokerul nu păstrează nicio stare cu privire la câte ori a fost citit un mesaj, următorul consumator care extrage acest mesaj nu va ști că s-a întâmplat ceva rău. Acest comportament a fost pseudo-transactional. Deplasarea era confirmată doar în cazul în care procesarea mesajului a fost de succes, dar dacă clientul era întrerupt, brokerul trimitea din nou același mesaj unui alt client. Acest comportament se conforma cu garanția de livrare a mesajelor „cel puțin o dată«.
În Kafka 0.10, codul clientului a fost modificat astfel încât commit-ul să fie inițiat periodic de biblioteca clientului, conform setării auto.commit.interval.ms. Acest comportament se află undeva între modurile JMS AUTO_ACKNOWLEDGE și DUPS_OK_ACKNOWLEDGE. Când se folosește auto-commit, mesajele puteau fi confirmate indiferent dacă au fost de fapt procesate — acest lucru se putea întâmpla în cazul în care consumatorul era lent. Dacă consumatorul se întrerupe, mesajele erau extrase de următorul consumator, începând de la poziția confirmată, ceea ce putea duce la omiterea unor mesaje. În acest caz, Kafka nu pierdea mesaje, codul de citire pur și simplu nu le procesa.
Acest mod are aceleași perspective ca în versiunea 0.9: mesajele pot fi procesate, dar în caz de eșec, deplasarea poate să nu fie confirmată, ceea ce poate duce la duplicarea livrării. Cu cât extragi mai multe mesaje în timpul poll (), cu atât mai mare este această problemă.
Așa cum s-a discutat în secțiunea „Citirea mesajelor din coadă” de pe pagina 21, în sistemul de mesagerie nu există noțiunea de livrare unică a mesajului, dacă luăm în considerare modurile de eșec.
În Kafka, există două modalități de a marca (a comite) offsetul: automat și manual. În ambele cazuri, mesajele pot fi procesate de mai multe ori, în cazul în care mesajul a fost procesat, dar a avut loc o eroare înainte de comitere. De asemenea, este posibil să nu procesați deloc un mesaj dacă comiterea a avut loc în fundal și codul dumneavoastră a fost finalizat înainte de a începe procesarea (poate în Kafka 0.9 și versiunile anterioare).
Gestionarea procesului de comitere a offset-ului manual poate fi realizată în API-ul consumatorului Kafka, setând parametrul enable.auto.commit la false și apelând explicit una dintre următoarele metode:
void commitSync();
void commitAsync();
Dacă doriți să procesați un mesaj „cel puțin o dată”, trebuie să comiteți offsetul manual cu ajutorul commitSync (), executând această comandă imediat după procesarea mesajelor.
Aceste metode nu permit confirmarea (acknowledged) mesajelor până când nu sunt procesate, dar nu fac nimic pentru a elimina potențialele duplicări de procesare, creând în același timp aparența tranzacționalității. În Kafka nu există tranzacții. Clientul nu poate realiza următoarele:
- Anula automat (roll back) un mesaj eșuat. Consumatorii trebuie să gestioneze singuri excepțiile care apar din cauza payload-urilor problematice și a deconectărilor din backend, deoarece nu se pot baza pe livrarea repetată a mesajelor de către broker.
- Trimite mesaje în mai multe topicuri într-o singură operațiune atomică. Așa cum vom vedea în curând, controlul asupra diferitelor topicuri și partiții poate fi distribuit pe mașini diferite în clusterul Kafka, care nu coordonează tranzacțiile la trimitere. Până la momentul redactării acestui articol, au fost realizate unele lucrări pentru a face acest lucru posibil prin KIP-98.
- A lega citirea unui mesaj dintr-un topic de trimiterea unui alt mesaj într-un alt topic. Din nou, arhitectura Kafka depinde de multe mașini independente care funcționează ca un singur bus și nu se fac încercări de a ascunde acest lucru. De exemplu, nu există componente API care să permită legarea Consumator și Producător în tranzacție. În JMS, acest lucru este asigurat de obiectul Sesiune, din care sunt create Produse de mesaje și Consumatori de mesaje.
Dacă nu ne putem baza pe tranzacții, cum putem asigura o semantica mai apropiată de cea furnizată de sistemele tradiționale de mesagerie?
Dacă există riscul ca offset-ul consumatorului să crească înainte de a fi procesat mesajul, de exemplu, în timpul unei erori a consumatorului, consumatorul nu are nicio modalitate de a ști dacă grupul său de consumatori a ratat mesaje atunci când i se atribuie o partiție. Astfel, una dintre strategii constă în a derula (rewind) offset-ul la o poziție anterioară. API-ul consumatorului Kafka oferă următoarele metode pentru acest lucru:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metoda seek() poate fi folosit cu metoda
offsetsForTimes (Map timestampsToSearch) pentru a derula la un anumit moment din trecut.
Implicit, utilizarea acestei abordări înseamnă că este foarte probabil ca unele mesaje care au fost procesate anterior să fie citite și procesate din nou. Pentru a evita acest lucru, putem utiliza citirea idempotentă, așa cum este descris în Capitolul 4, pentru a urmări mesajele vizualizate anterior și a exclude duplicatele.
Alternativ, codul consumatorului dumneavoastră poate fi simplu, dacă se acceptă pierderea sau dublarea mesajelor. Când analizăm scenariile de utilizare pentru care este utilizat de obicei Kafka, cum ar fi procesarea evenimentelor jurnalelor, metricilor, urmărirea clicurilor etc., înțelegem că pierderea unor mesaje individuale va avea probabil un impact semnificativ redus asupra aplicațiilor înconjurătoare. În astfel de cazuri, valorile implicite sunt perfect acceptabile. Pe de altă parte, dacă aplicația dumneavoastră trebuie să transmită plăți, trebuie să aveți grijă de fiecare mesaj în parte. Totul se reduce la context.
Observațiile personale arată că, pe măsură ce intensitatea mesajelor crește, valoarea fiecărui mesaj individual scade. Mesajele de volum mare devin, de obicei, valoroase dacă sunt considerate sub formă agregată.
Disponibilitate ridicată (High Availability)
Abordarea Kafka în ceea ce privește disponibilitatea ridicată se deosebește semnificativ de abordarea ActiveMQ. Kafka este construită pe baza clusterelor scalabile orizontal, în care toate instanțele brokerului acceptă și distribuie mesaje simultan.
Un cluster Kafka este format din mai multe instanțe broker care funcționează pe servere diferite. Kafka a fost concepută pentru a funcționa pe hardware autonom obișnuit, unde fiecare nod are propriul său sistem de stocare dedicat. Utilizarea stocării de rețea (SAN) nu este recomandată, deoarece mai multe noduri de calcul pot concura pentru timpii de stocare și pot genera conflicte.ÎIntervale de stocare și a genera conflicte.
Kafka este o platformă mereu activă. Mulți utilizatori mari ai Kafka nu își opresc niciodată clusterele, iar software-ul asigură întotdeauna actualizări prin reporniri secvențiale. Acest lucru se realizează prin garantarea compatibilității cu versiunile anterioare pentru mesaje și interacțiuni între brokeri.
Brokerii sunt conectați la un cluster de servere , care acționează ca un registru de date de configurare și este utilizat pentru a coordona rolurile fiecărui broker. ZooKeeper este o sistem distribuit care asigură disponibilitate ridicată prin replicarea informațiilor, stabilind un cvorum..
În cazul de bază, un topic este creat în clusterul Kafka cu următoarele proprietăți:
- Numărul de partiții. După cum s-a discutat anterior, valoarea exactă utilizată aici depinde de nivelul dorit de citire paralelă.
- Factoul de replicare determină câte instanțe broker din cluster trebuie să conțină jurnalele pentru această partiție.
Folosind ZooKeeper pentru coordonare, Kafka încearcă să distribuie echitabil noile partiții între brokerii din cluster. Acest lucru este realizat de o instanță care îndeplinește rolul de Controler.
În timpul execuției pentru fiecare partiție a topicului Controler aalocă brokerului rolurile liderilor (lider, stăpân, principal) și urmăritorilor (urmașe, sclavi, subordonați). Brokerul, care acționează ca lider pentru această partiție, este responsabil pentru primirea tuturor mesajelor trimise lui de către producători și distribuirea mesajelor către consumatori. Atunci când se trimit mesaje către partiția unui topic, acestea sunt replicate pe toate nodurile brokerului, care acționează ca urmași pentru această partiție. Fiecare nod care conține jurnalele pentru partiție se numește replică. Brokerul poate acționa ca lider pentru unele partiții și ca urmăritor pentru altele.
Urmăritorul care conține toate mesajele stocate la lider se numește replică sincronizată (replică, care se află în stare sincronizată, in-sync replica). Dacă brokerul, care acționează ca lider pentru partiție, se oprește, orice broker care se află în stare actualizată sau sincronizată pentru această partiție poate prelua rolul de lider. Acesta este un design extrem de rezistent.
O parte a configurației producătorului este parametrul acks, care definește câte replici trebuie să confirme (acknowledge) primirea mesajului înainte ca fluxul aplicației să continue trimiterea: 0, 1 sau toate. Dacă este specificată o valoare all, atunci la primirea mesajului liderul va trimite o confirmare (confirmation) înapoi producătorului, imediat ce a primit confirmările (acknowledgements) de la mai multe replici (inclusiv de la sine), așa cum este definit în configurația topicului min.insync.replicas (implicit 1). Dacă mesajul nu poate fi replicat cu succes, atunci producătorul va genera o excepție pentru aplicație (NotEnoughReplicas sau NotEnoughReplicasAfterAppend).
Într-o configurație tipică, se creează un topic cu un coeficient de replicare de 3 (1 lider, 2 urmași pentru fiecare partiție) și parametrul min.insync.replicas este setat la 2. În acest caz, clusterul va permite unui dintre brokerii care gestionează partiția topicului să se oprească fără a afecta aplicațiile clienților.
Asta ne readuce la un compromis deja cunoscut între performanță și fiabilitate. Replicarea are loc cu un timp suplimentar de așteptare pentru confirmările (acknowledgments) de la urmași. Cu toate acestea, deoarece aceasta se execută în paralel, replicarea, cel puțin pe trei noduri, are același nivel de performanță ca și pe două (ignorând creșterea utilizării lățimii de bandă a rețelei).
Folosind acest sistem de replicare, Kafka evită cu abilitate necesitatea de a asigura scrierea fizică a fiecărui mesaj pe disc prin operația sync (). Fiecare mesaj trimis de către producător va fi înregistrat în jurnalul partiției, dar, așa cum s-a discutat în Capitolul 2, scrierea în fișier se efectuează inițial în memoria tampon a sistemului de operare. Dacă acest mesaj este replicat pe o altă instanță Kafka și se află în memoria ei, pierderea liderului nu înseamnă că mesajul în sine a fost pierdut — acesta poate fi preluat de replica sincronizată.
Renunțarea la necesitatea de a efectua operația sync () înseamnă că Kafka poate accepta mesaje cu viteza cu care le poate scrie în memorie. Și invers, cu cât se poate evita mai mult declanșarea (flushing) memoriei pe disc, cu atât mai bine. Din această cauză, nu este neobișnuit ca brokerii Kafka să aibă alocate 64 GB de memorie sau mai mult. O astfel de utilizare a memoriei înseamnă că o instanță Kafka poate funcționa cu ușurință la viteze de mii de ori mai rapid decât un broker de mesaje tradițional.
Kafka poate fi, de asemenea, configurat pentru a aplica operația sync () la pachete de mesaje. Deoarece totul în Kafka este orientat spre lucrul cu pachete, acest lucru funcționează de fapt destul de bine pentru multe scenarii de utilizare și este un instrument util pentru utilizatorii care necesită garanții foarte puternice. O mare parte din performanța pură a Kafka se leagă de mesajele care sunt trimise brokerului sub formă de pachete, precum și de faptul că aceste mesaje sunt citite din broker în blocuri consecutive prin operații (operații în cursul cărora nu se efectuează sarcina de copiere a datelor dintr-o zonă de memorie în alta). Ultimul este un câștig semnificativ în ceea ce privește performanța și resursele și este posibil doar datorită utilizării structurii de date din spatele jurnalului, care determină schema partiției.
Într-un cluster Kafka, este posibilă o performanță deosebit de mare, comparativ cu utilizarea unui singur broker Kafka, deoarece partițiile topicului pot fi scalate orizontal pe multe mașini separate.
Concluzii
În acest capitol, am examinat cum arhitectura Kafka reconfigurează relațiile dintre clienți și brokeri pentru a oferi un canal de mesaje incredibil de robust, cu o capacitate de procesare de multe ori mai mare decât a unui broker de mesaje obișnuit. Am discutat funcționalitățile pe care le utilizează pentru a atinge acest obiectiv și am oferit o scurtă prezentare a arhitecturii aplicațiilor care facilitează această funcționalitate. În capitolul următor, vom analiza problemele comune pe care trebuie să le abordeze aplicațiile bazate pe mesaje și vom discuta strategiile pentru a le soluționa. Vom încheia capitolul delineând cum să gândim la tehnologiile de mesagerie în general, astfel încât să puteți evalua utilitatea lor pentru scenariile dumneavoastră de utilizare.
Partea precedent tradusă:
Traducerea a fost realizată:
Continuarea urmează...
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Este Kafka folosit în organizația dumneavoastră?
Da
Nu
A fost folosit anterior, acum nu mai este
Planificăm să folosim
Au votat 38 de utilizatori. 8 utilizatori s-au abținut.
Sursa: habr.com
