

O zi minunată de vineri pentru toți! Rămâne din ce în ce mai puțin timp până la lansarea cursului , așadar astăzi împărtășim traducerea unei alte resurse utile pe tema aceasta.
În procesul de dezvoltare s-a realizat o muncă impresionantă pentru a îmbunătăți secționarea tabelelor. Secționarea tabelelor — este o funcție care există în PostgreSQL de mult timp, dar, dacă putem spune așa, nu a fost practic utilizabilă până la versiunea 10, în care a devenit o funcție foarte utilă. Anterior, afirmasem că moștenirea tabelelor este implementarea noastră a secționării, și acest lucru este adevărat. Doar că acest mod te obliga să realizezi cea mai mare parte a muncii manual. De exemplu, dacă doreai ca tuplurile să fie inserate în secțiuni în timpul INSERT-urilor, trebuia să configurezi trigger-e să o facă pentru tine. Secționarea prin moștenire era foarte lentă și complicată pentru a dezvolta funcții suplimentare deasupra ei.
În PostgreSQL 10 am văzut nașterea „secționării declarative” — o funcție destinată să rezolve multe probleme care nu erau soluționabile prin utilizarea vechiului metodă cu moștenire. Acest lucru a condus la apariția unui instrument mult mai puternic, care ne permite să împărțim datele pe orizontală!
Compararea funcțiilor
În PostgreSQL 11 a apărut un set impresionant de funcții noi, care ajută la creșterea performanței și la transformarea tabelelor secționate într-o formă mai transparentă pentru aplicații.
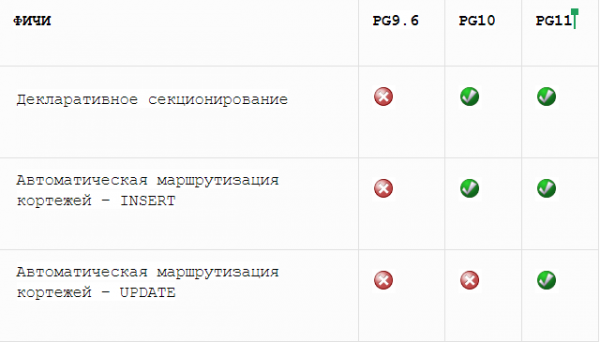
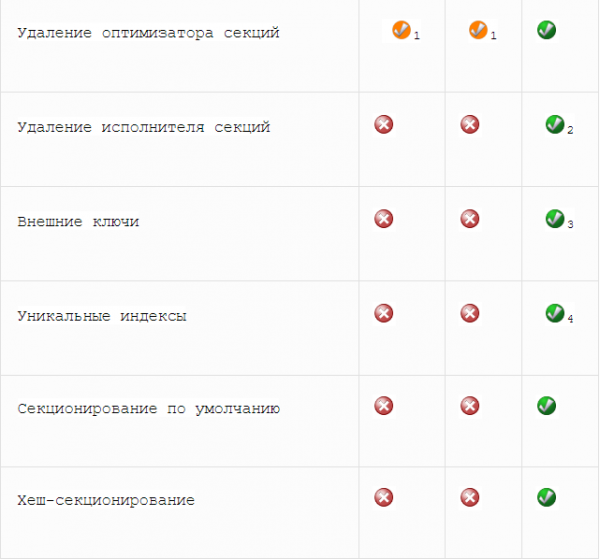
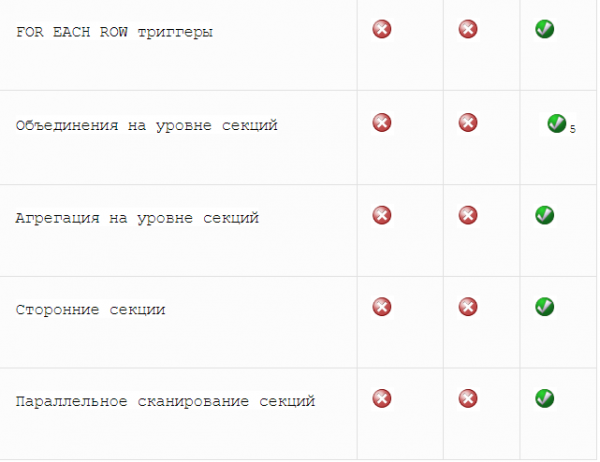
1. Folosind excepții restricționante
2. Adaugă doar noduri
3. Doar pentru tabela secționată, care se referă la o nesecționată
4. Indexurile trebuie să conțină toate coloanele cheie ale secțiunii
5. Restricțiile pe secțiune din ambele părți trebuie să coincidă
Performanță
Aici avem și vești bune! A fost adăugat o nouă metodă . Acest nou algoritm poate determina secțiunile potrivite, analizând condiția interogării WHERE. Algoritmul anterior, pe de altă parte, verifica fiecare secțiune pentru a determina dacă poate îndeplini condiția WHERE. Acest lucru ducea la o creștere suplimentară a timpului de planificare pe măsură ce numărul secțiunilor creștea.
În versiunea 9.6, cu secționarea prin moștenire, rutarea tuplilor în secțiune se realiza de obicei prin scrierea unei funcții trigger care conținea o serie de operatori IF pentru a insera tupla în secțiunea corectă. Aceste funcții puteau fi foarte lente în execuție. Odată cu secționarea declarațiilor, adăugată în versiunea 10, acest lucru a început să funcționeze mult mai repede.
Folosind o tabelă secționată cu 100 de secțiuni, putem evalua performanța încărcării a 10 milioane de rânduri în tabel din 1 coloană BIGINT și 5 coloane INT.
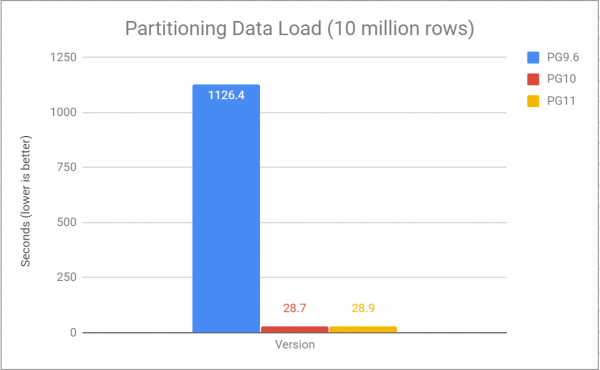
Performanța interogării acestei tabele pentru a căuta o înregistrare indexată și a executa DML pentru a manipula o singură înregistrare (folosind doar 1 procesor):
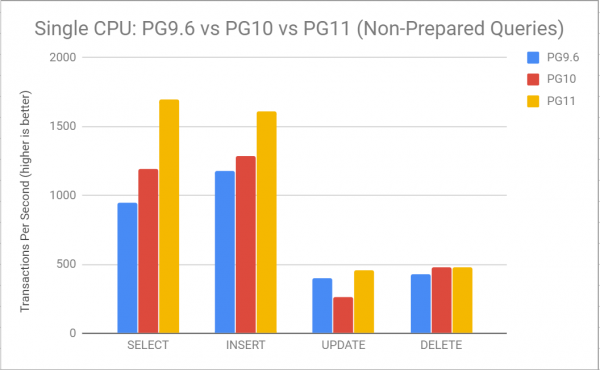
Aici vedem că performanța fiecărei operații a crescut semnificativ după PG 9.6. Interogările SELECT arată mult mai bine, în special cele care pot exclude multe secțiuni în timpul planificării interogărilor. Aceasta înseamnă că planificatorul poate sări peste o mare parte din munca pe care trebuia să o facă anterior. De exemplu, nu mai sunt construite căi pentru secțiuni inutile.
Concluzie
Secționarea tabelelor începe să devină o funcție foarte puternică în PostgreSQL. Aceasta permite extragerea rapidă a datelor în online și transferul lor în offline, fără a aștepta finalizarea unor operațiuni DML masive lente.Aceasta înseamnă, de asemenea, că datele asociate pot fi stocate împreună, ceea ce face accesul la datele necesare mult mai eficient. Îmbunătățirile aduse în această versiune nu ar fi fost posibile fără dezvoltatorii, recenzorii și commit-erii care au muncit neobosit la toate aceste funcții.
Le mulțumim tuturor! PostgreSQL 11 arată pur și simplu fantastic!
Iată un articol scurt, dar destul de interesant. Împărtășiți comentarii și nu uitați să vă înscrieți la , în cadrul căruia va fi prezentat în detaliu programul cursului.
Sursa: habr.com
