

— este un mecanism foarte puternic și convenabil, dacă aceeași acțiune este aplicată datelor conectate „în adâncime”. Însă recursivitatea necontrolată este un rău care poate duce fie la executarea infinită a procesului, fie (ceea ce se întâmplă mai des) la „consumarea” întregii memorii disponibile.
Sistemele de gestionare a bazelor de date funcționează în acest sens pe aceleași principii — "am spus să săpăm, așa că săpăm". Cererea dumneavoastră nu doar că poate încetini procesele învecinate, ocupând constant resursele procesorului, ci poate „pune jos” întreaga bază de date, „consumând” întreaga memorie disponibilă. Prin urmare, protecția împotriva recursivității infinite este datoria dezvoltatorului.
În PostgreSQL, capacitatea de a folosi interogări recursive prin a apărut încă din vremuri de demult, în versiunea 8.4, dar până în prezent pot fi întâlnite regulat interogări de tip „vulnerabil” și „neprotejat”. Cum ne putem feri de astfel de probleme?
Să nu scriem interogări recursive
Ci să scriem interogări nerrecursives. Cu stimă, al dumneavoastră K.O.
De fapt, PostgreSQL oferă un număr destul de mare de funcții de care se poate beneficia pentru nu a aplica recursivitatea.
A folosi o abordare complet diferită asupra problemei
Uneori este suficient să privim problema „dintr-o altă direcție”. Exemplul unei astfel de situații l-am adus în articolul — înmulțirea unui set de numere fără utilizarea funcțiilor agregate personalizate:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- selectarea rezultatului final
  i DESC
LIMIT 1;
Această interogare poate fi înlocuită cu o variantă de la cunoscătorii matematicii:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
A folosi generate_series în loc de bucle
Să presupunem că trebuie să generăm toate prefixele posibile pentru șirul 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Chiar e nevoie de recursivitate aici?.. Dacă folosim LATERAL și generate_series, atunci nici măcar CTE nu sunt necesare:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
A modifica structura Bazei de Date
De exemplu, aveți o tabelă cu mesajele dintr-un forum, cu relații între cine a răspuns cui sau un thread în :
CREATE TABLE message(
  message_id
    uuid
      PRIMARY KEY
, reply_to
    uuid
      REFERENCES message
, body
    text
);
CREATE INDEX ON message(reply_to); 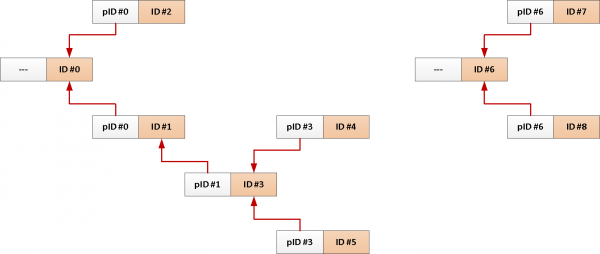
Un exemplu tipic de interogare pentru încărcarea tuturor mesajelor pe o anumită temă arată aproximativ așa:
WITH RECURSIVE T AS (
  SELECT
    *
  FROM
    message
  WHERE
    message_id = $1
UNION ALL
  SELECT
    m.*
  FROM
    T
  JOIN
    message m
      ON m.reply_to = T.message_id
)
TABLE T;
Dar, având în vedere că avem întotdeauna nevoie de întreaga temă de la mesajul rădăcină, de ce să nu adăugăm identificatorul său la fiecare înregistrare automat?
-- adăugăm un câmp cu identificatorul comun al temei și un index pe acesta
ALTER TABLE message
  ADD COLUMN theme_id uuid;
CREATE INDEX ON message(theme_id);

-- inițializăm identificatorul temei în trigger la inserare
CREATE OR REPLACE FUNCTION ins() RETURNS TRIGGER AS $$
BEGIN
  NEW.theme_id = CASE
    WHEN NEW.reply_to IS NULL THEN NEW.message_id -- luăm din evenimentul de start
    ELSE ( -- sau din mesajul la care răspundem
      SELECT
        theme_id
      FROM
        message
      WHERE
        message_id = NEW.reply_to
    )
  END;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER ins BEFORE INSERT
  ON message
    FOR EACH ROW
EXECUTE PROCEDURE ins(); 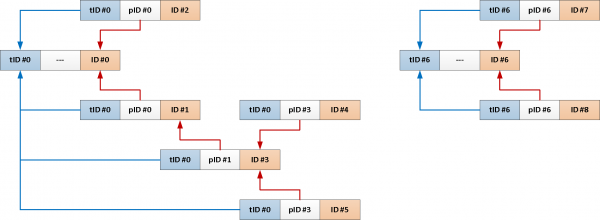
Acum întreaga noastră interogare recursivă poate fi redusă doar la așa ceva:
SELECT
  *
FROM
  message
WHERE
  theme_id = $1;
Utilizarea „limiterilor” aplicați
Dacă din diverse motive nu putem schimba structura bazei de date, haideți să vedem pe ce ne putem baza pentru a evita ca prezența unor erori în date să ducă la execuția infinită a recursiei.
Contorul „adâncimii” recursiei
Pur și simplu creștem contorul cu o unitate la fiecare pas al recursiei până când atingem limita pe care o considerăm evident inadecvată:
WITH RECURSIVE T AS (
  SELECT
    0 i
  ...
UNION ALL
  SELECT
    i + 1
  ...
  WHERE
    T.i < 64 -- limită
)
Pro: În cazul unei încercări de ciclizare, vom avea totuși nu mai mult de limita specificată a iterațiilor „în adâncime”.
Contra: Nu există nicio garanție că nu vom procesa din nou aceeași înregistrare — de exemplu, la adâncimea 15 și 25, și apoi din nou la fiecare +10. Și nimeni nu a promis nimic despre „lățime”.
Formal, această recursie nu va fi infinită, dar dacă la fiecare pas numărul de înregistrări crește exponentially, știm cu toții cum se termină…
Păstrătorul „căii”
Scriem pe rând toate identificatoarele obiectelor întâlnite pe calea recursiei într-un tablou, care reprezintă un „drum” unic până la acesta:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) -- nu se potrivește cu niciunul dintre
)
Pro: At the presence of a cycle in the data, we will definitely not process the same record again within the same path.
Contra: However, we can go through literally all the records without repeating.
Path Length Restriction
To avoid the situation of 'wandering' the recursion at unclear depths, we can combine the two previous methods. Or, if we don't want to maintain unnecessary fields, we can augment the recursion continuation condition with a path length estimate:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
Choose your method as you like!
Sursa: habr.com
