

În funcție de activitate, este necesar să ne confruntăm cu situații în care dezvoltatorul scrie o interogare și se gândește „baza de date este inteligentă, se va descurca singură!"«
În unele cazuri (parțial din cauza neștiinței capabilităților DB, parțial din cauza optimizărilor premature), această abordare conduce la apariția „frankensteinilor”.
Mai întâi voi da un exemplu de astfel de interogare:
-- pentru fiecare pereche cheie, găsim valorile asociate ale câmpurilor
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- găsim min/max valorile pentru fiecare primă cheie
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- legăm perechile cheie prin prima cheie și valorile min/max
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Pentru a evalua concret calitatea interogării, haideți să creăm un set de date arbitrar:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
Se dovedește că citirea datelor a durat mai puțin de un sfert din tot timpul executării interogării: Să analizăm pas cu pas
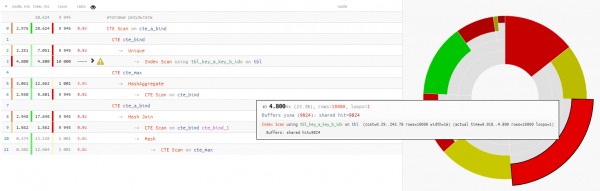
Vom examina cu atenție interogarea și ne vom întreba:
De ce avem aici WITH RECURSIVE, dacă nu sunt CTE recursive?
- De ce să grupăm valorile min/max într-un CTE separat, dacă apoi tot se leagă de selecția originală?
- +25% din timp
De ce să folosim la final o reîncărcare din CTE-ul anterior printr-un ‘SELECT * FROM’ necondiționat? - +14% din timp
În acest caz, am avut totuși noroc că s-a ales Hash Join pentru unire, nu Nested Loop, deoarece altfel am fi obținut nu un singur parcurs CTE Scan, ci 10K!
puțin despre CTE Scan
Aici trebuie să ne amintim căCTE Scan este un echivalent al Seq Scan — adică nicio indexare, doar o căutare completă, care ar necesita 10K x 0.3ms = 3000ms la iterațiile pe cte_max 1K x 1.5ms = sau 1500ms la iterațiile pe cte_bind De fapt, ce am vrut să obținem în rezultatul final?!
Aha, de obicei, exact această întrebare apare undeva în a cincea minută de analiză a interogărilor „în trei niveluri”. Am vrut să obținem pentru fiecare pereche cheie unică
min/max din grupul pe key_a Așa că hai să folosim pentru aceasta.
funcții de fereastră :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 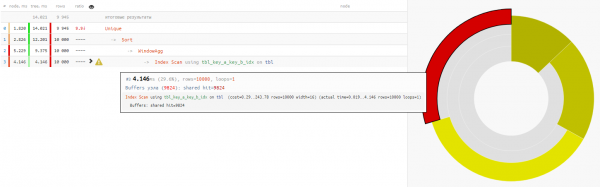
Deoarece citirea datelor în ambele variante durează aproximativ 4-5 ms, tot câștigul nostru de timp -32% — este în mod pur o încărcătură, eliminată de CPU-ul bazei, dacă o astfel de interogare este efectuată destul de frecvent.
În general, nu ar trebui să forțăm baza să „îndoaie rotunjit, să rostogolească pătrățit”.
Sursa: habr.com
