

În sistemele ERP complexe multe entități au o natură ierarhică, când obiecte omogene sunt organizate într-un arbore de relații „părinte — copil” — aceasta include atât structura organizațională a întreprinderii (toate aceste filiale, departamente și grupuri de lucru), cât și catalogul de produse, și domeniile de activitate, și geografia punctelor de vânzare,…
De fapt, nu există o , în care să nu existe vreo ierarhie ca rezultat. Dar chiar dacă nu lucrați „în domeniul afacerilor”, puteți să vă întâlniți cu relații ierarhice. De exemplu, chiar arborele genealogic sau schema pe etaje a unui centru comercial reprezintă o structură similară.
Există multe moduri de a stoca un astfel de arbore în SGBD, dar astăzi ne vom opri asupra unei singure variante:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- să nu uităm că FK nu presupune crearea automată a indexului, spre deosebire de PK
Și în timp ce te uiți în adâncimea ierarhiei, aceasta așteaptă cu răbdare cât de „ineficiente” se vor dovedi metodele tale de lucru cu o astfel de structură.
Să analizăm sarcinile tipice care apar, implementarea acestora în SQL și să încercăm să le îmbunătățim performanța.
#1. Насколько глубока кроличья нора?
Să presupunem, pentru claritate, că această structură va reflecta subordonarea departamentelor în structura organizației: departamente, divizionuri, sectoare, filiale, grupuri de lucru,… — orice le-ai numi.
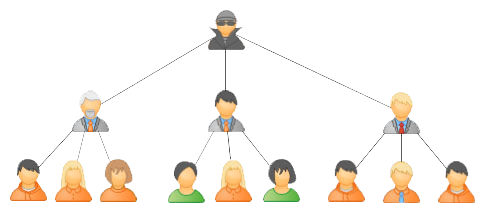
Mai întâi, vom genera „arborele” nostru din 10k de elemente
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Să începem cu cea mai simplă sarcină — a găsi toți angajații care lucrează într-un sector specific, sau, în termenii ierarhiei — a găsi toți descendenții unui nod. Și ar fi bine să obținem și „adâncimea” descendentului… Toate acestea pot fi necesare, de exemplu, pentru a construi o .
Totul ar fi în regulă dacă acești descendenți sunt doar câteva niveluri și se numără în zecimi, dar dacă numărul de niveluri depășește 5, iar descendenții sunt deja câteva zeci — pot apărea probleme. Să vedem cum sunt scrise (și funcționează) variantele tradiționale de căutare „în jos pe arbore”. Dar mai întâi, să definim care dintre noduri vor fi cele mai interesante pentru studiile noastre.
Cele mai „profund” subarbore:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...Cele mai „latoase” subarbore:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Pentru aceste interogări ne-am folosit de un tipic JOINRecursive:
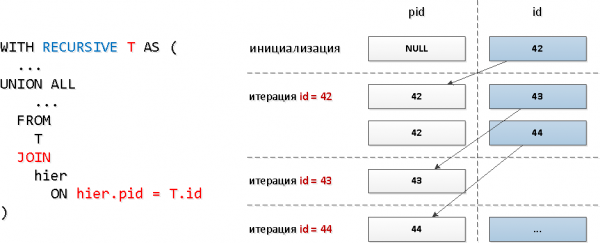
Evident, cu un astfel de model de interogare numărul de iterații va coincide cu numărul total de descendenți (iar aceștia sunt câteva zeci), și ocuparea resurselor poate fi destul de semnificativă, iar, prin urmare, timpul.
Să verificăm pe cel mai „latoase” subarbore:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 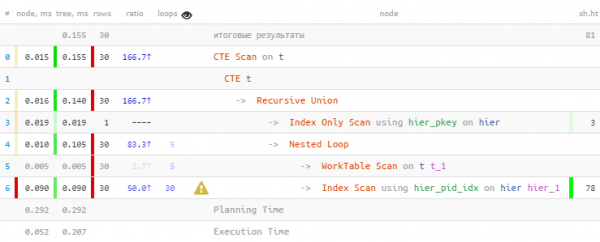
Așa cum am presupus, am găsit toate cele 30 de înregistrări. Însă am cheltuit 60% din tot timpul — pentru că am realizat 30 căutări în index. Oare mai puțin — este posibil?
Citire în masă din index
Și pentru fiecare nod trebuie să facem o interogare separată la index? Se pare că nu — putem citi din index imediat după mai multe chei într-o singură solicitare folosind = ANY(array).
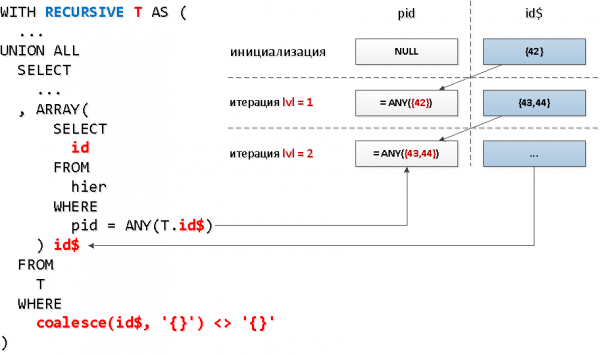
Iar în fiecare astfel de grup de identificatori putem lua toate ID-urile găsite în etapa anterioară pe „noduri”. Asta înseamnă că la fiecare pas următor vom căuta deodată toți descendenții unui anumit nivel.
Numai că, iată problema, în selecția recursivă nu putem face referire la noi înșine într-o interogare încorporată, iar noi trebuie să selectăm exact ceea ce a fost găsit la nivelul anterior… Se pare că nu se poate face o interogare încorporată la întreaga selecție — dar la un câmp concret se poate. Și acest câmp poate fi și un array — ceea ce ne trebuie pentru a folosi ALL.
Pare puțin ciudat, dar pe schemă — totul este simplu.
CU RECURENTĂ T AS (
  SELECT
    ARRAY[id] id$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    ARRAY(
      SELECT
        id
      FROM
        hier
      WHERE
        pid = ANY(T.id$)
    ) id$
  FROM
    T
  WHERE
    coalesce(id$, '{}') '{}' -- condiția de ieșire din ciclu - array gol
)
SELECT
  unnest(id$) id
FROM
T; 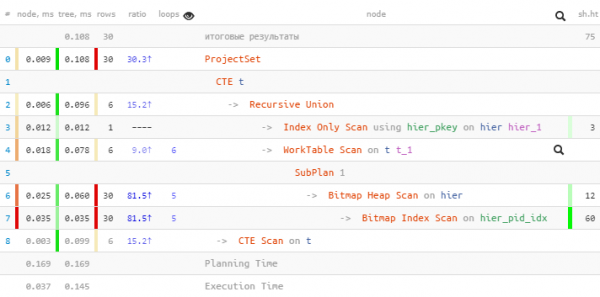
Și aici, ceea ce este cel mai important nu este câștigul de 1,5 ori în timp, ci faptul că am citit mai puțin buffers, deoarece accesările la index sunt doar 5 în loc de 30!
Un bonus suplimentar este că, după unnest final, identificatorii vor rămâne ordonați pe «niveluri».
Semnul nodului
O altă considerație care va ajuta la îmbunătățirea performanței este că «frunzele» nu pot avea copii, adică pentru ele nu trebuie să căutăm «în jos» deloc. În cadrul problemei noastre, aceasta înseamnă că, dacă am parcurs șirul departamentelor și am ajuns la angajat, nu mai este necesar să căutăm pe această ramură.
Să introducem în tabelul nostru un boolean-câmp, care ne va spune din prima dacă această anumită înregistrare din arborele nostru este un «nod» — adică dacă poate avea descendenți.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      hier
    WHERE
      pid = T.id
    LIMIT 1
);
-- Interogare executată cu succes: 3033 rânduri modificate în 42 ms.
Excelent! Se pare că doar puțin mai mult de 30% din toate elementele arborelui au descendenți.
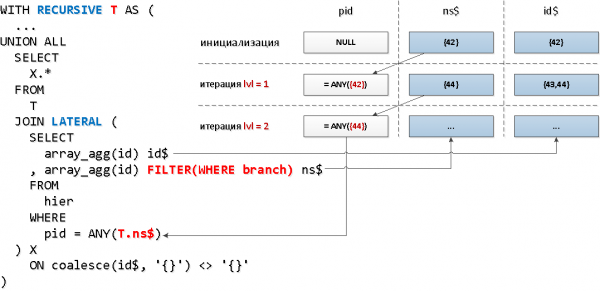
Acum vom aplica o mecanică diferită — conexiuni cu partea recursivă prin LATERAL, ceea ce ne va permite să accesăm direct câmpurile „tabelei” recursive, iar funcția agregată cu condiția de filtrare după semnul nodului o utilizăm pentru a reduce setul de chei:
CU RECURENTĂ T AS (
  SELECT
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    X.*
  FROM
    T
  JOIN LATERAL (
    SELECT
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FROM
      hier
    WHERE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}') '{}'
)
SELECT
  unnest(id$) id
FROM
T; 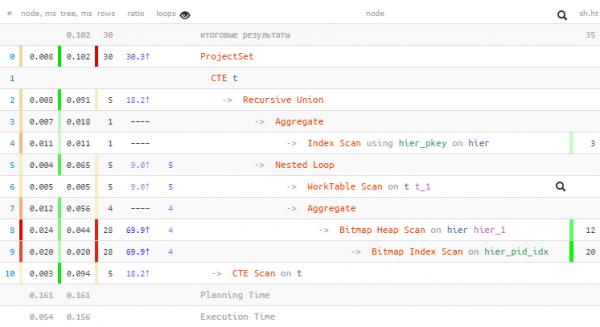
Am reușit să reducem încă un acces la index și am câștigat de mai bine de 2 ori în volum citit.
#2. Вернемся к корням
Acest algoritm va fi util dacă trebuie să adunați înregistrări pentru toate elementele „în sus pe arbore”, păstrând astfel informația despre care frunză originală (și cu ce indicatori) a provocat includerea în selecție — de exemplu, pentru a forma un raport rezumativ cu agregarea pe noduri.
Ce ce urmează trebuie considerat exclusiv ca un proof-of-concept, deoarece cererea devine foarte voluminoasă. Dar dacă ea domină în baza dumneavoastră de date, merită să luați în considerare aplicarea unor astfel de metode.
Să începem cu câteva enunțuri simple:
- Aceeași înregistrare din baza de date este mai bine să fie citită o singură dată.
- Înregistrările din baza de date sunt mai eficiente citite "în pachet", decât individual.
Acum să încercăm să construim cererea necesară.
Pasul 1
Este evident că la inițializarea recursivității (unde altundeva!) va trebui să extragem înregistrările frunzelor în funcție de setul de identificatori inițiali:
WITH RECURSIVE tree AS (
  SELECT
    rec -- acesta este întregul înregistrare din tabel
  , id::text chld -- acesta este "setul" de frunze care au dus aici
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Dacă cuiva i s-a părut ciudat că "setul" este stocat ca un șir de caractere și nu ca un array, există o explicație simplă pentru aceasta. Pentru șiruri există o funcție de agregare încorporată "de concatenare" string_agg, iar pentru array-uri — nu. Deși este .
Pasul 2
Acum trebuie să obținem setul de ID-uri ale secțiunilor care trebuie extrase în continuare. Acestea vor fi aproape întotdeauna duplicate în diferite înregistrări ale setului inițial, așa că ne-ar trebui să le grupăm, menținând în același timp informația despre frunzele sursă.
Dar aici ne așteaptă trei probleme neplăcute:
- Partea „sub-recursivă” a cererii nu poate conține funcții agregate cu
COUNT_BIG(*). - Accesul la „tabelul” recursiv nu poate fi într-un sub-întrebare.
- Cererile din partea recursivă nu pot conține CTE.
Din fericire, toate aceste probleme sunt destul de ușor de ocolit. Să începem cu sfârșitul.
CTE din partea recursivă
Așa ar trebui nu funcționează:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
Și astfel — funcționează, parantezele rezolvă!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
O întrebare în cadrul „tabelului” recursiv
Hmm… Accesul la CTE recursiv nu poate fi într-o sub-întrebare. Dar poate fi în interiorul CTE-ului! Iar sub-întrebarea poate accesa deja acest CTE!
GROUP BY în interiorul recursivității
Neplăcut, dar… Avem o modalitate simplă de a simula GROUP BY folosind DISTINCT ON și funcții de fereastră!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- nu funcționează!
Dar așa — funcționează!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Acum vedem de ce ID-ul numeric s-a transformat în text — pentru a putea fi concatenate printr-o virgulă!
Pasul 3
Pentru final, ne-a mai rămas doar atât:
- revedem înregistrările „secțiunilor” pe setul de ID-uri grupate
- asociem secțiunile citite cu „seturile” de foi originale
- „dezgropăm” șirul-set cu ajutorul
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 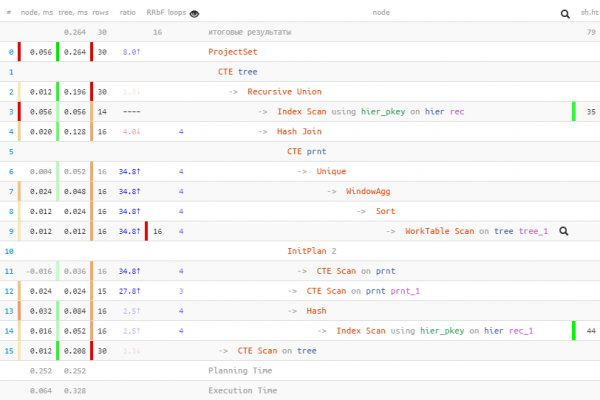
Sursa: habr.com
