

De multe ori, dezvoltatorul trebuie să transmită un set de parametri în cerere sau chiar o întreagă selecție „la intrare”. Uneori, se întâlnesc soluții foarte ciudate pentru această problemă.
Să mergem „pe calea inversă” și să vedem cum nu ar trebui să procedăm, de ce și cum putem face mai bine.
Inserarea directă a valorilor în corpul cererii
Arată de obicei cam așa:
query = "SELECT * FROM tbl WHERE id = " + value… sau așa:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Despre acest mod s-a spus, s-a scris și suficient:
Aproape întotdeauna aceasta este— o cale directă către injecțiile SQL și o încărcătură inutilă pe logica de afaceri, care este nevoită să „lipiască” șirul cererii tale.
Această abordare este parțial justificată doar în cazul în care este necesar să utilizăm partiționarea în versiunile PostgreSQL 10 și anterioare pentru a obține un plan mai eficient. În aceste versiuni, lista secțiunilor scanate este determinată fără a lua în considerare parametrii transmiși, doar pe baza corpului cererii.
$n-argumente
Utilizare parametrii — este bine, permite utilizarea , reducând încărcătura atât pe logica de afaceri (șirul cererii este formulat și transmis doar o dată), cât și pe serverul Bazei de Date (nu este necesară o nouă analiză și planificare pentru fiecare instanță a cererii).
Număr variabil de argumente
Problemele ne așteaptă atunci când dorim să transmitem un număr necunoscut de argumente:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Dacă lăsăm cererea în această formă, ne va proteja de potențiale injecții, dar totuși va duce la necesitatea lipirii/analizării cererii pentru fiecare variantă în funcție de numărul de argumente. Este deja mai bine decât să facem asta de fiecare dată, dar putem face fără ea.
Este suficient să transmitem un singur parametru, conținând o reprezentare serializată a unui tablou:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Singura diferență este necesitatea de a converti explicit argumentul în tipul dorit de tablou. Dar aceasta nu ridică probleme, deoarece oricum știm dinainte în ce direcție ne adresăm.
Transmiterea unui set (matrice)
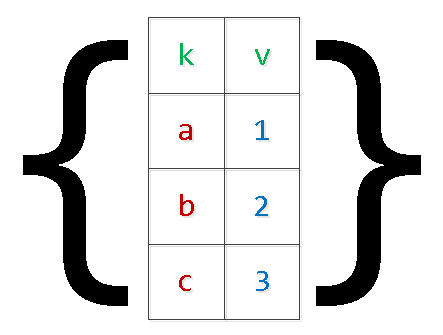
De obicei, aceasta se referă la diverse variante de transmitere a seturilor de date pentru a fi inserate în baza de date „într-o singură cerere”:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Pe lângă problemele descrise mai sus cu „lipirea” cererii, acest lucru ne poate conduce, de asemenea, la out of memory și căderea serverului. Motivul este simplu - sub argumentele PG se rezervă memorie suplimentară, iar numărul de înregistrări din set este limitat doar de dorințele aplicației de logică de afaceri. În cazuri clinice deosebite, am fost martor la argumente „numerice” care depășesc $9000 — nu trebuie să facem așa.
Să rescriem cererea, aplicând deja serializarea „pe două niveluri”:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Da, în cazul valorilor „complexe” din interiorul unui array, acestea trebuie să fie încadrate în ghilimele.
Este clar că, în acest mod, se poate „extinde” selecția cu un număr arbitrar de câmpuri.
unnest, unnest, …
Din când în când, apar variante de transmitere a mai multor „array-uri de coloane” în loc de un „array de array-uri”, despre care am menționat. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Cu acest mod, dacă greșești la generarea listelor de valori pentru diferite coloane, este foarte simplu să obții rezultate neobișnuite, care depind și de versiunea serverului:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Începând cu versiunea 9.3, PostgreSQL a introdus funcții complete pentru lucrul cu tipul json. Așadar, dacă definiția parametrilor de intrare se face în browser, poți genera direct acolo un obiect json pentru interogarea SQL:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Pentru versiunile anterioare, aceeași metodă poate fi utilizată pentru each(hstore), dar o „întreagă” corectă cu escaparea obiectelor complexe în hstore poate cauza probleme.
json_populate_recordset
Dacă știi din timp că datele din json-array-ul „de intrare” vor fi folosite pentru umplerea unei tabel, poți economisi mult timp în „de-referințierea” câmpurilor și conversia la tipurile necesare, folosind funcția json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Iar această funcție pur și simplu „întreagă” array-ul de obiecte transmis în selecție, fără a se baza pe formatul tabelului:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TABEL TEMPORAR
Dar, dacă volumul de date din selecția trimisă este foarte mare, atunci a o pune într-un singur parametru serializat - este greu, și uneori imposibil, deoarece necesită o alocare unică a unei cantități mari de memorieDe exemplu, trebuie să adunați un mare pachet de date despre evenimente dintr-un sistem extern și apoi doriți să-l procesați o singură dată pe partea bazei de date.
În acest caz, cea mai bună soluție va fi folosirea :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- repetă de multe, multe ori
...
-- aici facem ceva util cu întreaga tabelă
Această metodă este bună pentru transferuri rare de volum mare de date.
Din perspectiva descrierii structurii datelor, o tabelă temporară se deosebește de o „normală” doar printr-o caracteristică în tabela sistemică pg_class, iar în pg_type, pg_depend, pg_attribute, pg_attrdef, … — nu se deosebește deloc.
Prin urmare, în sistemele web cu un număr mare de conexiuni de scurtă durată, pentru fiecare dintre ele, o astfel de tabelă va genera înregistrări sistemice noi de fiecare dată, care sunt șterse odată cu închiderea conexiunii cu baza de date. În cele din urmă, utilizarea necontrolată a TEMP TABLE duce la „umflarea” tabelelor în pg_catalog și încetinește multe operațiuni care le folosesc.
Desigur, acest lucru poate fi combătut prin într-o trecere periodică VACUUM FULL prin tabelele catalogului sistemic.
Variabilele de sesiune
Să presupunem că procesarea datelor din cazul anterior este suficient de complicată pentru a fi realizată într-o singură interogare SQL, dar doriți să o faceți destul de des. Asta înseamnă că dorim să folosim procesarea procedurală într-un , dar folosirea transferului de date prin tabele temporare va fi prea costisitoare.
Folosirea parametrilor $n pentru a face transfer în blocuri anonime nu este, de asemenea, o opțiune. Vom recurge la variabilele de sesiune și la funcția current_setting.
Până la versiunea 9.2, era necesar să se configureze anterior custom_variable_classes pentru „propriile” variabile de sesiune. La versiunile actuale, se poate scrie aproximativ astfel:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
În alte limbi procedurale suportate se pot găsi și alte soluții.
Cunoașteți și alte metode? Împărtășiți-le în comentarii!
Sursa: habr.com
