

Particularitățile funcționării mecanismelor interne ale PostgreSQL îi permit să fie foarte rapid în anumite situații și „nu prea” în altele. Astăzi ne vom opri asupra unui exemplu clasic de conflict între modul în care funcționează SGBD-ul și ceea ce face dezvoltatorul cu el — UPDATE vs principiile MVCC.
Pe scurt, povestea din :
Când o linie este modificată prin comanda UPDATE, în realitate sunt efectuate două operațiuni: DELETE și INSERT. În versiunea curentă a liniei se stabilește xmax, egal cu numărul tranzacției care a efectuat UPDATE. Apoi se creează o nouă versiune a aceleași linii; valoarea xmin a acesteia coincide cu valoarea xmax a versiunii anterioare.
După un timp, după finalizarea acestei tranzacții, versiunea veche sau nouă, în funcție de COMMIT/ROLLBACK, va fi considerată „moartă” (tuples moarte) în timpul parcurgerii VACUUM tabelului și va fi curățată.
Dar asta nu se va întâmpla imediat, iar problemele cu „morții” pot apărea foarte rapid — în cazul actualizărilor repetitive sau dintr-un tabel mare, iar puțin mai târziu te poți confrunta cu situația că nici .
#1: I Like To Move It
Să presupunem că metoda ta pe baza logicii de afaceri funcționează bine și, deodată, îți dai seama că ar fi bine să actualizezi câmpul X într-o anumită înregistrare:
UPDATE tbl SET X = <newX> WHERE pk = $1;Apoi, în timpul execuției, realizezi că ar trebui să actualizezi și câmpul Y:
UPDATE tbl SET Y = <newY> WHERE pk = $1;… și apoi și Z — de ce să ne ținem de lucruri mărunte?
UPDATE tbl SET Z = <newZ> WHERE pk = $1;Câte versiuni ale acestei înregistrări avem acum în bază? Aha, 4 bucăți! Dintre care una este actuală, iar 3 va trebui să le cureți tu [auto]VACUUM.
Nu face așa! Folosește actualizarea tuturor câmpurilor într-o singură interogare — aproape întotdeauna logica metodei poate fi astfel schimbată:
UPDATE tbl SET X = <newX>, Y = <newY>, Z = <newZ> WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Așadar, totuși ți-ai dorit (în timpul aplicării unui script sau convertor, de exemplu). Și în script apare ceva de genul:
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2;Aproape în această formă, interogarea apare suficient de des și aproape întotdeauna nu pentru a completa un câmp nou gol, ci pentru a corecta anumite erori în date. În același timp, corectitudinea datelor deja existente nu este luată în considerare — și pe bună dreptate! Asta înseamnă că înregistrarea este rescrisă, chiar dacă acolo se afla exact ceea ce se dorea — de ce? Să corectăm:
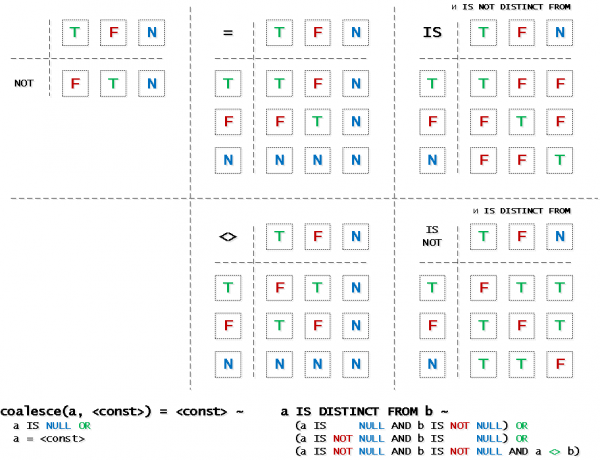
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM <newX>; Mulți nu sunt la curent cu existența acestui operator minunat, așa că iată un ghid despre IS DISTINCT FROM și alți operatori logici pentru ajutor:
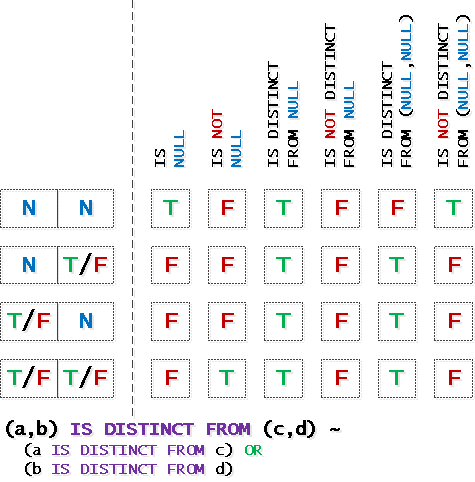
… și puțin despre operațiile cu expresii ROW()-complexe:
#3: А я милого узнаю по… блокировке
Se lansează două procese paralele identice, fiecare dintre ele încercând să marcheze înregistrările că sunt "în lucru":
UPDATE tbl SET processing = TRUE WHERE pk = $1;Chiar dacă aceste procese efectuează lucruri independente unul de celălalt, în cadrul aceluiași ID, în această interogare al doilea client "se va bloca" până când prima tranzacție se finalizează.
Soluția nr.1: problema a fost redusă la precedentul
Pur și simplu vom adăuga din nou IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;În această formă, a doua interogare pur și simplu nu va schimba nimic în bază, deja "totul este în regulă" — de aceea blocarea nu va apărea. Mai departe, faptul că înregistrarea "nu este găsită" este deja gestionat în algoritmul aplicației.
Soluția nr.2: blocări de consiliere
O temă mare pentru un articol separat, unde se poate citi despre .
Soluția nr.3: apeluri fără[ă]minte
Asta exact ar trebui să se întâmple o muncă simultană cu aceeași înregistrare? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Sursa: habr.com
