

Continuăm seria de articole dedicate explorării unor metode mai puțin cunoscute de îmbunătățire a performanței interogărilor „aparent simple” în PostgreSQL:
Nu credeți că nu-mi plac JOIN-urile atât de mult… 🙂
Dar adesea, fără el, interogarea devine semnificativ mai performantă decât cu el. Așadar, astăzi vom încerca să ne îndepărtăm de JOIN-ul consumator de resurse — cu ajutorul unui dicționar.
Începând cu PostgreSQL 12, o parte din situațiile descrise mai jos pot fi reproduceți puțin diferit din cauza . Această comportare poate fi readusă la forma anterioară prin specificarea cheii
MATERIALIZED.
Multe „fapte” privind dicționarul limitat
Să luăm o sarcină aplicativă foarte reală — trebuie să generăm o listă sau sarcini active cu expeditori:
25.01 | Ivanov I.I. | Pregătiți descrierea noului algoritm.
22.01 | Ivanov I.I. | Scrieți un articol pe Habr: viața fără JOIN.
20.01 | Petrov P.P. | Ajutați la optimizarea interogării.
18.01 | Ivanov I.I. | Scrieți un articol pe Habr: JOIN având în vedere distribuția datelor.
16.01 | Petrov P.P. | Ajutați la optimizarea interogării.
Într-o lume abstractă, autorii sarcinilor ar trebui să fie distribuiți uniform printre toți angajații organizației noastre, dar în realitate sarcinile vin, de regulă, de la un număr destul de limitat de persoane — „de la conducere” în sus în ierarhie sau „de la colegi” din departamentele învecinate (analisti, designeri, marketing, ...).
Să presupunem că în organizația noastră din 1000 de persoane doar 20 de autori (de obicei chiar mai puțin) pun sarcini în direcția fiecărui anumit executant și , pentru a accelera interogarea „tradițională”.
Generator de scripturi
-- angajați
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- sarcini cu distribuție specificată
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Vom arăta ultimele 100 de sarcini pentru un anumit executant:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 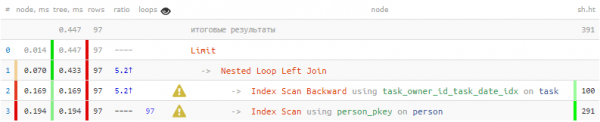
Deci, rezultă că 1/3 din totalul timpului și 3/4 din citiri pagina de date a fost realizată doar pentru a căuta autorul de 100 de ori — pentru fiecare sarcină afișată. Dar știm că dintre această sută sunt doar 20 diferite — nu putem folosi această informație?
dicționar hstore
Vom folosi pentru a genera un 'dicționar' cheie-valoare:
CREATE EXTENSION hstoreÎn dicționar ne ajunge să plasăm ID-ul autorului și numele său, pentru a putea extrage apoi după această cheie:
-- formăm selecția țintă
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- formăm dicționar pentru valori unice
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- obținem valorile asociate ale dicționarului
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> key
FROM
T; 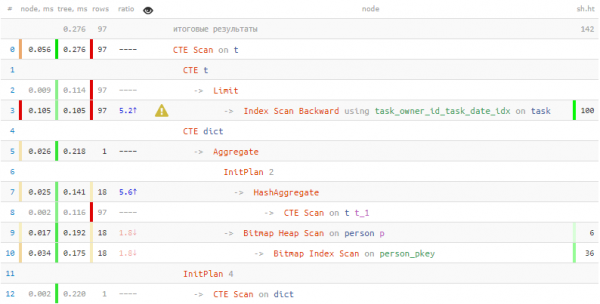
Informațiile despre persoane au fost obținute de 2 ori mai puțin timp și de 7 ori mai puține date citite! Pe lângă 'dicționare', aceste rezultate ne-au ajutat să atingem și extracția în masă a înregistrărilor din tabel printr-o singură trecere folosind = ANY(ARRAY(...)).
Înregistrările din tabel: serializare și deserializare
Dar ce facem dacă trebuie să păstrăm în dicționar nu un singur câmp text, ci un întreg înregistrare? În acest caz, ne va ajuta capacitatea PostgreSQL de a trata o înregistrare din tabel ca o valoare unică:
...,
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magie #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magie #2
FROM
  T;
Să analizăm ce s-a întâmplat aici:
- Am luat p ca alias pentru înregistrarea completă a tabelului person și le-am combinat într-un array.
- Acest array de înregistrări a fost transformat într-un array de șiruri de caractere (person[]::text[]), pentru a-l plasa în dicționarul hstore ca un array de valori.
- Când obținem înregistrarea legată, o extragem din dicționar pe baza cheii ca șir de caractere.
- Textul trebuie să fie transformat într-o valoare de tip tabel person (pentru fiecare tabel se creează automat un tip cu același nume).
- Am «desfășurat» înregistrarea tipizată în coloane folosind
(...).*.
dicționar json
Dar un astfel de truc, cum am aplicat mai sus, nu va funcționa dacă nu există un tip de tabel corespunzător pentru a efectua «transformarea». Aceeași situație va apărea și dacă încercăm să folosim un șir CTE, nu un tabel «real».
În acest caz, ne vor ajuta :
...
, p AS ( -- acesta este deja CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- acum acesta este deja json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- și în interior json pentru fiecare rând
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- extras din dicționar ca json
      ) AS j(name text, birth_date date) -- completat structura de care avem nevoie
  ) j;
Trebuie menționat că, la descrierea structurii țintă, putem enumera nu toate câmpurile din șirul sursă, ci doar pe cele de care avem cu adevărat nevoie. Dacă avem un tabel „nativ”, ar fi mai bine să folosim funcția json_populate_record.
Accesul la dicționar se face în continuare o singură dată, dar costurile de [de]serializare json sunt destul de mari, așa că acest mod este rezonabil de utilizat doar în anumite cazuri, când un „scan CTE” onest se dovedește a fi mai slab.
Testăm performanța
Așadar, am obținut două moduri de serializare a datelor în dicționar — hstore / json_object. În plus, modulele de chei și valori pot fi generate, de asemenea, în două moduri, cu transformare internă sau externă în text: array_agg(i::text) / array_agg(i)::text[].
Să verificăm eficiența diferitelor tipuri de serializare într-un exemplu pur sintetic — serializăm un număr diferit de chei:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Script de evaluare: serializare
CU T CA (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 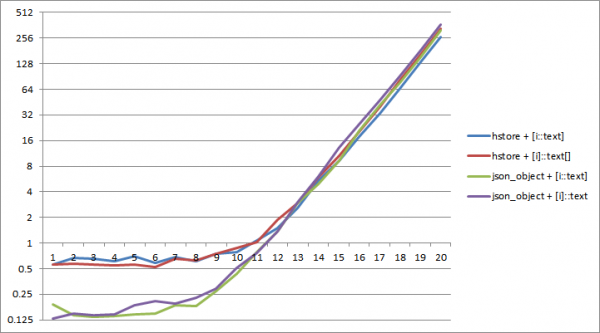
Pe PostgreSQL 11 aproximativ până la dimensiunea unui dicționar de 2^12 chei serializarea în json necesită mai puțin timp. În acest caz, combinația dintre json_object și conversia „internă” a tipurilor este cea mai eficientă array_agg(i::text).
Acum haideți să încercăm să citim valoarea fiecărei chei de 8 ori — de vreme ce dacă nu se accesează dicționarul, de ce este nevoie de el?
Script estimativ: citirea din dicționar
CU T CA (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              SELECT
                (TABLE dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 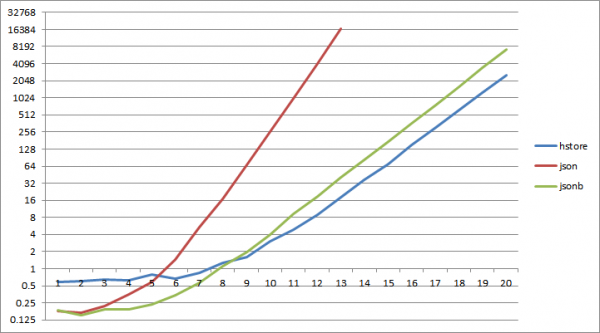
Și… deja aproximativ la 2^6 chei citirea din dicționarul json începe să piardă mult în comparație cu citirea din hstore, pentru jsonb același lucru se întâmplă la 2^9.
Concluziile finale:
- dacă trebuie să faceți JOIN cu înregistrări repetate de mai multe ori — este mai bine să folosiți „asocierea” tabelului
- dacă dicționarul dumneavoastră este așteptat mic și veți citi din el doar puțin — se poate folosi json[b]
- în toate celelalte cazuri hstore + array_agg(i::text) va fi mai eficient
Sursa: habr.com
