

Vă propun să cunoașteți transcrierea raportului din începutul anului 2016 al lui Vladimir Sitnikov "PostgreSQL și JDBC: Extragem tot ce este mai bun"
Bună ziua! Numele meu este Vladimir Sitnikov. Lucrez de 10 ani în compania NetCracker. În principal, mă ocup cu performanța. Tot ce are legătură cu Java și SQL - acestea sunt lucrurile pe care le îndrăgesc.
Și astăzi vă voi vorbi despre ce am întâmpinat în companie când am început să folosim PostgreSQL ca server de baze de date. În principal lucrăm cu Java. Însă, ceea ce voi povesti astăzi se leagă nu doar de Java. După cum arată practica, acest lucru apare și în alte limbaje.
Vom discuta despre:
- selectarea datelor.
- salvarea datelor.
- de asemenea, despre performanță.
- Și despre capcanele ascunse care sunt acolo.
Să începem cu o întrebare simplă. Alegem o linie din tabel după cheia primară.
Baza de date se află pe același host. Și tot acest lucru durează 20 de milisecunde.
Aceste 20 de milisecunde sunt foarte multe. Dacă aveți 100 de astfel de cereri, atunci petreceți timp în fiecare secundă pentru a procesa aceste cereri, adică pierdeți timpul în van.
Nu ne place să facem asta și ne uităm la ceea ce ne oferă baza de date pentru aceasta. Baza de date ne propune două variante de execuție a cererilor.
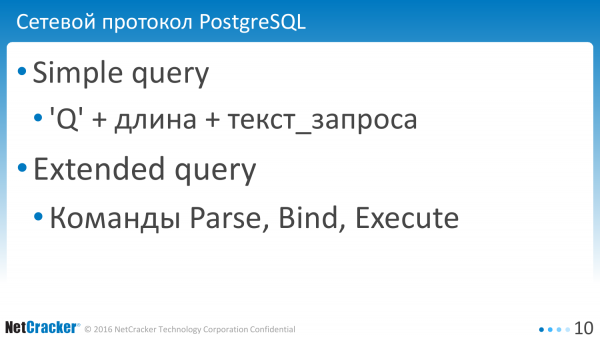
Prima variantă - este o cerere simplă. Ce este bun la ea? Că o luăm și o trimitem, și nimic mai mult.
Baza are și o cerere extinsă, care este mai sofisticată, dar mai funcțională. Se pot trimite separat cereri pentru analiză, execuție, legarea variabilelor etc.
Cererea super extinsă - este ceea ce nu vom acoperi în prezentarea curentă. Poate vrem ceva de la baza de date și există această listă de dorințe, care este formulată într-un anumit fel, adică acestea sunt lucrurile pe care le dorim, dar nu sunt posibile acum și în anul următor. Așa că am scris-o și vom merge să-i întrebăm pe cei principali.
Iar ceea ce putem face sunt cererea simplă și cererea extinsă.
Care este specificitatea fiecărui abordare?
Cererea simplă este bine de folosit pentru execuții ocazionale. O dată ce a fost executată, o uităm. Și problema este că nu suportă formatul binar de date, adică pentru anumite sisteme de înaltă performanță nu este adecvat.
Interogarea extinsă – vă ajută să economisiți timp în procesul de parsare. Acesta este ceea ce am realizat și am început să folosim. Ne-a ajutat enorm. Acolo nu există doar economii în parsare. Există economii și în transferul de date. Transmiterea datelor în format binar este mult mai eficientă.
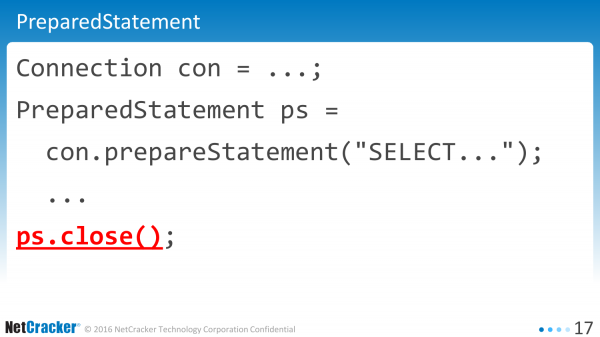
Să trecem la practică. Iată cum arată o aplicație tipică. Poate fi Java etc.
Am creat un statement. Am executat comanda. Am creat un close. Unde este greșeala aici? Care este problema? Nu există probleme. Așa este scris în toate cărțile. Așa trebuie să scriem. Dacă doriți o performanță maximă, scrieți așa.
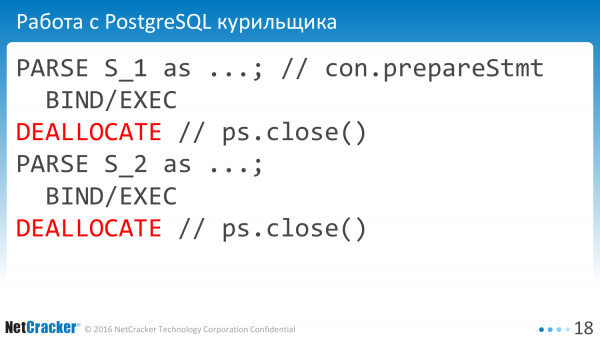
Dar practica a arătat că aceasta nu funcționează. De ce? Pentru că avem metoda „close”. Și când facem așa, din punctul de vedere al bazei de date, este ca și cum un fumător ar lucra cu baza de date. Am spus „PARSE EXECUTE DEALLOCATE”.
De ce aceste creații și descărcări inutile de statements? Nimeni nu are nevoie de ele. Dar de obicei, în PreparedStatement așa se întâmplă, când le închidem, acestea închid tot în baza de date. Nu aceasta este ceea ce ne dorim.
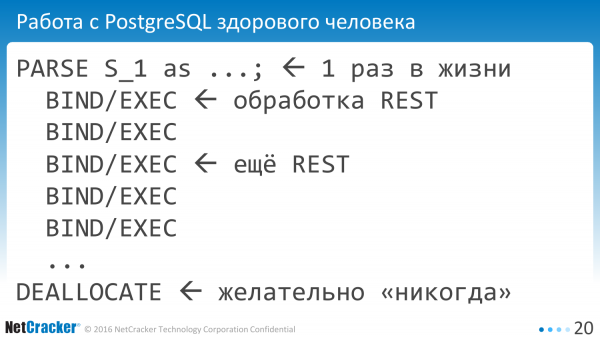
Vrem să lucrăm cu baza de date ca oamenii sănătoși. O dată am luat și pregătit statementul nostru, apoi îl executăm de multe ori. De fapt, multe ori – este o dată pe parcursul întregii vieți a aplicației când l-am parcurs. Și folosim același id de statement pe diferite REST-uri. Aceasta este scopul nostru.
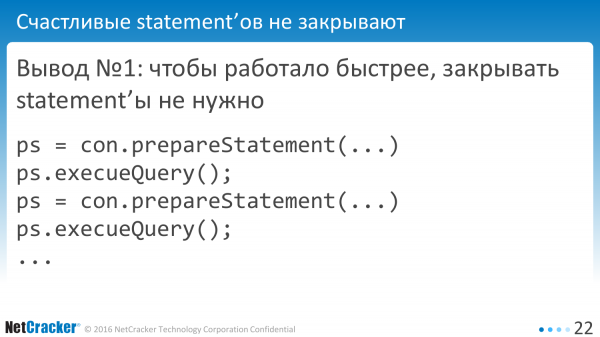
Cum putem realiza acest lucru?
Foarte simplu – nu trebuie să închidem statements. Scriem așa: „prepare” „execute”.
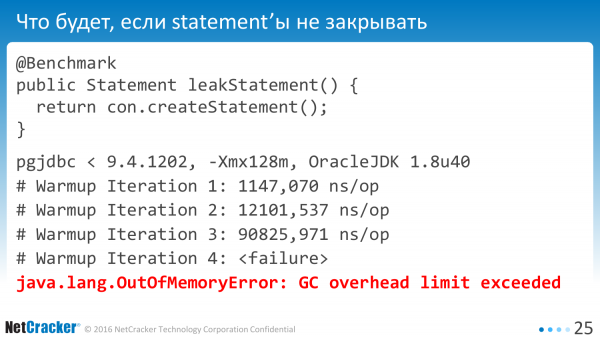
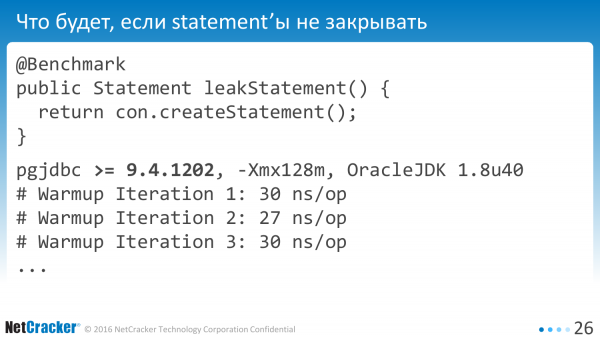
Dacă lansăm așa ceva, este evident că undeva se va depăși capacitatea. Dacă nu este clar, putem măsura. Să luăm și să scriem un benchmark în care să fie o metodă atât de simplă. Creăm un statement. Îl rulăm pe o anumită versiune a driverului și constatăm că se prăbușește destul de repede, pierzând toată memoria care a fost consumată.
Este clar că astfel de erori sunt ușor de corectat. Nu voi vorbi despre ele. Dar voi spune că în noua versiune funcționează mult mai repede. Este o metodă inutilă, dar cu toate acestea.
Cum să lucrăm corect? Ce trebuie să facem pentru aceasta?
În realitate, aplicațiile închid întotdeauna statements. În toate cărțile se spune să le închideți, altfel memoria va scăpa.
Și PostgreSQL nu poate să cacheze interogările. Fiecare sesiune trebuie să își creeze singură acest cache.
Și nu vrem să pierdem timp pe parsare.
Și, ca de obicei, avem două opțiuni.
Prima variantă – luăm și spunem că să împachetăm totul în PgSQL. Acolo există cache. Totul este cache-uit. Va fi minunat. Am analizat așa ceva. Avem 100500 de cereri. Nu funcționează. Nu suntem de acord să transformăm cererile manual în proceduri. Nu, nu.
Avem o a doua variantă – să luăm și să facem noi. Deschidem sursele, începem să modificăm. Continuăm să modificăm. A rezultat că nu este atât de complicat de realizat.
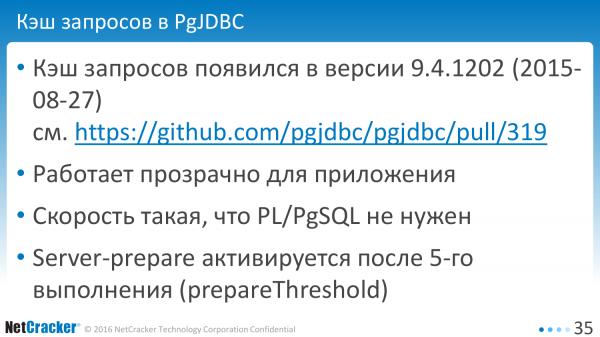
A apărut asta în august 2015. Acum există deja o versiune mai modernă. Și totul este grozav. Funcționează atât de bine încât nu mai facem nicio modificare în aplicație. Și chiar am încetat să ne gândim la PgSQL, adică ne-a fost suficient pentru a reduce practic cheltuielile la zero.
Prin urmare, declarațiile pregătite la nivel de server se activează la a cincea execuție pentru a nu consuma memorie în baza de date pentru fiecare cerere unică.
Se poate întreba – unde sunt cifrele? Ce obțineți? Și aici nu voi oferi cifre, deoarece fiecare cerere are propriile sale cifre.
Am avut cereri de genul că cheltuiam cam 20 de milisecunde pe analiză la cererile OLTP. Acolo erau 0,5 milisecunde pentru execuție, 20 de milisecunde pentru analiză. Cererea – 10 KiB de text, 170 de rânduri în plan. Aceasta este o cerere OLTP. Solicită 1, 5, 10 rânduri, uneori mai multe.
Dar nu ne-am dorit deloc să cheltuim 20 de milisecunde. Am redus totul la 0. Totul este grozav.
Ce puteți să deduceți de aici? Dacă aveți Java, luați versiunea modernă a driverului și vă bucurați.
Dacă aveți un alt limbaj, gândiți-vă – poate că ar trebui și voi? Deoarece din perspectiva limbajului final, de exemplu, dacă aveți PL 8 sau LibPQ, nu este evident că pierdeți timp nu pentru execuție, ci pentru analiză, iar asta merită verificată. Cum? Totul este gratuit.
Cu excepția faptului că există erori, anumite particularități. Și despre ele vom vorbi acum. O mare parte va fi despre arheologia industrială, despre ce am descoperit, la ce ne-am ciocnit.
Dacă cererea se generează dinamic. Așa ceva se întâmplă. Cineva concatenează șirurile, rezultând o cerere SQL.
De ce este aceasta proastă? Este proastă pentru că, în final, obținem de fiecare dată un șir diferit.
Și această linie diversă trebuie să recalculeze din nou hashCode. Aceasta este cu adevărat o sarcină CPU – găsirea unui text lung al interogării într-un hash existent nu este atât de simplă. Ceea ce înseamnă că regula este simplă – nu generați interogări. Stocați-le într-o singură variabilă. Și bucurați-vă.
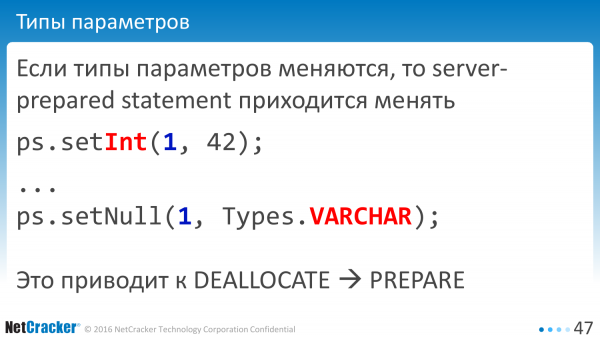
Următoarea problemă. Tipurile de date sunt importante. Există ORM-uri care spun că nu contează ce NULL există, să fie unul oarecare. Dacă este Int, spunem setInt. Iar dacă este NULL, atunci să fie întotdeauna VARCHAR. Și, în fond, ce contează ce NULL? Baza de date înțelege de la sine totul. Și acest scenariu nu funcționează.
În practică, baza de date nu îi pasă deloc. Dacă prima dată ați spus că este un număr, iar a doua dată ați spus că este VARCHAR, atunci nu se pot reutiliza afirmațiile pregătite de server. Și în acest caz, trebuie să recreați din nou afirmația.
Dacă efectuați aceeași interogare, aveți grijă să nu vă confundați tipurile de date în coloană. Trebuie să fiți atenți la NULL. Aceasta este o eroare frecventă pe care am avut-o după ce am început să folosim PreparedStatements.
Bine, am activat. Poate că am luat un driver. Și performanța a scăzut. Totul a devenit rău.
Cum poate fi așa? Este un bug sau o caracteristică? Din păcate, nu am reușit să înțelegem – este un bug sau o caracteristică. Dar există un scenariu destul de simplu pentru a reproduce această problemă. Ne-a surprins complet. Și constă în selectarea literalmente dintr-un singur tabel. Desigur, am avut mai multe astfel de interogări. În general, acestea includeau două-trei tabele, dar există un astfel de scenariu de reproducere. Luați baza dumneavoastră de date din orice versiune și reproduceți.
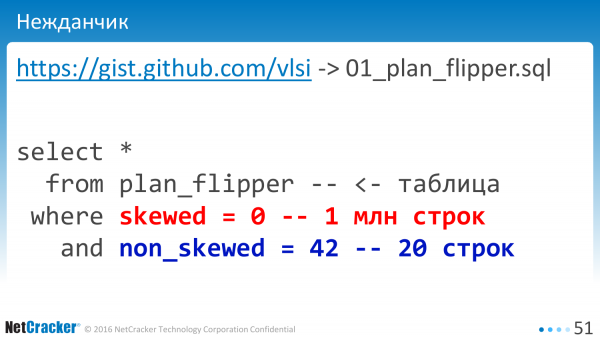
Ideea este că avem două coloane, fiecare indexată. Într-o coloană, la valoarea NULL, sunt un milion de rânduri. Iar în cealaltă coloană sunt doar 20 de rânduri. Când executăm fără variabile corelate, atunci totul funcționează bine.
Dacă începem să executăm cu variabile corelate, adică executăm semnul „?” sau „$1” pentru interogarea noastră, atunci ce obținem în cele din urmă?
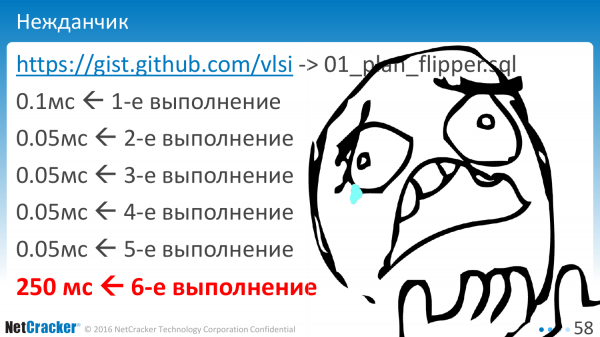
Prima execuție – așa cum trebuie. A doua – puțin mai repede. Unele lucruri s-au pus în cache. A treia, a patra, a cincea. Apoi, bam – și așa a fost. Și ceea ce este cel mai rău, se întâmplă la a șasea execuție. Cine știa că trebuie să facem exact șase execuții pentru a înțelege care este cu adevărat planul de execuție?
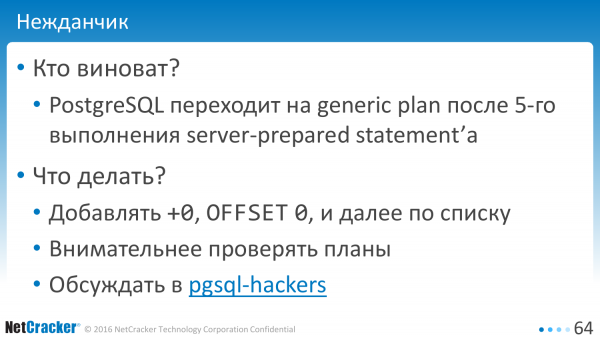
Cine este de vină? Ce s-a întâmplat? Baza de date conține o optimizare. Și este, într-un fel, optimizată pentru un caz generic. Așadar, începând de la un anumit punct, trece pe un plan generic, care, din păcate, poate fi diferit. Poate fi la fel, dar poate fi și diferit. Și există un anumit prag care duce la un asemenea comportament.
Ce se poate face în legătură cu asta? Aici, desigur, este mai complicat să facem vreo presupunere. Există o soluție simplă pe care o folosim. Este +0, OFFSET 0. Cu siguranță, cunoașteți astfel de soluții. Pur și simplu adăugăm „+0” în interogare și totul este bine. Voi arăta mai târziu.
Și există o altă opțiune – să ne uităm mai atent la planuri. Dezvoltatorul trebuie să nu scrie doar interogarea, ci și să spună „explain analyze” de 6 ori. Dacă o face de 5 ori, nu va fi suficient.
Și există o a treia opțiune – să scriem un mesaj pe pgsql-hackers. Am scris, dar nu este clar încă – este un bug sau o caracteristică.
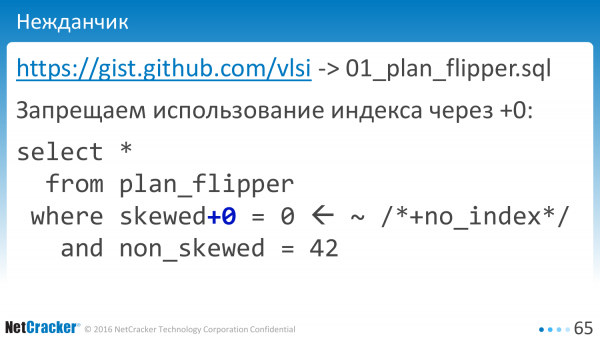
Până când ne gândim – este un bug sau o caracteristică, să reparăm. Să luăm interogarea noastră și să adăugăm „+0”. Totul este bine. Două caractere și nici măcar nu trebuie să ne gândim cum și ce. Foarte simplu. Pur și simplu am interzis bazei de date să folosească indexul pe această coloană. Nu avem index pe coloana „+0” și totul, baza de date nu folosește indexul, totul este bine.
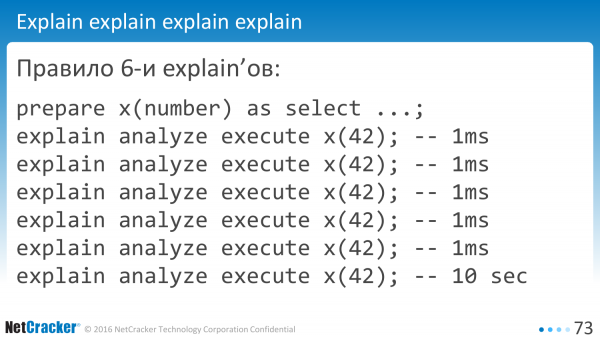
Iată regula celor 6 „explain-uri”. Acum, în versiunile curente, trebuie să o faci de 6 ori, dacă ai variabile legate. Dacă nu ai variabile legate, atunci facem așa. Și, în cele din urmă, anume această interogare eșuează. Nu este complicat.
Poate că pare că nu se poate? Aici este un bug, acolo este un bug. De fapt, bug-uri sunt peste tot.
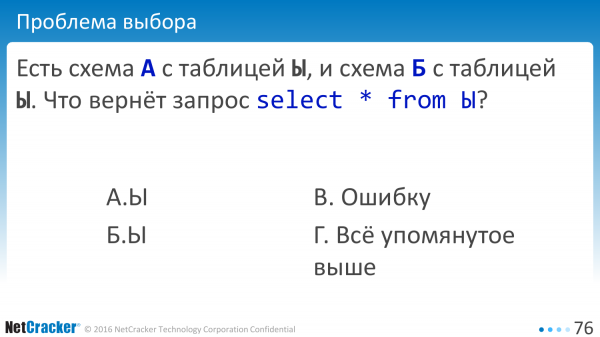
Hai să ne uităm și mai departe. De exemplu, avem două scheme. Schema A cu tabela Y și schema B cu tabela Y. Interogarea – selectați date din tabel. Ce avem în acest caz? Vom avea o eroare. Tot ce am menționat anterior va apărea. Regula este astfel – bug-uri sunt peste tot, vom avea tot ce am menționat anterior.
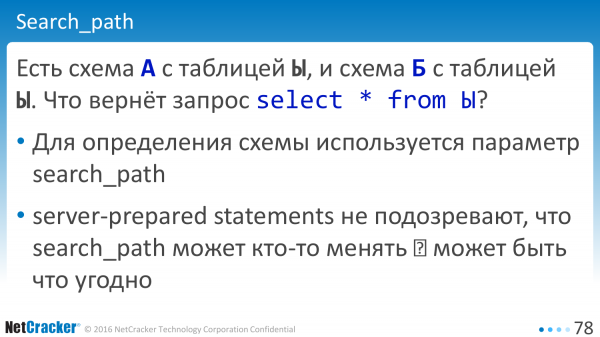
Acum întrebarea: „De ce?”. Poate că există documentație care spune că, dacă avem o schemă, există variabila „search_path” care indică unde trebuie căutată tabela. Poate că variabila există.
Care este problema? Problema este că server-prepared statements nu suspectează că search_path ar putea fi modificat de cineva. Această valoare rămâne, într-un fel, constantă pentru baza de date. Și unele părți pot să nu preia noile valori.
Desigur, depinde de versiunea pe care o testați. Depinde de cât de mult diferă tabelele dumneavoastră. Iar versiunea 9.1 va executa pur și simplu vechile interogări. Versiunile noi pot detecta problemele și pot spune că aveți o eroare.
Cum se repară asta? Există o rețetă simplă – nu faceți așa. Nu trebuie să schimbați search_path în timpul funcționării aplicației. Dacă schimbați, mai bine să creați o nouă conexiune.
Putem discuta, adică să deschidem, să discutăm, să completăm. Poate că vom convinge dezvoltatorii bazei de date că în cazul în care cineva schimbă o valoare, baza de date ar trebui să spună clientului: „Uitați, s-a actualizat o valoare. Poate ar trebui să resetați declarațiile, să le recreați?”. Acum baza de date se comportă tăcut și nu informează în niciun fel despre schimbările intervenite în interiorul declarațiilor.
Și înapoi subliniez – asta nu este tipic pentru Java. Vom vedea același lucru în PL/pgSQL unul la unul. Dar acolo va fi reprodus.
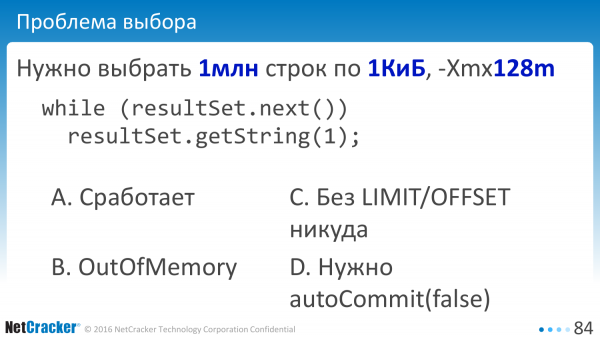
Hai să încercăm încă o dată să selectăm datele. Selectăm, selectăm. Avem un tabel cu un milion de rânduri. Fiecare rând are un kilobyte. Aproape un gigabyte de date. Și avem memorie de lucru în mașina Java de 128 megabytes.
Noi, așa cum este recomandat în toate cărțile, folosim procesarea pe flux. Adică deschidem resultSet și citim din el datele puțin câte puțin. Va funcționa asta? Nu va cădea din cauza memoriei? Va citi puțin câte puțin? Hai să ne punem încrederea în bază, în Postgres să ne punem încrederea. Nu ne încredem. Vom cădea în OutOfMemory? Cine a căzut în OutOfMemory? Și cine a reușit să repare după asta? Cineva a reușit să repare.
Dacă aveți un milion de rânduri, nu puteți să selectați pur și simplu. Trebuie neapărat OFFSET / LIMIT. Cine este pentru această opțiune? Și cine este pentru opțiunea că trebuie să ne jucăm cu autoCommit?
Aici, ca de obicei, cea mai neașteptată opțiune se dovedește a fi corectă. Și dacă întâmplător opriți autoCommit, va ajuta. De ce? Științei nu este cunoscut.
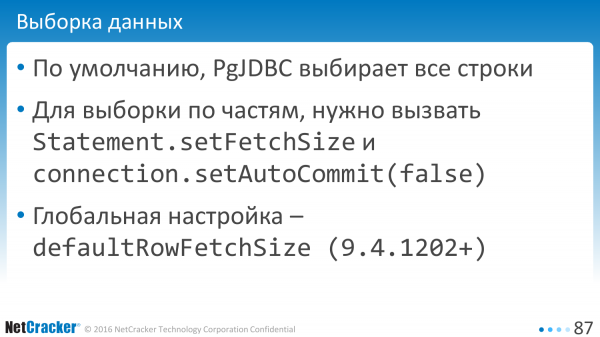
Dar în mod implicit toate clientele care se conectează la baza de date Postgres selectează datele în întregime. PgJDBC în acest sens nu face excepție, selectează toate rândurile.
Există o variație pe tema FetchSize, adică puteți la nivelul unui anumit statement să spuneți că aici, vă rugăm, alegeți datele câte 10, 50. Dar asta nu funcționează până nu opriți autoCommit. Opriți autoCommit – începe să funcționeze.
Dar a merge pe cod și a seta setFetchSize peste tot este incomod. De aceea, am creat o astfel de setare care va specifica valoarea implicită pentru întreaga conexiune.
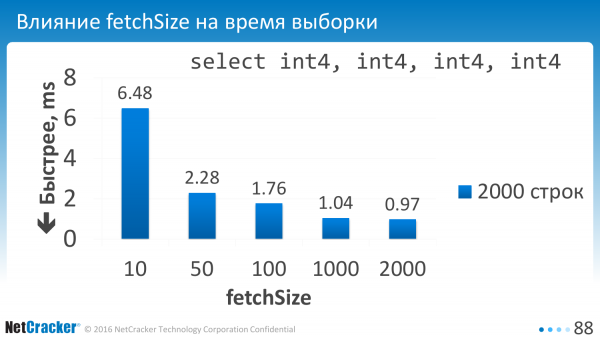
Iată, am spus asta. Am configurat parametrul. Și ce am obținut? Dacă alegem un număr mic, de exemplu, alegem câte 10 rânduri, avem costuri de overhead destul de mari. Așa că ar trebui să setăm această valoare la aproximativ o sută.
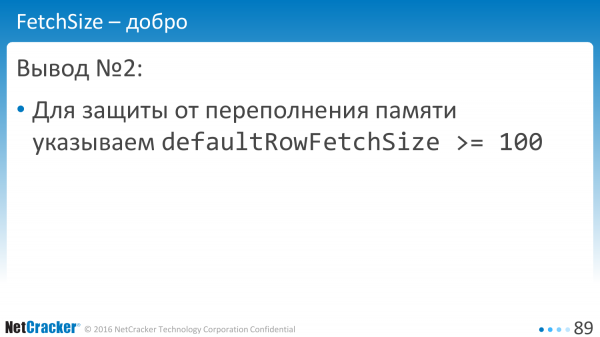
În ideal, bineînțeles, ar trebui să învățăm să limităm și în biți, dar rețeta este aceasta: setăm defaultRowFetchSize mai mare de o sută și ne bucurăm.
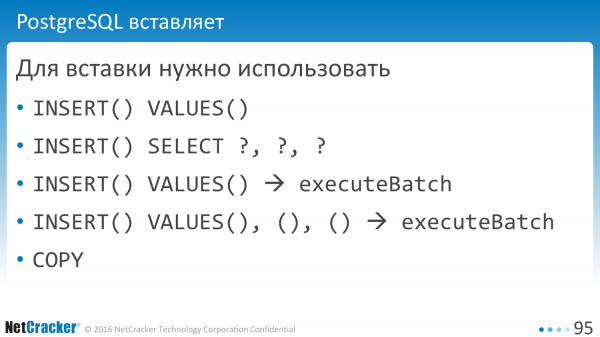
Hai să trecem la inserarea datelor. Inserarea este mai simplă, există diferite variante. De exemplu, INSERT, VALUES. Este o variantă bună. Putem spune „INSERT SELECT”. În practică, este același lucru. Nu există nicio diferență în performanță.
Cărțile spun că trebuie să executăm Batch statement, că putem executa comenzi mai complexe cu mai multe paranteze. Și în Postgres există o funcție minunată – putem face COPY, adică putem face asta mai repede.

Dacă măsurăm, putem descoperi din nou câteva lucruri interesante. Cum dorim să funcționeze acest lucru? Vrem să nu facem parsing și să nu executăm comenzi suplimentare.
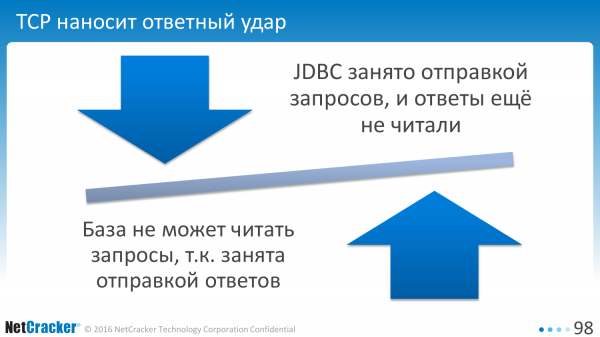
În practică, TCP nu ne permite să facem asta. Dacă clientul este ocupat cu trimiterea unei cereri, baza de date, în încercările de a ne trimite răspunsuri, nu citește cererile. În cele din urmă, clientul așteaptă baza de date să citească cererea, iar baza de date așteaptă clientul să citească răspunsul.
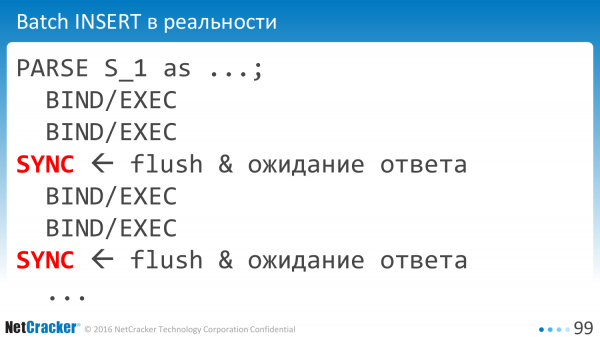
Și de aceea clientul este nevoit să trimită periodic un pachet de sincronizare. Interacțiuni de rețea inutile, pierderi de timp suplimentare.
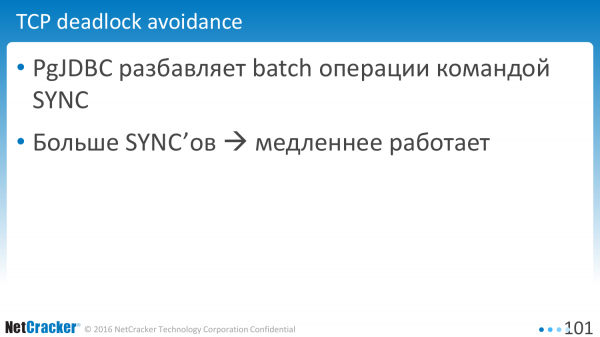 Și cu cât adăugăm mai multe, cu atât devine mai rău. Driverul este destul de pesimist și le adaugă destul de des, aproximativ o dată la 200 de rânduri, în funcție de dimensiunea rândurilor etc.
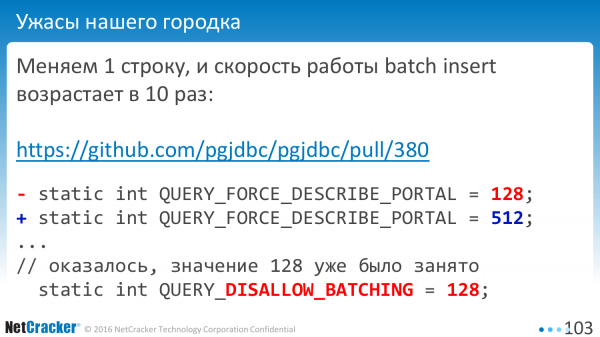
Se întâmplă uneori să corectezi un singur rând și totul se accelerează de zece ori. Asta se întâmplă. De ce? Ca de obicei, o constantă a fost folosită deja undeva. Și valoarea „128” însemna – nu folosi batching.
E bine că asta nu a ajuns în versiunea oficială. Am descoperit înainte de a începe să lansăm versiunea. Toate valorile pe care le menționez se bazează pe versiunile moderne.
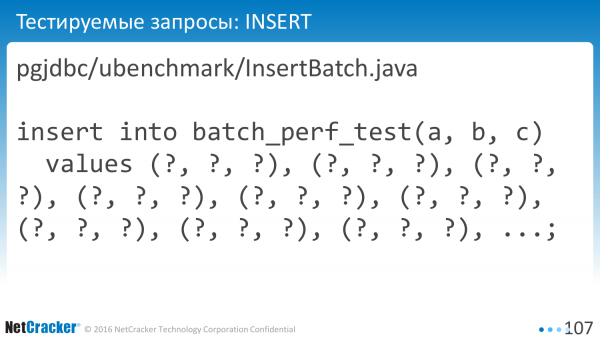
Hai să măsurăm. Măsurăm InsertBatch simplu. Măsurăm InsertBatch multiplă, adică același lucru, dar cu multe valori. O mișcare ingenioasă. Nu toată lumea știe să facă asta, dar este o mișcare simplă, mult mai simplă decât COPY.
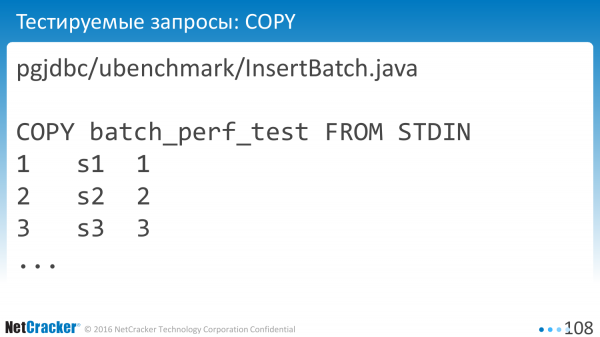
Se poate face COPY.
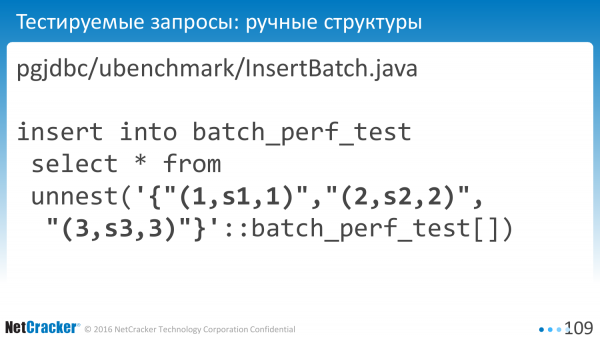
Și se poate face acest lucru pe structuri. Declarați User default type, transmiteți un array și inserați direct în tabel.
Dacă deschideți linkul: pgjdbc/ubenchmsrk/InsertBatch.java, acest cod se află pe GitHub. Puteți vedea exact ce interogări sunt generate acolo. Nu este esențial.
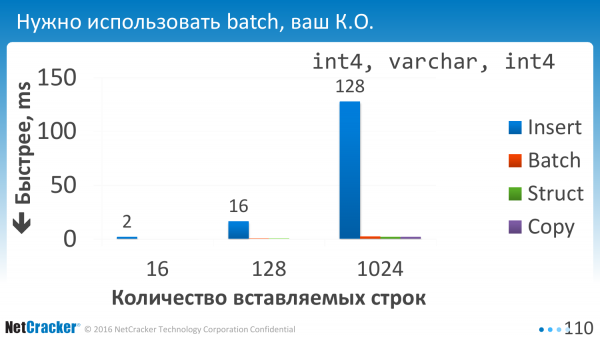
Am început. Și primul lucru pe care l-am realizat este că a nu folosi batch - este pur și simplu imposibil. Toate opțiunile de batching sunt egale cu zero, adică timpul de execuție este practic egal cu zero comparativ cu execuția unică.
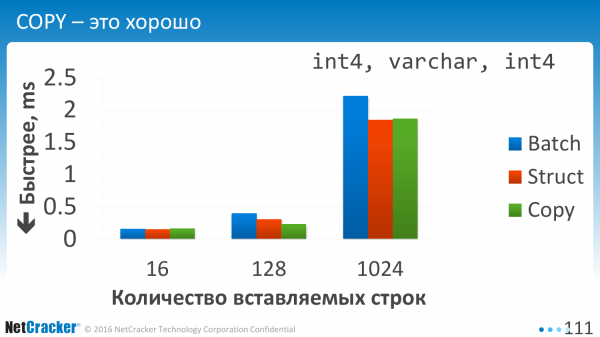
Inserăm date. Este o tabelă destul de simplă. Trei coloane. Și ce vedem aici? Vedem că toate aceste trei variante sunt aproximativ comparabile. Și COPY, desigur, este mai bun.
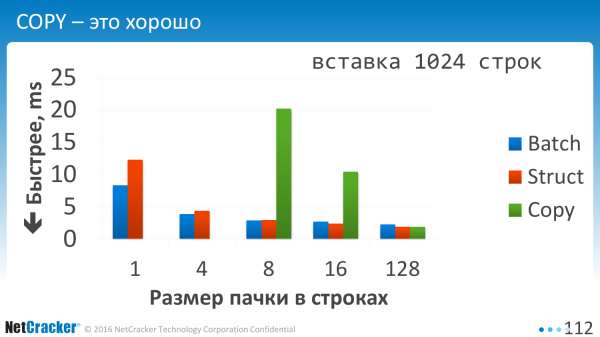
Este atunci când inserăm în bucăți. Atunci când am spus că o valoare VALUES, două valori VALUES, trei valori VALUES sau am specificat 10 separate prin virgulă. Asta este acum pe orizontală. 1, 2, 4, 128. Se observă că Batch Insert, care este reprezentat cu albastru, îi devine astfel mult mai ușor. Adică, atunci când inserați câte unul sau chiar când inserați câte patru, se îmbunătățește de două ori, doar din faptul că am introdus puțin mai mult în VALUES. Mai puține operațiuni EXECUTE.
Utilizarea COPY pentru volume mici este extrem de nepromițătoare. La primele două nici măcar nu le-am desenat. Ele se duc în cer, adică aceste cifre verzi pentru COPY.
COPY trebuie utilizat atunci când volumul de date este de cel puțin mai mult de o sută de rânduri. Cheltuielile administrative pentru deschiderea acestei conexiuni sunt mari. Și, sincer, nu am investigat în această direcție. Am optimizat batch-ul, pe COPY nu.
Ce facem mai departe? Am măsurat. Înțelegem că trebuie să folosim fie structuri, fie un batch ingenios care să combine mai multe valori.
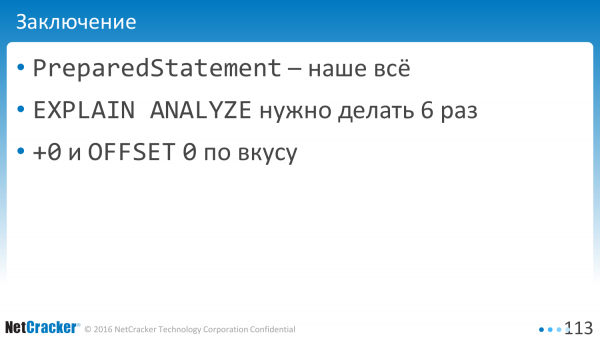
Ce trebuie să reținem din raportul de astăzi?
- PreparedStatement – este totul pentru noi. Oferă foarte mult pentru performanță. Aduce o mare cantitate de probleme.
- Și trebuie să facem EXPLAIN ANALYZE de 6 ori.
- Și trebuie să diluăm OFFSET 0, și să facem trucuri precum +0 pentru a corecta procentul rămas din interogările noastre problematice.
Sursa: habr.com
