

Traducerea articolului a fost pregătită special pentru studenții cursului .
În ultimele câteva săptămâni, am adăugat în formatul binar de streaming, completând deja formatul existent de fișiere de acces aleatoriu / IPC. Avem implemente în Java și C++ și legături pentru Python. În acest articol, voi explica cum funcționează formatul și voi arăta cum se poate atinge o capacitate foarte mare de transfer de date pentru DataFrame pandas.
Streaming de date coloana
O întrebare comună pe care o primesc de la utilizatorii Arrow este legată de costul ridicat al transferului unor seturi mari de date tabulare dintr-un format orientat pe linii sau înregistrări într-un format coloanal. Pentru seturi de date mari, transpunerea în memorie sau pe disc poate fi o sarcină imposibil de realizat.
Pentru streamingul de date, indiferent că sursa este de tip liniar sau coloană, una dintre opțiuni rămâne trimiterea unor pachete mici de linii, fiecare având o compunere pe coloane în interior.
În Apache Arrow, colecția de array-uri coloară în memorie, care reprezintă un bloc al unui tabel, se numește pachet de înregistrări (record batch). Pentru a reprezenta o structură unitară a datelor într-un tabel logic, se pot aduna mai multe pachete de înregistrări.
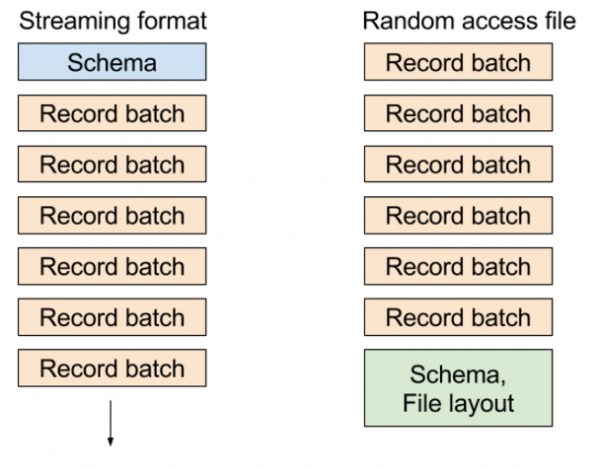
În formatul existent de fișiere „acces aleatoriu”, scriem metadatele care conțin schema tabelului și locația blocurilor la finalul fișierului, ceea ce permite selectarea extrem de ieftină a oricărui pachet de înregistrări sau a oricărei coloane din setul de date. În formatul de streaming, trimitem o serie de mesaje: schema, urmată de unul sau mai multe pachete de înregistrări.
Diferite formate arată cam așa cum este reprezentat în această imagine:
Streaming de date în PyArrow: aplicație
Pentru a vă arăta cum funcționează, voi crea un exemplu de set de date care reprezintă un chunk de streaming:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Acum, să presupunem că vrem să scriem 1 GB de date, compus din chunks de 1 MB fiecare, totalizând 1024 de chunks. În primul rând, să creăm primul DataFrame de 1 MB cu 16 coloane:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Apoi, îi voi converti în pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Acum voi crea un flux de ieșire care va scrie în memoria RAM și voi crea StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Apoi, vom scrie 1024 de chunk-uri, care vor forma în total 1GB de date:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Deoarece am scris în RAM, întregul flux îl putem obține într-un singur buffer:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Deoarece aceste date sunt în memorie, citirea pachetelor de înregistrări Arrow se realizează printr-o operațiune zero-copy. Deschid StreamReader și citesc datele în pyarrow.Table, și apoi le convertesc în DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Toate acestea sunt, bineînțeles, bune, dar s-ar putea să aveți întrebări. Cât de repede se întâmplă acest lucru? Cum influențează dimensiunea chunk-ului performanța obținerii unui DataFrame pandas?
Performanța fluxului de date
Pe măsură ce dimensiunea chunk-ului din fluxul de date scade, costul reconstrucției unui cadru de date colonne continuu în pandas crește din cauza schemelor de acces la cache ineficiente. Există, de asemenea, unele cheltuieli generale datorate lucrului cu structuri de date C++ și array-uri și buffer-urile lor de memorie.
Pentru 1 MB, așa cum s-a menționat mai sus, pe laptopul meu (Quad-core Xeon E3-1505M), rezultatul este:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Astfel, lățimea de bandă eficientă este de 7.75 GB/s pentru recuperarea unui DataFrame de 1GB din 1024 de chunk-uri de 1MB. Ce se întâmplă dacă folosim chunk-uri de dimensiuni mai mari sau mai mici? Iată rezultatele:
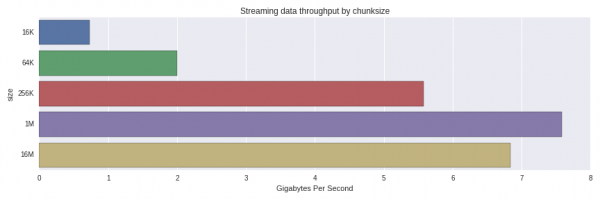
Performanța scade considerabil de la chunk-uri de 256K la 64K. M-a surprins faptul că chunk-urile de 1 MB au fost procesate mai repede decât cele de 16 MB. Este nevoie de o cercetare mai amănunțită pentru a înțelege dacă aceasta este o distribuție normală sau dacă influențează altceva.
În implementarea curentă a formatului, datele nu sunt comprimate, așadar dimensiunea în memorie și "în cabluri" este practic aceeași. În viitor, comprimarea ar putea deveni o opțiune suplimentară.
Rezultatul
Transmiterea datelor pe coloane poate fi o modalitate eficientă de a transfera seturi mari de date în instrumente analitice pe coloane, cum ar fi pandas, prin intermediul unor chunk-uri mici. Serviciile de date care utilizează stocarea orientată pe rânduri pot transmite și transpune chunk-uri mici de date, care sunt mai prietenoase cu cache-ul L2 și L3 al procesorului dumneavoastră.
Codul complet
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Sursa: habr.com
