

Bună, Habr.
Recent am despre ce parametrii folosim cel mai adesea în echipă pentru Kafka Producer și Consumer pentru a ne apropia de livrarea garantată. În acest articol vreau să discut despre cum am organizat procesarea repetată a evenimentului primit din Kafka, ca urmare a indisponibilității temporare a unei sisteme externe.
Aplicațiile moderne funcționează într-un mediu foarte complex. Logica de afaceri, învăluită în o stivă tehnologică modernă, funcționează într-o imagine Docker, gestionată de un orchestrator precum Kubernetes sau OpenShift, și comunică cu alte aplicații sau soluții enterprise printr-o serie de routere fizice și virtuale. Într-un astfel de mediu, mereu poate apărea ceva care se strică, astfel că procesarea repetată a evenimentelor în cazul în care una dintre sistemele externe devine indisponibilă este o parte importantă a proceselor noastre de afaceri.
Cum era înainte de Kafka
Anterior, în proiect, foloseam IBM MQ pentru livrarea asincronă a mesajelor. Când apărea vreo eroare în procesul de funcționare a serviciului, mesajul primit putea fi plasat într-o coadă de mesaje moarte (DLQ) pentru o analiză ulterioară manuală. DLQ era creată lângă coada de intrare, mutarea mesajului având loc în interiorul IBM MQ.
Dacă eroarea avea un caracter temporar și puteam determina asta (de exemplu, ResourceAccessException în timpul unui apel HTTP sau MongoTimeoutException în timpul unei interogări în MongoDb), atunci intervenea strategia de apeluri repetate. Indiferent de ramificarea logicii aplicației, mesajul original era mutat fie în coada sistemului pentru trimitere întârziată, fie în o aplicație separată, care a fost creată cu mult timp în urmă pentru retrimiterea mesajelor. În acest context, în antetul mesajului se înregistra numărul de retrimitere, care era legat de intervalul de întârziere sau de sfârșitul strategiei la nivel de aplicație. Dacă am atins sfârșitul strategiei, dar sistemul extern era încă indisponibil, mesajul era plasat în DLQ pentru analiză manuală.
Căutarea soluției
, poți găsi următoarele . Pe scurt, se propune să se creeze o temă pentru fiecare interval de întârziere și să se implementeze de partea aplicației Consumers care vor citi mesajele cu întârzierea necesară.
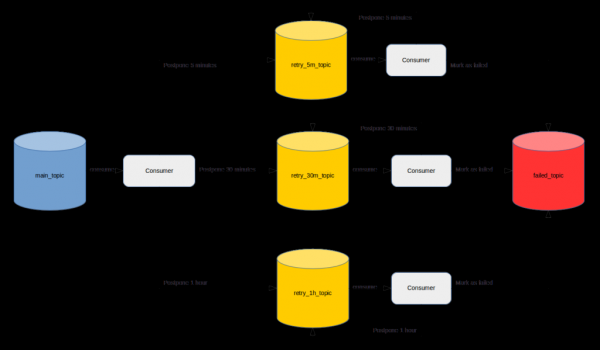
În ciuda numeroaselor recenzii pozitive, mi se pare că nu este complet reușit. În primul rând, deoarece dezvoltatorul, pe lângă implementarea cerințelor de afaceri, va trebui să aloce mult timp pentru realizarea mecanismului descris.
În plus, dacă pe clusterul Kafka este activată gestionarea accesului, va trebui să aloce ceva timp pentru a crea topicuri și a asigura accesul necesar la acestea. În plus, va trebui să selecteze parametrul corect retention.ms pentru fiecare din topicurile de retry, astfel încât mesajele să fie retransmise în timp și să nu dispară din acestea. Implementarea și solicitarea accesului va trebui repetată pentru fiecare serviciu existent sau nou.
Să vedem acum ce mecanisme de procesare repetată a mesajelor ne oferă spring în general și spring-kafka în special. Spring-kafka are o dependență tranzitivă de spring-retry, care oferă abstrații pentru gestionarea diferitelor BackOffPolicy. Acesta este un instrument destul de flexibil, dar dezavantajul său semnificativ este stocarea mesajelor pentru retransmitere în memoria aplicației. Asta înseamnă că repornirea aplicației din cauza unei actualizări sau a unei erori în timpul utilizării va duce la pierderea tuturor mesajelor care așteaptă procesarea repetată. Deoarece acest punct este critic pentru sistemul nostru, nu l-am mai analizat ulterior.
Spring-kafka în sine oferă mai multe implementări ale ContainerAwareErrorHandler, de exemplu, , cu ajutorul căruia se poate, fără a muta offset-ul în caz de eroare, procesa mesajul mai târziu. Începând cu versiunea spring-kafka 2.3, a apărut posibilitatea de a defini BackOffPolicy.
Această abordare permite mesajelor retrase să supraviețuiască repornirii aplicației, dar mecanismul DLQ este încă absent. Acesta a fost variantă pe care am ales-o la începutul anului 2019, fiind optimști că DLQ nu va fi necesar (am avut noroc și într-adevăr nu a fost nevoie în câteva luni de utilizare a aplicației cu un astfel de sistem de procesare repetată). Erorile temporare au dus la activarea SeekToCurrentErrorHandler. Celelalte erori au fost tipărite în loguri, au dus la mutarea offset-ului și procesarea a continuat cu următorul mesaj.
Soluția finală
Implementarea bazată pe SeekToCurrentErrorHandler ne-a împins să dezvoltăm un mecanism propriu pentru retransmiterea mesajelor.
În primul rând, am dorit să folosim experiența existentă și să o extindem în funcție de logica aplicației. Pentru o aplicație cu o logică liniară, ar fi optim să oprim citirea de noi mesaje pe o perioadă scurtă de timp, specificată în cadrul strategiei de retransmitere. Pentru celelalte aplicații, am dorit să avem un punct unic care să asigure implementarea strategiei de retransmitere. În plus, acest punct unic ar trebui să dispună de funcționalitatea DLQ pentru ambele abordări.
Strategia de retransmitere propriu-zisă ar trebui să fie stocată în aplicația responsabilă pentru obținerea următorului interval în cazul unei erori temporare.
Oprirea Consumer-ului pentru o aplicație cu logică liniară
Atunci când lucrăm cu spring-kafka, codul pentru oprirea Consumer-ului ar putea arăta cam așa:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // to DLQ
    }
În exemplu, retryAt este momentul în care trebuie să restartăm MessageListenerContainer, dacă acesta este încă activ. Restartarea va avea loc într-un fir de execuție separat, lansat în TaskScheduler, a cărei implementare o oferă de asemenea spring.
Valoarea retryAt o găsim în următorul mod:
- Se caută valoarea contorului de retransmiteri.
- Conform valorii contorului, se caută intervalul curent de întârziere în strategia de retransmitere. Strategia este declarată în cadrul aplicației, iar pentru stocarea acesteia am ales formatul JSON.
- Intervalul găsit în array-ul JSON conține numărul de secunde după care trebuie să repetăm procesarea. Acest număr de secunde este adăugat la timpul curent, formând valoarea pentru retryAt.
- Dacă intervalul nu este găsit, atunci valoarea retryAt este null și mesajul va fi trimis în DLQ pentru o analiză manuală.
Cu această abordare, trebuie doar să păstrăm numărul apelurilor repetate pentru fiecare mesaj care este acum în procesare, de exemplu, în memoria aplicației. Păstrarea unui contor de încercări în memorie nu este critică pentru această abordare, deoarece aplicația cu o logică liniară nu poate efectua procesarea în întregime. Spre deosebire de spring-retry, repornirea aplicației nu va duce la pierderea tuturor mesajelor pentru re-procesare, ci pur și simplu la reluarea strategiei.
Această abordare ajută la reducerea sarcinii asupra sistemului extern, care poate fi inaccesibil din cauza unei sarcini foarte mari. Cu alte cuvinte, în plus față de re-procesare, am realizat implementarea modelului .
În cazul nostru, pragul de eroare este doar 1, iar pentru a minimiza timpul de nefuncționare a sistemului din cauza unei întreruperi temporare a rețelei, folosim o strategie de apeluri repetitive foarte granulară cu intervale de întârzieri mici. Acest lucru poate să nu fie potrivit pentru toate aplicațiile grupului de companii, așa că raportul între pragul de eroare și dimensiunea intervalului trebuie ajustat, bazându-se pe caracteristicile sistemului.
O aplicație separată pentru procesarea mesajelor de la aplicații cu o logică nedeterministă
Iată un exemplu de cod care trimite un mesaj către o astfel de aplicație (Retryer), care va reîncerca trimiterea în topicul DESTINATION atunci când se atinge timpul RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Din exemplu, se observă că se transmite multe informații în header-e. Valoarea RETRY_AT se află la fel ca și pentru mecanismul de reîncercare prin oprirea Consumer-ului. Pe lângă DESTINATION și RETRY_AT, mai transmitem:
- GROUP_ID, care este utilizat pentru a grupa mesajele pentru analiza manuală și simplificarea căutării.
- ORIGINAL_PARTITION, pentru a încerca să păstrăm același Consumer pentru procesarea ulterioară. Acest parametru poate fi egal cu null, caz în care o nouă partition va fi obținută pe baza cheii record.key() a mesajului original.
- Valoarea actualizată COUNTER, pentru a respecta strategia de reîncercări.
- SEND_TO - constantă care arată dacă mesajul trebuie trimis pentru reprocesare la atingerea RETRY_AT sau să fie plasat în DLQ.
- REASON - motivul pentru care procesarea mesajului a fost oprită.
Retryer salvează mesajele pentru trimiterea ulterioară și analiza manuală în PostgreSQL. La un interval stabilit, o sarcină este activată care găsește mesajele cu RETRY_AT împlinit și le trimite înapoi în partition-ul ORIGINAL_PARTITION al topic-ului DESTINATION cu cheia record.key().
După trimiterea mesajului, acesta este șters din PostgreSQL. Analiza manuală a mesajelor se desfășoară într-o interfață simplă, care comunică cu Retryer prin REST API. Principalele funcții ale acesteia includ retransmiterea sau ștergerea mesajelor din DLQ, vizualizarea informațiilor despre erori și căutarea mesajelor, de exemplu, după numele erorii.
Dat fiind că gestionarea accesului este activată pe clusterele noastre, este necesar să se solicite suplimentar drepturi de acces pentru topic-ul pe care îl ascultă Retryer și să se permită Retryer-ului să scrie în topic-ul DESTINATION. Acest lucru este inconfortabil, dar, spre deosebire de abordarea cu topic-ul pe interval, obținem o DLQ complet funcțională și o interfață pentru gestionarea acesteia.
Există cazuri în care topic-ul de intrare este citit de mai multe grupuri de consumatori diferite, ale căror aplicații implementează o logică diferită. Reprocesarea unui mesaj prin Retryer pentru una dintre aceste aplicații va duce la un duplicat pe cealaltă. Pentru a ne proteja de această problemă, creăm un topic separat pentru reprocesare. Topic-ul de intrare și topic-ul de retry pot fi citite de același Consumer fără restricții.
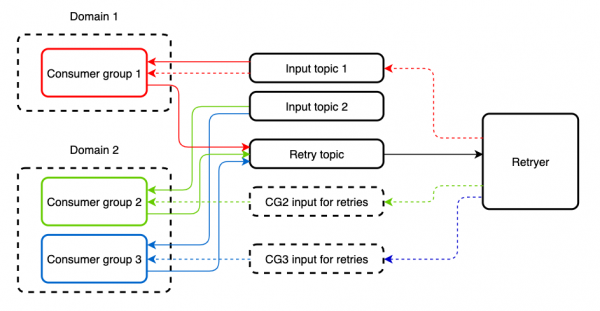
În mod implicit, această abordare nu oferă posibilitatea unui circuit breaker, dar acesta poate fi adăugat în aplicație cu ajutorul sau noul , învăluind locurile de apelare a serviciilor externe în abstracții corespunzătoare. De asemenea, devine posibilă alegerea unei strategii pentru pattern, ceea ce poate fi de asemenea util. De exemplu, în spring-cloud-netflix, acesta poate fi un thread pool sau un semafor.
Ieșire
Ca rezultat, am obținut o aplicație separată care permite repetarea prelucrării mesajului în cazul în care o sistem extern devine temporar indisponibil.
Unul dintre principalele avantaje ale aplicației este că poate fi utilizată de sistemele externe care funcționează pe același cluster Kafka, fără modificări semnificative de partea lor! Acelei aplicații îi va fi necesar doar să obțină acces la topicul de retry, să completeze câteva antete Kafka și să trimită mesajul în Retryer. Nu trebuie să ridice nicio infrastructură suplimentară. Și, pentru a reduce numărul de mesaje transferate din aplicație în Retryer și înapoi, am separat aplicațiile cu logică liniară și am implementat procesarea repetată prin oprirea Consumer-ului.
Sursa: habr.com
