

Introducere
În desfășurarea unui nou sistem, ne-am confruntat cu necesitatea de a procesa o cantitate mare de loguri diverse. Ca instrument, am ales ELK. În acest articol, vom vorbi despre experiența noastră în configurarea acestui stack.
Nu ne propunem să descriem toate posibilitățile sale, dar dorim să ne concentrăm pe rezolvarea problemelor practice. Aceasta se datorează faptului că, deși există o cantitate considerabilă de documentație și imagini deja pregătite, există multe capcane, cel puțin noi le-am descoperit.
Am desfășurat stack-ul prin docker-compose. Mai mult, aveam un docker-compose.yml bine scris, care ne-a permis să ridicăm stack-ul aproape fără probleme. Și ne părea că victoria era deja aproape, doar câteva ajustări necesare pentru nevoile noastre și totul va fi gata.
Din păcate, încercarea de a ajusta sistemul pentru a primi și procesa loguri de la aplicația noastră nu a avut succes imediat. Așa că am decis că ar fi bine să studiem fiecare componentă separat, pentru a reveni apoi la interconexiuni.
Așadar, am început cu logstash.
Mediul, desfășurarea, lansarea Logstash în container
Pentru desfășurare folosim docker-compose, experimentele descrise aici au fost efectuate pe MacOS și Ubuntu 18.04.
Imaginea logstash, care a fost specificată în docker-compose.yml-ul nostru, este docker.elastic.co/logstash/logstash:6.3.2
O vom folosi pentru experimente.
Pentru a lansa logstash am scris un docker-compose.yml separat. Bineînțeles, am putea lansa imaginea din linia de comandă, dar ne ocupăm de o sarcină specifică, unde totul este pornit din docker-compose.
Un scurt rezumat despre fișierele de configurare
După cum se menționează în descriere, logstash poate fi pornit atât pentru un singur canal, caz în care trebuie să-i fie transmis un fișier *.conf, cât și pentru mai multe canale, caz în care trebuie să-i fie transmis un fișier pipelines.yml, care, la rândul său, va face referire la fișiere .conf pentru fiecare canal.
Noi am ales cea de-a doua cale. Ni s-a părut mai versatilă și scalabilă. Așadar, am creat pipelines.yml și am realizat un director pipelines, în care vom plasa fișiere .conf pentru fiecare canal.
În interiorul containerului există un alt fișier de configurare — logstash.yml. Nu-l modificăm, îl folosim așa cum este.
Așadar, structura directoarelor noastre:
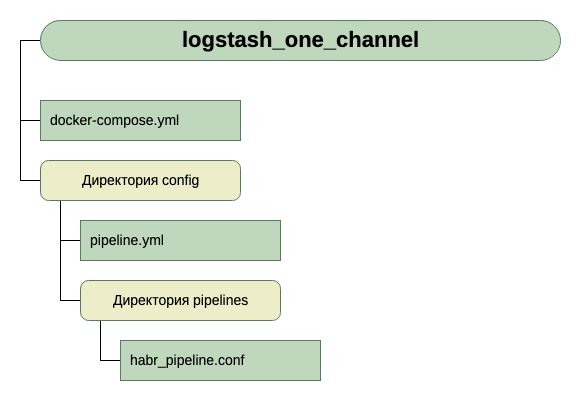
Pentru a obține datele de intrare, considerăm inițial că este vorba de tcp pe portul 5046, iar pentru ieșire vom folosi stdout.
Iată o configurație simplă pentru prima pornire. Deoarece scopul inițial este să pornim.
Așadar, avem acest docker-compose.yml
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      	- elk
    ports:
      	- 5046:5046
    volumes:
      	- ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
	- ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Ce vedem aici?
- Networks și volumes au fost preluate din docker-compose.yml original (acel fișier care rezolvă întreaga stivă de pornire) și cred că nu influențează foarte mult imaginea generală.
- Creăm un serviciu (services) logstash, din imaginea docker.elastic.co/logstash/logstash:6.3.2 și îi dăm numele logstash_one_channel.
- Redirecționăm portul 5046 în interiorul containerului, la același port intern.
- Mapăm fișierul nostru de configurare a canalelor ./config/pipelines.yml la fișierul /usr/share/logstash/config/pipelines.yml din interiorul containerului, de unde logstash îl va citi, și îl facem read-only, doar pentru siguranță.
- Mapăm directorul ./config/pipelines, unde avem fișierele cu configurațiile canalelor, în directorul /usr/share/logstash/config/pipelines și, de asemenea, îl facem read-only.
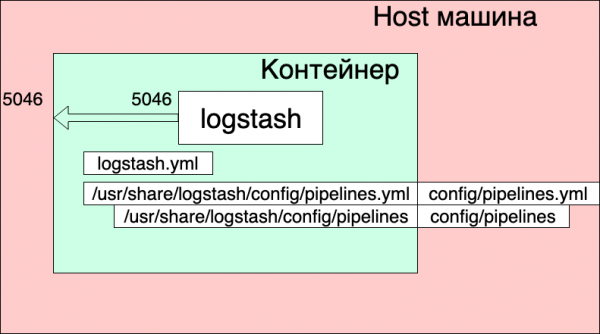
Fișierul pipelines.yml
- pipeline.id: HABR
  pipeline.workers: 1
  pipeline.batch.size: 1
  path.config: "./config/pipelines/habr_pipeline.conf"
Aici este descris un canal cu identificatorul HABR și calea către fișierul său de configurare.
Și în final, fișierul "./config/pipelines/habr_pipeline.conf"
input {
  tcp {
    port => "5046"
   }
  }
filter {
  mutate {
    add_field => [ "habra_field", "Hello Habr" ]
    }
  }
output {
  stdout {

    }
  }
Să nu ne aventurăm în descrierea sa pentru acum, să încercăm să-l pornim:
docker-compose up
Ce vedem?
Containerul a fost pornit. Putem verifica funcționarea sa:
echo '13123123123123123123123213123213' | nc localhost 5046
Și vedem în consola containerului răspunsul:
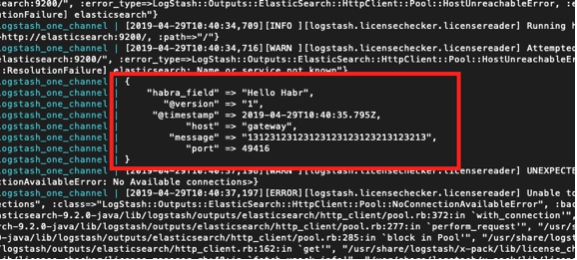
Dar în același timp, vedem de asemenea:
logstash_one_channel | [2019-04-29T11:28:59,790][ERROR][logstash.licensechecker.licensereader] Unable to retrieve license information from license server {:message=>"Elasticsearch Unreachable: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch", …
logstash_one_channel | [2019-04-29T11:28:59,894][INFO ][logstash.pipeline ] Pipeline started successfully {:pipeline_id=>".monitoring-logstash", :thread=>"#"}
logstash_one_channel | [2019-04-29T11:28:59,988][INFO ][logstash.agent ] Pipelines running {:count=>2, :running_pipelines=>[:HABR, :".monitoring-logstash"], :non_running_pipelines=>[]}
logstash_one_channel | [2019-04-29T11:29:00,015][ERROR][logstash.inputs.metrics ] X-Pack is installed on Logstash but not on Elasticsearch. Please install X-Pack on Elasticsearch to use the monitoring feature. Other features may be available.
logstash_one_channel | [2019-04-29T11:29:00,526][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600}
logstash_one_channel | [2019-04-29T11:29:04,478][INFO ][logstash.outputs.elasticsearch] Running health check to see if an Elasticsearch connection is working {:healthcheck_url=>http://elasticsearch:9200/, :path=>"/"}
logstash_one_channel | [2019-04-29T11:29:04,487][WARN ][logstash.outputs.elasticsearch] S-a încercat resuscitarea conexiunii la instanța ES moartă, dar s-a produs o eroare. {:url=>":9200/", :error_type=>LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=>"Elasticsearch inaccesibil: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch"}
logstash_one_channel | [2019-04-29T11:29:04,704][INFO ][logstash.licensechecker.licensereader] Se efectuează o verificare a sănătății pentru a vedea dacă o conexiune Elasticsearch funcționează {:healthcheck_url=http://elasticsearch:9200/, :path=>"/"}
logstash_one_channel | [2019-04-29T11:29:04,710][WARN ][logstash.licensechecker.licensereader] S-a încercat resuscitarea conexiunii la instanța ES moartă, dar s-a produs o eroare. {:url=>":9200/", :error_type=>LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=>"Elasticsearch inaccesibil: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch"}
Și logul nostru se mișcă constant în sus.
Aici am evidențiat cu verde mesajul că pipeline-ul s-a lansat cu succes, cu roșu — mesajul de eroare și cu galben — mesajul despre încercarea de a se conecta cu :9200.
Aceasta se întâmplă deoarece în logstash.conf, inclus în imagine, există o verificare a accesibilității elasticsearch. Logstash presupune că funcționează ca parte a stivei Elk, dar noi l-am separat.
Se poate lucra, dar nu este convenabil.
Soluția este să dezactivăm această verificare prin variabila de mediu XPACK_MONITORING_ENABLED.
Vom aduce o modificare în docker-compose.yml și reluăm:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Acum, totul este în regulă. Containărul este pregătit pentru experimente.
Putem scrie din nou în consola vecină:
echo '13123123123123123123123213123213' | nc localhost 5046
Și să vedem:
logstash_one_channel | {
logstash_one_channel |         "message" => "13123123123123123123123213123213",
logstash_one_channel |      "@timestamp" => 2019-04-29T11:43:44.582Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |            "host" => "gateway",
logstash_one_channel |            "port" => 49418
logstash_one_channel | }
Lucrul în cadrul unei singure canale
Deci, am pornit. Acum putem dedica timp configurării logstash-ului propriu-zis. Nu vom atinge încă fișierul pipelines.yml, să vedem ce putem obține lucrând cu un singur canal.
Trebuie menționat că principiul general de lucru cu fișierul de configurare a canalului este bine descris în documentația oficială, aici
Dacă dorești să citești în română, am folosit aceasta (dar sintaxa interogărilor este veche, trebuie să ținem cont de acest lucru).
Să trecem pas cu pas de la secțiunea Input. Am văzut deja lucrul prin tcp. Ce altceva poate fi interesant aici?
Mesaje de testare, folosind heartbeat
Există o oportunitate interesantă de a genera mesaje de test automate.
Pentru aceasta, trebuie să activăm pluginul heartbean în secțiunea input.
input {
  heartbeat {
    message => "HeartBeat!"
   }
  }
Activăm, vom începe să primim o dată pe minut
logstash_one_channel | {
logstash_one_channel |      "@timestamp" => 2019-04-29T13:52:04.567Z,
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "HeartBeat!",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "host" => "a0667e5c57ec"
logstash_one_channel | }
Dorim să primim mai des, trebuie să adăugăm parametrul interval.
Astfel, vom primi un mesaj la fiecare 10 secunde.
input {
  heartbeat {
    message => "HeartBeat!"
    interval => 10
   }
  }
Obținerea datelor din fișier
Am decis, de asemenea, să verificăm modul de funcționare file. Dacă funcționează bine cu fișierul, atunci poate nu va fi necesar niciun agent, cel puțin pentru utilizare locală.
Conform descrierii, modul de operare ar trebui să fie similar cu tail -f, adică citește noi linii sau, ca opțiune, citește întregul fișier.
Deci, ce vrem să obținem:
- Vrem să primim liniile care sunt adăugate într-un fișier de log.
- Vrem să primim datele care sunt scrise în mai multe fișiere de log, având capacitatea de a separa ce provine din fiecare.
- Vrem să verificăm că, la repornirea logstash, nu va primi aceste date din nou.
- Vrem să verificăm că, dacă logstash este oprit, iar datele continuă să fie scrise în fișiere, atunci când îl vom porni din nou, vom obține aceste date.
Pentru a efectua experimentul, adăugăm încă o linie în docker-compose.yml, deschizând directorul în care punem fișierele.
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
Și vom modifica secțiunea input din habr_pipeline.conf
input {
  file {
    path => "/usr/share/logstash/input/*.log"
   }
  }
Pornim:
docker-compose up
Pentru a crea și scrie fișiere de log, vom folosi comanda:
echo '1' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:53.876Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Aha, funcționează!
În acest mod, observăm că a fost adăugată automat câmpul path. Asta înseamnă că mai departe, vom putea filtra înregistrările după acesta.
Să încercăm din nou:
echo '2' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:59.906Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "2",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Acum într-un alt fișier:
echo '1' >> logs/number2.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:29:26.061Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log"
logstash_one_channel | }
Excelent! Fișierul a fost preluat, path-ul a fost specificat corect, totul este bine.
Oprim logstash și îl repornim. Așteptăm. Liniște. Adică, aceste înregistrări nu le primim din nou.
Acum pentru cel mai îndrăzneț experiment.
Punem logstash la somn și executăm:
echo '3' >> logs/number2.log
echo '4' >> logs/number1.log
Repornim logstash și vedem:
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "3",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.589Z
logstash_one_channel | }
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "4",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.856Z
logstash_one_channel | }
Ura! Totul a fost preluat.
Dar trebuie să avertizăm despre următoarele. Dacă containerul cu logstash este șters (docker stop logstash_one_channel && docker rm logstash_one_channel), atunci nimic nu va fi preluat. În interiorul containerului a fost păstrată poziția fișierului până la care acesta a fost citit. Dacă se pornește "de la zero", va prelua doar liniile noi.
Citirea fișierelor deja existente
Să presupunem că pornim logstash pentru prima dată, dar avem deja log-uri și am dori să le procesăm.
Dacă vom rula logstash cu secțiunea input, pe care am utilizat-o mai sus, nu vom obține nimic. Doar liniile noi vor fi procesate de logstash.
Pentru ca liniile din fișierele existente să fie preluate, este necesar să adăugăm o linie suplimentară în secțiunea input:
input {
  file {
    start_position => "beginning"
    path => "/usr/share/logstash/input/*.log"
   }
  }
Există o nuanță: aceasta se aplică doar fișierelor noi pe care logstash încă nu le-a văzut. Pentru fișierele care au fost deja procesate de logstash, acesta a memorat dimensiunea lor și acum va prelua doar noile înregistrări.
Ne vom opri aici cu studiul secțiunii input. Există multe alte opțiuni, dar pentru experimentele noastre deocamdată acestea sunt suficiente.
Rutare și transformare a datelor
Să încercăm să rezolvăm următoarea problemă: să presupunem că avem mesaje dintr-un canal, parte din ele sunt informaționale, iar altele sunt mesaje de eroare. Acestea se deosebesc prin etichete. Unii sunt INFO, alții sunt ERROR.
Trebuie să le separăm la ieșire. Adică, mesajele informaționale le scriem într-un canal, iar mesajele de eroare într-altul.
Pentru aceasta, vom trece de la secțiunea input la filter și output.
Cu ajutorul secțiunii filter vom analiza mesajul de intrare, obținând din acesta un hash (perechi cheie-valoare) cu care putem lucra, adică să le analizăm după anumite condiții. Iar în secțiunea output, vom selecta mesajele și le vom trimite fiecare în canalul său.
Analiza mesajului cu ajutorul grok
Pentru a analiza șirurile de text și a obține din ele un set de câmpuri, în secțiunea filter există un plugin special - grok.
Fără a avea scopul de a oferi aici o descriere detaliată a acestuia, (pentru asta vă recomand să vă adresați la ), voi oferi un exemplu simplu.
Pentru aceasta, trebuie să ne determinăm formatul șirurilor de intrare. Ale mele sunt următoarele:
1 INFO message1
2 ERROR message2
Adică, identificatorul este pe primul loc, urmat de INFO/ERROR, apoi un cuvânt fără spații.
Nu este complicat, dar pentru înțelegerea principiului de funcționare e suficient.
Așadar, în secțiunea filter, în pluginul grok, trebuie să definim un pattern pentru analiza șirurilor noastre.
Acesta va arăta astfel:
filter {
  grok {
    match => { "message" => ["%{INT:message_id} %{LOGLEVEL:message_type} %{WORD:message_text}"] }
   }
  }
Practic, acesta este un expresie regulată. Se folosesc deja pattern-uri gata pregătite, cum ar fi INT, LOGLEVEL, WORD. Descrierea lor, precum și alte pattern-uri, pot fi consultate aici
Acum, trecând prin acest filtru, șirul nostru va fi transformat într-un hash format din trei câmpuri: message_id, message_type, message_text.
Acestea vor fi afișate în secțiunea output.
Rutarea mesajelor în secțiunea output cu ajutorul comenzii if
În secțiunea output, așa cum ne amintim, intenționam să împărțim mesajele în două fluxuri. Cele care sunt INFO le vom afișa pe consolă, iar cele cu erori le vom scrie într-un fișier.
Cum putem să diferențiem aceste mesaje? Condiția problemei ne oferă deja sugestia soluției – avem un câmp desemnat message_type, care poate lua doar două valori: INFO și ERROR. Exact pe acesta vom face selecția cu ajutorul operatorului if.
if [message_type] == "ERROR" {
        # Aici scriem în fișier
       } else
     {
      # Aici scriem în stdout
    }
Descrierea modului de lucru cu câmpurile și operatorii poate fi vizualizată în această secțiune .
Acum, despre output-ul propriu-zis.
Output-ul în consolă, aici totul este clar – stdout {}
Dar output-ul în fișier – să ne amintim că totul se rulează dintr-un container și pentru ca fișierul în care scriem rezultatul să fie accesibil din exterior, trebuie să deschidem acest director în docker-compose.yml.
În total:
Secțiunea output a fișierului nostru arată astfel:
output {
  if [message_type] == "ERROR" {
    file {
          path => "/usr/share/logstash/output/test.log"
          codec => line { format => "custom format: %{message}"}
         }
    } else
     {stdout {
             }
     }
  }
În docker-compose.yml adăugăm încă un volum pentru output:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
      - ./output:/usr/share/logstash/output
Pornim, încercăm, vedem diferențierea în două fluxuri.
Sursa: habr.com
