

Stimați cititori, o zi bună!
Sarcina de a construi platforme IT pentru acumularea și analiza datelor apare mai devreme sau mai târziu în orice companie, al cărei model de afaceri se bazează pe servicii cu sarcini de inteligență sau pe crearea de produse tehnic complicate. Construirea platformelor analitice este o sarcină complexă și consumatoare de timp. Totuși, orice sarcină poate fi simplificată. În acest articol, vreau să împărtășesc experiența aplicării instrumentelor low-code, care ajută la crearea soluțiilor analitice. Această experiență a fost dobândită în cadrul implementării unei serii de proiecte în domeniul Big Data Solutions al companiei „Neoflex”. Domeniul Big Data Solutions al companiei „Neoflex” se ocupă din 2005 cu construirea de depozite și lacuri de date, rezolvă probleme de optimizare a vitezei de procesare a informațiilor și lucrează la metodologia de gestionare a calității datelor.
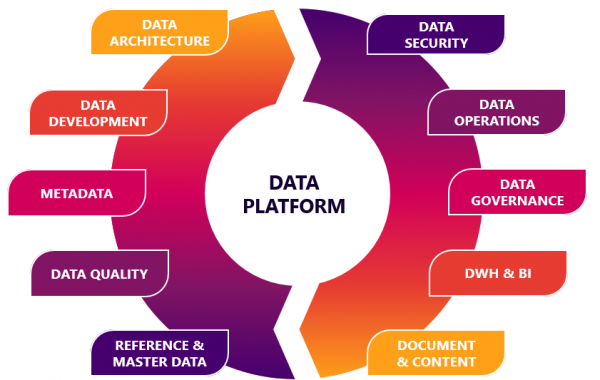
Evitarea acumulării conștiente de date slab și/sau foarte structurate nu va fi posibilă pentru nimeni. Probabil, chiar dacă este vorba despre o mică afacere. Căci, în timpul scalării afacerii, antreprenorul ar putea să se confrunte cu întrebări privind dezvoltarea unui program de loialitate, ar dori să efectueze o analiză a eficienței punctelor de vânzare, să se gândească la publicitate țintită, să se preocupe de cererea pentru produsele complementare. În prima instanță, sarcina poate fi rezolvată „pe genunchi”. Dar, odată cu creșterea afacerii, ajungerea la o platformă analitică devine inevitabilă.
Dar în ce cazuri sarcinile de analiză a datelor pot deveni sarcini de tip „Rocket Science”? Probabil în acel moment, când vorbim despre date cu adevărat mari.
Pentru a simplifica sarcina „Rocket Science”, poți mânca elefantul pe bucăți.
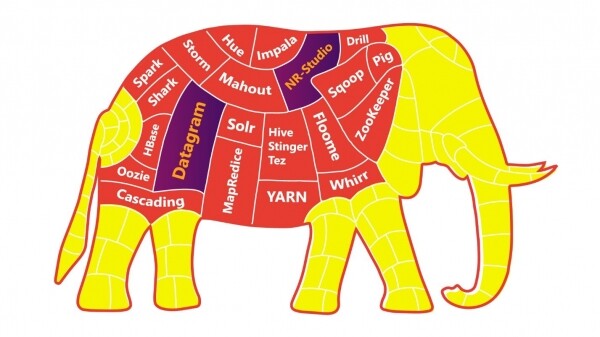
Cu cât mai mare este discreția și autonomia aplicațiilor/servicilor/microserviciilor tale, cu atât mai ușor va fi pentru tine, colegii tăi și întreaga afacere să digere elefantul.
La această afirmație au ajuns aproape toți clienții noștri, remodelând peisajul pe baza practicilor inginerice ale echipelor DevOps.
Dar chiar și cu o dietă „separată, elephantină” avem șanse destul de bune de „supraalimentare” a peisajului IT. În acest moment, merită să te oprești, să respiri adânc și să te uiți spre platforma de inginerie low-code.
Mulți dezvoltatori se tem de perspectiva de a ajunge într-un impas în carieră, trecând de la scrierea directă a codului la „tragerea” elementelor în interfețele UI ale sistemelor low-code. Însă apariția mașinilor nu a dus la dispariția inginerilor, ci a ridicat munca lor la un nou nivel!
Hai să vedem de ce.
Analiza datelor în domeniul logisticii, în industria telecom, în cercetările media sau în sectorul financiar, este întotdeauna asociată cu următoarele întrebări:
- Viteza de desfășurare a analizei automatizate;
- Posibilitatea desfășurării experimentelor fără a afecta fluxul principal al producției de date;
- Acuratețea datelor pregătite;
- Monitorizarea schimbărilor și versiune;
- Proveniența datelor, linia de date, CDC;
- Rapiditatea livrării noilor caracteristici în medii de producție;
- Și cunoscutele: costul dezvoltării și întreținerii.
Aceasta înseamnă că inginerii au un număr colosal de sarcini de nivel înalt, care pot fi îndeplinite cu eficiență doar curățându-și mintea de sarcinile de dezvoltare de nivel jos.
Premisele trecerii dezvoltatorilor la un nou nivel au fost evoluția și digitalizarea afacerii. Valoarea dezvoltatorului se schimbă de asemenea: există un deficit semnificativ de dezvoltatori capabili să capteze esența conceptelor de afaceri automatizate.
Să facem o analogie între limbajele de programare de nivel inferior și cele de nivel superior. Trecerea de la limbajele de nivel inferior la cele de nivel superior este o trecere de la scrierea „directive directe în limbajul hardului” la „directive în limbajul oamenilor”. Adică, adăugarea unei anumite dimensiuni de abstractizare. În acest caz, trecerea la platformele low-code din limbajele de programare de nivel superior este o trecere de la „directive în limbajul oamenilor” la „directive în limbajul afacerii”. Dacă se găsesc dezvoltatori cărora acest fapt le va provoca tristețe, atunci ei au fost, de fapt, triști cu mult înainte, încă de când a apărut JavaScript, care utilizează funcții de sortare a array-urilor. Și aceste funcții au, desigur, o implementare programatică în spate, folosind aceleași instrumente de programare de nivel înalt.
Prin urmare, low-code este doar apariția unui alt nivel de abstractizare.
Experiență aplicată în utilizarea low-code
Tema low-code este destul de vastă, dar acum aș dori să discut despre aplicarea conceptelor "low-code" prin exemplul unuia dintre proiectele noastre.
Departamentul Big Data Solutions al companiei "Neoflex" se specializează în mod deosebit în sectorul financiar, construind depozite și lacuri de date și automatizând diverse raportări. În acest domeniu, utilizarea low-code a devenit un standard. Printre celelalte instrumente low-code se numără soluții pentru organizarea proceselor ETL: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Sau Oracle Apex, care servește ca mediu de dezvoltare rapidă pentru interfețe de acces și editare a datelor. Totuși, utilizarea instrumentelor de dezvoltare low-code nu este întotdeauna asociată cu crearea de aplicații specializate pe un stack tehnologic comercial cu o dependență clară de furnizor.
Cu ajutorul platformelor low-code se pot organiza, de asemenea, orchestrarea fluxurilor de date, se pot crea platforme de data science sau, de exemplu, module pentru verificarea calității datelor.
Unul dintre exemplele aplicate de utilizare a instrumentelor de dezvoltare low-code este colaborarea dintre "Neoflex" și compania Mediascope, unul dintre liderii pieței de cercetare media din Rusia. Una dintre provocările acestei companii este generarea de date pe baza cărora advertiserii, platformele online, canalele TV, stațiile de radio, agențiile de publicitate și brandurile iau decizii privind achiziția de publicitate și își planifică comunicările de marketing.
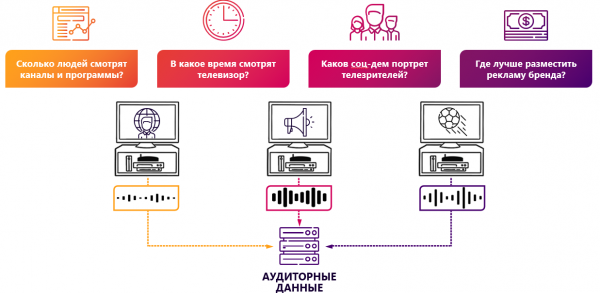
Cercetarea media este un domeniu de afaceri cu un grad tehnologic ridicat. Recunoașterea imaginilor video, colectarea de date de la dispozitive care analizează vizionarea, măsurarea activității pe resursele web - toate acestea necesită o echipă IT extinsă și o experiență vastă în construcția soluțiilor analitice. Cu toate acestea, creșterea exponențială a cantității de informații, a numărului și a diversității surselor acestora obligă industria IT a datelor să progreseze continuu. Cea mai simplă soluție pentru scalarea unei platforme analitice deja în funcțiune Mediascope ar fi puterea de muncă IT extinsă. Dar o soluție mult mai eficientă ar fi accelerarea procesului de dezvoltare. Unul dintre pașii care conduc în această direcție poate fi utilizarea platformelor low-code.
La momentul lansării proiectului, compania avea deja o soluție de produs funcțională. Cu toate acestea, implementarea soluției pe MSSQL nu putea corespunde pe deplin așteptărilor privind scalabilitatea funcționalității, menținând în același timp costuri acceptabile pentru modificări.
Sarcina cu care ne-am confruntat a fost cu adevărat ambițioasă – „Neoflex” și Mediascope trebuiau să creeze o soluție industrială în mai puțin de un an, cu condiția ca MVP-ul să fie lansat în primul trimestru de la data începerii lucrărilor.
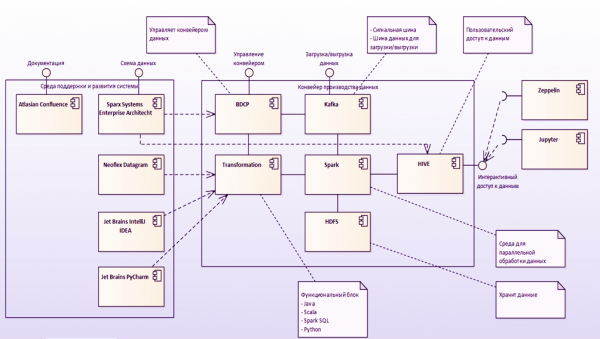
Ca fundament pentru construirea noii platforme de date, bazată pe calculul low-code, s-a ales stiva de tehnologii Hadoop. Standardul de stocare a datelor a devenit HDFS, folosind fișiere de format parquet. Accesul la datele din platformă se face prin Hive, unde toate vitrinele disponibile sunt prezentate sub formă de tabele externe. Încărcarea datelor în depozit a fost realizată cu ajutorul Kafka și Apache NiFi.
Instrumentul low-code în această concepție a fost aplicat pentru a optimiza cea mai laborioasă sarcină în construirea platformei analitice – sarcina de calculare a datelor.
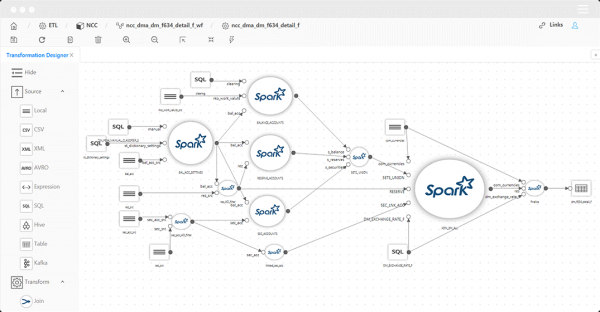
Mecanismul principal pentru maparea datelor a fost ales instrumentul low-code Datagram. Neoflex Datagram este un instrument pentru dezvoltarea transformărilor și fluxurilor de date.
Folosind acest instrument, este posibil să ne descurcăm fără a scrie cod în Scala „manual”. Codul Scala este generat automat folosind abordarea Model Driven Architecture.
Un avantaj evident al acestei abordări este accelerarea procesului de dezvoltare. Cu toate acestea, pe lângă viteză, există și alte avantaje:
- Vizualizarea conținutului și structurii surselor/destinațiilor;
- Urmărirea originii obiectelor fluxului de date până la câmpuri individuale (lineage);
- Executarea parțială a transformărilor cu vizualizarea rezultatelor intermediare;
- Vizualizarea codului sursă și corectarea acestuia înainte de execuție;
- Validarea automată a transformărilor;
- Încărcarea automată a datelor 1 la 1.
Pragul de intrare în soluțiile low-code pentru generarea transformărilor este destul de scăzut: un dezvoltator trebuie să cunoască SQL și să aibă experiență în utilizarea instrumentelor ETL. De asemenea, este important de menționat că generatoarele de transformări bazate pe cod nu sunt instrumente ETL în înțelesul larg al cuvântului. Instrumentele low-code pot să nu aibă un mediu propriu pentru executarea codului. Cu alte cuvinte, codul generat va fi executat în acel mediu care exista pe cluster înainte de instalarea soluției low-code. Acesta este, poate, încă un plus în favoarea low-code. Deoarece în paralel cu echipa low-code poate funcționa o echipă „clasică”, care implementează funcționalitatea, de exemplu, în cod Scala pur. Integrarea modificărilor realizate de ambele echipe în producție va fi simplă și „fără cusur”.
Probabil că merită să menționăm și că, pe lângă low-code, există și soluții no-code. Și, în esență, acestea sunt lucruri diferite. Low-code permite în mare măsură dezvoltatorului să intervină în codul generat. În cazul Datagram, este posibil să se vizualizeze și să se editeze codul generat Scala, în timp ce no-code poate să nu ofere această posibilitate. Această diferență este destul de semnificativă nu doar în ceea ce privește flexibilitatea soluției, ci și în ceea ce privește confortul și motivația în munca inginerilor de date.
Arhitectura soluției
Haideți să încercăm să înțelegem cum instrumentul low-code ajută la rezolvarea problemei optimizării vitezei de dezvoltare a funcționalităților de calculare a datelor. Pentru început, să analizăm arhitectura funcțională a sistemului. În acest caz, un exemplu este modelul de producție a datelor pentru cercetările media.
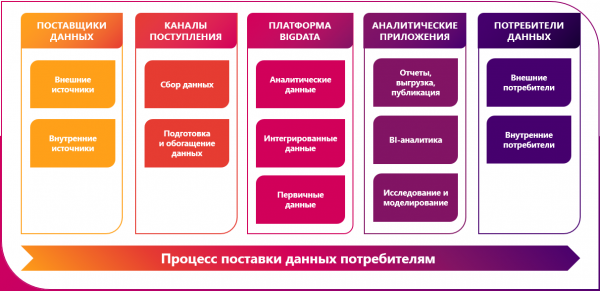
Sursele de date în cazul nostru sunt destul de variate și diverse:
- Peoplemeters (TV meters) are software and hardware devices that record user behavior from respondents in the television panel – who, when and which TV channel was watched in the household participating in the study. The provided information is a stream of viewing intervals linked to the media package and media product. Data at the upload stage in the Data Lake can be enriched with demographic attributes, geographic links, time zones, and other information necessary for analyzing TV viewing of a particular media product. The measurements obtained can be used for analyzing or planning advertising campaigns, assessing audience activity and preferences, and creating broadcast schedules;
- Data can come from streaming TV monitoring systems and measuring content viewership on online video resources;
- Measurement tools in the web environment, including both site-centric and user-centric counters. A browser extension research bar and a mobile application with built-in functionality may serve as data providers for the Data Lake. VPN.
- Data may also come from platforms that consolidate the results of online survey completions and the outcomes of telephone interviews in the company's survey research;
- Additional enrichment of the data lake may occur through uploading information from partner companies' logs.
The implementation of as-is loading from source systems into the initial staging of raw data can be organized in various ways. If low-code is used for these purposes, automatic generation of loading scripts based on metadata is possible. In this case, there is no need to delve into the development of source-to-target mappings. To implement automatic loading, we need to establish a connection to the source, followed by defining the list of entities to be loaded in the loading interface. The creation of directory structures in HDFS will happen automatically and will correspond to the data storage structure in the source system.
However, in the context of this project, we decided not to utilize this low-code platform capability due to the fact that the company Mediascope has already begun working on creating a similar service using Nifi + Kafka.
Este important să subliniem că aceste instrumente nu sunt interschimbabile, ci mai degrabă se completează reciproc. Nifi și Kafka pot funcționa atât în direcția directă (Nifi -> Kafka), cât și invers (Kafka -> Nifi). Pentru platforma de cercetare media, a fost folosită prima variantă de legătură.
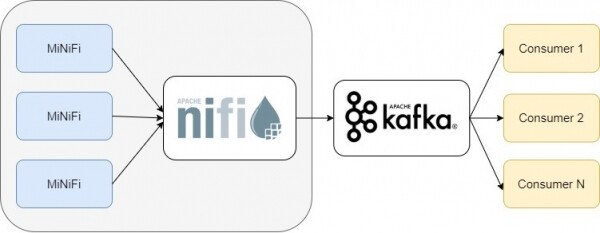
În cazul nostru, Nifi a fost necesar pentru a procesa diferite tipuri de date din sistemele sursă și a le trimite brokerului Kafka. Direcționarea mesajelor către un anumit topic Kafka s-a realizat prin utilizarea procesoarelor Nifi PublishKafka. Orchestrarea și întreținerea acestor pipeline-uri se face într-o interfață vizuală. Instrumentul Nifi și utilizarea combinației Nifi + Kafka pot fi, de asemenea, considerate o abordare low-code pentru dezvoltare, având un prag de intrare scăzut în tehnologiile Big Data și accelerând procesul de dezvoltare a aplicațiilor.
Următoarea etapă în implementarea proiectului a fost aducerea la un format unic de strat semantic pentru date detaliate. În cazul în care entitatea are atribute istorice, calculul se face în contextul partiției analizate. Dacă entitatea nu este istorică, atunci opțional se poate face fie recalcularea întregului conținut al obiectului, fie renunțarea la recalcularea acestui obiect (din cauza lipsei modificărilor). În această etapă, generația de chei pentru toate entitățile are loc. Cheile sunt salvate în dicționarele corespunzătoare obiectelor-mamă din Hbase, care conțin corespondența între cheile din platforma analitică și cheile din sistemele sursă. Consolidarea entităților atomice este însoțită de îmbogățirea rezultatelor din calculul preliminar al datelor analitice. Framework-ul pentru calculul datelor a fost Spark. Funcționalitatea descrisă pentru aducerea datelor la o semantica unitară a fost de asemenea implementată pe baza mapping-urilor instrumentului low-code Datagram.
În arhitectura țintă, a fost necesar să se asigure acces SQL la date pentru utilizatorii de afaceri. Pentru această opțiune, a fost folosit Hive. Înregistrarea obiectelor în Hive se face automat atunci când opțiunea "Registr Hive Table" este activată în instrumentul low-code.
Gestionarea fluxului de calcul
Datagram are interfaces for designing workflow streams. Mappings can be executed using the Oozie scheduler. The developer interface for streams allows creating schemes for parallel, sequential, or condition-dependent execution of data transformations. There is support for shell scripts and Java programs. It is also possible to use server Apache Livy. Apache Livy is used to run applications directly from the development environment.
If the company already has its own process orchestrator, it is possible to use REST API to integrate mappings into the existing stream. For example, we had fairly successful experience in integrating Scala mappings into orchestrators written in PLSQL and Kotlin. The REST API of the low-code tool implies operations such as generating an executable year based on mapping design, invoking mappings, calling a sequence of mappings, and of course, passing parameters in the URL to run mappings.
Alongside Oozie, it is possible to organize the calculation stream using Airflow. I won't dwell too long on comparing Oozie and Airflow, but I will simply say that in the context of the media research project's work, the choice leaned towards Airflow. The main arguments this time were a more active community developing the product and a more advanced interface + API.
Airflow is also good because it uses Python, which is loved by many, for describing calculation processes. Moreover, there are not so many open-source workflow management platforms. Launching and monitoring process execution (including with Gantt charts) only adds points to Airflow's karma.
The configuration file format for launching mappings in the low-code solution became spark-submit. This is due to two reasons. First, spark-submit allows you to directly run a jar file from the console. Second, it can contain all the necessary information for configuring the workflow (which simplifies writing scripts that form the DAG).
The most commonly encountered element of the Airflow workflow in our case became the SparkSubmitOperator.
SparkSubmitOperator allows you to run jars — packaged Datagram mappings with pre-formed input parameters for them.
Este important de menționat că fiecare sarcină Airflow se execută în fir de execuție separat și nu are cunoștință despre alte sarcini. Prin urmare, interacțiunea dintre sarcini se realizează prin operatori de control, cum ar fi DummyOperator sau BranchPythonOperator.
Utilizarea soluției low-code Datagram împreună cu universalizarea fișierelor de configurare (ce formează Dag) a dus la o accelerare și simplificare semnificativă a procesului de dezvoltare a fluxurilor de încărcare a datelor.
Calculul vitrinelor
Probabil, cea mai complexă etapă în producția de date analitice este pasul construcției vitrinelor. În contextul uneia dintre fluxurile de calcul al datelor ale unei companii de cercetare, în această etapă se realizează aducerea la o traducere de referință, având în vedere ajustarea pe fuse orare legată de grila de difuzare. De asemenea, este posibilă ajustarea pentru grila locală de difuzare (știri și publicitate locale). Printre altele, în această etapă se face segmentarea intervalelor de vizionare continuă a produselor media, pe baza analizei intervalelor de vizionare. Aici se realizează și „ponderea” valorilor de vizionare pe baza informațiilor despre relevanța acestora (calculul coeficientului de ajustare).
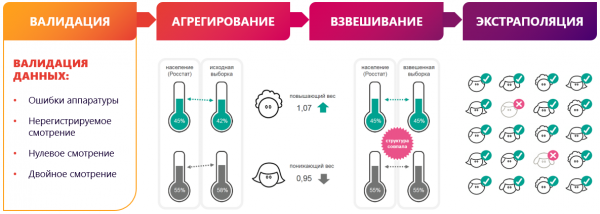
Un pas distinct în pregătirea vitrinelor este validarea datelor. Algoritmul de validare este asociat cu aplicarea unui set de modele matematice științifice. Totuși, utilizarea unei platforme low-code permite împărțirea algoritmului complex în mapări vizibile și ușor de citit. Fiecare dintre aceste mapări îndeplinește o sarcină specifică. Ca urmare, este posibilă depanarea intermediară, înregistrarea și vizualizarea etapelor de pregătire a datelor.
Algoritmul de validare a fost discretizat în următoarele sub-etape:
- Construirea regresiilor dependenței vizionării rețelei de televiziune din regiune cu vizionarea tuturor rețelelor din regiune pe parcursul a 60 de zile.
- Calculul reziduurilor studentizate (devierea valorilor actuale de la cele prezise de modelul de regresie) pentru toate punctele de regresie și pentru ziua calculată.
- Selectarea perechilor anormale regiune-rețea de televiziune, unde reziduul studentizat al zilei calculate depășește norma (stabilită prin configurația operației).
- Recalcularea soldului studențizat corectat pentru perechile anormale regiune-rețea de telecomunicații pentru fiecare respondent care a vizionat rețeaua în regiune, determinând contribuția acestui respondent (mărimea schimbării soldului studențizat) prin excluderea vizionării acestui respondent din eșantion.
- Căutarea candidaților al căror excludere aduce soldul studențizat al zilei de calcul în normal.
Exemplul de mai sus este o confirmare a ipotezei că un inginer de date are deja prea multe lucruri în minte... Și, dacă acesta este cu adevărat un „inginer”, nu doar un „coder”, frica de degradare profesională prin utilizarea instrumentelor low-code ar trebui să dispara complet.
Ce poate face low-code în plus?
Domeniul de aplicare al instrumentului low-code pentru procesarea de date în loturi și în flux fără a necesita scrierea manuală de cod în Scala nu se sfârșește aici.
Utilizarea low-code în dezvoltarea datalake-urilor a devenit deja un anumit standard pentru noi. Probabil se poate spune că soluțiile pe stiva Hadoop urmează calea de dezvoltare a DWH-urilor clasice, bazate pe RDBMS. Instrumentele low-code pe stiva Hadoop pot rezolva atât sarcinile de procesare a datelor, cât și sarcinile de construire a interfețelor finale BI. În plus, trebuie menționat că BI poate însemna nu doar reprezentarea datelor, ci și editarea acestora de către utilizatorii de afaceri. Această funcționalitate este adesea utilizată de noi în construirea platformelor analitice pentru sectorul financiar.
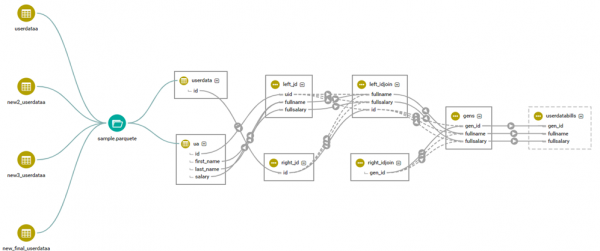
Printre altele, prin intermediul low-code și, în special, Datagram, se poate rezolva problema urmăririi originii obiectelor fluxului de date cu atomicitatea până la câmpuri individuale (lineage). Pentru aceasta, instrumentul low-code a implementat conectivitate cu Apache Atlas și Cloudera Navigator. Practic, dezvoltatorul trebuie să înregistreze un set de obiecte în dicționarele Atlas și să facă referire la obiectele înregistrate atunci când construiește mappere. Mecanismul de urmărire a originii datelor sau analiza dependențelor obiectelor economisește o cantitate considerabilă de timp atunci când este necesară modificarea algoritmilor de calcul. De exemplu, în construirea raportării financiare, această caracteristică facilitează mai bine perioada de schimbări legislative. Cu cât înțelegem mai bine dependența între forme în cadrul obiectelor din stratul detaliat, cu atât ne vom confrunta cu mai puține defecte „surpriză” și vom reduce numărul revizuirilor.
Calitatea Datelor & Low-code
O altă sarcină implementată de instrumentul low-code în proiectul companiei Mediascope a fost problema clasei Calitate a Datelor. Particularitatea implementării conveierului de verificare a datelor pentru proiectul companiei de cercetare a fost absența influenței asupra funcționării și vitezei de lucru a fluxului principal de calcul al datelor. Pentru a putea orchestra fluxuri independente de verificare a datelor, a fost utilizat deja cunoscutul Apache Airflow. Pe măsură ce fiecare pas în producția de date devenea disponibil, se lansa simultan o parte separată a conveierului DQ.
Este considerată o bună practică să se monitorizeze calitatea datelor încă de la nașterea lor în platforma analitică. Având informații despre metadate, putem verifica respectarea condițiilor de bază - not null, constrângeri, chei externe - încă de la momentul în care informația ajunge în stratul inițial. Această funcționalitate este implementată pe baza mappeslor generate automat din familia calității datelor în Datagram. Generarea codului în acest caz se bazează, de asemenea, pe metadatele modelului. În proiectul companiei Mediascope, conectivitatea s-a realizat cu metadatele produsului Enterprise Architect.
Datorită conectivității dintre instrumentul low-code și Enterprise Architect, au fost generate automat următoarele verificări:
- Verificarea prezenței valorilor „null” în câmpurile cu modificator „not null”;
- Verificarea prezenței duplicatelor cheii primare;
- Verificarea cheii externe a entității;
- Verificarea unicității unei linii pe baza unui set de câmpuri.
Pentru verificări mai complexe ale disponibilității și veridicității datelor, a fost creat un mapping cu Scala Expression, care primește ca input codul de verificare Spark SQL, pregătit de analiști în Zeppelin.
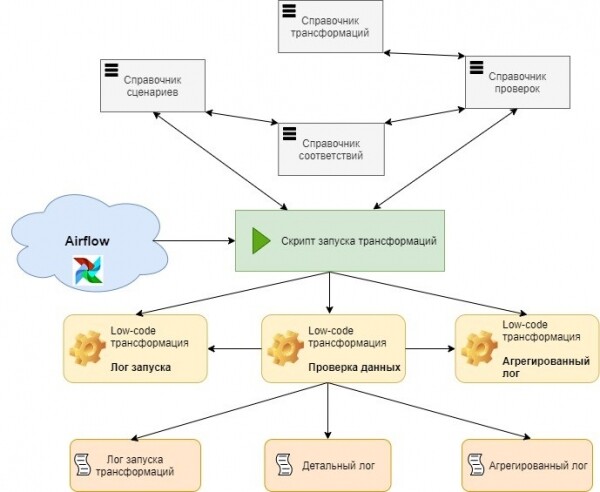
Desigur, generarea automată a verificărilor trebuie să se realizeze treptat. În cadrul proiectului descris, au fost următorii pași precedenți:
- DQ, realizate în notele Zeppelin;
- DQ, integrate în mapping;
- DQ sub formă de mapping-uri massive separate, care conțin un set complet de verificări pentru fiecare entitate;
- Mapping-uri DQ parametrizate universale, care acceptă ca input informații despre metadate și verificări de afaceri.
Probabil, principalul avantaj al creării unui serviciu de verificări parametrizate este reducerea timpului de livrare a funcționalității în mediu de producție. Noile verificări de calitate pot ocoli modelul clasic de livrare a codului prin medii de dezvoltare și testare:
- Toate verificările metadatelor sunt generate automat atunci când modelul în EA se modifică;
- Verificările disponibilității datelor (determinarea existenței unor date într-un anumit moment) pot fi generate pe baza unui director care stochează timpii așteptați pentru apariția unei noi porțiuni de date în funcție de obiecte;
- Verificările de afaceri pentru veridicitatea datelor sunt create de analiști în notele Zeppelin. De acolo, sunt direcționate direct către tabelele de configurare ale modulului DQ în mediul de producție.
Riscurile livrării directe a scripturilor în producție sunt practic inexistente. Chiar și în cazul unei erori de sintaxă, cel mai rău lucru care ne-ar putea amenința este nerealizarea unei verificări, deoarece fluxul de calcul al datelor și fluxul lansării verificărilor de calitate sunt separate.
În esență, serviciul DQ este permanent activ în mediul de producție și este gata să înceapă lucrul în momentul apariției unei noi porțiuni de date.
În concluzie
Avantajul utilizării low-code este evident. Dezvoltatorii nu trebuie să dezvolte o aplicație „de la zero”. Un programator eliberat de sarcini suplimentare oferă rezultate mai rapid. Viteza, la rândul ei, eliberează un timp suplimentar pentru a rezolva problemele de optimizare. Prin urmare, în acest caz, se poate conta pe existența unei soluții mai calitative și rapide.
Desigur, low-code nu este o soluție universală, iar magia nu se va întâmpla de la sine:
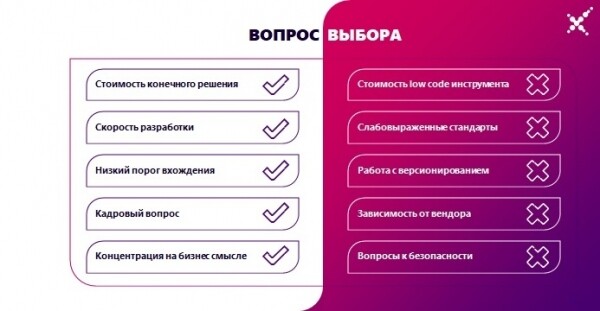
- Industria low-code trece printr-o etapă de „întărire” și momentan nu există standarde industriale uniforme;
- Multe soluții low-code nu sunt gratuite, iar achiziționarea acestora ar trebui să fie un pas conștient, care trebuie făcut cu certitudinea completă a beneficiului financiar derivat din utilizarea lor;
- Multe soluții low-code nu colaborează întotdeauna bine cu GIT / SVN. Fiecare dintre ele poate fi incomod de utilizat în cazul în care codul generat este ascuns;
- Atunci când se extinde arhitectura, poate fi necesară modificarea soluției low-code – ceea ce, la rândul său, provoacă un efect de „dependență și atașare” față de furnizorul soluției low-code.
- Un nivel adecvat de asigurare a securității este posibil, dar este foarte laborios și complicat de implementat în motoarele sistemelor low-code. Platformele low-code ar trebui alese nu doar pe principiul căutării beneficiului din utilizarea lor. La alegere, ar trebui să ne întrebăm despre funcționalitățile de gestionare a accesului și despre delegarea/escaladarea datelor de identificare la nivelul întregului peisaj IT al organizației.
Cu toate acestea, dacă sunteți conștient de toate dezavantajele sistemului ales, iar beneficiile utilizării acestuia sunt, totuși, predominante, atunci treceți la low-code fără frică. Cu atât mai mult cu cât trecerea la acesta este inevitabilă – la fel ca orice evoluție.
Dacă un dezvoltator pe o platformă low-code își va finaliza munca mai repede decât doi dezvoltatori fără low-code, atunci aceasta oferă companiei un avantaj sub toate aspectele. Pragul de intrare în soluțiile low-code este mai scăzut decât în tehnologiile „tradiționale”, iar acest lucru are un impact pozitiv asupra deficitului de personal. Utilizarea instrumentelor low-code permite accelerarea interacțiunii între echipele funcționale și o luare mai rapidă a deciziilor privind corectitudinea direcției alese în cercetarea data-science. Platformele low-code pot fi un factor declanșator pentru transformarea digitală a organizației, deoarece soluțiile produse pot fi ușor de înțeles de către persoanele non-tehnice (în special utilizatorii de afaceri).
Dacă aveți termene limită strânse, o logică de afaceri complexă, un deficit de expertiză tehnologică, și aveți nevoie să accelerați time to market, atunci low-code este una dintre modalitățile de a satisface nevoile dumneavoastră.
Nu trebuie să negați importanța instrumentelor tradiționale de dezvoltare, însă în multe cazuri utilizarea soluțiilor low-code este cea mai bună modalitate de a spori eficiența sarcinilor abordate.
Sursa: habr.com
