

Notă de traducere: aceasta este traducerea unui post-mortem public din blogul ingineresc al companiei . În acesta se descrie problema cu conntrack în clusterul Kubernetes, care a dus la o întrerupere parțială a unor servicii de producție.
Acest articol poate fi util celor care doresc să afle mai multe despre post-mortemuri sau să prevină anumite probleme potențiale cu DNS în viitor.
Nu este DNS
Nu poate fi că este DNS
A fost DNS
Despre post-mortemuri și procesele din Preply
Post-mortemul descrie o defecțiune în funcționare sau un eveniment în productie. Post-mortemul include o cronologie a evenimentelor, descrierea impactului asupra utilizatorului, cauza rădăcină, acțiunile și lecțiile învățate.
La întâlnirile săptămânale cu pizza, în cercul echipei tehnice, împărtășim diverse informații. Una dintre părțile cele mai importante ale acestor întâlniri sunt post-mortemurile, care sunt cel mai adesea însoțite de o prezentare cu diapozitive și o analiză mai profundă a incidentului petrecut. Deși nu «aplauzăm» după post-mortemuri, ne străduim să dezvoltăm o cultură «fără acuzații» (). Credem că redactarea și prezentarea post-mortemurilor ne poate ajuta (și nu numai) să prevenim incidente similare în viitor, aceasta este și motivul pentru care le împărtășim.
Persoanele implicate în incident trebuie să simtă că pot povesti în detaliu despre acesta, fără teama de pedeapsă sau răzbunare. Nicio mustrare! Redactarea post-mortemului nu este o pedeapsă, ci o oportunitate de învățare pentru întreaga companie.
Probleme DNS în Kubernetes. Post-mortem
Data: 28.02.2020
Autori: Amet U., Andrei S., Igor K., Alexei P.
Status: Finalizat
Pe scurt: Ne disponibilitate parțială DNS (26 min) pentru unele servicii din clusterul Kubernetes
Impact: 15000 evenimente pierdute pentru serviciile A, B și C
Cauza rădăcină: Kube-proxy nu a reușit să șteargă corect înregistrarea veche din tabelul conntrack, astfel că unele servicii încercau în continuare să se conecteze la podurile inexistente
E0228 20:13:53.795782 1 proxier.go:610] Eșec la ștergerea kube-system/kube-dns:dns endpoint connections, eroare: eroare la ștergerea intrărilor conntrack pentru UDP peer {100.64.0.10, 100.110.33.231}, eroare: comanda conntrack a returnat: ...Declanșator: Din cauza încărcării reduse în interiorul clusterului Kubernetes, CoreDNS-autoscaler a redus numărul de poduri din implementare de la trei la două
Soluția: O nouă desfășurare a aplicației a inițiat crearea de noduri noi, CoreDNS-autoscaler a adăugat mai multe poduri pentru a susține clusterul, ceea ce a provocat rescrierea tabelului conntrack
Detectare: Monitorizarea Prometheus a detectat un număr mare de erori 5xx pentru serviciile A, B și C și a inițiat un apel către inginerii de gardă
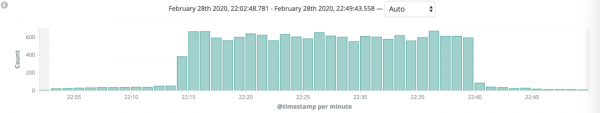
Erori 5xx în Kibana
Acțiuni
Acțiune
Tip
Responsabil
Sarcină
Dezactivează autoscalarea pentru CoreDNS
previne.
Amet U.
DEVOPS-695
Instalează serverul DNS de caching
reduce.
Max V.
DEVOPS-665
Configurează monitorizarea conntrack
previne.
Amet U.
DEVOPS-674
Lecțiile învățate
Ce a mers bine:
- Monitorizarea a funcționat corespunzător. Răspunsul a fost rapid și bine organizat
- Nu ne-am lovit de niciun limită pe noduri
Ce a fost în neregulă:
- Încă nu se cunoaște cauza reală, pare a fi în conntrack
- Toate acțiunile corectează doar efectele, nu cauza primară (eroarea)
- Știam că mai devreme sau mai târziu vom putea avea probleme cu DNS, dar nu am prioritizat sarcinile
Unde ne-a mers bine:
- O nouă desfășurare a activat CoreDNS-autoscaler, care a rescris tabelul conntrack
- Această eroare a afectat doar o parte a serviciilor
Cronologia (EET)
Timp
Acțiune
22:13
CoreDNS-autoscaler a redus numărul de poduri de la trei la două
22:18
Inginerii de gardă au început să primească apeluri din partea sistemului de monitorizare
22:21
Inginerii de gardă au început să investigheze cauza erorilor
22:39
Inginerii de gardă au început să revină asupra uneia dintre ultimele servicii la versiunea anterioară
22:40
Erorile 5xx au încetat să apară, situația s-a stabilizat
- Timpul până la detectare: 4 min
- Timpul până la acțiuni: 21 min
- Timpul până la corectare: 1 min
Informații suplimentare
- Jurnalele CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Scaled down replica set coredns-6cbb6646c9 to 2 - Linkuri către Kibana (tăiat), Grafana (tăiat)
Pentru a minimiza utilizarea procesorului, nucleul Linux utilizează ceva numit conntrack. Pe scurt, aceasta este o unealtă care conține o listă de înregistrări NAT, păstrate într-un tabel special. Când următorul pachet vine din aceleași poduri în același pod ca înainte, adresa IP finală nu va fi calculată din nou, ci va fi preluată din tabelul conntrack.
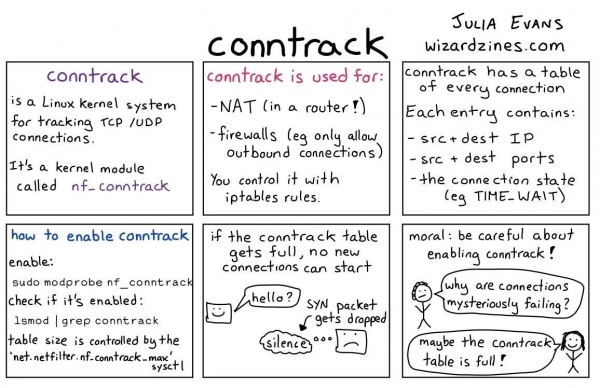
Cum funcționează conntrack
Concluzii
Aceasta a fost un exemplu din unul dintre postmortem-urile noastre, cu câteva linkuri utile. În acest articol, împărtășim informații care pot fi de folos altor companii. De aceea, nu ne temem să facem greșeli și de aceea am făcut unul dintre postmortem-urile noastre public. Iată câteva alte postmortem-uri publice interesante:
- GitLab:
- Dropbox:
- Spotify:
- Multe alte postmortem-uri din și repository
- De asemenea, postmortem public cu SRE Book
Sursa: habr.com
