

Această poveste vorbește despre modul în care folosim containere în mediul de producție, în special sub Kubernetes. Articolul este dedicat colectării metricalor și jurnalelor de la containere, precum și construirii imaginilor.
Suntem din compania fintech Exness, care dezvoltă servicii pentru tranzacționarea online și produse fintech pentru B2B și B2C. În R&D-ul nostru sunt multe echipe diferite, iar în departamentul de dezvoltare sunt peste 100 de angajați.
Reprezentăm echipa care se ocupă de platforma pentru colectarea și lansarea codului de către dezvoltatorii noștri. În special, răspundem de colectarea, stocarea și furnizarea de metrici, jurnale și evenimente din aplicații. În prezent, operăm aproximativ trei mii de containere Docker în mediul de producție, susținem stocarea noastră de big data de 50 TB și oferim soluții arhitecturale construite în jurul infrastructurii noastre: Kubernetes, Rancher și diferiți furnizori publici de cloud.
Motivația noastră
Ce arde? Nimeni nu poate răspunde. Unde este focul? Este greu de înțeles. Când a început? Se poate afla, dar nu imediat.
De ce unele containere stau pe loc, iar altele au căzut? Care container a cauzat asta? Deși din exterior containerele sunt identice, fiecare are propriul său Neo în interior.
Dezvoltatorii noștri sunt oameni competenți. Ei fac servicii bune care aduc profit companiei. Dar există și probleme, când containerele cu aplicații devin haotice. Un container consumă prea mult CPU, altul consumă lățime de bandă, al treilea efectuează operațiuni de intrare-ieșire, iar al patrulea face lucruri ciudate cu socket-urile. Toate acestea se prăbușesc și vasul se scufundă.
Agenti
Pentru a înțelege ce se întâmplă în interior, am decis să instalăm agenți direct în containere.
Acești agenți sunt programe de control care mențin containerele într-o stare astfel încât să nu se deteriorizeze reciproc. Agenții sunt standardizați, ceea ce permite standardizarea abordărilor în întreținerea containerelor.
În cazul nostru, agenții trebuie să furnizeze jurnale într-un format standard, etichetate și cu throttling. De asemenea, trebuie să ne ofere metrici standardizate, extinsibil sub aspectul aplicațiilor de afaceri.
Agenții implică și utilitare pentru exploatare și întreținere, capabile să funcționeze în diferite sisteme de orchestrare, susținând diferite imagini (Debian, Alpine, Centos etc.).
În cele din urmă, agenții trebuie să susțină un CI/CD simplu, care să includă fișiere Docker. Altfel, sistemul va colapsa, deoarece containerele vor începe să fie livrate pe șine „strâmbe”.
Procesul de construire și configurarea imaginii țintă
Pentru a avea totul standardizat și gestionabil, este necesar să respectăm un proces standard de construire. De aceea, am decis să construim containere cu ajutorul altor containere — o astfel de recursivitate.
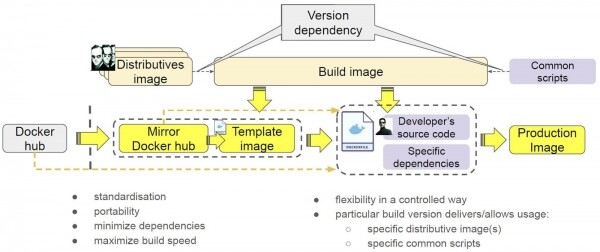
Aici, containerele sunt reprezentate prin contururi solide. De asemenea, am decis să includem în ele distribuțiile, pentru a nu face „viața prea ușoară”. Motivele pentru care am făcut acest lucru le vom explica mai jos.
Ca rezultat, am obținut un instrument pentru construire — un container de o anumită versiune, care face referire la anumite versiuni ale distribuțiilor și la anumite versiuni ale scripturilor.
Cum îl utilizăm? Avem un Docker Hub, unde este stocat containerul. Îl replicăm în sistemul nostru pentru a scăpa de dependențele externe. A rezultat un container, marcat cu galben. Creăm un șablon pentru a instala în container toate distribuțiile și scripturile necesare. După aceea, construim o imagine gata de exploatare: dezvoltatorii îi încarcă codul și anumite dependențe specifice.
Care sunt avantajele acestei abordări?
- În primul rând, control complet al versiunilor instrumentelor de construire – containerul de construire, versiunile scripturilor și ale distribuțiilor.
- În al doilea rând, am obținut standardizare: creăm șabloane, imagini intermediare și gata de exploatare într-un mod uniform.
- În al treilea rând, containerele ne oferă portabilitate. Astăzi folosim Gitlab, iar mâine vom trece la TeamCity sau Jenkins și exact la fel vom putea rula containerele noastre.
- În al patrulea rând, minimizarea dependențelor. Nu este întâmplător că am inclus distribuțiile în container, deoarece acest lucru ne permite să nu le descărcăm de fiecare dată de pe internet.
- În al cincilea rând, rapiditatea construirei a crescut – având copii locale ale imaginilor, nu pierdem timp cu descărcarea, deoarece avem imagini locale.
Cu alte cuvinte, am realizat un proces de construire controlat și flexibil. Folosim aceleași instrumente pentru construirea oricăror containere, având un versionare completă.
Cum funcționează procedura noastră de construire?
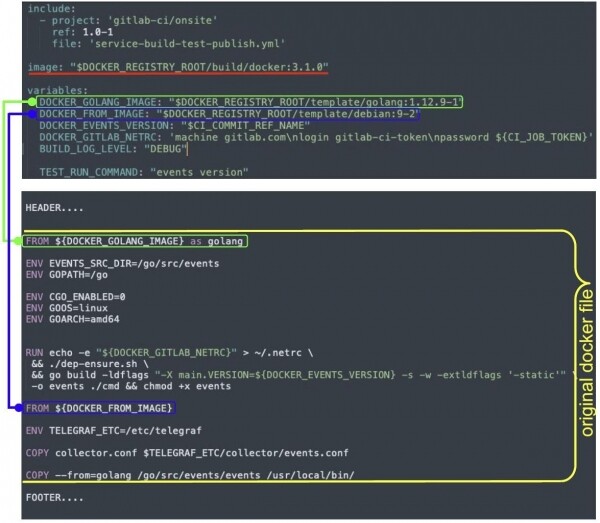
Construirea începe cu o singură comandă, procesul se desfășoară în imagine (evidențiat cu roșu). Dezvoltatorul are un fișier Docker (evidențiat cu galben), pe care îl redimensionăm, înlocuind variabilele cu valorile corespunzătoare. În același timp, adăugăm header-uri și footer-uri — acestea sunt agenții noștri.
Header-ul adaugă distribuțiile din imaginile corespunzătoare. Iar footer-ul instalează servicii în interior, configurând lansarea sarcinii de lucru, logarea și alți agenți, înlocuind entrypoint-ul etc.
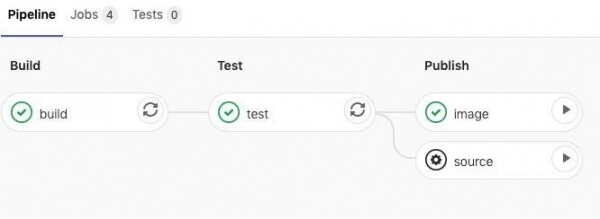
Am reflectat mult dacă să implementăm un supervizor. În cele din urmă, am decis că avem nevoie de el. Am ales S6. Supervizorul asigură gestionarea containerului: permite conectarea la acesta în caz de cădere a procesului principal și oferă gestionarea manuală a containerului fără a îl recrea. Jurnalele și metricile sunt procese care se desfășoară în interiorul containerului. Trebuie să le controlăm de asemenea, și facem acest lucru prin intermediul supervizorului. În cele din urmă, S6 se ocupă de housekeeping, procesarea semnalelor și alte sarcini.
Dat fiind că utilizăm diferite sisteme de orchestrare, după construirea și lansarea containerului, acesta trebuie să înțeleagă în ce mediu se află și să acționeze corespunzător. De exemplu:
Acest lucru ne permite să construim o singură imagine și să o lansăm în diferite sisteme de orchestrare, având în vedere specificitatea acestor sisteme.
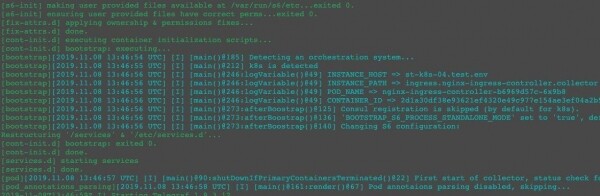
Pentru același container obținem diferite arbori de procese în Docker și Kubernetes:
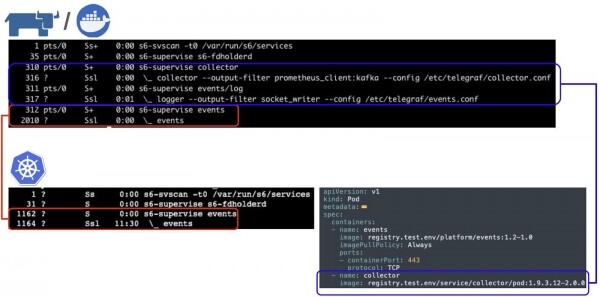
Sarcina utilă se desfășoară sub supervizorul S6. Observați collector și events — aceștia sunt agenții noștri, responsabili pentru jurnale și metrici. În Kubernetes nu sunt, dar în Docker sunt. De ce?
Dacă ne uităm la specificația „pod-ului” (de aici înainte - Kubernetes pod), vom vedea că containerul events se desfășoară în pod-ul în care există un container separat collector, care îndeplinește funcția de colectare a metricilor și jurnalele. Putem utiliza capacitățile Kubernetes: lansarea containerelor într-un singur pod, în același spațiu de proces și/sau rețea. Practic, putem implementa agenți proprii și îndeplini anumite funcții. Și dacă același container va fi lansat în Docker, el va obține aceleași capacități, adică va putea livra jurnale și metrici, deoarece agenții vor fi rulați în interior.
Metrici și jurnale
Livrarea metricilor și jurnalele — o sarcină complexă. Soluționarea acesteia este legată de mai multe aspecte.
Infrastructura este creată pentru a executa sarcini utile, nu pentru livrarea în masă a jurnalelor. Adică, acest proces ar trebui să se desfășoare cu cerințe minime de resurse pentru containere. Ne străduim să ajutăm dezvoltatorii noștri: „Luați un container din Docker Hub, porniți-l și vom putea livra jurnalele”.
Al doilea aspect – limitarea volumului de jurnale. Dacă în mai multe containere apare o situație de vârf în volumul de jurnale (aplicația în buclă afișează stack-trace), crește încărcătura pe CPU, canalele de comunicare, sistemul de procesare a jurnalelor și aceasta afectează funcționarea host-ului în ansamblu și a altor containere de pe host, ceea ce uneori duce la „pădurea” host-ului.
Al treilea aspect – trebuie să suportăm din cutie cât mai multe metode de colectare a metricilor. De la citirea fișierelor și interogarea punctelor de finalizare Prometheus până la utilizarea protocoalelor specifice ale aplicațiilor.
Și ultimul aspect – trebuie să minimizăm consumul de resurse.
Am ales o soluție open-source pe Go numită Telegraf. Acesta este un conectator versatil care suportă peste 140 de tipuri de canale de intrare (input plugins) și 30 de tipuri de ieșire (output plugins). L-am adaptat și acum vom explica cum este utilizat de noi prin intermediul Kubernetes.
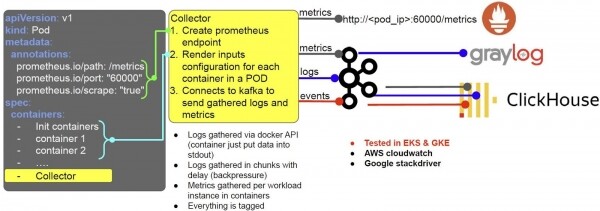
Să presupunem că un dezvoltator desfășoară o sarcină și Kubernetes primește o cerere de creare a unui pod. În acel moment, pentru fiecare pod se creează automat un container numit Collector (folosim mutation webhook). Collector este agentul nostru. La start, acest container se configurează pentru a lucra cu Prometheus și sistemul de colectare a jurnalelor.
- Pentru aceasta, el folosește anotații ale pod-ului și, în funcție de conținutul acesteia, creează, să zicem, un punct de finalizare Prometheus;
- Pe baza specificației pod-ului și a setărilor specifice ale containerelor, decide cum să livreze jurnalele.
Jurnalele sunt colectate prin Docker API: dezvoltatorii trebuie doar să le plaseze în stdout sau stderr, iar apoi Collector se va ocupa de ele. Jurnalele sunt colectate în blocuri cu o oarecare întârziere, pentru a preveni o posibilă supraîncărcare a host-ului.
Metricile sunt colectate pe instanțele sarcinii de lucru (procese) din containere. Totul este marcat cu etichete: namespace, pod și așa mai departe, și apoi convertit în format Prometheus – și devine disponibil pentru colectare (cu excepția jurnalelor). De asemenea, jurnalele, metricile și evenimentele sunt trimise în Kafka și mai departe:
- Jurnalele sunt disponibile în Graylog (pentru analiză vizuală);
- Jurnalele, metricele și evenimentele sunt trimise în Clickhouse pentru stocare pe termen lung.
Exact în același mod funcționează totul în AWS, doar că înlocuim Graylog cu Kafka cu Cloudwatch. Trimitem jurnalele acolo, iar totul devine foarte convenabil: este clar cui îi aparține clusterul și containerul. Același lucru este valabil și pentru Google Stackdriver. Așadar, schema noastră funcționează atât on-premise cu Kafka, cât și în cloud.
Dacă nu avem Kubernetes cu pod-uri, schema devine puțin mai complicată, dar funcționează pe aceleași principii.
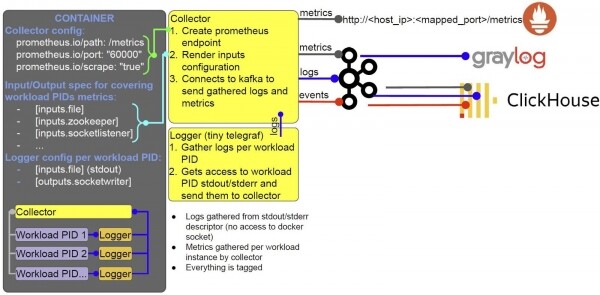
În interiorul containerului se execută aceleași procese, orchestrate cu ajutorul S6. Toate aceleași procese sunt lansate în interiorul unui singur container.
În concluzie
Am creat o soluție integrată pentru construirea și lansarea imaginilor în producție, cu opțiuni de colectare și livrare a jurnalelor și metricelor:
- Am dezvoltat o abordare standardizată pentru construirea imaginilor, pe baza căreia am dezvoltat șabloane CI;
- Agentele pentru colectarea datelor sunt extensiile noastre Telegraf. Le-am testat bine în producție;
- Aplicăm webhook-uri de mutație pentru implementarea containerelor cu agenți în pod-uri;
- Ne-am integrat în ecosistemul Kubernetes/Rancher;
- Putem rula aceleași containere în diferite sisteme de orchestrare și obține rezultatul dorit;
- Am creat o configurație complet dinamică pentru gestionarea containerelor.
Coautor: Ilia Prudnikov
Sursa: habr.com
