

Pachet tidyr face parte din nucleul uneia dintre cele mai populare biblioteci în R — tidyverse.
Scopul principal al pachetului este de a aduce datele într-o formă ordonată.
Pe Habr există deja dedicată acestui pachet, dar este datată din 2015. Vreau să vorbesc despre cele mai recente modificări anunțate cu câteva zile în urmă de autorul său, Hadley Wickham.
SJK: Funcțiile gather() și spread() vor fi considerate învechite?
Hadley Wickham: Într-o anumită măsură. Vom înceta să recomandăm utilizarea acestor funcții și să corectăm erorile din ele, dar ele vor rămâne disponibile în pachet în starea actuală.
Cuprins
Dacă sunteți interesat de analiza datelor, s-ar putea să vă intereseze canalele mele. și Majoritatea conținutului care este dedicat limbajului R.
Conceptul TidyData
Scop tidyr — să vă ajute să transformați datele într-o așa-numită formă ordonată. Datele ordonate sunt date în care:
- Fiecare variabilă este într-o coloană.
- Fiecare observație este un rând.
- Fiecare valoare este o celulă.
Lucrul cu datele aduse la tidy data este semnificativ mai simplu și mai convenabil în analiza acestora.
Funcțiile principale incluse în pachetul tidyr
tidyr conține un set de funcții destinate transformării tabelilor:
fill()— completarea valorilor lipsă din coloană, cu valorile anterioare;separate()— împarte un câmp în mai multe, printr-un separator;unite()— efectuează operația de unificare a mai multor câmpuri într-unul, acțiunea opusă funcțieiseparate();pivot_longer()— funcția care transformă datele din format larg în lung;pivot_wider()— funcția care transformă datele din format lung în larg. Operația este opusă celei efectuate de funcțiapivot_longer().gather()învechită — funcția care transformă datele din format larg în lung;spread()învechită — funcția care transformă datele din format lung în larg. Operația este opusă celei efectuate de funcțiagather().
Noua concepție de transformare a datelor din format larg în lung și invers
Anterior, pentru acest tip de transformare erau folosite funcțiile gather() și spread(). De-a lungul anilor de existență a acestor funcții, a devenit evident că, pentru majoritatea utilizatorilor, inclusiv pentru autorul pachetului, numele acestor funcții și argumentele lor erau destul de neclare și provocau dificultăți în căutarea și înțelegerea acelei funcții care transformă un cadru de date din format larg în format lung și invers.
Din acest motiv, tidyr au fost adăugate două funcții noi, importante, care sunt destinate transformării cadrelor de date.
Funcții noi pivot_longer() și pivot_wider() au fost create sub influența unor funcții din pachetul cdata, creat de John Mount și Nina Zumel.
Instalarea celei mai recente versiuni tidyr 0.8.3.9000
Pentru a instala cea mai recentă versiune a pachetului, tidyr 0.8.3.9000, în care sunt disponibile noile funcții, utilizați următorul cod.
devtools::install_github("tidyverse/tidyr")
La momentul redactării acestui articol, aceste funcții sunt disponibile doar în versiunea dev a pachetului pe GitHub.
Trecerea la noi funcții
De fapt, nu este complicat să traduci vechile scripturi pentru a lucra cu noile funcții; pentru o mai bună înțelegere, voi lua un exemplu din documentația vechilor funcții și voi arăta cum aceste operațiuni sunt realizate folosind noile pivot_*() funcții.
Transformarea din format larg în format lung.
Exemplu de cod din documentația funcției gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformarea din format lung în format larg.
Exemplu de cod din documentația funcției spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Dacă în exemplele de mai sus de lucru cu pivot_longer() și pivot_wider(), în tabelul inițial, stocks nu sunt coloane enumerate în argumentele names_to și values_to numele lor trebuie specificate în ghilimele.
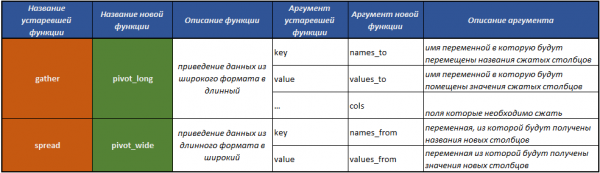
Un tabel cu ajutorul căruia îți va fi cel mai ușor să înțelegi cum să treci la noua conceptie tidyr.
Nota autorului
Întregul text care urmează este un traducere adaptivă, aș spune chiar liberă, de pe site-ul oficial al bibliotecii tidyverse.
Un exemplu simplu de transformare a datelor din format larg în lung
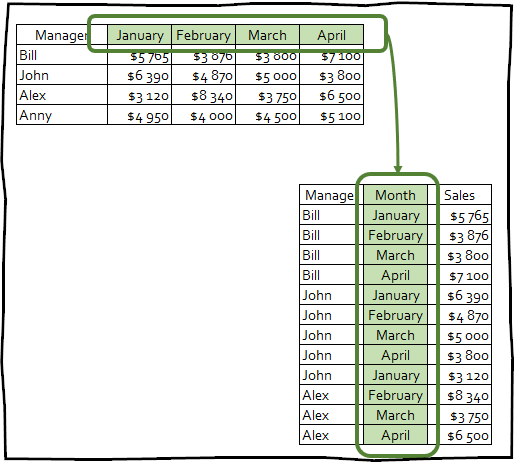
pivot_longer () — face seturile de date mai lungi, reducând numărul de coloane și crescând numărul de rânduri.
Pentru a efectua exemplele prezentate în articol, este necesar mai întâi să conectezi pachetele necesare:
library(tidyr)
library(dplyr)
library(readr)
Să presupunem că avem un tabel cu rezultatele unui sondaj, în care (printre altele) s-au întrebat oamenii despre religia lor și venitul anual:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Această tabelă conține date despre religia respondenților în rânduri, iar nivelul venitului este dispus pe denumirile coloanelor. Numărul respondenților din fiecare categorie este stocat în valorile celulelor la intersecția dintre religie și nivelul venitului. Pentru a aduce tabela într-un format ordonat și corect, este suficient să folosești pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # A tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostic 2 Agnostic $10-20k 34
#> 3 Agnostic $20-30k 60
#> 4 Agnostic $30-40k 81
#> 5 Agnostic $40-50k 76
#> 6 Agnostic $50-75k 137
#> 7 Agnostic $75-100k 122
#> 8 Agnostic $100-150k 109
#> 9 Agnostic >150k 84
#> 10 Agnostic Don't know/refused 96
#> # … with 170 more rowsArgumentele funcției pivot_longer()
- Primul argument cols, descrie ce coloane trebuie unite. În acest caz, toate coloanele, cu excepția time.
- Argumentul names_to dă un nume variabilei care va fi creată din denumirile coloanelor pe care le-am unit.
- values_to dă un nume variabilei care va fi creată din datele stocate în valorile celulelor coloanelor unite.
Specificatii
Aceasta este o nouă funcționalitate a pachetului tidyr, care anterior, în lucrul cu funcții învechite, nu era disponibilă.
Specificația este un cadru de date, fiecare rând corespunde unei coloane din noul cadru de date de ieșire, și două coloane speciale care încep cu :
- .name conține denumirea originală a coloanei.
- .value conține denumirea coloanei în care vor intra valorile celulelor.
Celelalte coloane din specificație reflectă modul în care în noua coloană vor fi afișate denumirile coloanelor comprimate din .name.
Specificația descrie metadatele stocate în denumirea coloanei, cu un rând pentru fiecare coloană și o coloană pentru fiecare variabilă, unind-o cu denumirea coloanei, poate acum o astfel de definiție pare complicată, dar după examinarea câtorva exemple va fi mult mai clar.
Sensul specificației este acela că poți extrage, modifica și defini noi metadate pentru cadrul de date transformat.
Pentru a lucra cu specificațiile la transformarea tabelului dintr-un format larg într-unul lung, se folosește funcția pivot_longer_spec().
Cum funcționează această funcție, ea preia orice cadru de date și își formează metadatele în modul descris mai sus.
Ca exemplu, să luăm setul de date who, care este furnizat împreună cu pachetul tidyr. Acest set de date conține informații furnizate de Organizația Mondială a Sănătății despre incidența tuberculozei.
who
#> # A tibble: 7,240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        & &
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … with 7,230 more rows, and 53 more variables
Să construim specificația acestuia.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsCâmpuri țara, iso2, iso3 sunt deja variabile. Sarcina noastră este să inversăm coloanele cu new_sp_m014 pe newrel_f65.
În denumirile acestor coloane se află următoarele informații:
- Prefix
new_indică faptul că coloana conține date despre noi cazuri de tuberculoză, cadrul de date curent conține informații doar despre noi îmbolnăviri, prin urmare acest prefix nu are o încărcătură semnificativă în contextul actual. sp/rel/sp/epdescrie metoda de diagnosticare a bolii.m/fsexul pacientului.014/1524/2535/3544/4554/65intervalul de vârstă al pacientului.
Putem separa aceste coloane folosind funcția extract(), utilizând o expresie regulată.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsRețineți, coloana .name trebuie să rămână neschimbată, deoarece este indexul nostru în denumirile coloanelor setului de date sursă.
Sexul și vârsta (coloanele gender și age) au valori fixe și cunoscute, prin urmare este recomandat să transformăm aceste coloane în factori:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
În final, pentru a aplica specificația creată de noi la cadrul de date sursă who trebuie să folosim argumentul spec în funcția pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
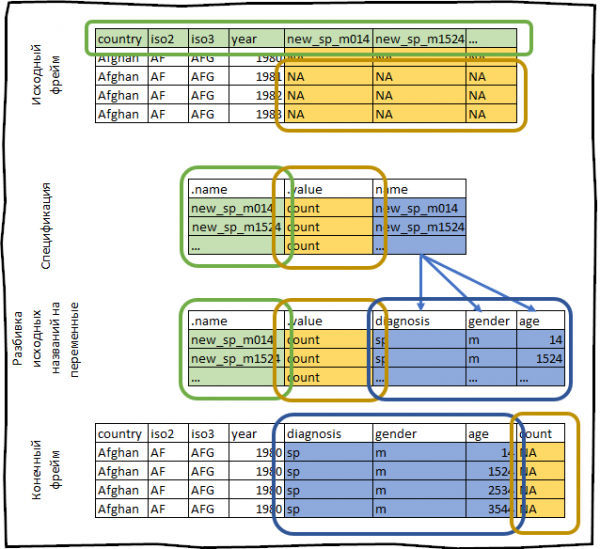
Tot ce am făcut acum poate fi schematic reprezentat astfel:
Specificație cu utilizarea mai multor valori (.value)
În exemplul de mai sus, coloana specificației .value a avut doar o singură valoare, de obicei așa este.
Dar uneori poate apărea o situație în care trebuie să adunați valori din coloane cu tipuri de date diferite. Cu ajutorul unei funcții învechite, spread() ar fi destul de greu de realizat.
Exemplul de mai jos este preluat din pachetul data.table.
Hai să creăm un cadru de date de antrenament.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Cadrele de date create conțin în fiecare rând informații despre copiii unei familii. Familiile pot avea unul sau doi copii. Pentru fiecare copil, sunt furnizate informații despre data nașterii și sex, datele fiecărui copil fiind în coloane separate. Sarcina noastră este de a aduce aceste date în formatul corect pentru analiză.
Observați că avem două variabile cu informații despre fiecare copil: sexul și data nașterii (coloanele cu prefixul dop conțin data nașterii, coloanele cu prefixul gender conțin sexul copilului). În rezultatul așteptat, acestea ar trebui să fie în coloane separate. Putem realiza acest lucru generând o specificație în care coloana .value va avea două valori diferite.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child")) %>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Așadar, să analizăm pas cu pas acțiunile care sunt realizate prin codul de mai sus.
pivot_longer_spec(-family)— creăm o specificație care comprimă toate coloanele disponibile, exceptând coloana family.separate(col = name, into = c(".value", "child"))— separăm coloana .name, care conține numele câmpurilor sursă, pe baza underscore-ului și introducem valorile obținute în coloanele .value și child.mutate(child = parse_number(child))— transformăm valorile câmpului child din tip text în tip numeric.
Acum putem aplica specificația obținută cadrele de date inițiale și să aducem tabelul în forma dorită.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Folosim argumentul na.rm = TRUE, deoarece forma actuală a datelor impune crearea de rânduri suplimentare pentru observații inexistente. Deoarece familia 2 are doar un singur copil, na.rm = TRUE garantează că familia 2 va avea un singur rând în datele de ieșire.
Transformarea data frame-urilor din format lung în larg
pivot_wider() — reprezintă o transformare inversă și, invers, crește numărul coloanelor din cadrul unui DataFrame prin reducerea numărului de rânduri.
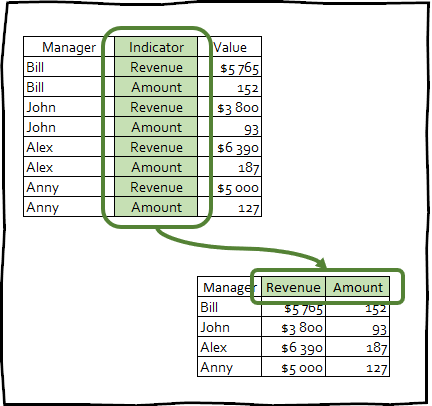
Un astfel de tip de transformare este folosit foarte rar pentru a aduce datele într-o formă ordonată, totuși această metodă poate fi utilă pentru a crea tabele pivot folosite în prezentări sau pentru integrarea cu alte instrumente.
De fapt, funcțiile pivot_longer() și pivot_wider() sunt simetrice și efectuează acțiuni inverse una față de alta, adică: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) și df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) va returna df-ul inițial.
Cel mai simplu exemplu de aducere a unei tabele în format larg
Pentru a demonstra funcția pivot_wider() vom folosi setul de date fish_encounters, care conține informații despre modul în care diverse stații urmăresc mișcarea peștilor în râu.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
În majoritatea cazurilor, această tabelă va fi mai informativă și mai ușor de utilizat dacă prezentăm informațiile pentru fiecare stație într-o coloană separată.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … cu 9 rânduri mai mult și 1 variabilă în plus: MAW
Acest set de date înregistrează informații doar în acele cazuri când peștele a fost detectat de stație, adică dacă vreun pește nu a fost observat de o anumită stație, atunci acele date nu vor fi în tabel. Aceasta înseamnă că rezultatul va fi completat cu NA.
Cu toate acestea, în acest caz știm că absența unei înregistrări înseamnă că peștele nu a fost observat, așa că putem folosi argumentul values_fill în funcția pivot_wider() și putem completa aceste valori lipsă cu zerouri:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generarea numelui coloanei din mai multe variabile de bază
Imaginați-vă că avem un tabel care conține combinații de produse, țări și ani. Pentru a genera un cadru de date de testare, puteți executa următorul cod:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsSarcina noastră este de a extinde cadrul de date astfel încât o coloană să conțină date pentru fiecare combinație de produs și țară. Pentru aceasta, este suficient să transmitem în argumentul names_from un vector care conține denumirile câmpurilor combinate.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsDe asemenea, puteți aplica specificații funcției pivot_wider(). Dar atunci când este transmis în pivot_wider() specificația efectuează o transformare opusă pivot_longer(): se creează coloanele specificate în .name, utilizând valorile din .value și alte coloane.
Pentru acest set de date, puteți genera o specificație personalizată dacă doriți ca fiecare combinație posibilă de țară și produs să aibă propria coloană, nu doar cele care sunt prezente în date:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Câteva exemple avansate de lucru cu noua concepție tidyr
Aducerea datelor într-o formă ordonată folosind un set de date despre recensământul veniturilor și chiriei din SUA
Setul de date us_rent_income conține informații despre venitul mediu și chiria pentru fiecare stat din SUA în 2017 (setul de date este disponibil în pachetul tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … with 94 more rows
În forma în care sunt stocate datele în setul de date, us_rent_income lucrul cu ele este extrem de inconvenient, așa că am dori să creăm un set de date cu coloanele: rent, rent_moe, come, income_moe. Există multe modalități de a crea această specificație, dar esențial este că trebuie să generăm fiecare combinație de valori ale variabilei estimate/moe, iar apoi să generăm numele coloanei.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeFurnizarea acestei specificații pivot_wider() ne oferă rezultatul pe care îl căutăm:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Banca Mondială
Uneori, transformarea unui set de date în forma dorită necesită mai mulți pași.
Set de date world_bank_pop conține datele băncii mondiale despre populația fiecărei țări în perioada 2000-2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Obiectivul nostru este să creăm un set de date bine structurat, unde fiecare variabilă se află într-o coloană separată. Deocamdată nu este clar ce pași sunt necesari, dar vom începe cu cea mai evidentă problemă: anul este distribuit pe mai multe coloane.
Pentru a corecta asta, este necesar să folosim funcția pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsUrmătorul pas este să ne concentrăm asupra variabilei indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Unde SP.POP.GROW reprezintă creșterea populației, SP.POP.TOTL reprezintă numărul total al populației, iar SP.URB. * reprezintă același lucru, dar doar pentru zona urbană. Să împărțim aceste valori în două variabile: area — teritoriu (total sau urban) și variabila care conține datele efective (population sau growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsAcum ne rămâne doar să împărțim variabila variable în două coloane:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsLista de contacte
Ultimul exemplu, imaginați-vă că aveți o listă de contacte pe care ați copiat și lipit-o de pe un site web:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Aducerea acestei liste într-o formă tabelară este destul de complicată, deoarece nu există o variabilă care să identifice ce date aparțin fiecărui contact. Putem corecta asta, observând că datele pentru fiecare nou contact încep cu numele ("name"), astfel putem crea un identificator unic și să îl mărim cu o unitate de fiecare dată când în coloana field apare valoarea “name”:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Acum, când avem un identificator unic pentru fiecare contact, putem transforma câmpul și valoarea în coloane:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Concluzie
Personal, consider că noua conceptie tidyr este într-adevăr mai intuitivă și depășește semnificativ funcțiile învechite. spread() și gather()Sper că acest articol v-a ajutat să înțelegeți pivot_longer() și pivot_wider().
Sursa: habr.com
