

Redundanța și disponibilitatea ridicată sunt subiecte mari, așa că vom dedica articole separate pentru RabbitMQ și Kafka. Acest articol este despre RabbitMQ, iar următorul va fi despre Kafka, în comparație cu RabbitMQ. Articolul este lung, așa că așezați-vă confortabil.
Vom examina strategiile de redundanță, consistență și disponibilitate ridicată (HA), precum și compromisurile la care trebuie să recurgem în fiecare strategie. RabbitMQ poate funcționa pe un cluster de noduri - și atunci este clasificată ca un sistem distribuit. Când vorbim despre sisteme distribuite, discutăm adesea despre consistență și disponibilitate.
Aceste concepte descriu cum se comportă un sistem în caz de eșec. Eșecul conexiunii de rețea, eșecul serverului, eșecul hard disk-ului, indisponibilitatea temporară a serverului din cauza colectării de date, pierderea pachetelor sau încetinirea conexiunii de rețea. Toate acestea pot duce la pierderi de date sau conflicte. Se dovedește a fi practic imposibil să se construiască un sistem care să fie simultan și complet coerent (fără pierderi de date, fără discrepanțe de date), și disponibil (care va accepta operațiuni de citire și scriere) pentru toate tipurile de eșecuri.
Vom vedea că consistența și disponibilitatea se află la capete opuse ale spectrului, iar va trebui să alegeți în ce direcție să optimizați. Vestea bună este că, cu RabbitMQ, această alegere este posibilă. Aveți acele «mânere nerdy» pentru a ajuta la balansarea către o consistență mai mare sau o disponibilitate mai mare.
Ne vom concentra asupra configurărilor care duc la pierderea datelor din cauza confirmărilor de scriere. Există o lanț de responsabilitate între publisheri, brokeri și consumatori. După ce un mesaj este transmis brokerului, aceasta este responsabilitatea sa - să nu piardă mesajul. Atunci când brokerul confirmă publisherului primirea mesajului, nu ne așteptăm ca acesta să fie pierdut. Dar vom vedea că acest lucru poate apărea, în funcție de configurarea brokerului și publisherului dvs.
Primitivii unui nod rezistent
Queue-uri rezistente/routing
În RabbitMQ există două tipuri de cozi: durabile (durable) și nedurabile (non-durable). Toate cozile sunt păstrate în baza de date Mnesia. Cozile durabile sunt declarate din nou la pornirea nodului și, astfel, supraviețuiesc repornirii, eșecului sistemului sau eșecului serverului (atâta timp cât datele sunt păstrate). Acest lucru înseamnă că, atâta timp cât declarați rutarea (exchange) și coada ca fiind durabile, infrastructura cozilor/rutării va reveni în modul operațional.
Cozi și rutare nedurabile sunt șterse la repornirea nodului.
Mesaje durabile
A avea o coadă durabilă nu înseamnă că toate mesajele sale vor supraviețui repornirii nodului. Vor fi restaurate doar mesajele marcate de publisher ca fiind durabile (persistent). Mesajele durabile creează cu adevărat o sarcină suplimentară asupra brokerului, dar dacă pierderea mesajului nu este acceptabilă, atunci nu există altă cale.
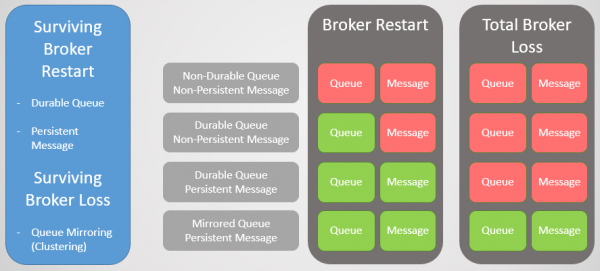
Fig. 1. Matricea durabilității
Clusterizare cu oglindire a cozilor
Pentru a supraviețui pierderii brokerului, avem nevoie de redundanță. Putem combina mai multe noduri RabbitMQ într-un cluster și apoi adăuga o redundanță suplimentară prin replicarea cozilor între mai multe noduri. Astfel, dacă un nod pică, nu pierdem date și rămânem accesibili.
Oglindirea cozilor:
- o coadă principală (master), care primește toate comenzile de scriere și citire
- una sau mai multe oglinzi, care primesc toate mesajele și metadatele din coada principală. Aceste oglinzi nu există pentru scalare, ci exclusiv pentru redundanță.
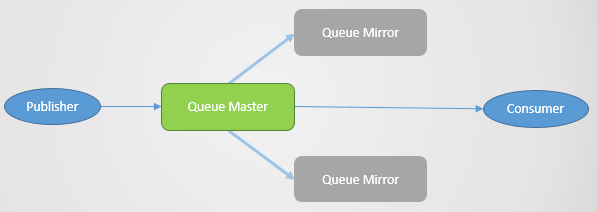
Fig. 2. Oglindirea cozilor
Oglindirea se stabilește printr-o politică corespunzătoare. În aceasta se poate alege coeficientul de replicare și chiar nodurile pe care ar trebui să fie plasată coada. Exemple:
ha-mode: allha-mode: exactly, ha-params: 2(o master și o oglindă)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Confirmarea către publisher
Pentru a asigura o înregistrare consecventă, sunt necesare confirmări de la publisher (Publisher Confirms). Fără acestea, există riscul de pierdere a mesajelor. Confirmarea este trimisă publisher-ului după ce mesajul este scris pe disc. RabbitMQ scrie mesajele pe disc nu la primire, ci periodic, în jur de câteva sute de milisecunde. Când coada este replicată, confirmarea este trimisă doar după ce toate replicile au scris și ele copia mesajului pe disc. Aceasta înseamnă că utilizarea confirmărilor adaugă o întârziere, dar dacă securitatea datelor este importantă, acestea sunt necesare.
Coada rezistentă la erori
Când brokerul se oprește sau se prăbușește, toate coada primare (master) de pe acest nod se opresc odată cu el. Apoi, clusterul selectează cea mai veche replică a fiecărui master și o promovează ca nou master.
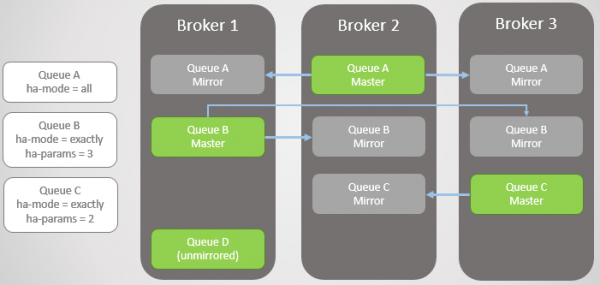
Fig. 3. Mai multe cozi replicate și politicile lor
Brokerul 3 se prăbușește. Observați că replica Cozii C de pe Brokerul 2 este promovată la master. De asemenea, observați că a fost creată o nouă replică pentru Coada C pe Brokerul 1. RabbitMQ încearcă întotdeauna să mențină coeficientul de replicare specificat în politicile dvs.
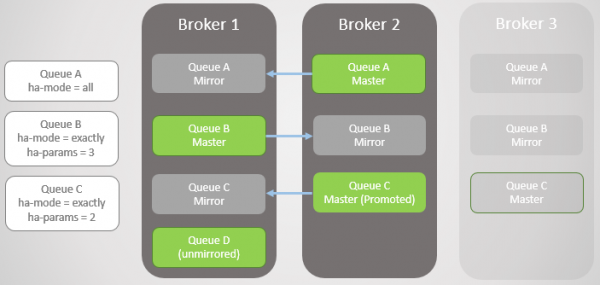
Fig. 4. Brokerul 3 se prăbușește, provocând eșecul cozii C
Se prăbușește următorul Broker 1! Ne-a mai rămas doar un broker. Replica Cozii B este promovată la master.
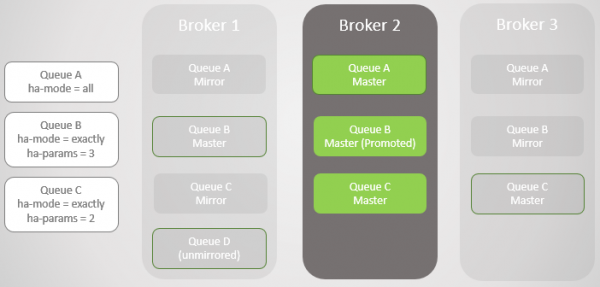
Fig. 5
Am recuperat Brokerul 1. Indiferent de cât de bine au trecut datele prin pierderea și recuperarea brokerului, toate mesajele replicate ale cozii sunt respinse la repornire. Este important de menționat acest lucru, deoarece vor exista consecințe. În curând vom examina aceste consecințe. Astfel, Brokerul 1 este din nou membru al clusterului, iar clusterul încearcă să respecte politicile și, prin urmare, creează replici pe Brokerul 1.
În acest caz, pierderea Brokerului 1 a fost totală, la fel ca și datele, de aceea Coada B, ne-replicată, a fost complet pierdută.
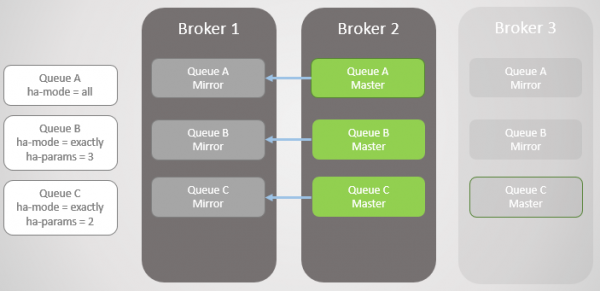
Fig. 6. Brokerul 1 revine în funcțiune
Broker 3 a revenit, iar cozii A și B primesc înapoi oglinzile create pe el pentru a-și satisface politica HA. Dar acum toate cozile principale sunt pe un singur nod! Acest lucru nu este ideal, ar fi mai bine să existe o distribuție uniformă între noduri. Din păcate, nu există opțiuni speciale pentru reechilibrarea masterelor. Vom reveni la această problemă mai târziu, deoarece trebuie să discutăm mai întâi despre sincronizarea cozii.
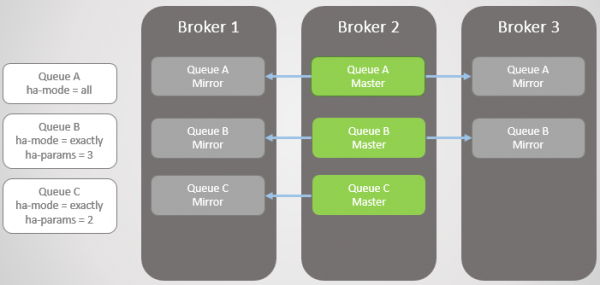
Fig. 7. Broker 3 revine. Toate cozile principale sunt pe un singur nod!
Astfel, acum ar trebui să aveți o idee despre cum oglinzile oferă redundanță și reziliență la defecte. Aceasta garantează disponibilitatea în caz de defecțiune a unui nod și protejează împotriva pierderii de date. Dar nu am terminat, pentru că, de fapt, lucrurile sunt mult mai complexe.
Sincronizare
Atunci când creați o nouă oglindă, toate mesajele noi vor fi întotdeauna replicate pe această oglindă și pe orice alte oglinzi. Cât despre datele existente în coada principală, le putem replica în noua oglindă, care devine o copie completă a masterului. De asemenea, putem alege să nu replicăm mesajele existente și să permitem cozii principale și noii oglinzi să se sincronizeze în timp, pe măsură ce mesaje noi intră în coada de final și mesajele existente ies din capul cozii principale.
Această sincronizare se efectuează automat sau manual, fiind gestionată prin politici de coadă. Să luăm un exemplu.
Avem două cozi oglindite. Coada A se sincronizează automat, iar Coada B – manual. Ambele cozi au câte zece mesaje.
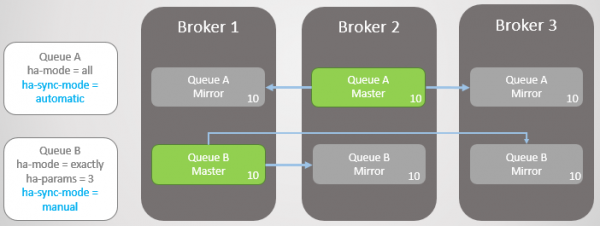
Fig. 8. Două cozi cu moduri diferite de sincronizare
Acum îl pierdem pe Broker 3.
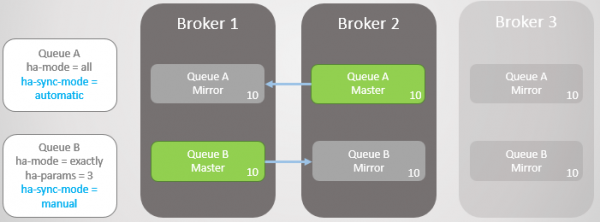
Fig. 9. Broker 3 a picat
Broker 3 revine. Clusterul creează o oglindă pentru fiecare coadă pe un nou nod și sincronizează automat noua Coada A cu masterul. Totuși, oglinda noii Cozi B rămâne goală. Astfel, avem o redundanță completă pentru Coada A și doar o oglindă pentru mesajele existente din Coada B.
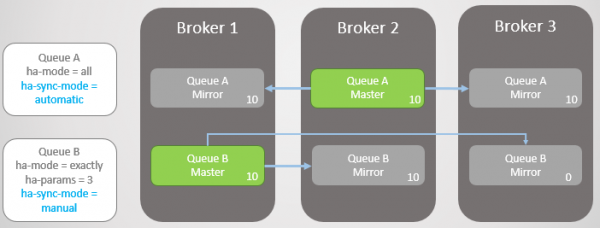
Fig. 10. Noua oglindă a Cozii A primește toate mesajele existente, iar noua oglindă a Cozii B – nu.
Ambele cozi primesc încă zece mesaje. Apoi Brokerul 2 se prăbușește, iar Coada A revine la cel mai vechi miror, care se află pe Brokerul 1. În cazul unei defecțiuni, nu există pierderi de date. În Coada B, sunt douăzeci de mesaje în master și doar zece în mirror, deoarece această coadă nu a repliat niciodată primele zece mesaje.
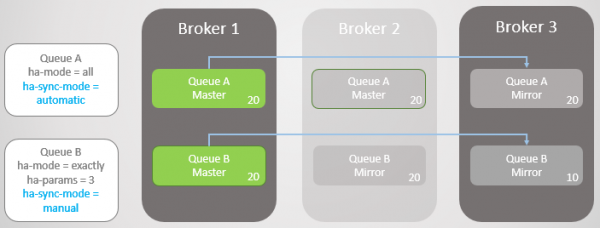
Fig. 11. Coada A revine pe Brokerul 1 fără pierderi de mesaje
Ambele cozi primesc încă zece mesaje. Acum, Brokerul 1 se prăbușește. Coada A trece fără probleme la mirror fără pierderi de mesaje. Totuși, Coada B întâmpină probleme. În acest stadiu, putem optimiza fie disponibilitatea, fie consistența.
Dacă dorim să optimizăm disponibilitatea, atunci politica ha-promote-on-failure trebuie setată la always. Aceasta este valoarea implicită, așa că putem pur și simplu să nu specificăm deloc politica. În acest caz, practic, acceptăm defecțiuni în oglinzile nesincronizate. Acest lucru va duce la pierderi de mesaje, dar coada rămâne disponibilă pentru citire și scriere.
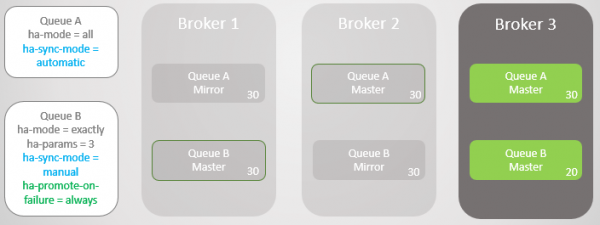
Fig. 12. Coada A revine pe Brokerul 3 fără pierderi de mesaje. Coada B revine pe Brokerul 3 cu pierderi de zece mesaje
De asemenea, putem seta ha-promote-on-failure to the value when-synced. În acest caz, în loc să revină la mirror, coada va aștepta până când Brokerul 1 cu datele sale revine în funcțiune. După revenirea sa, coada principală ajunge din nou pe Brokerul 1 fără pierderi de date. Disponibilitatea este sacrificată în favoarea securității datelor. Dar acesta este un mod riscant, care poate duce chiar la pierderi totale de date, ceea ce vom analiza în curând.
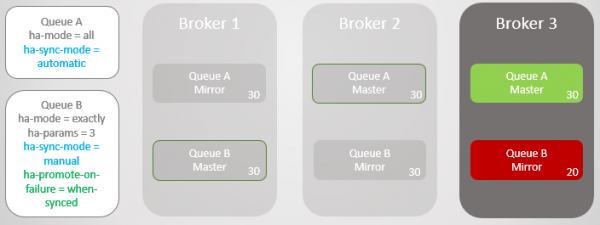
Fig. 13. Coada B rămâne indisponibilă după pierderea Brokerului 1
Te poți întreba: „Poate că ar fi mai bine să nu folosim niciodată sincronizarea automată?”. Răspunsul este că sincronizarea este o operațiune blocantă. În timpul sincronizării, coada principală nu poate efectua operațiuni de citire sau scriere!
Să luăm un exemplu. Acum avem cozi foarte mari. Cum pot ajunge la o asemenea dimensiune? Din mai multe motive:
- Cozi activ nu sunt folosite
- Acestea sunt cozi de mare viteză, iar în prezent consumatorii funcționează lent
- Acestea sunt cozi de mare viteză, a avut loc o defecțiune, iar consumatorii recuperează
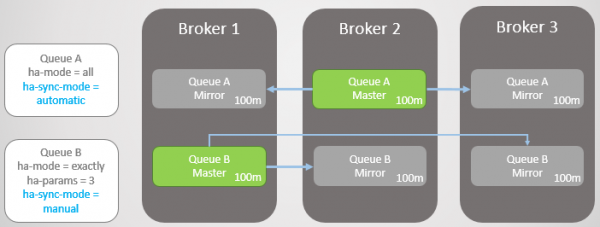
Fig. 14. Două cozi mari cu moduri diferite de sincronizare
Acum cade Broker 3.
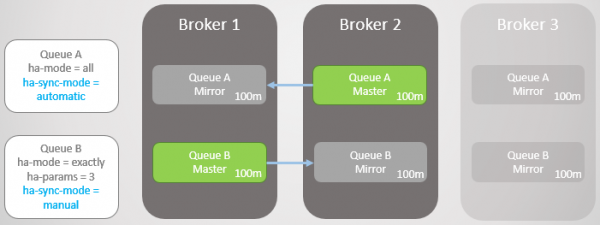
Fig. 15. Broker 3 cade, lăsând câte un master și un mirror în fiecare coadă
Broker 3 revine în funcțiune și se creează noi oglinzi. Coada Principală A începe să replicate mesajele existente pe noua oglindă, iar în acest timp coada nu este disponibilă. Replicarea datelor durează două ore, ceea ce duce la două ore de nefuncționare pentru această coadă!
Cu toate acestea, Coada B rămâne disponibilă pe toată perioada. Ea a sacrificat o parte din redundanță pentru a menține disponibilitatea.
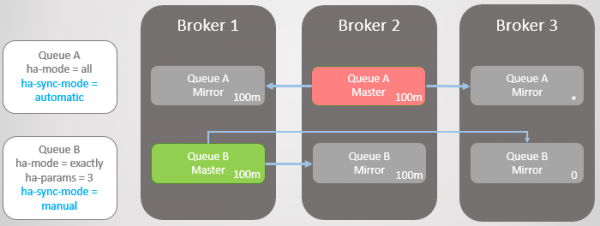
Fig. 16. Coada rămâne indisponibilă în timpul sincronizării
După două ore, Coada A devine și ea disponibilă și poate începe din nou să primească operațiuni de citire și scriere.
Actualizări
Comportamentul blocant în timpul sincronizării face dificilă actualizarea clusterelor cu cozi foarte mari. La un moment dat, nodul cu masterul trebuie repornit, ceea ce înseamnă fie trecerea pe oglindă, fie oprirea cozii în timpul actualizării serverului. Dacă alegem trecerea, vom pierde mesaje, dacă oglinzile nu sunt sincronizate. În mod default, în timpul opririi brokerului, trecerea pe o oglindă nesincronizată nu se efectuează. Aceasta înseamnă că, odată ce brokerul revine, nu pierdem mesaje, singurul impact fiind doar nefuncționarea cozii. Reguli de comportament la oprirea brokerului sunt definite de politică ha-promote-on-shutdown. Se poate stabili una dintre cele două valori:
always= trecerea pe oglinzi nesincronizate este activatăwhen-synced= doar trecerea pe oglinda sincronizată, altfel coada devine indisponibilă pentru citire și scriere. Coada revine în funcțiune imediat ce brokerul revine
Așa sau altfel, cu cozi mari trebuie să alegi între pierderea de date și indisponibilitate.
Când disponibilitatea crește, securitatea datelor crește
Înainte de a lua o decizie, trebuie să ia în considerare o altă complicație. Deși sincronizarea automată este mai bună pentru redundanță, cum afectează aceasta securitatea datelor? Bineînțeles, datorită redundanței mai bune, RabbitMQ are o probabilitate mai mică de a pierde mesajele existente, dar ce se întâmplă cu mesajele noi de la publisheri?
Aici trebuie să luăm în considerare următoarele:
- Poate un publisher să returneze pur și simplu o eroare, iar un serviciu superior sau un utilizator să încerce din nou mai târziu?
- Poate publisherul să salveze mesajul local sau în baza de date, pentru a încerca din nou mai târziu?
Dacă publisherul poate doar să ignore mesajul, atunci, de fapt, îmbunătățirea accesibilității crește și securitatea datelor.
Așadar, trebuie să căutăm un echilibru, iar soluția depinde de situația concretă.
Probleme cu ha-promote-on-failure=when-synced
Ideea ha-promote-on-failure= when-synced constă în faptul că prevenim comutarea pe o oglindă nesincronizată, evitând astfel pierderea de date. Coada rămâne inaccesibilă pentru citire sau scriere. În schimb, încercăm să recuperăm brokerul căzut cu datele intacte, astfel încât să își reia activitatea ca master fără pierderi de date.
Dar (și aici vine problema) dacă brokerul și-a pierdut datele, atunci avem o mare problemă: coada este pierdută! Toate datele au dispărut! Chiar dacă aveți oglinzi care ajung în mare parte din urmă la coada principală, aceste oglinzi sunt, de asemenea, respinse.
Pentru a adăuga din nou un nod cu același nume, spunem cluster-ului să uite nodul pierdut (cu comanda rabbitmqctl forget_cluster_node) și să lansăm un nou broker cu același nume de gazdă. Atâta timp cât cluster-ul își amintește nodul pierdut, își amintește vechea coadă și oglinzile nesincronizate. Când cluster-ului i se spune să uite nodul pierdut, acea coadă este de asemenea uitată. Acum trebuie să o declarăm din nou. Am pierdut toate datele, deși aveam oglinzi cu un set parțial de date. Ar fi fost mai bine să trecem la o oglindă nesincronizată!
Prin urmare, sincronizarea manuală (și neefectuarea sincronizării) împreună cu ha-promote-on-failure=when-synced, în opinia mea, este destul de riscantă. Documentele spun că această opțiune există pentru a proteja datele, dar este o sabie cu două tăișuri.
Reechilibrarea masterilor
Așa cum am promis, revenim la problema aglomerării tuturor masterilor pe unul sau mai multe noduri. Aceasta poate avea loc chiar și ca rezultat al unei actualizări „în valuri” (rolling) a cluster-ului. Într-un cluster cu trei noduri, toate coadă principale se vor aglomera pe unul sau două noduri.
Reechilibrarea masterilor poate fi problematică din două motive:
- Nu există instrumente bune pentru a efectua reechilibrarea
- Sincronizarea coadă
Pentru reechilibrare există un plugin terțiar , care nu este susținut oficial. În ceea ce privește pluginurile terțe în documentația RabbitMQ : „Pluginul oferă unele instrumente suplimentare de configurare și raportare, dar nu este suportat și nu a fost testat de echipa RabbitMQ. Folosiți-l pe riscul dvs.”.
Există încă un truc pentru a muta coada principală prin politicile HA. În manual este menționat pentru aceasta. Funcționează după cum urmează:
- Elimină toate oglinzile utilizând o politică temporară cu o prioritate mai mare decât politica HA existentă.
- Modifică politica temporară HA pentru a utiliza modul „noduri” specificând nodul pe care trebuie să fie mutată coada principală.
- Sincronizează coada pentru migrarea forțată.
- După finalizarea migrației, elimină politica temporară. Politica HA originală intră în vigoare și se creează numărul necesar de oglinzi.
Dezavantajul este că acest abordare poate să nu funcționeze dacă aveți cozi mari sau cerințe stricte de redundanță.
Acum să vedem cum funcționează clusterele RabbitMQ cu secțiunile de rețea.
Încălcarea coeziunii
Nodurile sistemului distribuit sunt conectate prin legături de rețea, iar legăturile de rețea pot fi și vor fi întrerupte. Frecvența întreruperilor depinde de infrastructura locală sau fiabilitatea norului ales. În orice caz, sistemele distribuite trebuie să fie capabile să facă față acestora. Din nou, avem de ales între disponibilitate și consistență, și din nou vestea bună este că RabbitMQ oferă ambele opțiuni (doar nu simultan).
Cu RabbitMQ avem două opțiuni principale:
- Permiteți separarea logică (split-brain). Aceasta asigură disponibilitate, dar poate provoca pierderi de date.
- Interziceți separarea logică. Poate duce la pierderi de disponibilitate pe termen scurt, în funcție de modul în care se conectează clienții la cluster. De asemenea, poate duce la indisponibilitatea totală în clusterul format din două noduri.
Dar ce este separarea logică? Este atunci când clusterul este împărțit în două din cauza pierderii legăturilor de rețea. Pe fiecare parte, oglinzile devin master, astfel încât, în cele din urmă, fiecare coadă are mai mulți masteri.
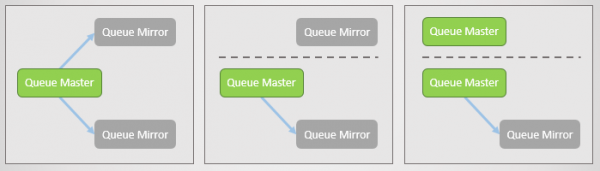
Fig. 17. Coada principală și două oglinzi, fiecare pe un nod separat. Apoi apare o defecțiune de rețea, iar o oglindă se separă. Nodul separat observă că celelalte două s-au deconectat și își avansează oglinzile la master. Acum avem două cozi principale, ambele permit scriere și citire.
Dacă publisherii trimit date către ambele mastere, vom avea două copii divergente ale cozii.
Diferitele moduri RabbitMQ asigură fie disponibilitate, fie consistență.
Modul Ignore (implicit)
Aceast mod asigură disponibilitate. După pierderea conectivității, se produce o separare logică. După restabilirea conectivității, administratorul trebuie să decidă cărei secțiuni să îi acorde prioritate. Partea pierdută va fi repornită, iar toate datele acumulate de această parte se pierd.
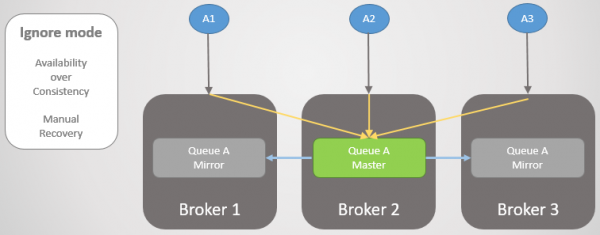
Fig. 18. Trei publisheri sunt conectați la trei brokeri. În interiorul clusterului, toate cererile sunt direcționate către coada principală de pe Brokerul 2.
Acum pierdem Brokerul 3. Acesta vede că ceilalți brokeri s-au deconectat și își promovează oglinda la master. Astfel are loc separarea logică.
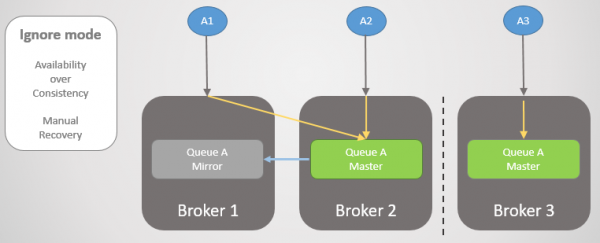
Fig. 19. Separarea logică (split-brain). Înregistrările merg în două cozi principale, iar cele două copii se separă.
Conectivitatea se restabilește, dar separarea logică rămâne. Administratorul trebuie să aleagă manual partea pierdută. În exemplul de mai jos, administratorul repornește Brokerul 3. Toate mesajele care nu au fost transmise se pierd.
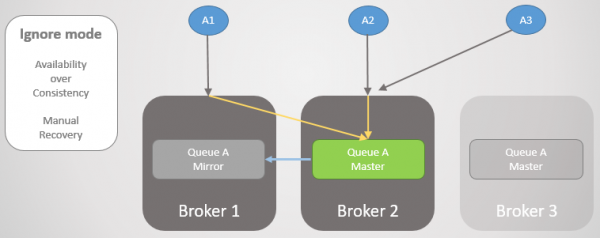
Fig. 20. Administratorul deconectează Brokerul 3.
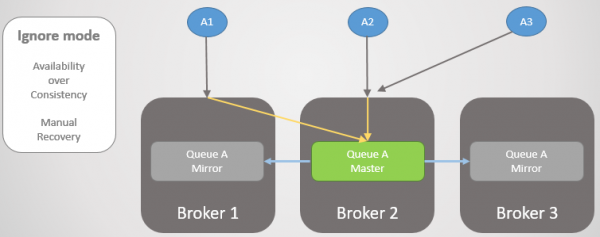
Fig. 21. Administratorul repornește Brokerul 3, iar acesta se alătură clusterului, pierzând toate mesajele care au rămas acolo.
În timpul pierderii conectivității și după restabilirea acesteia, clusterul și această coadă au fost disponibile pentru citire și scriere.
Modul Autoheal
Funcționează similar cu modul Ignore, cu excepția faptului că clusterul însuși alege automat partea pierdută după separare și restabilirea conectivității. Partea pierdută se întoarce în cluster goală, iar coada pierde toate mesajele care au fost trimise doar către acea parte.
Modul Pause Minority
Dacă nu dorim să permită divizarea logică, atunci singura noastră opțiune este să renunțăm la citirea și scrierea pe partea mai mică după separarea cluster-ului. Când brokerul observă că se află pe partea mai mică, oprește activitatea, adică închide toate conexiunile existente și refuză orice noi conexiuni. O dată pe secundă, verifică recuperarea conectivității. Odată ce conectivitatea este restabilită, își reia activitatea și se alătură cluster-ului.
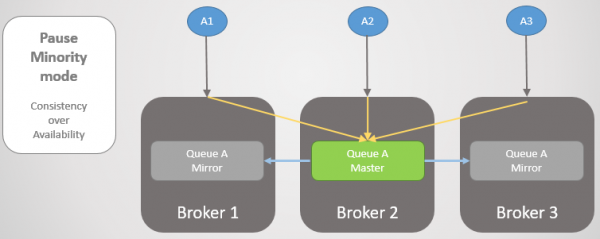
Fig. 22. Trei publicați sunt legați de trei brokeri. Intern, cluster-ul direcționează toate cererile către coada principală de la Broker 2.
Apoi, Brokerii 1 și 2 se separă de Broker 3. În loc să-și promoveze oglinda la master, Broker 3 oprește activitatea și devine inaccesibil.
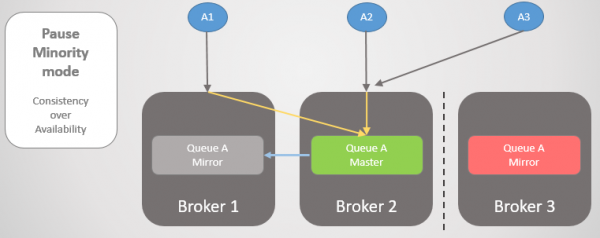
Fig. 23. Broker 3 oprește activitatea, deconectează toți clienții și respinge cererile de conectare.
Odată ce conectivitatea este restabilită, se întoarce în cluster.
Să ne uităm la un alt exemplu, unde coada principală este la Broker 3.
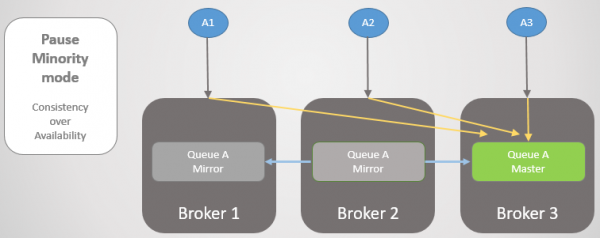
Fig. 24. Coada principală la Broker 3.
Apoi se produce aceeași pierdere de conectivitate. Broker 3 se oprește, deoarece se află pe partea mai mică. De cealaltă parte, nodurile observă că Broker 3 a căzut, astfel încât o oglindă mai veche de la Brokerii 1 și 2 este promovată la master.
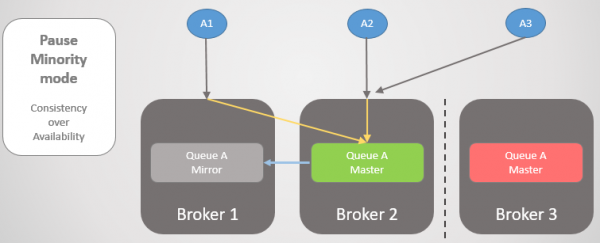
Fig. 25. Trecerea la Broker 2 în absența Brokerului 3.
Când conectivitatea este restabilită, Broker 3 se va alătura cluster-ului.

Fig. 26. Cluster-ul a revenit la funcționarea normală.
Aici este important să înțelegem că obținem consistență, dar putem să obținem și disponibilitate, dacă vom transfera cu succes clienții pe cea mai mare parte a secțiunii. În majoritatea situațiilor, personal aș alege modul Pause Minority, dar aceasta depinde cu adevărat de cazul specific.
Pentru a asigura disponibilitatea, este important să ne asigurăm că clienții se conectează cu succes la nod. Să luăm în considerare opțiunile noastre.
Asigurarea conectivității clienților
Avem mai multe opțiuni pentru a redirecționa clienții către partea principală a clusterului sau către noduri funcționale după o pierdere a conectivității (după o defecțiune a unui nod). Mai întâi, să ne amintim că o anumită coadă este găzduită pe un anumit nod, dar rutarea și politicile sunt replicate pe toate nodurile. Clienții se pot conecta la orice nod, iar rutarea internă îi va direcționa acolo unde trebuie. Însă, atunci când un nod este suspendat, acesta refuză conexiunile, așa că clienții trebuie să se conecteze la un alt nod. Dacă un nod a căzut, acesta nu mai poate face aproape nimic.
Opțiunile noastre:
- Accesul la cluster se face prin intermediul unui echilibrator de încărcare care pur și simplu trece prin noduri într-un mod ciclic, iar clienții fac încercări repetate de conectare până la finalizarea cu succes. Dacă un nod nu funcționează sau este suspendat, încercările de conectare la acel nod vor eșua, dar încercările ulterioare vor merge la alte servere (în mod ciclic). Aceasta este adecvată pentru o pierdere temporară a conectivității sau pentru un server căzut care va fi ridicat rapid.
- Acces la cluster prin intermediul unui echilibrator de încărcare și eliminarea nodurilor suspendate/căzute din listă imediat ce sunt detectate. Dacă se face rapid acest lucru, și dacă clienții pot efectua încercări repetate de conectare, atunci vom obține o disponibilitate constantă.
- A oferi fiecărui client o listă cu toate nodurile, iar clientul, la conectare, alege întâmplător unul dintre ele. Dacă, în timpul încercării de conectare, primește o eroare, atunci trece la următorul nod din listă, până când se conectează.
- A elimina traficul de pe nodul căzut/suspendat prin DNS. Acest lucru se face prin utilizarea unui TTL mic.
Conclusions
Clusterizarea RabbitMQ are avantajele și dezavantajele sale. Cele mai grave dezavantaje constau în faptul că:
- când se alătură clusterului, nodurile își abandonează datele;
- synchronizarea blocantă duce la indisponibilitatea cozii.
Toate deciziile dificile decurg din aceste două caracteristici ale arhitecturii. Dacă RabbitMQ ar putea salva datele la reconectarea cluster-ului, sincronizarea ar fi mai rapidă. Dacă ar putea realiza o sincronizare non-blocantă, ar susține mai bine cozi mari. Rezolvarea acestor două probleme ar îmbunătăți semnificativ caracteristicile RabbitMQ ca tehnologie de schimb de mesaje rezistentă la defecte și cu disponibilitate ridicată. Nu aș recomanda RabbitMQ cu clusterizare în următoarele situații:
- Rețea nesigură.
- Stocare nesigură.
- Cozi foarte mari.
În ceea ce privește setările pentru disponibilitate ridicată, luați în considerare următoarele:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(sauautoheal)- mesaje rezistente
- asigurați-vă că clienții se conectează la nodul activ atunci când un nod iese din funcțiune
Pentru consistență (securitatea datelor) luați în considerare următoarele setări:
- Publisher Confirms și Manual Acknowledgements pe partea consumatorului
ha-promote-on-failure=when-synced, dacă editorii pot încerca din nou mai târziu și dacă aveți un stocare foarte sigură! În caz contrar, setați=always.ha-sync-mode=automatic(dar pentru cozi mari inactivate poate fi necesar modul manual; de asemenea, luați în considerare dacă lipsa de acces va duce la pierderi de mesaje)- modul Pause Minority
- mesaje rezistente
Nu am acoperit încă toate aspectele privind rezistența la erori și disponibilitatea ridicată; de exemplu, cum să efectuați în siguranță proceduri administrative (cum ar fi actualizările succesive). Trebuie să discutăm și despre federare și plugin-ul Shovel.
Dacă am ratat ceva, vă rog să mă anunțați.
Vezi și , unde fac o explorare a cluster-ului RabbitMQ folosind Docker și Blockade pentru a verifica unele scenarii de pierdere a mesajelor menționate în acest articol.
Articolele anterioare din serie:
Nr. 1 —
Nr. 2 —
Nr. 3 —
Sursa: habr.com
