

În Am analizat clusterizarea RabbitMQ pentru asigurarea rezilienței și a disponibilității ridicate. Acum vom aprofunda în Apache Kafka.
Aici, unitatea de replicare este o partție. Fiecare topic are una sau mai multe partții. Fiecare partție are un lider cu sau fără followeri. Atunci când se creează un topic, se specifică numărul de partții și coeficientul de replicare. Valoarea obișnuită este 3, ceea ce înseamnă trei replici: un lider și doi followeri.
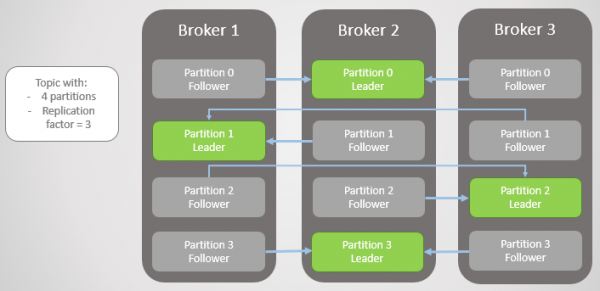
Fig. 1. Patru partții distribuite între trei brokeri.
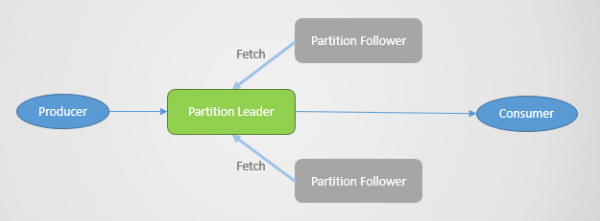
Toate cererile de citire și scriere ajung la lider. Followerii trimit periodic liderului cereri pentru a obține cele mai recente mesaje. Consumatorii nu se conectează niciodată la followeri, aceștia existând doar pentru redundanță și reziliență.
Defecțiune a partției.
Când brokerul se deconectează, adesea liderii mai multor partții ies din funcțiune. În fiecare dintre ele, lider devine un follower de pe un alt nod. În realitate, aceasta nu este întotdeauna situația, deoarece și factorul de sincronizare influențează: există followeri sincronizați, iar dacă nu, este permisă trecerea la o replică nesincronizată. Dar să nu complicăm lucrurile pentru moment.
Brokerul 3 se deconectează din rețea — și pentru partția 2 este ales un nou lider pe brokerul 2.
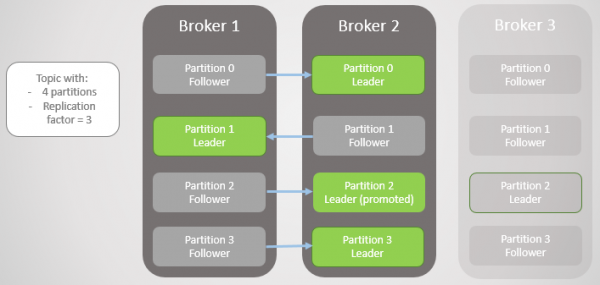
Fig. 2. Brokerul 3 moare, iar followerul său de pe brokerul 2 este ales noul lider al partției 2.
Apoi se deconectează brokerul 1, iar partția 1 își pierde și ea liderul, rolul fiind preluat de brokerul 2.
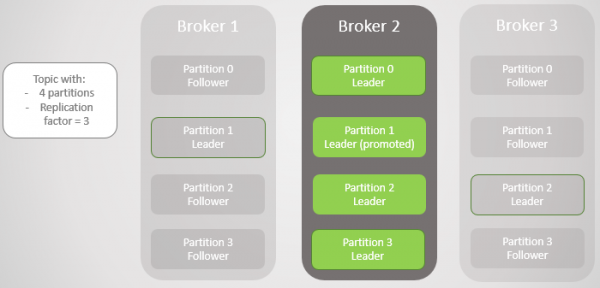
Fig. 3. A rămas un singur broker. Toți liderii se află pe același broker, cu redundantă zero.
Când brokerul 1 revine în rețea, adaugă patru followeri, asigurând o anumită redundanță fiecărei partții. Dar toți liderii rămân pe brokerul 2.
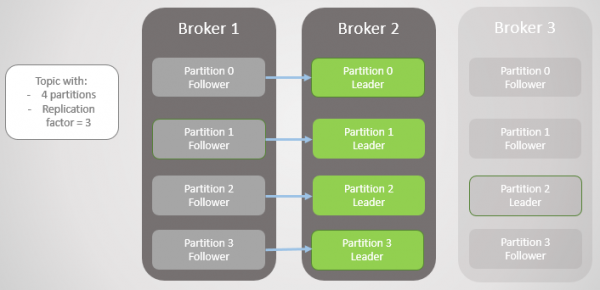
Fig. 4. Liderii rămân pe brokerul 2.
Când brokerul 3 se reintegrează, revenim la trei replici pe partție. Dar toți liderii rămân pe brokerul 2.
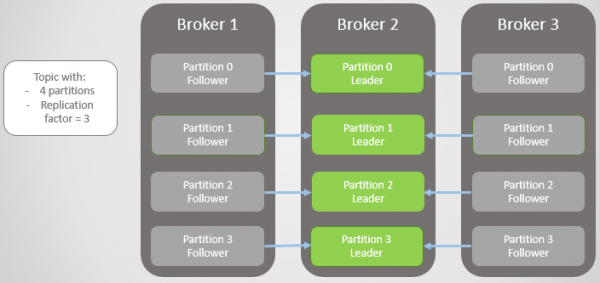
Fig. 5. Distribuție dezechilibrată a liderilor după restaurarea brokerilor 1 și 3.
Kafka are un instrument pentru o reclasare mai eficientă a liderilor decât RabbitMQ. Acolo era necesar să se folosească un plugin sau un script terț, care modifica politicile pentru migrarea nodului principal prin reducerea redundanței în timpul migrației. În plus, pentru cozi mari era necesar să ne conformăm cu indisponibilitatea în timpul sincronizării.
Kafka are o concepție de „replici preferate” pentru rolul de lider. Atunci când se creează partiții de topici, Kafka încearcă să distribuie liderii uniform pe noduri și marchează acești primi lideri ca fiind preferați. În timp, din cauza repornirii serverelor, a defecțiunilor și a pierderii de conectivitate, liderii pot fi mutați pe alte noduri, așa cum s-a menționat în cazul extrem anterior.
Pentru a remedia acest lucru, Kafka oferă două opțiuni:
- Opțiune auto.leader.rebalance.enable=true permete nodului de control să revină automat liderii la replicile preferate, restabilind astfel o distribuție uniformă.
- Administratorul poate rula scriptul kafka-preferred-replica-election.sh pentru a reatribui manual.
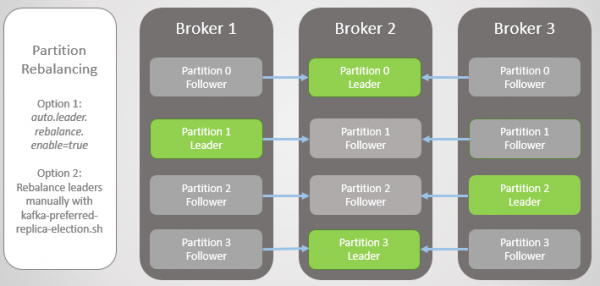
Fig. 6. Replici după rebalansare
Aceasta a fost o versiune simplificată a defecțiunii, dar realitatea este mai complicată, deși nimic prea dificil aici. Totul se reduce la replicile sincronizate (In-Sync Replicas, ISR).
Replicile sincronizate (ISR)
ISR este un set de replici ale unei partiții care este considerat „sincronizat” (in-sync). Aici există un lider, iar followerii pot să nu fie. Un follower este considerat sincronizat dacă a realizat copii exacte ale tuturor mesajelor liderului înainte de expirarea intervalului replica.lag.time.max.ms.
Un follower este îndepărtat din setul ISR dacă:
- nu a solicitat o extragere în intervalul replica.lag.time.max.ms (considerat mort)
- nu a reușit să se actualizeze în interval replica.lag.time.max.ms (considerat lent)
Followerii fac cereri pentru extragere în intervalul replica.fetch.wait.max.ms, care este setat implicit la 500 ms.
Pentru a explica clar scopul ISR, trebuie să ne uităm la confirmările de la producător și la unele scenarii de defecțiune. Producătorii pot alege când brokerul trimite o confirmare:
- acks=0, confirmarea nu este trimisă
- acks=1, confirmarea este trimisă după ce liderul a scris mesajul în jurnalul său local
- acks=all, confirmarea este trimisă după ce toate replicile din ISR au scris mesajul în jurnalele lor locale
În terminologia Kafka, dacă ISR a stocat mesajul, are loc „commit”-ul acestuia. Acks=all este cea mai sigură opțiune, dar implică și o întârziere suplimentară. Să examinăm două exemple de defecțiune și cum diferitele opțiuni ‘acks’ interacționează cu conceptul ISR.
Acks=1 și ISR
În acest exemplu, vom observa că, dacă liderul nu așteaptă confirmarea fiecărui mesaj de la toți followerii, atunci, în cazul unei defecțiuni a liderului, s-ar putea pierde date. Trecerea la un follower nesincronizat poate fi permisă sau interzisă prin configurare. unclean.leader.election.enable.
În acest exemplu, producătorul are setarea acks=1. Partiția este distribuită pe toate cele trei brokeri. Brokerul 3 este în întârziere, s-a sincronizat cu liderul acum opt secunde și acum întârzie cu 7456 mesaje. Brokerul 1 a întârziat doar cu o secundă. Producătorul nostru trimite un mesaj și primește rapid un ack, fără a avea overhead pentru followeri care sunt lenti sau inactivi, de care liderul nu așteaptă.
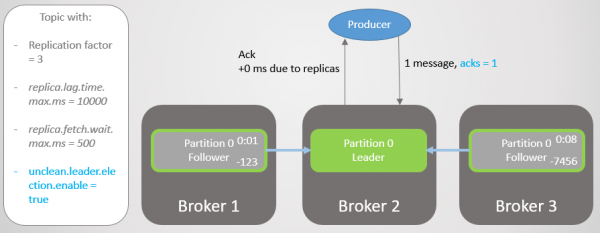
Fig. 7. ISR cu trei replici
Brokerul 2 eșuează, iar producătorul primește o eroare de conexiune. După ce conducerea este preluată de brokerul 1, pierdem 123 mesaje. Followerul de pe brokerul 1 a fost în ISR, dar nu s-a sincronizat complet cu liderul când acesta a căzut.
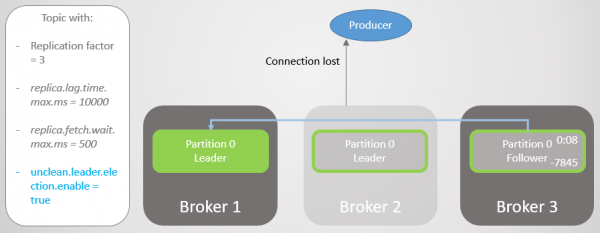
Fig. 8. Mesajele sunt pierdute în cazul unei defecțiuni
În configurație bootstrap.servers producătorul are enumerate mai multe brokeri și acesta poate întreba un alt broker cine a devenit noul lider al partiției. Apoi, stabilește o conexiune cu brokerul 1 și continuă să trimită mesaje.
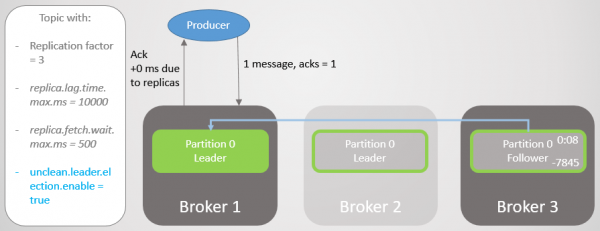
Fig. 9. Trimiterea mesajelor este reluată după o scurtă pauză
Brokerul 3 întârzie și mai mult. Acesta face cereri de extragere, dar nu poate sincroniza. Acest lucru poate fi cauzat de o conexiune de rețea lentă între brokeri, o problemă de stocare etc. Este eliminat din ISR. Acum, ISR constă dintr-o singură replică – liderul! Producătorul continuă să trimită mesaje și să primească confirmări.
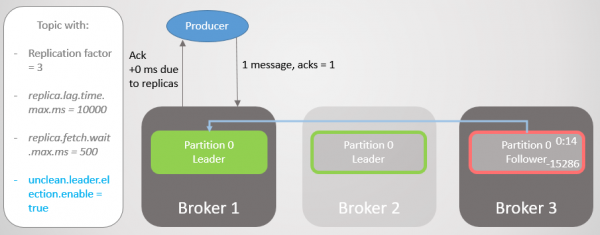
Fig. 10. Followerul de pe brokerul 3 este eliminat din ISR
Brokerul 1 se defectează, iar rolul de lider trece la brokerul 3 cu o pierdere de 15286 mesaje! Producătorul primește un mesaj de eroare de conexiune. Trecerea la liderul din afara ISR a fost posibilă doar datorită setării unclean.leader.election.enable=true. Dacă aceasta este setată la false, atunci trecerea nu ar fi avut loc, iar toate cererile de citire și scriere ar fi fost respinse. În acest caz, așteptăm întoarcerea brokerului 1 cu datele sale intacte în replică, care va prelua din nou conducerea.
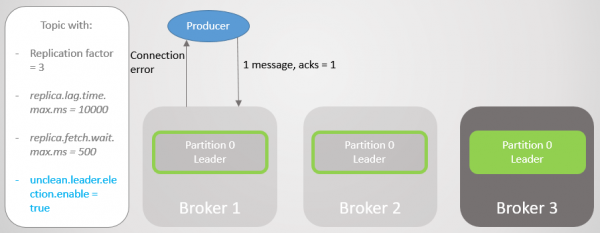
Fig. 11. Brokerul 1 se defectează. La o defecțiune se pierd multe mesaje.
Producătorul stabilește o conexiune cu ultimul broker și observă că acesta este acum liderul secțiunii. El începe să trimită mesaje brokerului 3.
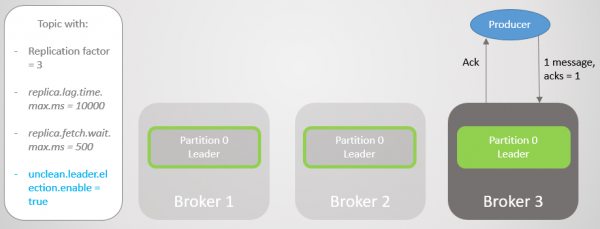
Fig. 12. După o scurtă pauză, mesajele sunt din nou trimise în secțiunea 0
Am observat că, în afară de scurtele întreruperi pentru a stabili noi conexiuni și căutarea unui nou lider, producătorul a continuat constant să trimită mesaje. Această configurație asigură disponibilitatea prin consistență (securitatea datelor). Kafka a pierdut mii de mesaje, dar a continuat să primească noi înregistrări.
Acks=all și ISR
Să repetăm acest scenariu încă o dată, dar cu acks=all. Întârzierea brokerului 3 este în medie de patru secunde. Producătorul trimite un mesaj cu acks=all, și acum nu primește un răspuns rapid. Liderul așteaptă până când toate replicile din ISR salvează mesajul.
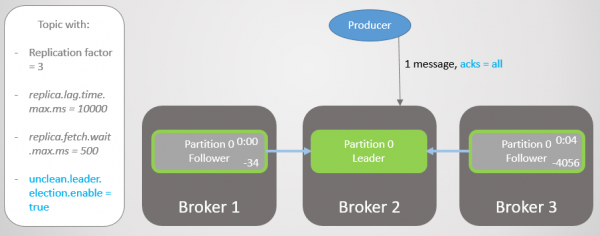
Fig. 13. ISR cu trei replici. Una funcționează lent, ceea ce duce la o întârziere a scrierii
După patru secunde de întârziere suplimentară, brokerul 2 trimite ack. Toate replicile sunt acum complet actualizate.
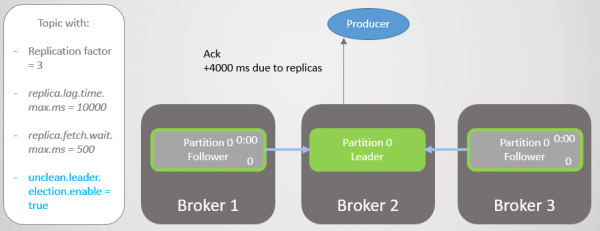
Fig. 14. Toate replicile păstrează mesajele și trimite ack
Brokerul 3 acum întârzie și mai mult și este eliminat din ISR. Întârzierea se reduce semnificativ, deoarece nu au rămas replici lente în ISR. Brokerul 2 așteaptă acum doar brokerul 1, care are o întârziere medie de 500 ms.
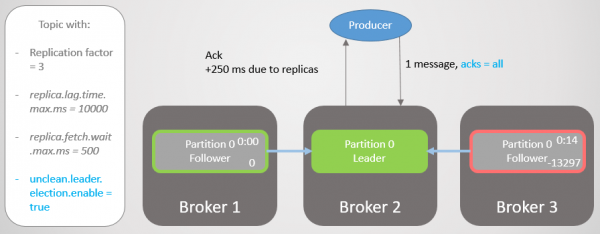
Fig. 15. Replica de pe brokerul 3 este eliminată din ISR
Apoi, brokerul 2 cedează, iar conducerea trece la brokerul 1 fără pierderi de mesaje.
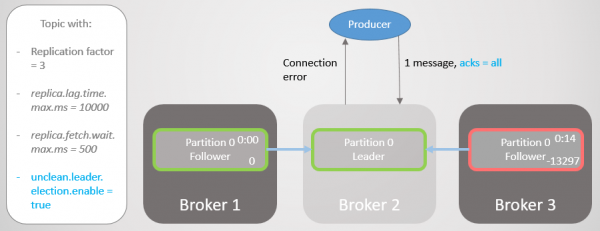
Fig. 16. Brokerul 2 cade
Producătorul găsește un nou lider și începe să-i trimită mesaje. Întârzierea se reduce și mai mult, deoarece acum ISR constă dintr-o singură replică! Prin urmare, opțiunea acks=all nu adaugă redundanță.
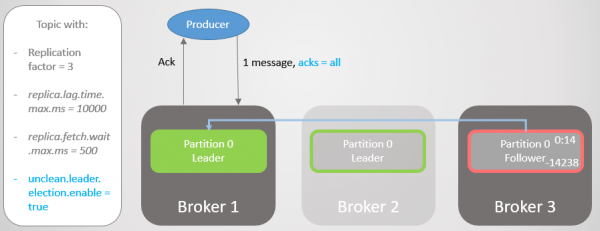
Fig. 17. Replica de pe brokerul 1 își asumă conducerea fără pierderi de mesaje
Apoi, brokerul 1 cedează, iar conducerea trece la brokerul 3 cu pierderea a 14238 de mesaje!
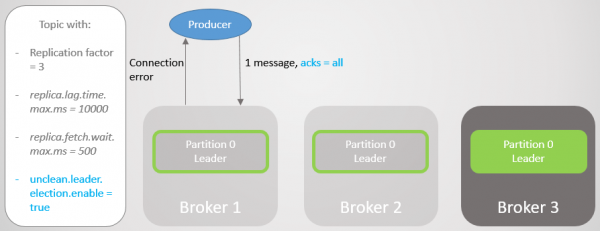
Fig. 18. Brokerul 1 moare, iar trecerea conducerii cu setarea necurată duce la pierderi considerabile de date
Am fi putut să nu stabilim opțiunea unclean.leader.election.enable to the value true. În mod implicit, aceasta este egală cu false. Configurarea acks=all de unclean.leader.election.enable=true asigură disponibilitatea cu o anumită securitate suplimentară a datelor. Dar, după cum vedeți, putem încă pierde mesaje.
Dar ce se întâmplă dacă dorim să creștem securitatea datelor? Putem seta unclean.leader.election.enable = false, dar aceasta nu garantează că vom proteja datele de pierdere. Dacă liderul a căzut drastic și a dus cu el datele, mesajele rămân pierdute, plus că accesibilitatea se pierde până când administratorul va restabili situația.
Mai bine să garantăm redundanța tuturor mesajelor, altfel să ne abținem de la înregistrare. Atunci, din punctul de vedere al brokerului, pierderea datelor este posibilă doar în cazul a două sau mai multe defecțiuni simultane.
Acks=all, min.insync.replicas și ISR
Cu configurația topicului min.insync.replicas ne creștem nivelul de securitate a datelor. Să trecem încă o dată prin ultima parte a scenariului precedent, dar de data aceasta cu min.insync.replicas=2.
Așadar, brokerul 2 are liderul replicii, iar followerul de pe brokerul 3 a fost eliminat din ISR.
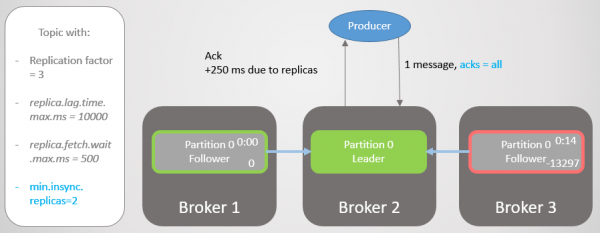
Fig. 19. ISR din două replici
Brokerul 2 se prăbușește, iar lideratul trece la brokerul 1 fără pierderea mesajelor. Dar acum ISR constă doar dintr-o singură replică. Acest lucru nu corespunde numărului minim pentru a primi înregistrări și, prin urmare, brokerul răspunde la încercarea de înregistrare cu o eroare. NotEnoughReplicas.
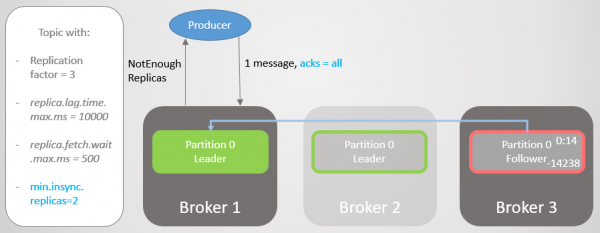
Fig. 20. Numărul ISR cu unul mai puțin decât cel specificat în min.insync.replicas
Această configurație sacrifică disponibilitatea pentru consens. Înainte de a confirma un mesaj, ne asigurăm că acesta este înregistrat pe cel puțin două replici. Acest lucru oferă producătorului o mult mai mare încredere. Pierderea mesajelor este posibilă aici doar în cazul unei defecțiuni simultane a două replici într-un interval scurt, înainte ca mesajul să fie replicat unui follower suplimentar, ceea ce este puțin probabil. Dar dacă ești superparanoic, poți stabili un coeficient de replicare de 5, iar min.insync.replicas la 3. Aici, imediat trei brokeri trebuie să se prăbușească simultan pentru a pierde o înregistrare! Desigur, pentru o asemenea fiabilitate vei plăti cu o întârzierere suplimentară.
Când disponibilitatea este necesară pentru securitatea datelor
Ca și în , uneori disponibilitatea este necesară pentru securitatea datelor. Trebuie să te gândești la următoarele lucruri:
- Poate publisherul să returneze pur și simplu o eroare, iar serviciul superior sau utilizatorul să încerce din nou mai târziu?
- Poate publisherul să salveze mesajul local sau în baza de date, pentru a încerca din nou mai târziu?
Dacă răspunsul este negativ, optimizarea disponibilității crește securitatea datelor. Veți pierde mai puține date dacă alegeți disponibilitatea în locul respingerii записей. Astfel, totul se rezumă la găsirea unui echilibru, iar decizia depinde de situația specifică.
Sensul ISR
Setul ISR permite alegerea unui echilibru optim între securitatea datelor și latență. De exemplu, asigurarea disponibilității în condiții de eșec al majorității replicatelor, minimizând impactul replicatelor moarte sau lente în termeni de latență.
Noi alegem valoarea replica.lag.time.max.ms în funcție de nevoile noastre. În esență, acest parametru înseamnă ce latență suntem dispuși să acceptăm la acks=all. Valoarea implicită este de zece secunde. Dacă pentru tine este prea mult, o poți reduce. Atunci va crește frecvența modificărilor în ISR, deoarece urmaritorii vor fi eliminați și adăugați mai des.
În RabbitMQ există pur și simplu un set de oglinzi care trebuie replicate. Oglinzile lente introduc o întârziere suplimentară, iar răspunsul oglinzilor moarte poate dura până la expirarea timpului de viață al pachetelor care verifică disponibilitatea fiecărui nod (net tick). ISR este o metodă interesantă de a evita aceste probleme cu creșterea latenței. Dar riscăm să pierdem redundanța, deoarece ISR se poate reduce doar la lider. Pentru a evita acest risc, folosiți setarea min.insync.replicas.
Garanția conexiunii clienților
În setările bootstrap.servers producer și consumer, puteți specifica mai mulți brokeri pentru conectarea clienților. Ideea este că, în cazul în care un nod este oprit, rămân câțiva de rezervă cu care clientul poate stabili o conexiune. Aceștia nu trebuie să fie liderii secțiunilor, ci pur și simplu un punct de plecare pentru încărcarea inițială. Clientul poate întreba care nod găzduiește liderul secțiunii pentru citire/scriere.
În RabbitMQ, clienții se pot conecta la orice nod, iar rutarea internă trimite cererea acolo unde trebuie. Aceasta înseamnă că puteți plasa un balancer de încărcare înainte de RabbitMQ. Kafka necesită ca clienții să se conecteze la nodul pe care se află liderul secțiunii corespunzătoare. Într-o astfel de situație, un balancer de încărcare nu poate fi instalat. Lista bootstrap.servers este critică pentru ca clienții să poată accesa nodurile necesare și să le găsească după o defecțiune.
Arhitectura consensului Kafka
Până acum, nu am discutat despre modul în care clusterul află despre căderea unui broker și cum este ales un nou lider. Pentru a înțelege cum funcționează Kafka cu partițiile de rețea, trebuie să înțelegem mai întâi arhitectura consensului.
Fiecare cluster Kafka este implementat împreună cu un cluster Zookeeper - un serviciu de consens distribuit care permite sistemului să ajungă la un consens asupra unui anumit stadiu, punând accentul pe consistență în detrimentul disponibilității. Consensul majorității nodurilor Zookeeper este necesar pentru aprobarea operațiunilor de citire și scriere.
Zookeeper păstrează starea clusterului:
- Lista topicurilor, partițiilor, configurația, replicile curente ale liderului, replicile preferate.
- Membrii clusterului. Fiecare broker trimite un ping la clusterul Zookeeper. Dacă Zookeeper nu primește ping-ul în termenul specificat, atunci îl marchează pe broker ca nedisponibil.
- Alegerea nodurilor primare și de rezervă pentru controler.
Nodul controler este unul dintre brokerii Kafka responsabil de alegerea liderilor replicilor. Zookeeper trimite notificări controlerului despre schimbările de membru al clusterului și modificările topicului, iar controlerul trebuie să acționeze conform acestor modificări.
De exemplu, să luăm un nou topic cu zece partiții și un coeficient de replicare de 3. Controlerul trebuie să aleagă liderul fiecărei partiții, încercând să distribuie optim liderii între brokeri.
Pentru fiecare partiție, controlerul:
- actualizează informațiile în Zookeeper despre ISR și lider;
- trimite comanda LeaderAndISRCommand fiecărui broker care găzduiește replica acestei partiții, informând brokerii despre ISR și lider.
Când un broker lider pică, Zookeeper trimite o notificare controlerului, iar acesta alege un nou lider. Din nou, controlerul actualizează mai întâi Zookeeper, apoi trimite comanda fiecărui broker, informându-i despre schimbarea de lider.
Fiecare lider este responsabil pentru setul de ISR. Configurarea replica.lag.time.max.ms determină cine va face parte din acesta. Atunci când ISR se schimbă, liderul comunică lui Zookeeper noile informații.
Zookeeper este întotdeauna informat despre orice modificări, astfel încât, în caz de defecțiune, conducerea să se transfere lin către un nou lider.
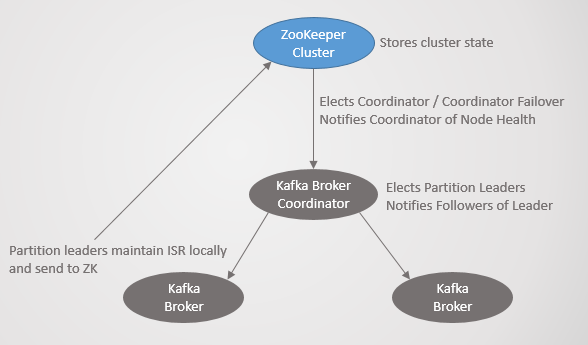
Fig. 21. Consensul Kafka
Protocolul de replicare
Înțelegerea detaliilor replicării ajută la o înțelegere mai bună a scenariilor potențiale de pierdere a datelor.
Cereri de selecție, Log End Offset (LEO) și Highwater Mark (HW)
Am analizat că followerii trimit periodic liderului cereri de extragere (fetch). Intervalul implicit este de 500 ms. Acesta diferă de RabbitMQ prin faptul că, în RabbitMQ, replicarea este inițiată nu de oglinda cozii, ci de master. Masterul împinge modificările către oglinzi.
Liderul și toți followerii păstrează offsetul final al jurnalului (Log End Offset, LEO) și eticheta Highwater (HW). Eticheta LEO păstrează offsetul ultimei mesaje în replica locală, iar HW - offsetul ultimei confirmări. Amintiți-vă că, pentru statusul „confirmare”, mesajul trebuie să fie stocat în toate replicile ISR. Aceasta înseamnă că LEO înaintează de obicei puțin înainte de HW.
Când liderul primește un mesaj, acesta îl stochează local. Followerul face o cerere de extragere, transmitându-și LEO. Apoi, liderul trimite un pachet de mesaje, începând de la acel LEO, și de asemenea transmite HW-ul curent. Când liderul primește informația că toate replicile au stocat mesajul cu offset-ul specificat, acesta mută eticheta HW. Numai liderul poate muta HW, iar astfel toți followerii află valoarea curentă în răspunsurile la cererile lor. Aceasta înseamnă că followerii pot rămâne în urmă față de lider atât în ceea ce privește mesajele, cât și în privința cunoștinței HW. Consumatorii primesc mesaje doar până la HW-ul curent.
Rețineți că „salvat” (persisted) înseamnă scris în memorie, nu pe disc. Pentru performanță, Kafka efectuează sincronizarea pe disc la un interval specific. RabbitMQ are, de asemenea, un astfel de interval, dar va trimite o confirmare publicatorului doar după ce masterul și toate oglinzile au scris mesajul pe disc. Dezvoltatorii Kafka, din motive de performanță, au decis să trimită ack imediat ce mesajul este scris în memorie. Kafka mizează pe faptul că redundanța compensează riscul de stocare pe termen scurt a mesajelor confirmate doar în memorie.
Eșec al liderului
Când liderul pica, Zookeeper notifică controllerul, care alege o nouă replică a liderului. Noul lider stabilește o nouă etichetă HW conform LEO-ului său. Apoi, informația despre noul lider este primită de followeri. În funcție de versiunea Kafka, followerul va alege una dintre două scenarii:
- Își va trunchia jurnalul local până la HW cunoscut și va trimite noului lider o cerere pentru mesajele după această etichetă.
- Trimite o solicitare liderului pentru a obține HW la momentul alegerii sale ca lider, apoi va tăia logul până la această deplasare. Apoi, va începe să facă solicitări periodice pentru a extrage date, începând cu această deplasare.
Follower-ul poate fi nevoit să trimită un log din următoarele motive:
- Atunci când apare o defecțiune a liderului, primul follower din setul ISR, înregistrat în Zookeeper, câștigă alegerile și devine lider. Toți follower-ii din ISR, deși considerați «sincronizați», pot să nu fi primit de la fostul lider copia tuturor mesajelor. Este foarte posibil ca follower-ul ales să nu aibă cea mai actualizată copie. Kafka garantează că între replici nu există discrepanțe. Astfel, pentru a evita discrepanțele, fiecare follower trebuie să își taie logul până la valoarea HW a noului lider la momentul alegerii sale. Aceasta este o altă motivare pentru care configurația acks=all este esențială pentru consistență.
- Mesajele sunt scrise periodic pe disc. Dacă toate nodurile din cluster se defectează simultan, replicile vor păstra diferite deplasări pe discuri. Este posibil ca atunci când brokerii revin în rețea, noul lider care va fi ales să fie în urmă față de follower-ii săi, deoarece a fost salvat pe disc înaintea altora.
Reîmperecherea cu clusterul
În timpul reîmperecherii cu clusterul, replicile se comportă la fel ca în cazul defecțiunii liderului: verifică replica liderului și își taie logul până la HW-ul său (la momentul alegerii). Spre deosebire, RabbitMQ consideră nodurile reîmperecheate ca fiind complet noi. În ambele cazuri, brokerul elimină orice stare existentă. Dacă se folosește sincronizarea automată, atunci masterul trebuie să replici complet toate conținuturile curente în noul oglindă prin metoda „să aștepte toată lumea”. În timpul acestei operațiuni, masterul nu acceptă nicio operație de citire sau scriere. Această abordare creează probleme în cozi mari.
Kafka este un jurnal distribuit, și în general stochează mai multe mesaje decât coada RabbitMQ, unde datele sunt eliminate din coadă după ce sunt citite. Cozi active trebuie să rămână relativ mici. Dar Kafka este un jurnal cu propria politică de stocare, care poate stabili un termen de zile sau săptămâni. Abordarea cu blocarea cozii și sincronizarea totală este complet inacceptabilă pentru un jurnal distribuit. În schimb, followerii Kafka pur și simplu își taie jurnalul până la liderul HW (în momentul alegerii sale) în cazul în care copia lor îi depășește pe lider. În cazul mai probabil, când followerul este în urmă, acesta începe pur și simplu să facă cereri de preluare, începând de la LEO-ul său actual.
Followerii noi sau reintegrați încep în afara ISR și nu participă la comitete. Ei doar lucrează alături de grup, primind mesaje cât mai repede posibil, până când ajung din urmă liderul și intră în ISR. Nu există blocare și nu este nevoie să-și elimine toate datele.
Încălcarea coeziunii
Kafka are mai multe componente decât RabbitMQ, astfel încât există un set mai complex de comportamente atunci când în cluster se încalcă coeziunea. Dar Kafka a fost proiectată inițial pentru clustere, astfel încât soluțiile sunt foarte bine gândite.
Iată câteva scenarii de încălcare a coeziunii:
- Scenariul 1. Followerul nu vede liderul, dar încă vede Zookeeper.
- Scenariul 2. Liderul nu vede niciun follower, dar încă vede Zookeeper.
- Scenariul 3. Followerul vede liderul, dar nu vede Zookeeper.
- Scenariul 4. Liderul vede followerii, dar nu vede Zookeeper.
- Scenariul 5. Followerul este complet izolat atât de celelalte noduri Kafka, cât și de Zookeeper.
- Scenariul 6. Liderul este complet izolat atât de celelalte noduri Kafka, cât și de Zookeeper.
- Scenariul 7. Nodul controllerului Kafka nu vede alt nod Kafka.
- Scenariul 8. Controllerul Kafka nu vede Zookeeper.
Fiecare scenariu are un comportament specific.
Scenariul 1. Followerul nu vede liderul, dar încă vede Zookeeper
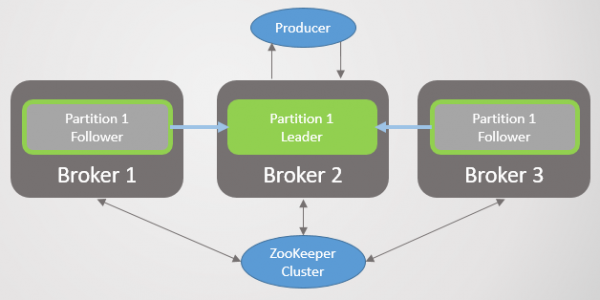
Fig. 22. Scenariul 1. ISR din trei replici
Încălcarea coeziunii izolează brokerul 3 de brokerii 1 și 2, dar nu de Zookeeper. Brokerul 3 nu mai poate trimite cereri de preluare. După o perioadă de timp replica.lag.time.max.ms el este eliminat din ISR și nu participă la angajamentele mesajelor. Odată ce conectivitatea este restabilită, va relua cererile de extracție și se va alătura ISR-ului când ajunge din urmă liderul. Zookeeper va continua să primească ping-uri și va considera că brokerul este viu și sănătos.
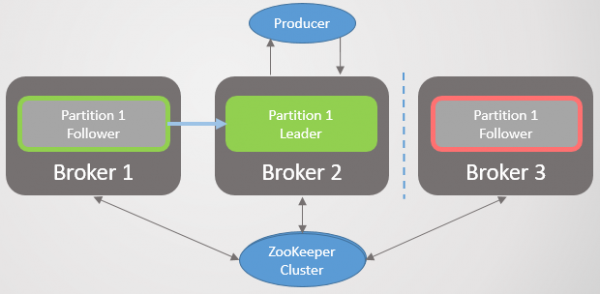
Fig. 23. Scenariul 1. Brokerul este eliminat din ISR dacă nu a primit o cerere de extracție în intervalul replica.lag.time.max.ms
Nu există nicio separare logică (split-brain) sau suspendare a nodului, ca în RabbitMQ. În schimb, redundanța este redusă.
Scenariul 2. Liderul nu vede niciun follower, dar încă vede Zookeeper
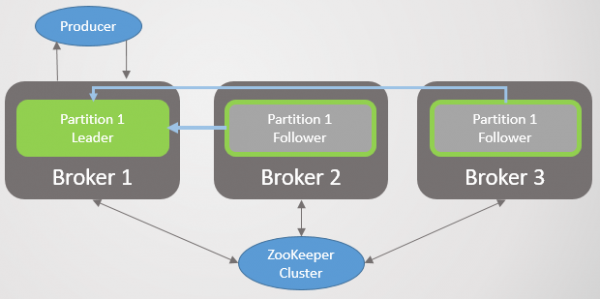
Fig. 24. Scenariul 2. Liderul și doi followers
Încercarea de conectivitate rețea separă liderul de followers, dar brokerul încă îl vede pe Zookeeper. Ca și în primul scenariu, ISR-ul se comprimă, dar de data aceasta doar la lider, deoarece toți followers încetează să trimită cereri de extracție. Din nou, nu există nicio separare logică. În schimb, există o pierdere a redundanței pentru mesajele noi, până când conectivitatea este restabilită. Zookeeper continuă să primească ping-uri și consideră că brokerul este viu și sănătos.
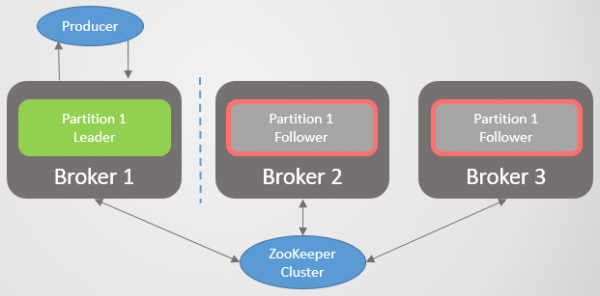
Fig. 25. Scenariul 2. ISR-ul s-a comprimat doar la lider
Scenariul 3. Follower-ul vede liderul, dar nu vede Zookeeper
Follower-ul este separat de Zookeeper, dar nu de brokerul cu liderul. Drept rezultat, follower-ul continuă să facă cereri de extracție și este membru al ISR-ului. Zookeeper nu mai primește ping-uri și înregistrează că brokerul a căzut, dar deoarece este doar un follower, nu există nicio consecință după recuperare.
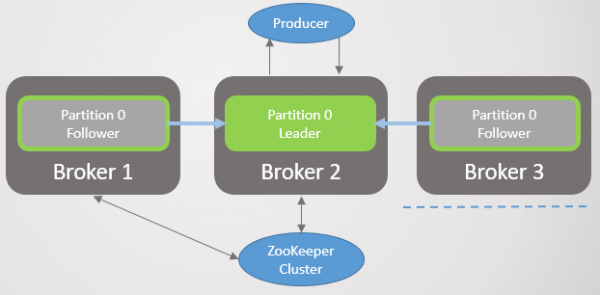
Fig. 26. Scenariul 3. Follower-ul continuă să trimită cereri de extracție liderului
Scenariul 4. Liderul vede followers, dar nu vede Zookeeper
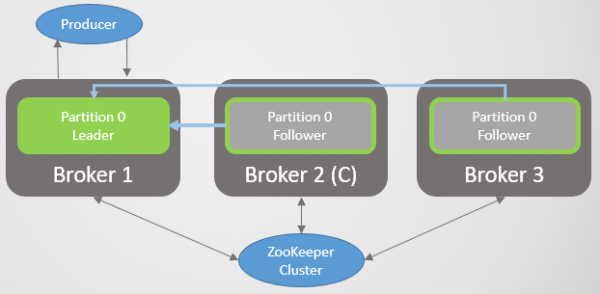
Fig. 27. Scenariul 4. Liderul și doi followers
Liderul este separat de Zookeeper, dar nu de brokerii cu followers.
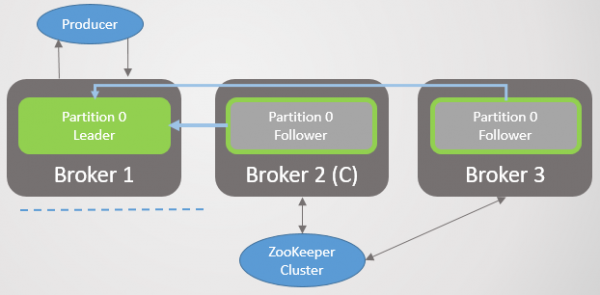
Fig. 28. Scenariul 4. Liderul este izolat de Zookeeper
După un timp, Zookeeper va înregistra că brokerul a căzut și va notifica controllerul. Acesta va alege un nou lider dintre followers. Cu toate acestea, liderul inițial va continua să creadă că este lider și va continua să accepte înregistrări cu acks=1. Followers nu îi mai trimit cereri de extracție, așa că el îi va considera morți și va încerca să comprime ISR-ul până la el însuși. Dar deoarece nu are o conexiune cu Zookeeper, nu va putea să o facă și în acel moment va renunța la primirea ulterioară a înregistrărilor.
Mesaje acks=all nu vor primi confirmări, deoarece ISR include inițial toate replicile, iar mesajele nu ajung la ele. Când liderul inițial va încerca să le elimine din ISR, nu va putea face acest lucru și va înceta complet să primească orice mesaje.
Clienții observă în curând schimbarea liderului și încep să trimită înregistrări pe noul server. Odată ce rețeaua se restabilește, liderul inițial observă că nu mai este lider și își va tăia log-ul la valoarea HW pe care o avea noul lider în momentul prăbușirii, pentru a evita discrepanțele log-urilor. Apoi va începe să trimită cereri de obținere către noul lider. Toate înregistrările liderului inițial, care nu au fost replicate noului lider, se pierd. Asta înseamnă că vor fi pierdute mesajele care nu au fost confirmate de liderul inițial în acele câteva secunde în care au funcționat doi lideri.
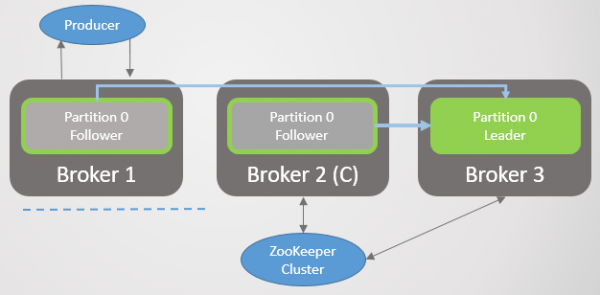
Fig. 29. Scenariul 4. Liderul de pe brokerul 1 devine follower după restabilirea rețelei
Scenariul 5. Followerul este complet izolat atât de celelalte noduri Kafka, cât și de Zookeeper
Followerul este complet izolat atât de celelalte noduri Kafka, cât și de Zookeeper. El este pur și simplu eliminat din ISR până când rețeaua este restabilită, apoi va ajunge din urmă pe ceilalți.

Fig. 30. Scenariul 5. Followerul izolat este eliminat din ISR
Scenariul 6. Liderul este complet izolat atât de celelalte noduri Kafka, cât și de Zookeeper
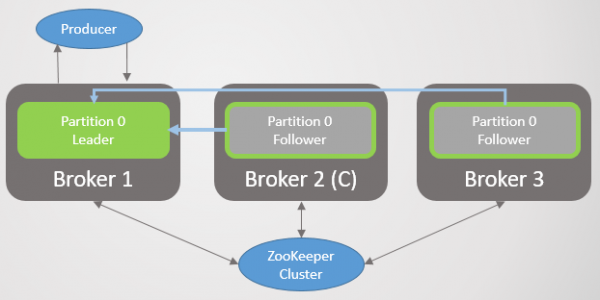
Fig. 31. Scenariul 6. Liderul și doi followers
Liderul este complet izolat de followerii săi, de controler și de Zookeeper. Pe o perioadă scurtă, el va continua să primească înregistrări de la acks=1.
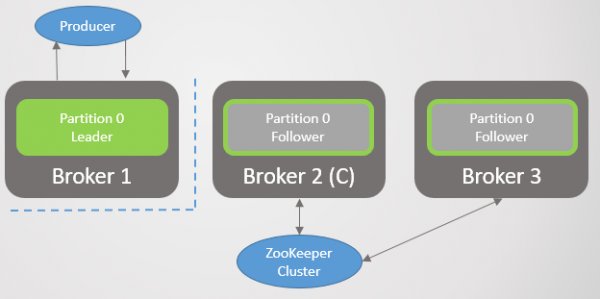
Fig. 32. Scenariul 6. Izolarea liderului de celelalte noduri Kafka și Zookeeper
Neprimind cereri după expirarea replica.lag.time.max.ms, el va încerca să comprime ISR doar la sine, dar nu va putea face acest lucru, deoarece nu există legătură cu Zookeeper, atunci va înceta să primească înregistrări.
Între timp, Zookeeper va marca brokerul izolat ca fiind mort, iar controlerul va alege un nou lider.
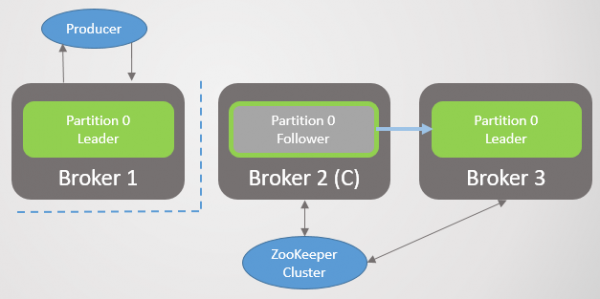
Fig. 33. Scenariul 6. Două lideri
Liderul inițial poate primi înregistrări timp de câteva secunde, dar apoi încetează să primească orice mesaje. Clienții se actualizează la fiecare 60 de secunde cu ultimele metadate. Ei vor fi informați despre schimbarea liderului și vor începe să trimită înregistrări noului lider.
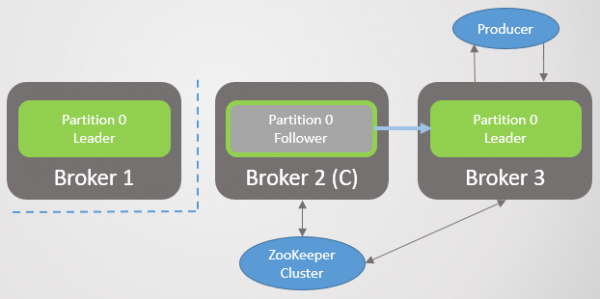
Fig. 34. Scenariul 6. Producerii se schimbă la noul lider
Vor fi pierdute toate înregistrările confirmate efectuate de liderul inițial de la momentul pierderii conectivității. Odată ce rețeaua este restabilită, liderul inițial va descoperi prin Zookeeper că nu mai este lider. Apoi, va tăia jurnalul său până la HW noului lider la momentul alegerii și va începe să trimită cereri ca un follower.
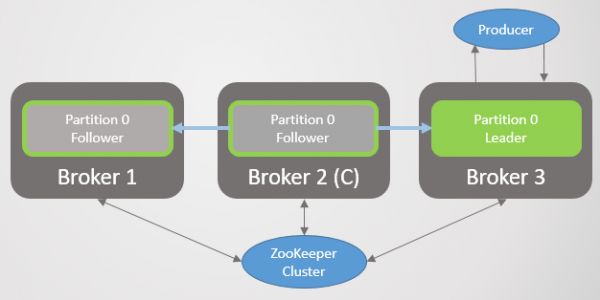
Fig. 35. Scenariul 6. Liderul inițial devine follower după restabilirea conectivității rețelei.
În această situație, pentru o perioadă scurtă poate apărea o separare logică, dar doar dacă. acks=1 și min.insync.replicas de asemenea 1. Separarea logică se încheie automat fie după restabilirea rețelei, când liderul inițial înțelege că nu mai este lider, fie când toți clienții înțeleg că liderul s-a schimbat și încep să scrie noului lider - în funcție de ceea ce se întâmplă mai repede. În orice caz, vor exista pierderi de unele mesaje, dar doar cu. acks=1.
Există o altă variantă a acestui scenariu, când, imediat înainte de separarea rețelei, followerii au rămas în urmă, iar liderul a restrâns ISR la el însuși. Apoi, acesta se izolează din cauza pierderii conectivității. Este ales un nou lider, dar liderul inițial continuă să primească înregistrări, chiar. acks=all, deoarece în ISR nu mai este nimeni în afară de el. Aceste înregistrări vor fi pierdute după restabilirea rețelei. Singura modalitate de a evita această variantă este. min.insync.replicas = 2.
Scenariul 7. Nodul controler Kafka nu vede alte noduri Kafka.
În general, după pierderea conectivității cu nodul Kafka, controlerul nu va putea transmite nici o informație despre schimbarea liderului. În cel mai rău caz, aceasta va duce la o separare logică pe termen scurt, ca în scenariul 6. Cel mai des, brokerul pur și simplu nu va deveni candidatul la liderat în cazul unei defecțiuni a acestuia din urmă.
Scenariul 8. Controlerul Kafka nu vede Zookeeper.
De la controlerul Zookeeper căzut nu va primi ping și va alege ca nou controler un nou nod Kafka. Controlerul inițial poate continua să se prezinte ca atare, dar nu primește notificări de la Zookeeper, deci nu va avea nicio sarcină de îndeplinit. Odată ce rețeaua este restabilită, el va înțelege că nu mai este controler, ci a devenit un nod Kafka obișnuit.
Concluzii din scenarii.
Vedem că pierderea conectivității follower-ilor nu duce la pierderea mesajelor, ci doar reduce temporar redundanța, până când rețeaua se restabilește. Aceasta poate, desigur, duce la pierderea datelor, dacă unul sau mai multe noduri sunt pierdute.
Dacă din cauza pierderii conectivității liderul se deconectează de la Zookeeper, acest lucru poate duce la pierderea mesajelor cu acks=1. Absența conexiunii cu Zookeeper provoacă o separare logică temporară cu doi lideri. Această problemă este rezolvată prin parametrul acks=all.
Parametru min.insync.replicas în două sau mai multe replici oferă garanții suplimentare că astfel de scenarii pe termen scurt nu vor duce la pierderea mesajelor, așa cum se întâmplă în scenariul 6.
Rezumat despre pierderea mesajelor
Să enumerăm toate modurile prin care se pot pierde date în Kafka:
- Orice eșec al liderului, dacă mesajele au fost confirmate prin acks=1
- Orice tranziție necurată a leadership-ului, adică către un follower în afara ISR, chiar și cu acks=all
- Izolarea liderului de Zookeeper, dacă mesajele au fost confirmate prin acks=1
- Izolarea completă a liderului, care deja și-a redus grupul ISR la el însuși. Toate mesajele vor fi pierdute, chiar și acks=all. Acest lucru este adevărat doar în cazul în care min.insync.replicas=1.
- Eșecuri simultane ale tuturor nodurilor din partaj. Deoarece mesajele sunt confirmate din memorie, unele pot să nu fi fost salvate pe disc. După restartarea serverelor, unele mesaje ar putea lipsi.
Tranzițiile necurate ale leadership-ului pot fi evitate fie prin interzicerea lor, fie prin asigurarea redundanței de cel puțin două. Cea mai robustă configurație este o combinație de acks=all și min.insync.replicas mai mult de 1.
Compararea directă a fiabilității RabbitMQ și Kafka
Pentru a asigura fiabilitatea și disponibilitatea ridicată, ambele platforme implementează un sistem de replicare principală și secundară. Cu toate acestea, RabbitMQ are un punct slab. Atunci când se reconectează după un eșec, nodurile abandonează datele lor, iar sincronizarea este blocată. Această dublă lovitură ridică semne de întrebare asupra durabilității cozii mari în RabbitMQ. Va trebui să te acomodezi fie cu reducerea redundanței, fie cu blocări prelungite. Reducerea redundanței crește riscul de pierdere masivă a datelor. Dar dacă cozile sunt mici, pentru a asigura redundanța cu perioade scurte de indisponibilitate (câteva secunde), pot fi gestionate prin încercări repetate de conectare.
În Kafka nu există această problemă. Ea abandonează datele doar la punctul de divergență între lider și follower. Toate datele comune sunt păstrate. În plus, replicarea nu blochează sistemul. Liderul continuă să primească înregistrări în timp ce un nou follower îl ajunge din urmă, astfel încât pentru devops, alăturarea sau reunirea cluster-ului devine o sarcină trivială. Desigur, rămân în continuare probleme, cum ar fi lățimea de bandă a rețelei în timpul replicării. Dacă mai mulți followers sunt adăugați simultan, se poate ajunge la limita lățimii de bandă.
RabbitMQ depășește Kafka în ceea ce privește fiabilitatea în cazul în care mai multe servere din cluster se defectează simultan. Așa cum am menționat, RabbitMQ trimite o confirmare publisher-ului doar după ce mesajul este scris pe disc la master și toate oglinzile. Dar aceasta adaugă o întârziere suplimentară din două motive:
- fsync la fiecare câteva sute de milisecunde
- Defectarea unei oglinzi poate fi observată doar după expirarea timpului de viață al pachetelor care verifică disponibilitatea fiecărui nod (net tick). Dacă oglinda se blochează sau cade, aceasta adaugă întârziere.
Kafka mizează pe faptul că dacă un mesaj este stocat pe mai multe noduri, poate confirma mesajele imediat ce ajung în memorie. Din cauza aceasta, există riscul pierderii mesajelor de orice tip (chiar acks=all, min.insync.replica=2) în cazul unei defecțiuni simultane.
În general, Kafka demonstrează o performanță mai bună și este proiectată inițial pentru clustere. Numărul de followers poate fi crescut până la 11, dacă este necesar pentru fiabilitate. Rata de replicare de 5 și numărul minim de replici în stare sincronizată min.insync.replicas=3 vor face ca pierderea mesajului să fie un eveniment foarte rar. Dacă infrastructura ta poate oferi această rată de replicare și un nivel de redundanță, atunci poți alege această opțiune.
Clusterea RabbitMQ este bună pentru cozi mici. Dar chiar și cozi mici pot crește rapid la un trafic mare. Odată ce cozile devin mari, va trebui să faci o alegere dificilă între disponibilitate și fiabilitate. Clusterea RabbitMQ este cel mai bine adaptată pentru situații mai puțin obișnuite, unde avantajele flexibilității RabbitMQ depășesc orice dezavantaje ale clusterei sale.
Una dintre soluțiile pentru vulnerabilitatea RabbitMQ legată de cozi mari este divizarea acestora în mai multe cozi mai mici. Dacă nu este necesar să se mențină o ordonare completă a întregii cozi, ci doar a mesajelor corespunzătoare (de exemplu, mesajele unui anumit client), sau chiar să nu se ordoneze nimic, această opțiune este acceptabilă: aruncați o privire asupra proiectului meu pentru divizarea cozii (proiectul este încă în stadiu incipient).
În cele din urmă, nu uitați de o serie de erori în mecanismele de clustering și replicare atât în RabbitMQ, cât și în Kafka. În timp, sistemele au devenit mai mature și stabile, dar niciun mesaj nu va fi niciodată 100% protejat împotriva pierderii! În plus, accidentele pe scară largă se petrec în centrele de date!
Dacă am omis ceva, am comis o eroare sau nu sunteți de acord cu oricare dintre afirmații, nu ezitați să lăsați un comentariu sau să mă contactați.
Adesea, mi se pune întrebarea: „Ce să aleg, Kafka sau RabbitMQ?”, „Care platformă este mai bună?”. Adevărul este că depinde cu adevărat de situația dumneavoastră, experiența actuală etc. Nu îndrăznesc să îmi exprim opinia, deoarece ar fi o simplificare prea mare să recomand o anumită platformă pentru toate utilizările posibile și restricțiile respective. Am scris acest ciclu de articole pentru a vă ajuta să vă formați propria opinie.
Vreau să spun că ambele sisteme sunt lideri în acest domeniu. Poate că sunt puțin părtinitor, deoarece din experiența proiectelor mele, prețuiesc mai mult lucruri precum ordonarea garantată a mesajelor și fiabilitatea.
Văd alte tehnologii care nu dispun de această fiabilitate și de ordonare garantată, apoi mă uit la RabbitMQ și Kafka — și înțeleg valoarea incredibilă a ambelor aceste sisteme.
Sursa: habr.com
