

Nota traducătorului.: Autorul acestui material este Cindy Sridharan, inginer la imgix, o companie care se ocupă de dezvoltarea API-urilor și, în special, de testarea microserviciilor. În acest material, ea își împărtășește viziunea detaliată asupra problemelor actuale în domeniul trasării distribuite, unde, în opinia sa, există o lipsă de instrumente cu adevărat eficiente pentru a aborda sarcinile urgente.
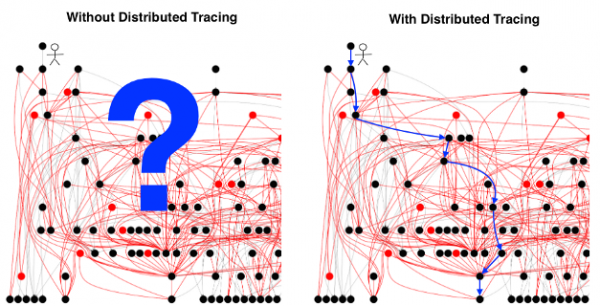
[Ilustrația este preluată din despre trasarea distribuită.]
Se consideră că este dificil de implementat, iar beneficiul său . „Problema” trasării este explicată printr-o mulțime de motive, adesea referindu-se la dificultatea de configurare a fiecărui component al sistemului pentru a transmite anteturile corespunzătoare împreună cu fiecare solicitare. Deși această problemă există cu adevărat, nu poate fi numită deloc insurmontabilă. Apropo, nu explică de ce dezvoltatorii nu sunt foarte încântați de trasare (chiar și de cea deja existentă).
Principalul lucru dificil cu trasarea distribuită nu este colectarea datelor, nici standardizarea formatelor de distribuție și prezentare a rezultatelor și nici determinarea momentului, locului și modului în care trebuie realizată eșantionarea. Nu încerc deloc să fac trivial aceste „probleme de utilizare” — de fapt, există provocări tehnice și (dacă analizăm cu adevărat standardele și protocoalele Open Source) politice destul de semnificative care trebuie depășite pentru ca aceste probleme să poată fi considerate rezolvate. experienței utilizatorului final
. Trasarea poate să nu aducă în continuare beneficii practice în cele mai frecvente scenarii de depanare — chiar și după ce a fost implementată. O astfel de trasare diferităTrasarea distribuită implică mai multe componente disparate:
echiparea aplicațiilor și middleware-ului cu instrumente de monitorizare;
transmiterea contextului distribuit;
- colectarea trasărilor;
- stocarea trasărilor;
- extracția și vizualizarea acestora.
- stocare a traselor;
- extracția și vizualizarea acestora.
Multe discuții despre trasarea distribuită se reduc la a o considera ca o operație unică, al cărei singur scop este de a ajuta în diagnosticarea completă a sistemului. În mare parte, acest lucru se datorează modului în care reprezentările despre trasarea distribuită s-au format istoric. În , s-a menționat, când au fost deschise sursele Zipkin, că el [Zipkin] face Twitter mai rapid. Primele oferte comerciale pentru trasare au fost, de asemenea, promovate ca .
Nota traducătorului.: Pentru ca textul ulterior să fie perceput mai bine, să definim două termeni de bază conform :
- Span — un element de bază al trasării distribuite. Reprezintă o descriere a unui anumit flux de lucru (de exemplu, o interogare la baza de date) cu un nume, ora de început și sfârșit, etichete, jurnaluri și context.
- Span-urile conțin de obicei referințe la alte span-uri, ceea ce permite combinarea mai multor span-uri în Trace — o vizualizare a vieții unei interogări pe parcursul deplasării sale printr-un sistem distribuit.
Trace-urile conțin date incredibil de valoroase, capabile să ajute în sarcini precum: testarea în producție, efectuarea testelor de recuperare în caz de defecțiune, testarea cu introducerea de erori etc. De fapt, unele companii folosesc deja trasarea pentru astfel de scopuri. Să începem cu faptul că are și alte aplicări în afară de simpla transferare a span-urilor în sistemul de stocare:
- De exemplu, Uber rezultatele trasării pentru a delimita traficul de testare de traficul de producție.
- Facebook datele trace-urilor pentru analiza căii critice și pentru comutarea traficului în timpul testelor regulate de recuperare în caz de defecțiune.
- De asemenea, rețeaua socială notebook-urile Jupyter, care permit dezvoltatorilor să efectueze interogări aleatoare asupra rezultatelor trasării.
- Susținătorii (Lineage Driven Failure Injection) trasările distribuite pentru testarea cu introducerea de erori.
Niciuna dintre opțiunile menționate mai sus nu se referă în întregime la scenariul de debugging, în care inginerul încearcă să rezolve problema, uitându-se la trace.
Când vine într-adevăr vorba de scenariul de debugging, interfața principală rămâne diagrama traceview (deși unii o numesc și „diagrama Gantt” sau „diagrama în cascadă”). Prin traceview eu toate span-urile și metadatele aferente, care împreună formează trace. Fiecare sistem de trasare cu sursă deschisă, precum și fiecare soluție comercială pentru trasare oferă un bazat pe traceview interfața utilizatorului pentru vizualizarea, detalierea și filtrarea trace-urilor.
Problema cu toate sistemele de trasare cu care am avut de-a face până acum este că, în cele din urmă, vizualizarea (traceview) reflectă aproape complet specificitățile procesului de generare a trace-ului. Chiar și atunci când sunt oferite vizualizări alternative: hărțile intensității (heatmap), topologiile serviciilor, histogramele întârzierilor (latency) — în cele din urmă, toate se reduc la traceview.
În trecut, am cu privire la faptul că majoritatea "inovațiilor" în domeniul trasării în ceea ce privește UI/UX par să se limiteze la metadate suplimentare în trace, încorporând informații de înaltă cardinalitate (high-cardinality) sau oferind posibilitatea de a detalia anumite span-uri sau de a efectua interogări între și în cadrul trace-urilor. Trebuie menționat că traceview rămâne principalul instrument de vizualizare. Atâta timp cât această situație va persista, trasarea distribuită va ocupa (cel mult) locul 4 ca instrument de depanare, după metrici, jurnale și stack trace-uri, iar în cel mai rău caz — se va dovedi a fi o pierdere de bani și timp.
Problema cu traceview
Scop traceview este de a oferi o imagine completă a mișcării unei cereri individuale prin toate componentele sistemului distribuit cu care este asociată. Unele sisteme de trasare mai avansate permit detalierea unor span-uri și vizualizarea detaliată pe timp inside a unui proces (când span-urile au limite funcționale).
O premisă de bază a arhitecturii microserviciilor este ideea că structura organizațională crește împreună cu nevoile companiei. Susținătorii microserviciilor afirmă că distribuirea diferitelor sarcini de afaceri în servicii separate permite echipelor mici și autonome de dezvoltatori să controleze întregul ciclu de viață al acestor servicii, oferindu-le posibilitatea de a crea, a testa și a desfășura aceste servicii în mod independent. Totuși, un dezavantaj al unei astfel de distribuții este pierderea informațiilor despre modul în care fiecare serviciu interacționează cu celelalte. În astfel de condiții, urmărirea distribuită aspiră să devină un instrument esențial pentru de debugging interacțiunile complexe între servicii.
Dacă aveți cu adevărat , atunci nimeni nu este capabil să rețină în minte imaginea completă. De fapt, dezvoltarea unui instrument bazat pe presupunerea că acest lucru este posibil este un fel de antipattern (o abordare ineficientă și neproductivă). Ideal, pentru depanare, este necesar un instrument care să ajute la restrângerea domeniului de căutare, astfel încât inginerii să se poată concentra pe un subset de măsurători (servicii/utilizatori/găzduiri etc.) relevante pentru scenariul problemei discutate. Atunci când se determină cauza eșecului, inginerii nu ar trebui să se ocupe de ceea ce se întâmpla în toate serviciile în același timp, deoarece o astfel de cerință ar contrazice însăși ideea arhitecturii microservicilor.
Cu toate acestea, traceview reprezintă anume asta. Da, unele sisteme de urmărire oferă traceview comprimate, atunci când numărul de spanuri în trace este atât de mare, încât nu poate fi afișat într-o singură vizualizare. Totuși, din cauza volumului mare de informații conținute chiar și în această vizualizare restrânsă, inginerii trebuie în continuare să «curețe» aceste informații, restrângând manual selecția la un set de servicii sursă ale problemelor. Din păcate, în acest domeniu, mașinile sunt mult mai rapide decât oamenii, mai puțin predispose la greșeli, iar rezultatele lor sunt mai repetabile. O altă rațiune pentru care consider metoda traceview greșită este că nu se potrivește bine pentru depanarea bazată pe ipoteze. În esența sa, depanarea este
Î încă o rațiune pentru care consider metoda traceview incorectă este că nu se potrivește bine pentru debugging-ul bazat pe ipoteze. La baza sa, debugging-ul este iterativ un proces care începe cu o ipoteză, urmată de verificarea diferitelor observații și fapte obținute din sistem pe diferite vectore, concluzii/sumarizări și o evaluare ulterioară a veridicității ipotezei.
Posibilitatea rapid și ieftin testarea ipotezelor și îmbunătățirea corespunzătoare a modelului mental este piatra de temelie a depanării. Orice instrument de depanare trebuie să fie interactiv și să strângă spațiul de căutare sau, în cazul unei piste false, să permită utilizatorului să revină și să se concentreze pe o altă zonă a sistemului. Instrumentul ideal va face acest lucru în mod proactiv, atrăgând imediat atenția utilizatorului asupra zonelor potențial problematice.
Din păcate, traceview nu se poate numi un instrument cu interfață interactivă. Cel mai bun lucru pe care îl putem spera în utilizarea sa este să identificăm o sursă de întârzieri sporite și să examinăm toate etichetele și log-urile asociate. Acest lucru nu ajută inginerul să identifice modelele în trafic, cum ar fi specificul distribuirii întârzierilor, sau să descopere corelații între diferitele măsurători. poate ajuta la ocolirea unor astfel de probleme. De fapt, de analiză de succes utilizând învățarea automată pentru a identifica span-uri anormale și pentru a identifica un subset de etichete care ar putea fi asociate cu un comportament anormal. Cu toate acestea, până acum nu am întâlnit vizualizări convingătoare ale descoperirilor realizate prin învățarea automată sau analiza datelor aplicate la span-uri, care să se abată semnificativ de la traceview sau DAG (graf orientat aciclic).
Span-urile sunt prea joase
Problema fundamentală cu traceview este că span-urile sunt primitive prea joase atât pentru analiza întârzierilor (latency), cât și pentru analiza cauzelor de bază. Este ca și cum am analiza comenzi individuale ale procesorului într-o încercare de a remedia o excepție, știind că există instrumente de nivel mai înalt, precum backtrace, care sunt mult mai convenabile.
În plus, îmi voi permite să afirm următoarele: în ideal, nu avem nevoie deloc de o imagine completă ceea ce s-a întâmplat în timpul ciclului de viață al unei cereri, pe care o prezintă instrumentele moderne pentru urmărire. În loc de asta, este necesară o formă de abstracție de nivel mai înalt, care să conțină informații despre ce a mers prost (analog cu backtrace), împreună cu un anumit context. În loc să observ întreaga urmărire, prefer să văd o parte, unde se întâmplă ceva interesant sau neobișnuit. În prezent, căutarea se face manual: inginerul primește urmărirea și analizează singur span-urile în căutarea a ceva interesant. Abordarea, în care oamenii se uită la span-uri în urmăriri separate, sperând să descopere activități suspecte, nu se scalează deloc (mai ales când trebuie să interpreteze toate metadatele codificate în diferitele span-uri, cum ar fi ID-ul span-ului, numele metodei RPC, durata span-ului, jurnalele, etichetele etc.).
Alternativele traceview
Rezultatele urmării sunt cele mai utile atunci când pot fi vizualizate într-un mod care să ofere o imagine semnificativă despre ceea ce se întâmplă în părțile interconectate ale sistemului. Până când acest lucru nu există, procesul de depanare rămâne în mare parte inerțial și depinde de abilitățile utilizatorului de a observa corelații corecte, de a verifica părțile corecte ale sistemului sau de a aduna bucăți de puzzle laolaltă — spre deosebire de instrumentul, care ajută utilizatorul să formuleze aceste ipoteze.
Nu sunt designer vizual și nu sunt specialist în UX, totuși în secțiunea următoare vreau să împărtășesc câteva idei despre cum ar putea arăta astfel de vizualizări.
Focalizare pe servicii specifice
În condițiile în care industria se consolidează în jurul ideilor , pare rezonabil ca echipele individuale să urmărească, în principal, conformitatea serviciilor lor cu aceste obiective. Din aceasta rezultă că vizualizarea orientată pe servicii este cel mai bine potrivită pentru astfel de echipe.
Urmăriri, în special fără eșantionare, sunt o comoară de informații despre fiecare componentă a unui sistem distribuit. Aceste informații pot fi furnizate unei procesoare inteligente, care va oferi utilizatorilor descoperiri orientate pe servicii. Acestea pot fi identificate din timp — înainte ca utilizatorul să se uite la urmăriri: descoperiri. Acestea pot fi identificate din timp - chiar înainte ca utilizatorul să se uite la trace-uri:
- Diagramă a distribuției întârzierilor doar pentru cereri în afara mediului obişnuit (cereri atypice);
- Diagramă a distribuției întârzierilor în cazurile în care obiectivele SLO ale serviciului nu sunt atinse;
- Cele mai „frequent”, „interesante” și „neobișnuite” etichete din cereri, care apar cel mai des se repetă;
- Spargerea întârzierilor pentru cazurile în care dependențele serviciului nu ating SLO-urile stabilite;
- Spargerea întârzierilor pe diferite servicii downstream.
La unele dintre aceste întrebări, metricile încorporate pur și simplu nu pot oferi răspunsuri, obligând utilizatorii să examineze cu atenție span-urile. În cele din urmă, avem un mecanism extrem de neprietenos pentru utilizator.
În acest context, apare întrebarea: ce se întâmplă cu interacțiunile complexe între diverse servicii, gestionate de echipe diferite? Nu este traceview cel mai potrivit instrument pentru a ilustra o astfel de situație?
Dezvoltatorii de mobil, proprietarii serviciilor stateless, proprietarii serviciilor stateful gestionate (precum bazele de date) și proprietarii platformelor ar putea fi interesați de o altă reprezentare a sistemului distribuit; traceview — aceasta este o soluție prea generală pentru aceste nevoi fundamentale diferite. Chiar și într-o arhitectură microservicii complexă, proprietarii de serviciu nu au nevoie de cunoștințe profunde despre mai mult de două-trei servicii upstream și downstream. În esență, în cele mai multe scenarii, utilizatorii trebuie să răspundă la întrebări legate de un set limitat de servicii.
Este similar cu examinarea unei mici submulțimi de servicii printr-un microscop pentru a fi studiate cu rigurozitate. Acest lucru va permite utilizatorului să pună întrebări mai pertinente legate de interacțiunile complexe dintre aceste servicii și dependențele lor imediate. Este similar cu un backtrace în lumea serviciilor, unde un inginer știe utilizatorul (sau atacatorul) încearcă să facă, ci și nu doar asta, ci are și o idee despre ceea ce se întâmplă în serviciile învecinate, pentru a înțelege, de ce.
Abordarea pe care o promovez este complet opusă abordării „de sus în jos”, bazată pe traceview, atunci când analiza începe cu întregul trace și apoi coboară treptat la span-uri individuale. În schimb, abordarea „de jos în sus” începe cu analiza unei mici sectiuni, apropiate de cauza potențială a incidentului, iar apoi aria de căutare se extinde după cum este necesar (posibil implicând alte echipe pentru a analiza o gamă mai largă de servicii). A doua abordare este mai bine echipată pentru a verifica rapid ipotezele inițiale. După obținerea unor rezultate concrete, se poate trece la o analiză mai focalizată și detaliată.
Construirea topologiei
Vederile legate de un serviciu specific pot fi incredibil de utile dacă utilizatorul știe ce serviciu sau grup de servicii este responsabil pentru creșterea întârziilor sau este sursa erorilor. Totuși, într-un sistem complex, identificarea serviciului infractor poate fi o sarcină netrivială în timpul unei defecțiuni, mai ales dacă mesajele de eroare de la servicii nu au fost primite.
Construirea topologiei serviciilor poate ajuta enorm la determinarea care serviciu demonstrează o creștere a frecvenței erorilor sau o întârziere crescută, ducând la o deteriorare semnificativă a performanței serviciului. Când vorbesc despre construirea topologiei, mă refer nu la un harta serviciilor, care afișează fiecare serviciu existent în sistem și este cunoscută pentru . O astfel de reprezentare nu este mai bună decât traceview bazat pe un graf direcționat aciclic. În schimb, aș dori să văd o topologie de servicii generată dinamic, bazată pe anumite atribute, cum ar fi frecvența erorilor, timpul de răspuns sau pe orice parametru specificat de utilizator, care ajută la clarificarea situației cu privire la anumite servicii suspecte.
Să luăm un exemplu. Să ne imaginăm un anumit site de știri ipotetic. Serviciul paginii principale (front page) comunică date cu Redis, cu serviciul de recomandări, cu serviciul de publicitate și cu serviciul video. Serviciul video preia videoclipurile din S3, iar datele metadata din DynamoDB. Serviciul de recomandări primește datele metadata din DynamoDB, încarcă date din Redis și MySQL, trimite mesaje în Kafka. Serviciul de publicitate primește date din MySQL și trimite mesaje în Kafka.
Mai jos este prezentată o imagine schematică a acestei topologii (topologia este construită de multe programe comerciale de urmărire). Aceasta poate fi utilă dacă trebuie să înțelegeți dependențele serviciilor. Cu toate acestea, în timpul de debugging, când un anumit serviciu (să zicem, serviciul video) arată un timp de răspuns crescut, o astfel de topologie nu este foarte utilă.
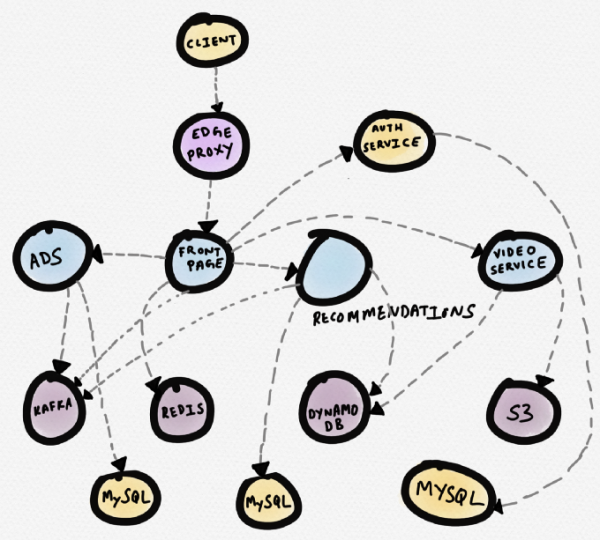
Schema serviciilor unui site de știri ipotetic
O diagramă ar fi fost mai potrivită, așa cum este ilustrat mai jos. Pe aceasta, serviciul problematic (video) este reprezentat chiar în centrul imaginii. Utilizatorul îl observă imediat. Din această vizualizare se înțelege că serviciul video funcționează anormal din cauza creșterii timpului de răspuns S3, ceea ce afectează viteza de încărcare a unei părți din pagina principală.
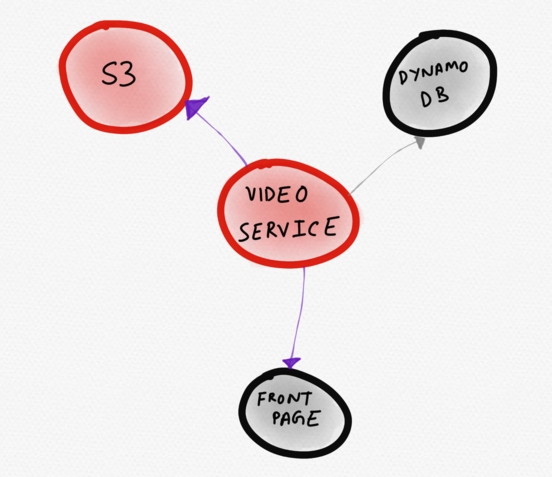
Topologia dinamică, care afișează doar serviciile „interesante”
Schema topologică generată dinamic poate fi mai eficientă decât hărțile statice ale serviciilor, mai ales în infrastructuri elestice și auto-scalabile. Capacitatea de a compara și corela topologiile serviciilor permite utilizatorului să pună întrebări mai relevante. Întrebările mai precise despre sistem duc cu mai multă probabilitate la o mai bună înțelegere a modului în care funcționează sistemul.
Afisaj comparativ
O altă vizualizare utilă va fi afișajul comparativ. În prezent, trasările nu sunt foarte bune pentru comparații unul lângă altul, așa că de obicei se compară span-urile. Iar ideea principală a acestui articol este că span-urile sunt prea la un nivel scăzut pentru a extrage cele mai valoroase informații din rezultatele trasării.
Comparația a două trasări nu necesită vizualizări fundamental noi. De fapt, este suficient ceva similar cu un histogramă, care reprezintă aceeași informație ca și traceview. Este surprinzător, dar chiar și această metodă simplă poate aduce mult mai multe beneficii decât examinarea celor două trasări în mod separat. O posibilitate și mai puternică ar fi vizualiza compararea trace-urilor în ansamblu. Ar fi extrem de util să vedem cum o configurație de bază a datelor recent implementată, cu activarea GC (garbage collection), afectează timpul de răspuns al serviciului downstream pe o perioadă de câteva ore. Dacă ceea ce descriu aici pare similar cu o analiză A/B privind impactul schimbărilor infrastructurale în mai multe servicii folosind rezultatele de trasare, atunci nu ești foarte departe de adevăr.
Concluzie
Nu contest utilitatea trasării în sine. Cred cu sinceritate că nu există altă metodă de a colecta date atât de bogate, casuale și contextuale, cum sunt cele din trace. Cu toate acestea, consider de asemenea că toate soluțiile de trasare folosesc aceste date extrem de ineficient. Atât timp cât instrumentele de trasare vor fi limitate la reprezentările traceview, vor fi restricționate în capacitatea de a folosi la maxim informația valoroasă ce poate fi extrasă din datele conținute în trace-uri. În plus, există riscul dezvoltării unui interfață vizuală complet neprietenoasă și neintuitivă, care va limita grav capacitatea utilizatorului de a depana aplicația.
Depanarea sistemelor complexe, chiar și cu utilizarea celor mai noi instrumente, este incredibil de complicată. Instrumentele trebuie să ajute dezvoltatorul să formuleze și să testeze o ipoteză, oferind activ informații relevante, identificând anomalii și observând caracteristicile în distribuția întârzierilor. Pentru ca trasarea să devină instrumentul preferat al dezvoltatorilor în depana erorile în producție sau în soluționarea problemelor care vizează diferite servicii, sunt necesare interfețe și vizualizări inovatoare, care să fie mai bine aliniate cu modelul mental al dezvoltatorilor care creează și operează aceste servicii.
Vor fi necesare eforturi mentale semnificative pentru a proiecta un sistem care va reprezenta diferite semnale disponibile în rezultatele urmăririi, într-un mod optimizat pentru a facilita analiza și concluziile. Este necesar să ne gândim la cum să abstractizăm topologia sistemului în timpul depanării, astfel încât să ajutăm utilizatorul să depășească zonele oarbe, fără a privi în urmă sau în spanuri separate.
Avem nevoie de bune capacități de abstractizare și de stratificare (în special în UI). Acestea ar trebui să se integreze bine în procesul de depanare bazat pe ipoteze, unde se pot pune întrebări și verifica ipotezele în mod iterativ. Ele nu vor rezolva automat toate problemele de observabilitate, dar vor ajuta utilizatorii să-și rafineze intuiția și să formuleze întrebări mai bine gândite. Fac apel la un abordare mai atentă și inovatoare în domeniul vizualizării. Aici există o reală oportunitate de a extinde orizonturile.
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
