

Teorema CAP este piatra de temelie a teoriei sistemelor distribuite. Desigur, controversele din jurul său nu se sting: definițiile nu sunt canonice și nu există o dovadă strictă… Totuși, bazându-ne pe bunul simț, înțelegem că teorema este adevărată.
Singurul lucru care nu este evident este semnificația literei „P”. Când un cluster se separă, decide dacă să nu răspundă până când nu se atinge un quor, sau să ofere datele pe care le are. În funcție de rezultatele acestei alegeri, sistemul este clasificat fie ca CP, fie ca AP. Cassandra, de exemplu, poate funcționa atât în mod CP, cât și în mod AP, în funcție nu doar de setările cluster-ului, ci și de parametrii fiecărei cereri în parte. Dar dacă sistemul nu este „P” și s-a separat, atunci – ce se întâmplă?
Răspunsul la această întrebare este oarecum surprinzător: un cluster CA nu se poate separa.
Ce fel de cluster este acesta, care nu se poate separa?
Un atribut esențial al unui astfel de cluster este un sistem comun de stocare a datelor. În cea mai mare parte a cazurilor, aceasta înseamnă conectarea prin SAN, ceea ce limitează aplicațiile soluțiilor CA la mari întreprinderi capabile să mențină o infrastructură SAN. Pentru ca mai multe servere să poată lucra cu aceleași date, este necesară o sistem de fișiere clusterizat. Astfel de sisteme de fișiere sunt disponibile în portofoliile HPE (CFS), Veritas (VxCFS) și IBM (GPFS).
Oracle RAC
Opțiunea Real Application Cluster a fost introdusă pentru prima dată în 2001 în versiunea Oracle 9i. Într-un astfel de cluster, mai multe instanțe server lucrează cu aceeași bază de date.
Oracle poate funcționa atât cu un sistem de fișiere clusterizat, cât și cu propria soluție – ASM, Automatic Storage Management.
Fiecare instanță își ține jurnalul. O tranzacție este executată și înregistrată de o singură instanță. În caz de eșec al unei instanțe, unul dintre nodurile supraviețuitoare ale cluster-ului (instanțelor) citește jurnalul său și recuperează datele pierdute – astfel se asigură disponibilitatea.
Toate instanțele își mențin propriul cache, iar aceleași pagini (blocuri) pot fi prezente simultan în cache-urile mai multor instanțe. Mai mult, dacă o pagină este necesară unei instanțe și aceasta există în cache-ul altei instanțe, ea o poate obține de la „vecin” prin intermediul mecanismului de fusionare a cache-ului în loc să o citească de pe disc.
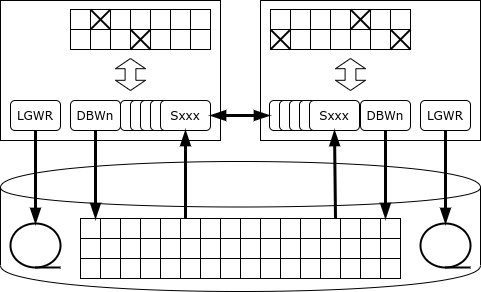
Dar ce se întâmplă dacă unul dintre instanțe are nevoie să modifice datele?
Particularitatea Oracle este că nu are un serviciu dedicat de blocare: dacă serverul dorește să blocheze un rând, înregistrarea blocării este pusă direct pe pagina de memorie unde se află rândul blocat. Datorită acestei abordări, Oracle este campion în performanță printre bazele de date monolitice: serviciul de blocare nu devine niciodată un punct de îngustare. Însă, în configurațiile de cluster, o astfel de arhitectură poate duce la schimburi intensificate de rețea și blocări reciproc.
Odată ce înregistrarea este blocată, instanța notifică toate celelalte instanțe că pagina în care este stocată această înregistrare este ocupată în mod monopol. Dacă unei alte instanțe îi va trebuie să modifice înregistrarea de pe aceeași pagină, aceasta trebuie să aștepte până când modificările de pe pagină sunt confirmate, adică informația despre modificare nu a fost încă scrisă în jurnal pe disc (în acest timp, tranzacția poate continua). Poate apărea și situația în care pagina este modificată consecutiv de mai multe instanțe, iar atunci, când pagina este scrisă pe disc, va trebui să se determine cine deține versiunea actuală a acelei pagini.
Actualizările accidentale ale acelorași pagini prin diferite noduri RAC conduc la o scădere drastică a performanței bazei de date - până la punctul în care performanța clusterului poate fi mai mică decât cea a unei singure instanțe.
Utilizarea corectă a Oracle RAC presupune divizarea fizică a datelor (de exemplu, prin mecanismul tabelelor secționate) și accesarea fiecărui set de secțiuni printr-un nod dedicat. Principala destinație a RAC nu a devenit scalarea orizontală, ci asigurarea rezilienței la erori.
Dacă un nod nu mai răspunde la heartbeat, atunci nodul care a descoperit acest lucru prima dată initiază o procedură de votare pe disc. Dacă și aici nodul pierdut nu se înregistrează, unul dintre noduri își asumă responsabilitățile de recuperare a datelor:
- «îngheață» toate paginile care erau în cache-ul nodului pierdut;
- citește jurnalele (redo) ale nodului pierdut și aplică din nou modificările înregistrate în aceste jurnale, verificând în același timp dacă alte noduri au versiuni mai recente ale paginilor modificate;
- revine tranzacțiile nefinalizate.
Pentru a simplifica comutarea între noduri, Oracle are conceptul de serviciu – un exemplu virtual. Un exemplu poate deservi mai multe servicii, iar un serviciu poate migra între noduri. Exemplul aplicației, care deservește o anumită parte a bazei de date (de exemplu, un grup de clienți), lucrează cu un singur serviciu, iar serviciul responsabil pentru această parte a bazei de date migrează pe un alt nod în cazul în care un nod eșuează.
IBM Pure Data Systems for Transactions
Solutia de cluster pentru SGBD a apărut în portofoliul Gigantului Albastru în 2009. Ideologic, este urmașul clusterului Parallel Sysplex, construit pe echipamente „obișnuite”. În 2009 a fost lansat produsul DB2 pureScale, care reprezintă un pachet software, iar în 2012 IBM oferă un pachet software și hardware (appliance) denumit Pure Data Systems for Transactions. Nu trebuie confundat cu Pure Data Systems for Analytics, care nu este altceva decât un Netezza redenumit.
Arhitectura pureScale pare la prima vedere similară cu Oracle RAC: astfel, mai multe noduri sunt conectate la un sistem comun de stocare a datelor, și pe fiecare nod lucrează propria instanță SGBD cu propriile sale zone de memorie și jurnale de tranzacții. Dar, spre deosebire de Oracle, în DB2 există un serviciu dedicat de blocare, reprezentat de un set de procese db2LLM*. În configurația clusterului, acest serviciu este transferat pe un nod separat, care în Parallel Sysplex se numește coupling facility (CF), iar în Pure Data – PowerHA.
PowerHA oferă următoarele servicii:
- manager de blocări;
- cache global de buffer;
- domeniu de comunicații interproces.
Pentru a transfera date de la PowerHA la nodurile Bazei de Date și înapoi, se utilizează accesul la memorie de la distanță, astfel încât interconectarea clusterului trebuie să suporte protocolul RDMA. PureScale poate utiliza atât Infiniband, cât și RDMA peste Ethernet.
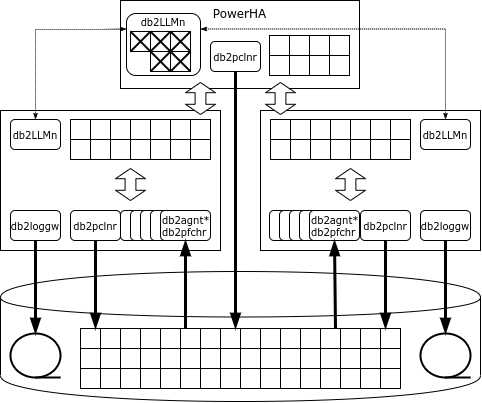
Dacă nodul are nevoie de o pagină, iar acea pagină nu se află în cache, nodul solicită pagina din cache-ul global, și doar în acel caz, dacă nici acolo nu este, o citește de pe disc. Spre deosebire de Oracle, cererea se face doar în PowerHA, nu și la nodurile adiacente.
Dacă un nod intenționează să modifice o linie, acesta o blochează în modul exclusiv, iar pagina unde se află linia – în mod partajat. Toate blocările sunt înregistrate în managerul global de blocări. Când tranzacția se finalizează, nodul trimite un mesaj managerului de blocări, care copiază pagina modificată în cache-ul global, elimină blocările și invalidează pagina modificată în cache-urile altor noduri.
Dacă pagina pe care se află linia modificabilă este deja blocată, managerul de blocări va citi pagina modificată din memoria nodului care a efectuat modificările, va elimina blocarea, va invalida pagina modificată în cache-urile altor noduri și va restitui blocarea paginii nodului care a solicitat-o.
"Pagini murdare", adică modificate, pot fi scrise pe disc atât de la un nod obișnuit, cât și de la PowerHA (castout).
În cazul unui defect al unui nod pureScale, recuperarea este limitată doar la tranzacțiile care în momentul întreruperii nu au fost încă finalizate: paginile modificate de acest nod în tranzacțiile finalizate se află în cache-ul global de pe PowerHA. Nodul se repornește într-o configurație restrânsă pe unul dintre serverele clusterului, anulează tranzacțiile nefinalizate și eliberează blocările.
PowerHA funcționează pe două servere, iar nodul principal replică starea sa sincron. În cazul unui defect al nodului principal, clusterul PowerHA continuă să funcționeze cu nodul de rezervă.
Desigur, dacă se accesează un set de date printr-un singur nod, performanța generală a clusterului va fi mai bună. PureScale poate chiar observa că o anumită zonă de date este procesată de un singur nod, iar atunci toate blocările asociate acestei zone vor fi gestionate local de nod fără comunicări cu PowerHA. Dar de îndată ce aplicația încearcă să acceseze aceste date printr-un alt nod, procesarea centralizată a blocărilor va fi reluată.
Testele interne IBM pe o sarcină compusă din 90% citiri și 10% scrieri, ceea ce seamănă foarte mult cu o sarcină industrială reală, arată o scalare aproape liniară până la 128 de noduri. Din păcate, condițiile de testare nu sunt dezvăluite.
HPE NonStop SQL
Platforma sa de înaltă disponibilitate este disponibilă și în portofoliul Hewlett-Packard Enterprise. Aceasta este platforma NonStop, lansată pe piață în 1976 de compania Tandem Computers. În 1997, compania a fost achiziționată de Compaq, care, la rândul său, s-a integrat în Hewlett-Packard în 2002.
NonStop este utilizată pentru construirea aplicațiilor critice – de exemplu, HLR sau procesarea cardurilor bancare. Platforma este disponibilă ca un complex software-hardware (appliance), care include noduri de calcul, un sistem de stocare a datelor și echipamente de comunicație. Rețeaua ServerNet (în sistemele moderne – Infiniband) servește atât pentru schimbul de date între noduri, cât și pentru accesul la sistemul de stocare a datelor.
În versiunile anterioare ale sistemului, erau utilizate procesoare proprietare, care erau sincronizate între ele: toate operațiile erau executate sincron de către mai multe procesoare, și de îndată ce unul dintre procesoare întâmpina o eroare, se deconecta, în timp ce celălalt continua să funcționeze. Ulterior, sistemul a trecut la procesoare standard (inițial MIPS, apoi Itanium și, în cele din urmă, x86), iar pentru sincronizare au fost folosite alte mecanisme:
- mesaje: fiecare proces de sistem are un duplicat-„umbră”, căruia procesul activ îi trimite periodic mesaje despre starea sa; în cazul unei erori a procesului principal, procesul umbră începe să funcționeze din punctul stabilit de ultimul mesaj;
- votare: sistemul de stocare a datelor are un component hardware special, care primește mai multe solicitări identice și le execută doar dacă acestea coincid; în loc de sincronizare fizică, procesoarele funcționează asincron, iar rezultatele muncii lor sunt comparate doar în momentele de intrare/ieșire.
Începând din 1987, platforma NonStop găzduiește un sistem de gestionare a bazelor de date relaționale – mai întâi SQL/MP, iar mai târziu – SQL/MX.
Întreaga bază de date este împărțită în părți, fiecare parte fiind gestionată de propriul proces Data Access Manager (DAM). Acesta asigură scrierea datelor, caching-ul și mecanismul de blocare. Procesarea datelor este efectuată de procesele executante (Executor Server Process), care rulează pe aceleași noduri ca și managerii de date aferenți. Scheduler-ul SQL/MX împarte sarcinile între executanți și combină rezultatele. În cazul în care este necesară efectuarea modificărilor coordonate, se folosește protocolul de confirmare în două faze, asigurat de biblioteca TMF (Transaction Management Facility).
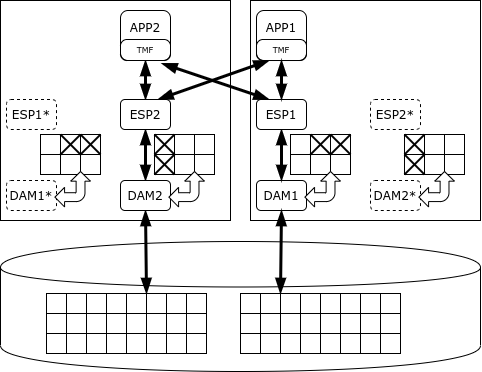
NonStop SQL prioritizează procesele astfel încât interogările analitice de lungă durată să nu interfereze cu executarea transacțiilor. Totuși, scopul său este de a gestiona transacții scurte, nu analiza. Dezvoltatorul garantează disponibilitatea clusterului NonStop la nivel de cinci „nouă”, adică downtime-ul este de doar 5 minute pe an.
SAP HANA
Prima versiune stabilă a SGBD-ului HANA (1.0) a fost lansată în noiembrie 2010, iar pachetul SAP ERP a trecut la HANA începând cu mai 2013. Platforma se bazează pe tehnologii achiziționate: motorul de căutare TREX (pentru căutarea în stocarea pe coloane), SGBD P*TIME și MAX DB.
Cuvântul „HANA” este un acronim pentru High Performance ANalytical Appliance. Acest SGBD este disponibil sub formă de cod care poate funcționa pe orice servere x86, însă instalațiile industriale sunt permise doar pe echipamente certificate. Există soluții de la HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Unele configurații Lenovo permit chiar exploatarea fără SAN – clusterul GPFS pe discurile locale joacă rolul unui stocare comună.
Spre deosebire de platformele menționate mai sus, HANA este un SGBD în memorie, adică imaginea primară a datelor este stocată în memoria RAM, iar pe disc sunt scrise doar jurnalele și instantaneele periodice – pentru recuperare în caz de avarie.
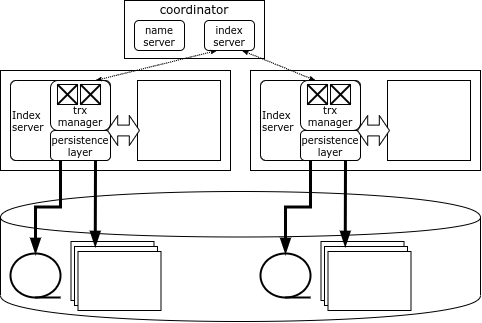
Fiecare nod al clusterului HANA este responsabil pentru partea sa de date, iar harta datelor este stocată într-un component special – Name Server, situat pe nodul coordonator. Datele între noduri nu sunt duplicate. Informațiile despre blocaje sunt de asemenea stocate pe fiecare nod, dar în sistem există un detector global de blocaje.
Client HANA, when connecting to the cluster, loads its topology and can subsequently address any node directly depending on the data it needs. If the transaction involves data from a single node, it can be executed locally by that node, but if data from multiple nodes is being modified, the initiating node communicates with the coordinating node, which opens and coordinates the distributed transaction, committing it using an optimized two-phase commit protocol.
The coordinating node is duplicated, so in case the coordinator fails, a backup node immediately takes over. However, if a data node fails, the only way to access its data is to restart the node. Typically, HANA clusters maintain a spare server to quickly restart the lost node.
Sursa: habr.com
