

În această articol, dorim să discutăm despre particularitățile funcționării aranjamentelor All Flash AccelStor cu una dintre cele mai populare platforme de virtualizare – VMware vSphere. În special, ne vom concentra asupra parametrilor care pot ajuta la obținerea unui efect maxim din utilizarea unui instrument atât de puternic precum All Flash.
Aranjamentele All Flash AccelStor NeoSapphire™ reprezintă sau dispozitiv nodular bazat pe unități SSD, cu o abordare total diferită în realizarea conceptului de stocare a datelor și organizarea accesului la acesta, folosind tehnologia proprie în locul algoritmilor RAID destul de populari. Aranjamentele oferă acces bloc pentru gazde prin interfețele Fibre Channel sau iSCSI. Merită menționat că modelele cu interfață ISCSI au de asemenea acces prin fișiere ca un bonus plăcut. Totuși, în cadrul acestui articol ne vom concentra pe utilizarea protocoalelor bloc ca fiind cele mai productive pentru All Flash.
Întregul proces de desfășurare și configurare ulterioară a colaborării dintre aranjamentele AccelStor și sistemul de virtualizare VMware vSphere poate fi împărțit în mai multe etape:
- Implementarea topologiei de conectare și configurarea rețelei SAN;
- Configurarea aranjamentului All Flash;
- Configurarea gazdelor ESXi;
- Configurarea mașinilor virtuale.
Pentru exemplele utilizate, s-au folosit aranjamente AccelStor NeoSapphire™ cu interfață Fibre Channel și cu interfață iSCSI. Software-ul de bază utilizat a fost VMware vSphere 6.7U1.
Înainte de desfășurarea sistemelor descrise în articol, este extrem de recomandat să se revizuiască documentația de la VMware referitoare la aspectele de performanță ( ) și setările iSCSI ()
Topologia de conectare și configurarea rețelei SAN
Principalele componente ale rețelei SAN sunt adaptorii HBA din gazdele ESXi, comutatoarele SAN și nodurile aranjamentului. O topologie tipică a acestei rețele va arăta astfel:
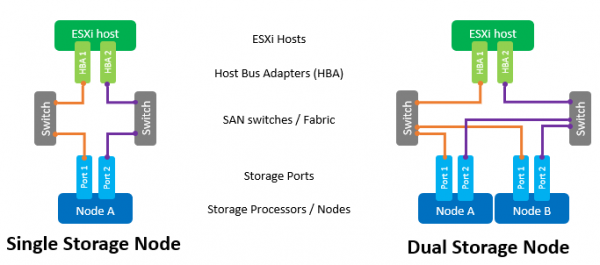
Prin termenul Switch, ne referim atât la un comutator fizic separat sau la un set de comutatoare (Fabric), cât și la un dispozitiv partajat între diferite servicii (VSAN în cazul Fibre Channel și VLAN în cazul iSCSI). Utilizarea a două comutatoare/Fabric independente va elimina o posibilă punct de eșec.
Conectarea directă a gazdelor la matrice este posibilă, dar nu este recomandată. Performanța matricei All Flash este suficient de ridicată și, pentru viteză maximă, este necesar să se utilizeze toate porturile matricei. Prin urmare, este obligatorie prezența cel puțin unui switch între gazde și NeoSapphire™.
Prezența a două porturi pe HBA-ul gazdei este, de asemenea, o cerință esențială pentru a atinge performanța maximă și pentru a asigura redundanța.
În cazul utilizării interfeței Fibre Channel, este necesară configurarea zonării pentru a exclude coliziunile între inițiatori și ținte. Zonele sunt construite pe principiul „un port al inițiatorului – unul sau mai multe porturi ale matricei”.
Dacă se utilizează conexiunea prin iSCSI, în cazul utilizării unui switch partajat cu alte servicii, este obligatorie izolarea traficului iSCSI într-un VLAN separat. Este, de asemenea, foarte recomandat să se activeze suportul pentru Jumbo Frames (MTU = 9000) pentru a crește dimensiunea pachetelor în rețea și, astfel, a reduce cantitatea de informații administrative în timpul transmisiei. Totuși, este important să ne amintim că pentru o funcționare corectă, trebuie schimbat parameterul MTU pe toate componentele rețelei pe lanțul „inițiator-switch-țintă”.
Configurarea matricei All Flash
Matricea este livrată clienților cu grupuri deja formate . Prin urmare, nu este necesar să se efectueze acțiuni pentru a combina suporturile într-o singură structură. Este suficient să creați volume de dimensiunea necesară și în numărul dorit.
Pentru comoditate, există funcționalitatea de creare în bloc a mai multor volume de dimensiune specificată. Implicit, se creează volume "subțiri", deoarece acest lucru permite utilizarea mai eficientă a spațiului de stocare disponibil (inclusiv datorită suportului pentru Space Reclamation). Din punctul de vedere al performanței, diferența între volumele "subțiri" și cele "groase" nu depășește 1%. Totuși, dacă se dorește „scoaterea tuturor sucurilor” din matrice, se poate oricând converti orice volum "subțire" într-un volum "gros". Dar trebuie să ne amintim că această operațiune este ireversibilă.
Apoi, rămâne să „publicați” volumele create și să stabiliți permisiunile de acces de către gazde prin intermediul ACL (adrese IP pentru iSCSI și WWPN pentru FC) și separarea fizică pe porturile array-ului. Pentru modelele iSCSI, acest lucru se face prin crearea unui Target.
Pentru modelele FC, publicarea se realizează prin crearea unui LUN pentru fiecare port al array-ului.
Pentru accelerarea procesului de configurare, gazdele pot fi grupate. De fapt, dacă pe gazdă este folosit un FC HBA multiport (ceea ce se întâmplă cel mai frecvent în practică), sistemul determină automat că porturile unui astfel de HBA aparțin aceleași gazde datorită WWPN-ului, care se diferențiază cu o unitate. De asemenea, pentru ambele interfețe se suportă crearea în masă de Target/LUN.
O observație importantă în cazul utilizării interfeței iSCSI este crearea pentru volume a mai multor target-uri simultan pentru a crește performanța, deoarece coada pe target nu poate fi modificată și va fi, de fapt, un punct de congestie.
Configurarea gazdelor ESXi
Din partea gazdelor ESXi, configurarea de bază se realizează conform unui scenariu destul de așteptat. Pașii pentru conexiunea iSCSI sunt:
- Adăugați Software iSCSI Adapter (nu este necesar dacă acesta a fost deja adăugat, sau în cazul utilizării Hardware iSCSI Adapter);
- Crearea unui vSwitch, prin care va circula traficul iSCSI, și adăugarea linkurilor fizice și VMkernel în acesta;
- Adăugarea adreselor array-ului în Dynamic Discovery;
- Crearea unui Datastore
Câteva observații importante:
- În general, bineînțeles, se poate folosi și un vSwitch existent, dar în cazul unui vSwitch separat, gestionarea setărilor gazdei va fi semnificativ mai simplă.
- Este necesar să separați traficul de Management și iSCSI pe linkuri fizice și/sau VLAN-uri separate pentru a evita problemele de performanță.
- Adresele IP ale VMkernel și ale porturilor corespunzătoare ale array-ului All Flash trebuie să fie în aceeași subrețea din nou din motive de performanță.
- Pentru a asigura redundanța conform regulilor VMware, vSwitch-ul trebuie să aibă cel puțin două uplink-uri fizice.
- Dacă se utilizează Jumbo Frames, este necesar să schimbați MTU atât la vSwitch, cât și la VMkernel.
- Nu strică să amintim că, conform recomandărilor VMware pentru adaptoarele fizice care vor fi utilizate pentru a lucra cu traficul iSCSI, este absolut necesar să se efectueze configurarea Teaming and Failover. În special, fiecare VMkernel trebuie să funcționeze doar printr-un singur uplink, iar al doilea uplink trebuie să fie setat pe mod unused. Pentru redundanță, este necesar să se adauge două VMkernel-uri, fiecare dintre ele funcționând prin propriul său uplink.
VMkernel Adapter (vmk#)
Physical Network Adapter (vmnic#)
vmk1 (Storage01)
Adaptoare active
vmnic2
Adaptoare neutilizate
vmnic3
vmk2 (Storage02)
Adaptoare active
vmnic3
Adaptoare neutilizate
vmnic2
Pentru conexiunea prin Fibre Channel, nu sunt necesare acțiuni preliminare. Se poate crea imediat un Datastore.
După crearea Datastore-ului, trebuie să ne asigurăm că se folosește politica Round Robin pentru căile către Target/LUN, deoarece aceasta este cea mai performantă.
În mod implicit, setările VMware prevăd utilizarea acestei politici conform schemei: 1000 de solicitări prin prima cale, următoarele 1000 de solicitări prin a doua cale etc. Această interacțiune a gazdelor cu un array cu două controle nu va fi echilibrată. De aceea, recomandăm setarea parametrului Round Robin policy = 1 prin Esxcli/PowerCLI.
Setări
Pentru Esxcli:
- Afișați LUN-urile disponibile
esxcli storage nmp device list
- Copiați Device Name
- Modificați Round Robin Policy
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
Majoritatea aplicațiilor moderne sunt proiectate pentru a schimba pachete de date de dimensiuni mari, cu scopul de a maximiza utilizarea lățimii de bandă și de a reduce sarcina pe procesorul central. De aceea, ESXi în mod implicit trimite solicitările de intrare/ieșire către dispozitivul de stocare în porții de până la 32767KB. Totuși, pentru anumite scenarii, schimbul în porții mai mici va fi mai performant. În legătură cu array-urile AccelStor, acestea sunt următoarele scenarii:
- Mașina virtuală folosește UEFI în loc de Legacy BIOS
- Se folosește vSphere Replication
Pentru astfel de scenarii, se recomandă modificarea valorii parametrului Disk.DiskMaxIOSize la 4096.
Pentru conexiunile iSCSI, se recomandă modificarea parametrului Login Timeout la 30 (de la 5 în mod implicit) pentru a îmbunătăți stabilitatea conexiunii și dezactivarea întârzierii confirmărilor pachetelor retransmise DelayedAck. Ambele opțiuni se găsesc în vSphere Client: Host → Configure → Storage → Storage Adapters → Advanced Options pentru adaptorul iSCSI.
Un aspect important este numărul de volume utilizate pentru datastore. Este evident că, pentru a simplifica gestionarea, există dorința de a crea un singur volum mare pentru întreaga capacitate a array-ului. Totuși, faptul de a avea mai multe volume și, prin urmare, datastores, afectează pozitiv performanța generală (mai multe detalii despre cozi mai jos). De aceea, recomandăm crearea a cel puțin două volume.
Cu câteva vreme în urmă, VMware recomanda limitarea numărului de mașini virtuale pe un singur datastore din același motiv de a obține o performanță maximă. Totuși, acum, în special odată cu răspândirea VDI, această problemă nu mai este atât de stringentă. Dar acest lucru nu anulează regula veche – distribuirea mașinilor virtuale care necesită un IO intens pe diferite datastores. Pentru a determina numărul optim de VM-uri pe un volum, nu există nimic mai bun decât a efectua în cadrul infrastructurii proprii.
Configurarea mașinilor virtuale
La configurarea mașinilor virtuale nu există cerințe speciale, adică acestea sunt destul de obișnuite:
- Folosirea celei mai recente versiuni posibile a VM (compatibility)
- Acordați mai multă atenție dimensiunii RAM-ului atunci când plasați dens mașinile virtuale, de exemplu, în VDI (deoarece, în mod implicit, la pornire se creează un fișier de swap de dimensiuni similar cu RAM-ul, ceea ce consumă capacitatea utilă și afectează performanța finală)
- Utilizați cele mai performante versiuni de adaptori în ceea ce privește IO: tipul de rețea VMXNET 3 și SCSI de tip PVSCSI
- Utilizați tipul de disc Thick Provision Eager Zeroed pentru performanță maximă și Thin Provisioning pentru utilizarea eficientă a spațiului de stocare
- Dacă este posibil, limitați activitatea mașinilor necritice la IO prin intermediul Virtual Disk Limit
- Asigurați-vă că VMware Tools sunt instalate
Observații despre cozi
Coada (sau I/O-uri outstanding) se referă la numărul de cereri de intrare/ieșire (comenzi SCSI) care așteaptă procesarea în fiecare moment pentru un anumit dispozitiv/aplicație. În cazul în care coada este suprasaturată, se emit erori QFULL, ceea ce duce în final la creșterea parametrului de latență. Atunci când sunt utilizate sisteme de stocare pe disc (spindle), teoretic, cu cât coada este mai mare, cu atât performanța acestora este mai ridicată. Totuși, nu trebuie să se abuzeze, deoarece riscați să întâlniți QFULL. În cazul sistemelor All Flash, pe de o parte, lucrurile sunt puțin mai simple: deoarece matricea are întârzieri cu ordine de mărime mai mici, în cele mai multe cazuri nu este necesară ajustarea separată a dimensiunilor cozilor. Pe de altă parte, în unele scenarii de utilizare (un dezechilibru puternic în cerințele de I/O pentru anumite mașini virtuale, teste de performanță maximă etc.) este necesar, dacă nu să modificați parametrii cozilor, măcar să înțelegeți ce valori pot fi atinse și, cel mai important, prin ce metode.
Pe matricea All Flash AccelStor nu există limite în ceea ce privește volumele sau porturile de intrare/ieșire. Dacă este necesar, chiar și un singur volum poate beneficia de toate resursele matricei. Singura limitare a cozilor se află la țintele iSCSI. Din acest motiv, a fost menționată anterior necesitatea de a crea mai multe (ideal până la 8) ținte pentru fiecare volum pentru a depăși această limită. De asemenea, repetăm că matricele AccelStor sunt soluții de înaltă performanță. Prin urmare, trebuie folosite toate porturile de interfață ale sistemului pentru a atinge viteza maximă.
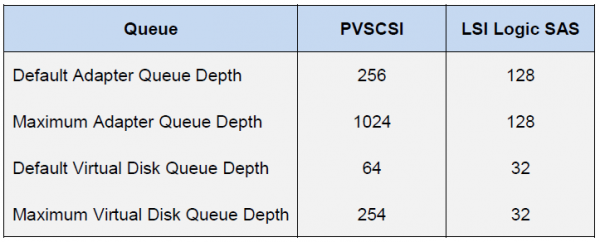
Din perspectiva gazdelor ESXi, situația este complet diferită. Gazda aplică practica accesului egal la resurse pentru toți participanții. Prin urmare, există cozi IO separate pentru sistemul de operare guest și HBA. Cozile pentru sistemul de operare guest sunt combinate din cozile către adaptorul SCSI virtual și discul virtual:
Coada HBA depinde de tipul/vânzătorul specific:
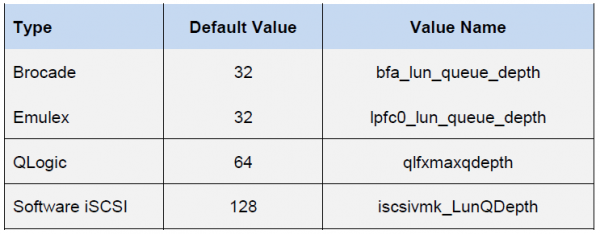
Performanța finală a mașinii virtuale va fi determinată de cea mai mică valoare a limitelor cozii (Queue Depth limit) dintre componentele gazdei.
Datorită acestor valori, putem evalua indicatorii de performanță pe care îi putem obține în diferite configurații. De exemplu, dorim să cunoaștem performanța teoretică a unei mașini virtuale (fără legare la un bloc) cu o latență de 0,5 ms. Atunci IOPS-ul său = (1,000/latency) * Outstanding I/Os (Limită de adâncime a cozii)
Exemple
Exemplu 1
- FC Emulex HBA Adapter
- O VM pe datastore
- VMware Paravirtual SCSI Adapter
Aici, limita de adâncime a cozii este determinată de Emulex HBA. Prin urmare, IOPS = (1000/0.5)*32 = 64K
Exemplu 2
- VMware iSCSI Software Adapter
- O VM pe datastore
- VMware Paravirtual SCSI Adapter
Aici, limita de adâncime a cozii este determinată de Paravirtual SCSI Adapter. Prin urmare, IOPS = (1000/0.5)*64 = 128K
Modelele de top ale sistemelor All Flash AccelStor (de exemplu, ) sunt capabile să ofere o performanță de 700K IOPS la scriere cu un bloc de 4K. La acest dimensiune a blocului, este evident că o singură mașină virtuală nu poate solicita un astfel de sistem. Pentru aceasta va fi nevoie de 11 (pentru exemplul 1) sau 6 (pentru exemplul 2) mașini virtuale.
În final, cu o configurare corectă a tuturor componentelor descrise ale centrului de date virtual, se pot obține rezultate foarte impresionate în ceea ce privește performanța.
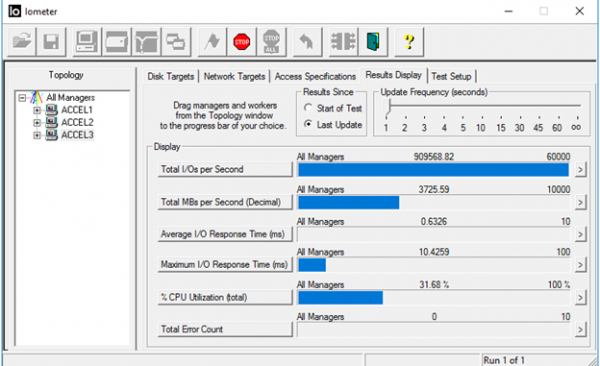
4K Random, 70% Citire/30% Scriere
În realitate, lumea este mult mai complexă pentru a fi descrisă printr-o formulă simplă. Pe un singur host, există întotdeauna mai multe mașini virtuale cu configurații și cerințe IO diferite. De asemenea, procesorul host-ului gestionează operațiunile de intrare/ieșire, cu puterea sa care nu este infinită. Astfel, pentru a valorifica potențialul complet al aceleași în realitate, sunt necesare cel puțin trei hosts. În plus, aplicațiile care funcționează în interiorul mașinilor virtuale aduc propriile lor ajustări. Prin urmare, pentru un dimensionare precisă, vă recomandăm sistemelor All Flash în cadrul infrastructurii clientului pe sarcini reale.
Sursa: habr.com
