

Voi spune astăzi o poveste. O poveste despre evoluția tehnologiei informației și apariția locurilor de muncă la distanță, de la cele mai vechi timpuri până în prezent.
Evoluția IT
Principala lecție pe care o putem învăța din istoria IT este...
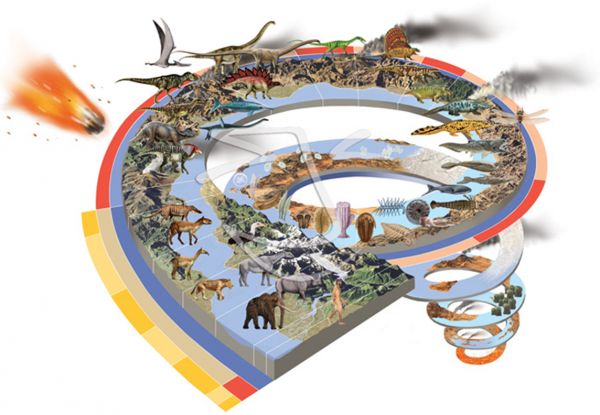
Desigur, IT-ul se dezvoltă în spirală. Aceleași soluții și concepte care au fost abandonate acum zeci de ani recâștigă înțeles și încep să funcționeze cu succes în noi condiții, la noi sarcini și cu noi capacități. În acest sens, IT-ul nu se deosebește de niciun alt domeniu al cunoștințelor umane și de istoria Pământului în general.
Cu mult timp în urmă, când computerele erau mari
„Cred că în lume există un piață pentru aproximativ cinci computere”, a declarat Thomas Watson, șeful IBM, în 1943.
Tehnologia timpurie a calculatoarelor era enormă. Nu, greșesc, tehnologia timpurie era colosală, ciclopică. O mașină de calcul completă ocupa un spațiu comparabil cu o sală de sport și costa o sumă total imposibilă. Ca exemplu de componente, putem menționa un modul de memorie RAM cu inele de ferită (1964).
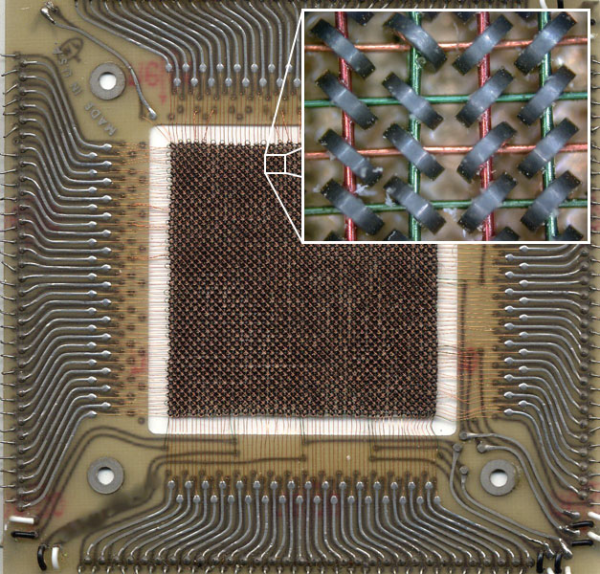
Acest modul are dimensiunea de 11 cm * 11 cm și o capacitate de 512 biți (4096 biți). Un dulap, plin complet cu aceste module, avea o capacitate de-abia comparabilă cu discheta veche de 3,5” (1,44 MB = 2950 module), consumând o putere electrică considerabilă și încălzindu-se ca un locomotivă.
De altfel, dimensiunile uriașe sunt legate și de denumirea în limba engleză a procesului de depurare a codului — „debugging”. Una dintre primele programatoare din istorie, Grace Hopper (da, o femeie), ofițer în marina militară, a făcut în 1945 o notă în jurnalul său de activitate după investigația unei defecțiuni a programului.
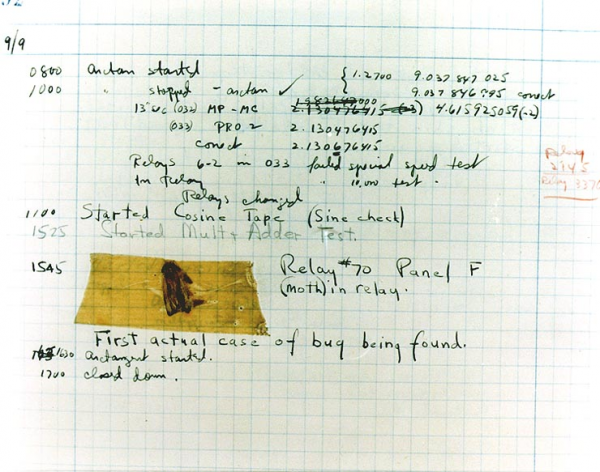
Din moment ce „moth” (motyl) este în general un tip de „bug” (insectă), toate problemele și acțiunile ulterioare pentru rezolvarea lor erau raportate superiorilor ca „debugging” (literalmente, „dez-insectizare”), așa că termenul „bug” s-a fixat ferm în lexiconul programării, iar procesul de depurare a devenit un „debug”.
Pe măsură ce electronica și, în special, electronica pe bază de semiconductori au evoluat, dimensiunile fizice ale mașinilor au început să scadă, în timp ce puterea de calcul, dimpotrivă, a crescut. Dar chiar și în aceste condiții, nu putea fiecare să aibă un computer personal.
„Nu există niciun motiv pentru ca cineva să vrea să dețină un computer acasă” — Ken Olsen, fondatorul DEC, 1977.
În anii '70 apare termenul mini-computer. Îmi amintesc că, atunci când am citit acest termen pentru prima dată cu mulți ani în urmă, mi-am imaginat ceva asemănător unui netbook, practic un dispozitiv de mână. Nu aș fi putut fi mai departe de adevăr.
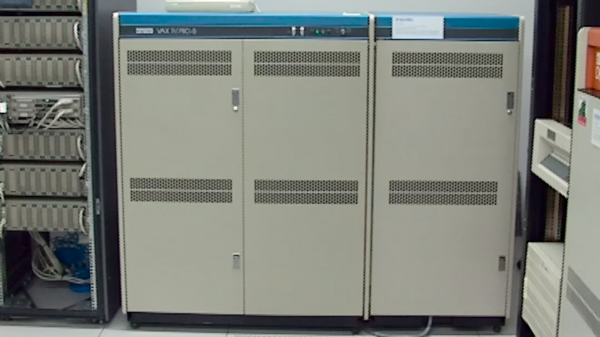
Mini este doar în comparație cu imensele săli de mașini, dar este în continuare vorba despre mai multe dulapuri cu echipamente în valoare de sute de mii și milioane de dolari. Totuși, puterea de calcul a crescut deja atât de mult încât nu era întotdeauna utilizată la maxim, iar computerele au început să devină accesibile studenților și profesorilor universitar.
Și aici a venit EL!
Puțini se gândesc la rădăcinile latine din limba engleză, dar tocmai ea ne-a adus accesul de la distanță, așa cum îl știm acum. Terminus (lat) înseamnă sfârșit, limită, țintă. Scopul Terminatorului T800 era să pună capăt vieții lui John Connor. De asemenea, știm că stațiile de transport, unde se efectuează îmbarcarea și debarcarea pasagerilor sau încărcarea și descărcarea mărfurilor, se numesc terminale — ținte finale ale traseelor.
Prin urmare, a apărut conceptul de acces terminal, iar tu poți vedea cel mai cunoscut terminal din lume, care trăiește încă în inimile noastre.
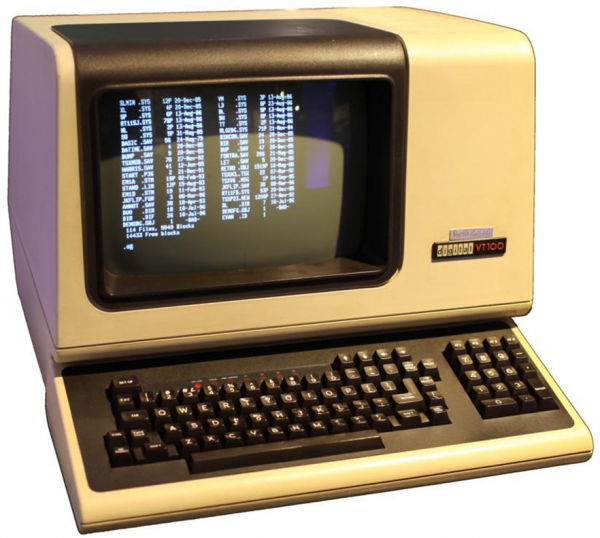
DEC VT100 se numește terminal, deoarece încheie linia informațională. Are practic zero putere de calcul, iar singura sa sarcină este să afișeze informațiile primite de la o mașină mare și să transmită mașinii introducerea de la tastatură. Și deși VT100-urile au murit fizic de mult, noi încă le folosim pe deplin.
Zilele noastre
„Zilele noastre” le-aș începe de la începutul anilor '80, de la apariția primelor procesoare accesibile publicului larg cu o putere de calcul semnificativă. Se consideră tradițional că principalul procesor al epocii a fost Intel 8088 (familia x86), ca fondator al arhitecturii care a triumfat. Care este, așadar, diferența esențială față de conceptul din anii '70?
Pentru prima dată, apare o tendință de transferare a procesării informațiilor din centru către periferie. Nu toate sarcinile necesită puterea colosală (comparativ cu x86) a unui mainframe sau chiar a unui mini-computer. Intel nu stă pe loc, în anii '90 lansând familia Pentium, care a devenit cu adevărat primul procesor de masă pentru uz casnic în Rusia. Aceste procesoare sunt capabile să facă multe, nu doar să scrie un email — ci și să gestioneze multimedia și să lucreze cu baze de date mici. Practic, pentru micile afaceri, nu mai este necesar un server — totul poate fi realizat pe periferie, pe mașinile clienților. Cu fiecare an, procesoarele devin din ce în ce mai puternice, iar diferența dintre servere și computere personale devine din ce în ce mai mică din punct de vedere al puterii de calcul, rămânând adesea doar în privința rezervării energiei, suportului pentru schimb hotărât și în carcase speciale pentru montaj în rack-uri.
Dacă comparăm procesoarele client moderne, „amuzante” pentru administratorii serverelor grele din anii '90 de la Intel cu supercomputerele din trecut, devine puțin deranjant.
Să aruncăm o privire asupra unui „bătrân” care este, practic, aproape de vârsta mea. Cray X-MP/24 din 1984.
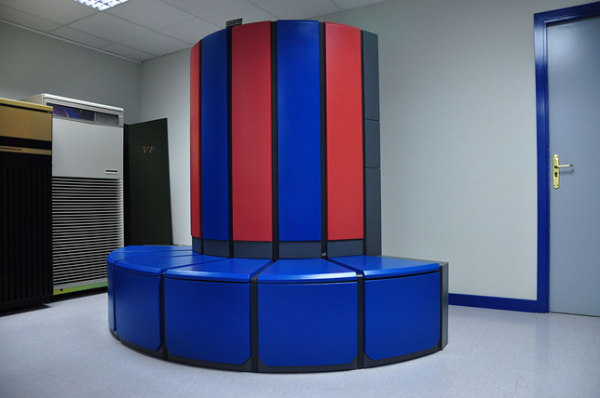
Această mașină făcea parte din topul supercomputerelor în 1984, având 2 procesoare de 105 MHz cu o putere de calcul de vârf de 400 MFlops (milioane de operațiuni în virgulă mobilă). Concret, mașina care este reprezentată în fotografie se afla în laboratorul de criptografie al NSA din SUA și se ocupa cu spargerea codurilor. Dacă traducem 15 milioane de dolari din 1984 în dolari din 2020, costul ar fi de 37,4 milioane sau 93.500 dolari/MFlops.
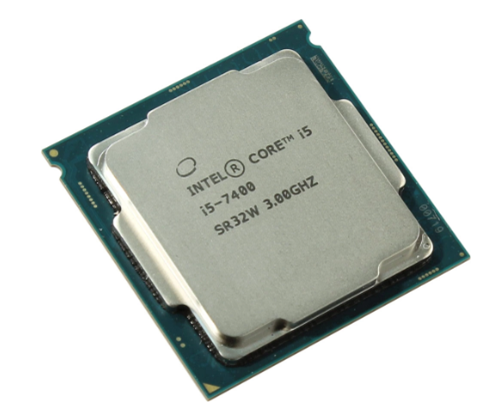
Pe mașina pe care scriu aceste rânduri, se află un procesor Core i5-7400 din 2017, care este departe de a fi nou, și chiar în anul lansării era cel mai tânăr procesor quad-core din gama medie de desktop-uri. 4 nuclee cu o frecvență de bază de 3,0 GHz (3,5 cu Turbo Boost) și dublarea firelor prin HyperThreading oferă între 19 și 47 GFlops de putere în funcție de diferite teste, la un preț de 16.000 de ruble pentru procesor. Dacă asamblez o mașină completă, pot considera costul ei la 750 de dolari (pe baza prețurilor și cursului din 1 martie 2020).
În cele din urmă, obținem o superioritate de 50-120 de ori a unui procesor desktop mediu de azi în raport cu un supercomputer din top 10 dintr-un trecut ușor vizibil, iar scăderea costului pe MFlops devine complet monstruoasă, 93.500/25 = 3.700 de ori.
De ce ne mai trebuie servere și centralizare a calculului cu astfel de puteri la periferie — este cu adevărat neclar!
Retragerea — spirala a făcut o întorsătură
Stații fără discuri
Primul semnal că externalizarea calculului la periferie nu va fi finală a fost apariția tehnologiei stațiilor de lucru fără discuri. Odată cu distribuția semnificativă a stațiilor de lucru pe teritoriul întreprinderii, și în special în încăperi poluate, apare o problemă foarte stringentă de gestionare și întreținere a acestor stații.
Apare conceptul de „timp de coridor” — procentul din timp în care angajatul de suport tehnic se află în coridor, pe drum spre angajatul cu problemă. Acest timp este plătit, dar complet neproductiv. Un rol semnificativ, în special în încăperi poluate, l-au avut defecțiunile discurilor dure. Hai să eliminăm discul din stația de lucru, iar tot restul să-l facem prin rețea, inclusiv încărcarea. Adaptorul de rețea primește, pe lângă adresa de la serverul DHCP, și informații suplimentare — adresa serverului TFTP (un serviciu de fișiere simplificat) și numele imaginii de încărcare, le încarcă în memorie și pornește mașina.
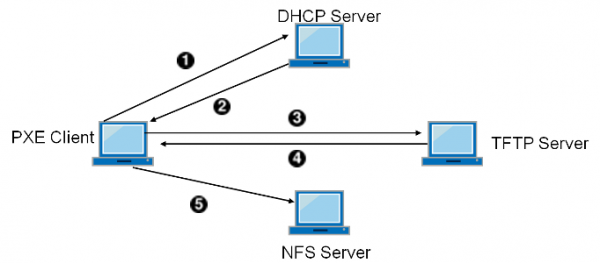
În afară de un număr mai mic de defecțiuni și reducerea timpului de coridor, acum mașina nu trebuie să fie ajustată la fața locului, ci pur și simplu poate fi adusă una nouă, iar cea veche să fie dusă la diagnosticare într-un loc de lucru echipat. Dar asta nu este tot!
Stația fără discuri devine semnificativ mai sigură — dacă cineva intră în încăpere și ia toate computerele, pierderile sunt doar de echipament. Niciun fel de date nu sunt stocate pe stațiile fără discuri.
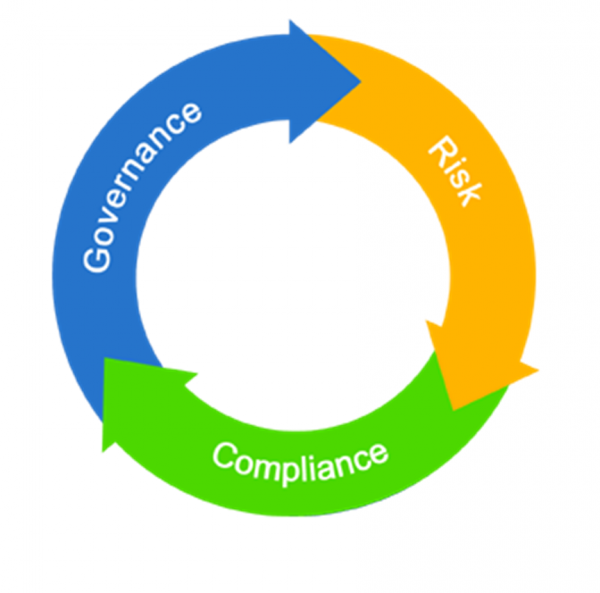
Să reținem acest moment, Securitatea Informațională începe să joace un rol din ce în ce mai important după „copilăria iresponsabilă” a tehnologiilor informaționale. În IT, cele trei litere înfricoșătoare și importante — GRC (Guvernanță, Riscuri, Conformitate) — își fac tot mai mult simțită prezența.
Servere terminale
Răspândirea din ce în ce mai mare a PC-urilor puternice la periferie a depășit semnificativ dezvoltarea rețelelor publice. Aplicațiile client-server clasice din anii '90 și începutul anilor 2000 nu funcționau foarte bine prin canale subțiri, când transferul de date era semnificativ. Acest lucru era deosebit de greu pentru birourile remote, care se conectau prin modem și linie telefonică, care se bloca sau se întrerupea periodic. Și...
Spirala a făcut un tur și s-a întors din nou la modul terminal cu conceptul serverelor terminale.
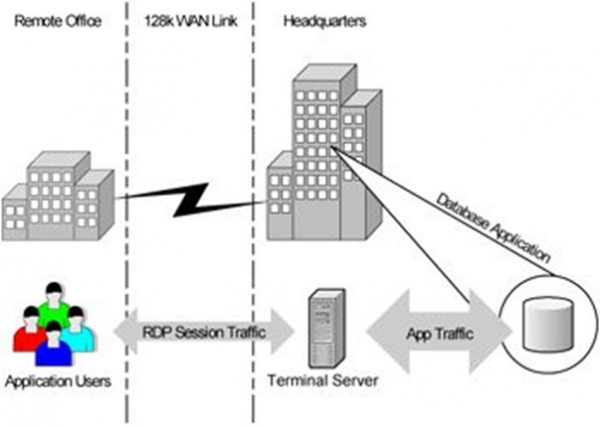
De fapt, ne-am întors în anii '70 cu clienții zero și centralizarea puterii de calcul. A devenit foarte rapid evident că, pe lângă motivația pur economică cu privire la canale, accesul terminal oferă oportunități uriașe de organizare a unui acces sigur din exterior, inclusiv muncă de acasă pentru angajați sau acces extrem de limitat și controlat pentru contractorii din rețele nesigure și dispozitive nedeterminate.
Cu toate avantajele și progresivitatea lor, serverele terminale aveau și o serie de dezavantaje — flexibilitate scăzută, problema vecinului zgomotos, un Windows strict server și așa mai departe.
Nașterea proto VDI
Adevărul este că, la începutul și mijlocul anilor 2000, virtualizarea industrială a platformei x86 a început să facă valuri. Și cineva a exprimat pur și simplu ideea care plutea în aer: de ce, în loc să centralizăm toți clienții pe fermele de terminale server, să dăm fiecăruia o mașină virtuală personală cu Windows client și chiar acces de administrator?
Renunțarea la clienți groși
Paralel cu virtualizarea sesiunilor și sistemelor de operare, s-a dezvoltat o abordare legată de simplificarea funcției clientului la nivel de aplicație.
Logica din spatele acestui aspect era destul de simplă, deoarece laptopurile personale nu erau încă la îndemâna tuturor, internetul nu era la fel de răspândit, iar mulți puteau accesa doar din cafenele internet cu drepturi foarte limitate, să spunem așa. De fapt, tot ce se putea rula era un browser. Browserul a devenit un atribut esențial al sistemului de operare, internetul și-a consolidat prezența în viața noastră.
Cu alte cuvinte, în paralel, exista tendința de a transfera logica de la client la centru sub formă de aplicații web, pentru accesul cărora era nevoie doar de cel mai simplu client, internet și browser.
Și nu am ajuns doar acolo de unde am început — cu clienți zero și servere centrale. Am ajuns acolo pe mai multe căi independente.
Infrastructurea Desktop Virtual
Broker
În 2007, liderul pieței virtualizării industriale, VMware, a lansat prima versiune a produsului său VDM (Virtual Desktop Manager), care a devenit de fapt primul pe o piață de desktopuri virtuale aflându-se abia la început. Desigur, nu a durat mult până să apară răspunsul liderului serverelor terminale Citrix și, în 2008, cu achiziția XenSource, apare XenDesktop. Cu siguranță au fost și alți furnizori cu ofertele lor, dar să nu ne aprofundăm prea mult în istorie, abătându-ne de la concept.
Și până în prezent, conceptul se menține. Componenta cheie a VDI este brokerul de conexiuni.
Aceasta este inima infrastructurii desktopurilor virtuale.
Brokerul se ocupă de cele mai importante procese ale VDI:
- Determină resursele disponibile pentru clientul conectat (mașini/sesiuni);
- Echilibrează, dacă este necesar, clienții între grupurile de mașini/sesiuni;
- Redirecționează clientul către resursa selectată.
Astăzi, clientul (terminalul) pentru VDI poate fi, de fapt, orice dispozitiv cu ecran — laptop, smartphone, tabletă, chioșc, client subțire sau zero. Iar partea răspunsătoare, care îndeplinește sarcina productivă — sesiunea serverului terminal, mașina fizică, mașina virtuală. Produsele VDI moderne și mature sunt strâns integrate cu infrastructura virtuală și gestionează automat aceasta, desfășurând sau, dimpotrivă, eliminând mașinile virtuale care nu mai sunt necesare.
Puțin mai în aparte, dar pentru unii clienți o tehnologie extrem de importantă a VDI, este suportul pentru accelerarea hardware-ului 3D pentru munca proiectanților sau designerilor.
Protocolul
O a doua parte extrem de importantă a unei soluții VDI mature este protocolul de acces la resursele virtuale. Dacă este vorba despre lucrul în cadrul unei rețele locale corporative cu o rețea fiabilă de 1 Gbps până la locul de muncă și cu o întârziere de 1 ms, atunci se poate folosi practic orice și nu trebuie să te gândești prea mult.
Este important să ne gândim atunci când conexiunea se desfășoară printr-o rețea necontrolată, iar calitatea acestei rețele poate varia de la viteze de câteva kilobit la întârzieri imprevizibile. Aceasta este esențială pentru organizarea unei adevărate lucrări de la distanță, fie că este vorba de o cabană, de acasă, din aeroporturi sau din restaurante.
Servere terminale vs. VM client
Odată cu apariția VDI, părea că ne luăm rămas bun de la serverele terminale. De ce sunt necesare, dacă fiecare are propria sa VM personală?
Cu toate acestea, din perspectiva economiei pure, s-a dovedit că pentru locurile de muncă standardizate și identice până la plictiseală — nu există nimic mai eficient decât serverele terminale în ceea ce privește raportul cost / sesiune. Indiferent de avantajele sale, abordarea '1 utilizator = 1 VM' consumă semnificativ mai multe resurse pe hardware virtual și un sistem de operare complet, ceea ce afectează economia pe locurile de muncă standard.
În cazul locurilor de muncă ale top-managerilor, pentru poziții atipice și încărcate, când există necesitatea de a avea privilegii ridicate (inclusiv drepturi de administrator), preferința o are o VM dedicată utilizatorului. În cadrul acestei VM, resursele pot fi alocate individual, pot fi oferite drepturi de orice nivel și se poate echilibra VM-urile între gazdele de virtualizare în condiții de sarcină ridicată.
VDI și economie
Ani de zile am auzit aceeași întrebare — dar cum, VDI este mai ieftin decât să oferim pur și simplu laptopuri tuturor? Și ani de zile trebuie să dau același răspuns: în cazul angajaților de birou obișnuiți, VDI nu este mai ieftin dacă luăm în considerare costurile nete pentru asigurarea echipamentelor. Oricum ai lua-o, laptopurile devin mai ieftine, în timp ce serverele, stocarea și software-ul de sistem costă destul de mult. Dacă a venit momentul să-ți actualizezi echipamentul și te gândești să economisești prin VDI — nu, nu vei economisi.
Am menționat mai sus cele temute trei litere GRC — așa că, VDI este despre GRC. Este despre gestionarea riscurilor, este despre securitate și confortul unui acces controlat la date. Și toate acestea costă de obicei destul de mult pentru implementare pe o multitudine de echipamente variate. Prin intermediul VDI, controlul se simplifică, securitatea crește, iar părul devine moale și mătăsos.
Soluții HPE pentru muncă de la distanță
Managementul de la distanță și în cloud
iLO
Compania HPE nu este deloc nouă în gestionarea infrastructurii serverelor la distanță; în martie, legendarul iLO (Integrated Lights Out) a împlinit 18 ani. Amintindu-mi de zilele mele de administrator din anii 2000, nu am putut să mă bucur mai mult. Instalarea inițială în rackuri și conectarea cablurilor erau tot ce trebuia făcut într-un centru de date zgomotos și rece. Tot restul configurării, inclusiv instalarea sistemului de operare, putea fi realizat de pe birou, cu două monitoare și o ceașcă de cafea fierbinte. Și asta acum 13 ani!
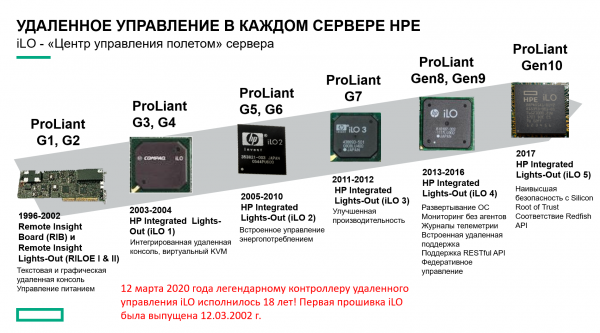
Astăzi, serverele HPE sunt fără îndoială un standard de calitate de lungă durată - iar iLO, având un rol semnificativ, este sistemul de gestionare la distanță de aur.
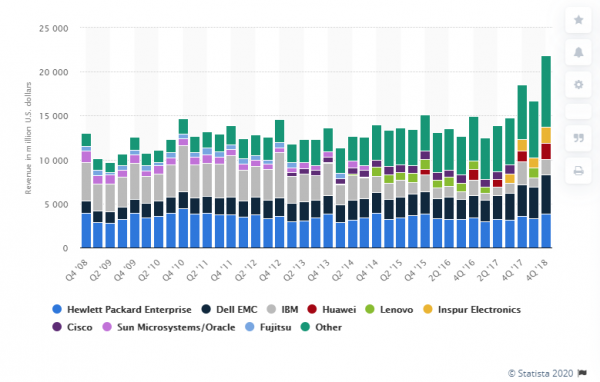
Merită menționate acțiunile HPE în menținerea controlului umanității asupra coronavirusului. , că până la sfârșitul anului 2020 (cel puțin) licența iLO Advanced este disponibilă gratuit pentru toți.
Infosight
Dacă aveți mai mult de 10 servere în infrastructură și administratorul nu se plictisește, atunci un instrument excelent complementar la mijloacele standard de monitorizare este sistemul cloud HPE Infosight bazat pe inteligență artificială. Acesta nu doar monitorizează starea și creează grafice, dar recomandă de asemenea acțiuni viitoare pe baza situației curente și a tendințelor.
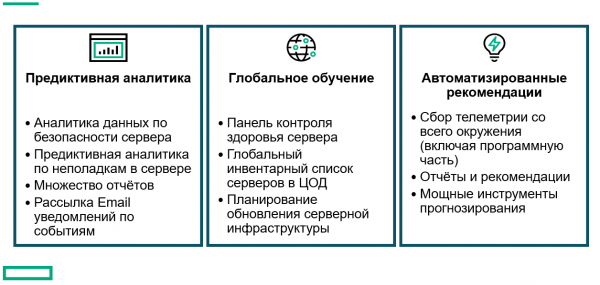
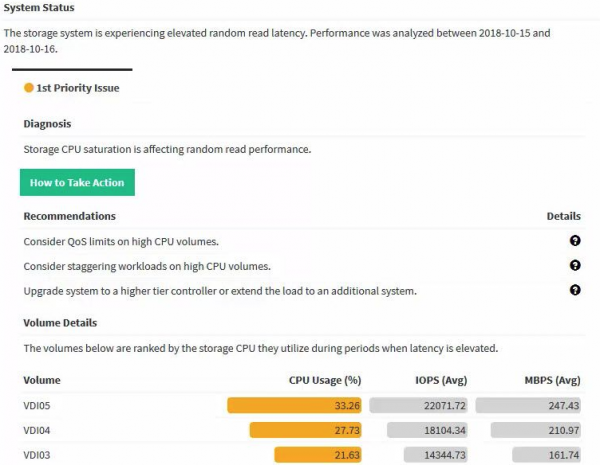
Fii inteligent, , încearcă Infosight!
OneView
Ultimul, dar nu cel din urmă, vreau să subliniez HPE OneView - un portofoliu întreg de produse cu capacități enorme de monitorizare și gestionare a întregii infrastructuri. Iar toate acestea fără să te ridici de la birou, care poate că în această situație se află chiar la cabană.
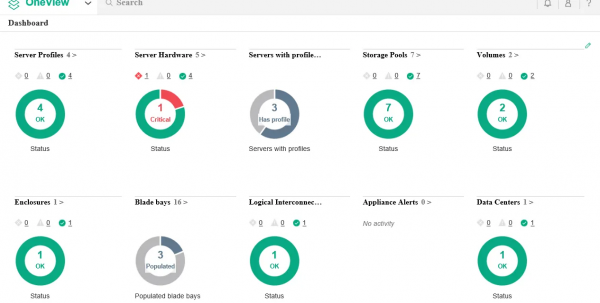
Sistemele de stocare nu sunt cu nimic mai prejos!
Desigur, toate sistemele de stocare sunt gestionate și monitorizate la distanță - așa a fost cu mulți ani în urmă. Astăzi vreau să discut despre altceva, și anume metrocaste.
Metrocastele nu sunt deloc o noutate pe piață, dar tocmai din această cauză nu sunt foarte populare - se face simțită inerția gândirii și primele impresii. Desigur, acum 10 ani existau deja, dar costul lor era exorbitant. Anii care au trecut de la primele metrocaste au schimbat industria și accesibilitatea tehnologiei pentru publicul larg.
Îmi amintesc proiecte în care părțile sistemului de stocare erau distribuite separat - unele pentru servicii extrem de critice în clusterul metropolitan, altele pentru replicare sincronă (de câteva ori mai ieftină).
De fapt, în 2020, clusterul metropolitan nu vă costă nimic, dacă reușiți să organizați două locații și canale. Iar canalele pentru replicarea sincronă sunt exact aceleași ca și pentru clusterele metropolitane. Licențierea software-ului este deja realizată în pachete - iar replicarea sincronă vine direct cu clusterul metropolitan, iar singurul lucru care păstrează viața replicării unidirecționale este nevoie de organizarea unei rețele L2 extinse. Și chiar și așa, L2 peste L3 avansează deja în întreaga țară.
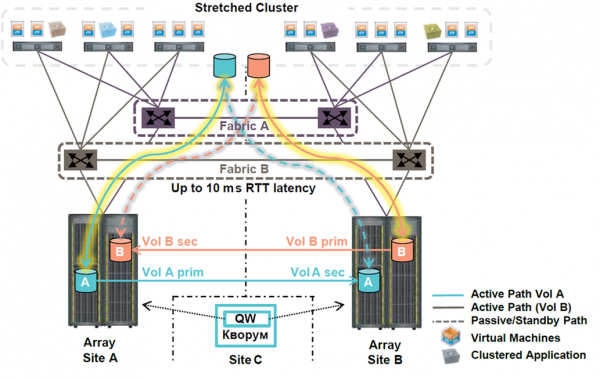
Care este, așadar, diferența principală între replicarea sincronă și clusterul metropolitan din perspectiva muncii la distanță?
Totul este foarte simplu. Clusterul metropolitan funcționează singur, automat, întotdeauna, aproape imediat.
Cum arată procesul de transfer al sarcinii în replicarea sincronă pe o infrastructură cu câteva sute de mașini virtuale?
- Se primește un semnal de avarie.
- Schimbul de urgență analizează situația - se pot aloca cu ușurință între 10 și 30 de minute doar pentru a primi semnalul și a lua o decizie.
- În cazul în care inginerii de urgență nu au autoritate pentru a începe în mod independent transferul - încă 30 de minute pentru a lua legătura cu persoana care are autoritatea și a confirma formal începutul transferului.
- Apăsarea Marei Buton Roșu.
- 10-15 minute pentru timeout-uri și reconfigurarea volumelor, reinscrierea mașinilor virtuale.
- 30 de minute pentru schimbarea adresării IP - o estimare optimistă.
- Și în cele din urmă, pornirea mașinilor virtuale și activarea serviciilor productive.
Așadar, RTO (timpul până la recuperarea proceselor de afaceri) poate fi evaluat fără îndoială la 4 ore.
Să comparăm cu situația din clusterul metropolitan.
- Sistemul de stocare înțelege că legătura cu brațul clusterului metropolitan a fost pierdută - 15-30 de secunde.
- Serverele de virtualizare înțeleg că primul centru de date a fost pierdut - 15-30 de secunde (simultan cu punctul 1).
- Repornirea automată a jumătate până la o treime din mașinile virtuale în al doilea centru de date - 10-15 minute până la încărcarea serviciilor.
- Aproximativ în acest timp, echipa de urgență înțelege ce s-a întâmplat.
Prin urmare: RTO = 0 pentru servicii individuale, 10-15 minute în cazul general.
De ce repornirea este doar pentru jumătate până la o treime din mașinile virtuale? Iată despre ce este vorba:
- Voi faceți totul inteligent și activați balansarea automată a VM-urilor. Ca urmare, în medie, doar jumătate din VM-uri sunt operate într-unul dintre centrele de date. Întregul sens al metroklastrelor este de a minimiza timpii de nefuncționare, iar, prin urmare, este în interesul dumneavoastră să minimizați și numărul de VM-uri expuse riscurilor.
- Unele servicii pot fi clusterizate la nivelul aplicației, fiind distribuite pe VM-uri diferite. Astfel, aceste VM-uri pereche sunt fixate cu cuie sau legate cu panglici de centre de date diferite, astfel încât serviciul să nu aștepte repornirea VM-ului în caz de avarie.
Cu o infrastructură bine construită și metroklastre extinse, utilizatorii de afaceri lucrează cu întârzieri minime din orice punct, chiar și în cazul unei avarii la nivelul centrului de date. În cel mai rău caz, întârzierea va fi echivalentă cu timpul necesar pentru a savura o ceașcă de cafea.
Și, desigur, metroklastrele funcționează excelent atât cu sistemele HPE 3Par care ies din producție, cât și cu cele noi, Primera!
Infrastructura locurilor de muncă la distanță
Servere terminale
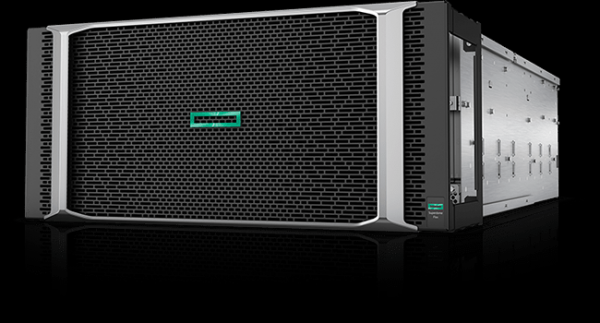
Nu este nevoie să inventați ceva nou pentru serverele terminale; de mulți ani, HPE furnizează unele dintre cele mai bune servere din lume pentru acestea. Clasicul care rămâne întotdeauna relevant — DL360 (1U) sau DL380 (2U) sau, pentru iubitorii de AMD — DL385. Desigur, există și servere blade, atât clasicile C7000, cât și noua platformă modulară Synergy.
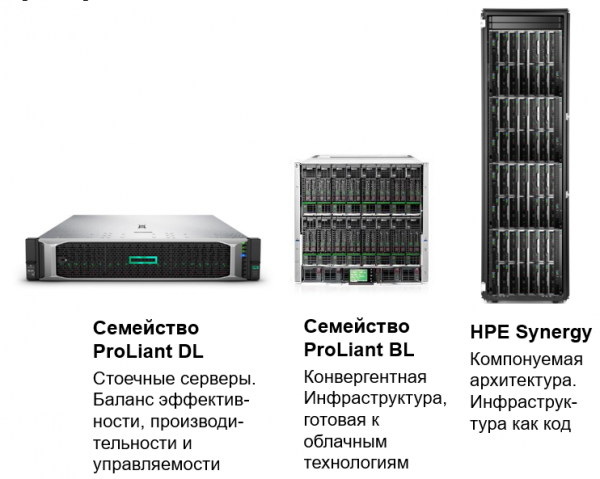
Pe gustul tuturor, în orice culoare, maxim de sesiuni pe server!
“VDI clasic” + HPE Simplivity
Prin „VDI clasic” mă refer la conceptul 1 utilizator = 1 VM cu Windows client. Și, bineînțeles, nu există o încărcare VDI mai apropiată și familiară pentru sistemele hiperconvergente, cu atât mai mult cu cât beneficiază de deduplicare și compresie.
Aici, HPE poate oferi atât platforma sa hiperconvergentă, Simplivity, cât și servere/noduri certificate pentru soluțiile partenerilor, cum ar fi VSAN Ready Nodes pentru construirea VDI pe infrastructura VMware VSAN.
Să discutăm puțin mai mult despre soluția noastră, Simplivity. În centrul acesteia, așa cum ne sugerează delicat numele, se află simplitatea (în engleză, simple — simplu). Simplitatea desfășurării, simplitatea gestionării, simplitatea scalării.
Sistemele hiperconvergente sunt astăzi unul dintre cele mai discutate subiecte în IT, iar numărul furnizorilor de diferite dimensiuni se ridică la aproximativ 40. Conform matricei magice Gartner, compania HPE se află în top 5 global și intră în pătratul liderilor - cei care înțeleg încotro se îndreaptă industria și sunt capabili să transpună această înțelegere în hardware.
Din punct de vedere arhitectural, Simplivity este un sistem hiperconvergent clasic cu mașini virtuale de control, ceea ce înseamnă că poate susține diferite hypervisoare, spre deosebire de sistemele integrate în hypervisor. Iar, într-adevăr, în aprilie 2020, sunt susținute VMware vSphere și Microsoft Hyper-V, iar planurile de susținere pentru KVM au fost anunțate. Inovația cheie a Simplivity de la lansarea sa pe piață a fost accelerarea hardware-ului pentru compresie și deduplicare cu ajutorul unei plăci speciale de accelerare.
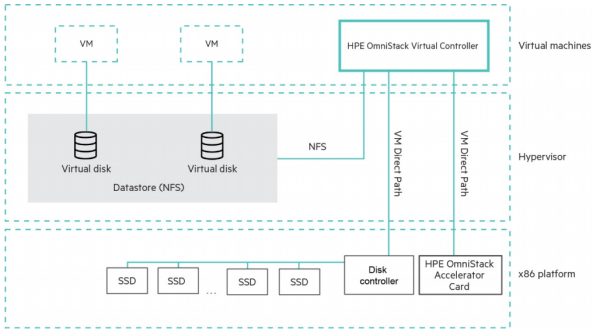
Este important de menționat că compresia și deduplicarea sunt globale și întotdeauna activate, deci nu este o caracteristică opțională, ci arhitectura soluției.
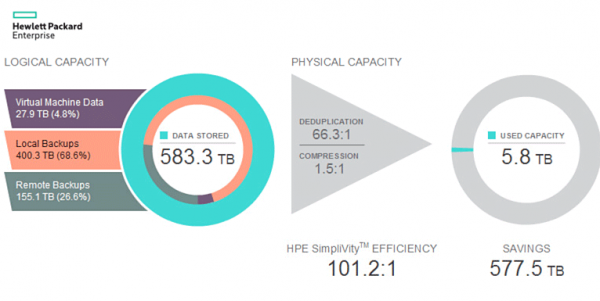
HPE, desigur, exagerează puțin, afirmând o eficiență de 100:1, calculată într-un mod special, dar eficiența utilizării spațiului este într-adevăr foarte ridicată. Numărul 100:1 este pur și simplu prea atrăgător. Să analizăm cum este implementată tehnic Simplivity pentru a putea susține astfel de cifre.
Snapshot. Instantaneele (snapshots) sunt implementate 100% corect ca RoW (Redirect-on-Write), prin urmare se realizează instantaneu și nu aduc penalizări de performanță. Acestea diferă, de exemplu, de unele alte sisteme. De ce avem nevoie de instantanee locale fără penalizări? Foarte simplu, pentru a reduce RPO de la 24 de ore (RPO mediu pentru backup) la zeci sau chiar la câteva minute.
Backup. Instantaneele se deosebesc de backup doar prin modul în care sunt percepute de sistemul de gestionare a mașinilor virtuale. Dacă la ștergerea mașinii este șters și tot restul - înseamnă că a fost o instantanee. Dacă a rămas - înseamnă că este un backup. Astfel, orice instantanee poate fi considerată și un backup complet, dacă este marcată în sistem și nu este ștearsă.
Desigur, mulți vor obiecta — ce fel de backup este acesta dacă este stocat pe aceeași sistem? Răspunsul la această întrebare este foarte simplu: spuneți, aveți un model formal de amenințări care stabilește reguli pentru stocarea copiilor de rezervă? Acesta este un backup absolut legitim împotriva ștergerii fișierelor din VM, este un backup împotriva ștergerii VM-ului însuși. În cazul în care este necesară stocarea unei copii de rezervă exclusiv pe un sistem separată, există opțiuni: replicarea acestui snapshot pe un al doilea cluster Simplivity sau pe HPE StoreOnce.
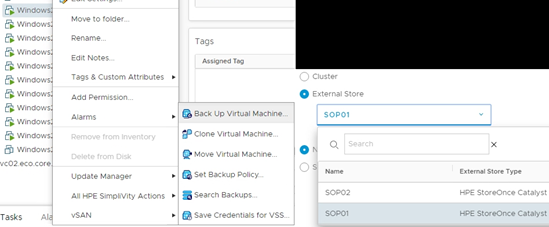
Și aici descoperim că o astfel de arhitectură se potrivește perfect pentru orice tip de VDI. VDI reprezintă sute sau chiar mii de mașini extrem de asemănătoare, cu același sistem de operare, cu aceleași aplicații. Deduplicarea globală poate procesa și compresa totul, poate chiar mai bine de 100:1. Să desfaci 1000 de VM-uri dintr-un singur template? Nu este deloc o problemă, aceste mașini se vor înregistra în vCenter mai lent decât se pot clona.
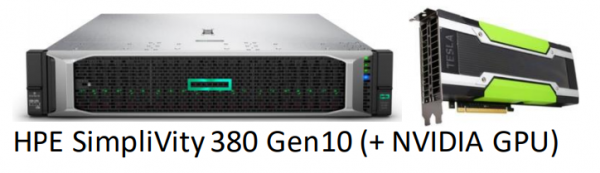
Special pentru utilizatorii cu cerințe de performanță speciale și pentru cei care au nevoie de acceleratoare 3D, a fost creată gama Simplivity G.
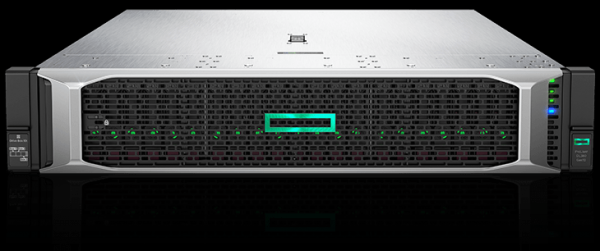
În această serie nu se folosește un accelerator hardware pentru deduplicare, astfel că numărul de discuri pe nod a fost redus, permițând controlerului să funcționeze software. Astfel, se eliberează sloturi PCIe pentru orice alte acceleratoare. De asemenea, volumul de memorie disponibil pe nod a fost dublat până la 3TB pentru cele mai exigeante sarcini de lucru.
Simplivity este perfect adaptat pentru organizarea infrastructurilor VDI distribuite geografic, cu replicarea datelor în centrul de date central.
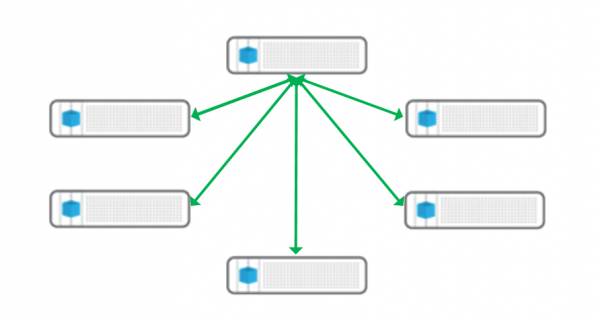
O astfel de arhitectură VDI (iar nu doar VDI) este deosebit de interesantă în condițiile actuale din Rusia — distanțe uriașe (și, prin urmare, întârzieri) și canale de comunicare departe de ideale. Se creează centre regionale (chiar și doar 1-2 noduri Simplivity într-un birou îndepărtat), la care se conectează utilizatori locali prin canale rapide, păstrându-se controlul și gestionarea completă din centru, iar în centru se replică doar o cantitate nesemnificativă de date reale, valoroase, nu de gunoi.
Desigur, Simplivity se conectează complet la OneView și InfoSight.
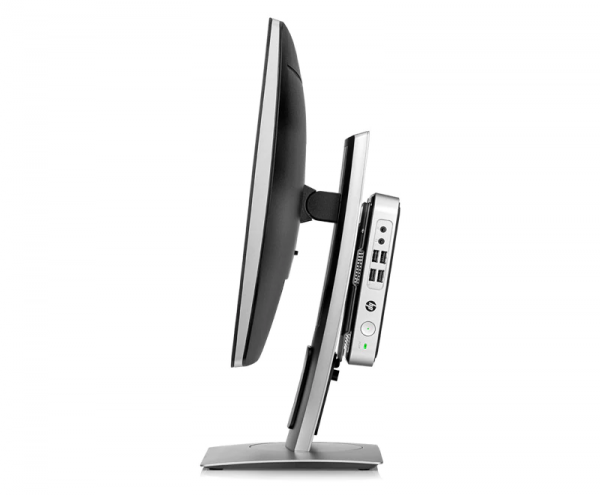
Clienți subțiri și zero
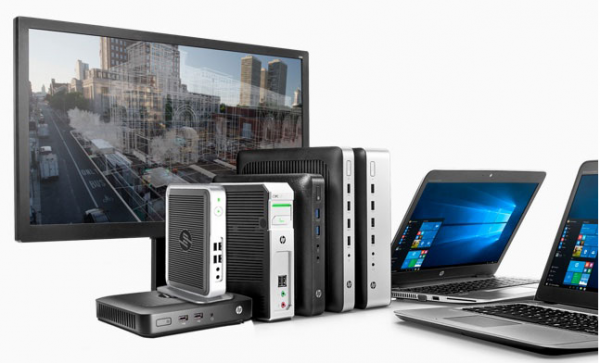
Clienții subțiri sunt soluții specializate destinate exclusiv utilizării ca terminale. Deoarece pe client nu există practic nicio sarcină, cu excepția menținerii canalului și decodificării video, de cele mai multe ori este dotat cu un procesor cu răcire pasivă, un disc de boot mic, doar pentru a porni un sistem de operare încorporat special, și atât. Practic, nu există nimic care să se defecteze, iar furarea este inutilă. Costul este redus și nu se păstrează date în acesta.
Există o categorie specială de clienți subțiri, așa-numitele clienți zero. Principala lor diferență față de clienții subțiri este absența chiar și a unui sistem de operare încorporat de uz general, lucrând exclusiv cu un microchip cu firmware. De multe ori sunt echipați cu acceleratoare hardware speciale pentru decodificarea fluxului video în protocoalele terminale, precum PCoIP sau HDX.
În ciuda separării marelui „Hewlett Packard” în HPE și HP, nu pot să nu menționez clienții subțiri produși de HP.
Selectia este variată, pentru orice gust și nevoie — inclusiv stații de lucru cu mai multe monitoare, cu accelerare hardware a fluxului video.
Serviciul HPE pentru munca dumneavoastră remote
Și în ultimul rând, dar nu ca importanță, vreau să menționez serviciul HPE. Ar fi prea lung să enumerăm toate nivelurile de servicii HPE și capabilitățile acestora, dar există în mod cert o ofertă extrem de importantă în condițiile muncii de la distanță. Mai precis — un inginer de servicii de la HPE/centru de servicii autorizat. Puteți continua să lucrați remote, din grădina preferată, ascultând zumzetul albinelor, în timp ce un specialist de la HPE, ajungând în data center, înlocuiește hard diskurile sau sursa de alimentare defectă în serverele dumneavoastră.
HPE CallHome
În condițiile zilelor de azi, cu restricții de deplasare, funcția Call Home devine mai relevantă ca niciodată. Orice sistem HPE dotat cu această funcție poate comunica de unul singur despre o defecțiune hardware sau software către centrul de suport HPE. Este foarte probabil ca piesa de schimb și/sau inginerul de servicii să sosească la dumneavoastră cu mult înainte de a observa problemele și deficiențele cu serviciile productive.
Personal, recomand cu tărie activarea acestei funcții.
Sursa: habr.com
