

Directorul de operare al portalului Banki.ru, Andrei Nikolsky, a vorbit la conferința de anul trecut despre serviciile orfane: cum să identifici o orphan în infrastructură, de ce sunt proaste serviciile orfane, ce să faci cu ele și ce să faci dacă nimic nu ajută.
În secțiune, versiunea textuală a raportului.
Bună ziua, colegi! Mă numesc Andrei, conduc operarea în compania Banki.ru.
Avem servicii mari, cum ar fi monolitice, avem servicii într-o înțelegere mai clasică, avem servicii foarte mici. În terminologia mea de zi cu zi, spun că dacă un serviciu este simplu și mic, atunci este un microserviciu, iar dacă nu este foarte simplu și nu este mic, atunci este pur și simplu un serviciu.
Avantajele serviciilor
Voi trece rapid prin avantajele serviciilor.
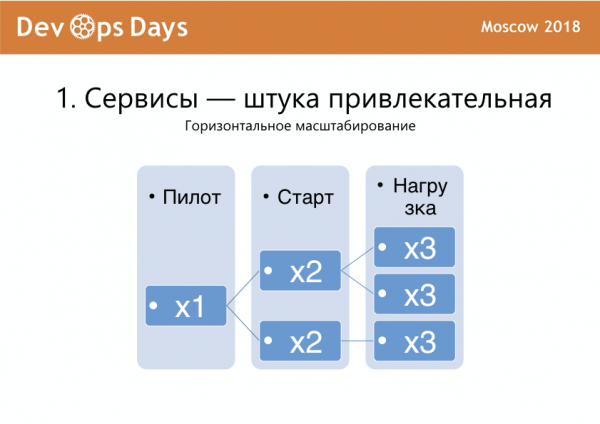
Primul - scalabilitatea. Puteți face rapid ceva pe serviciu și să începeți în producție. A venit traficul, ați clonat serviciul. A venit din nou trafic, ați clonat din nou și trăiți cu asta. Este un bonus bun și, de fapt, când am început, acesta era considerat cel mai important motiv pentru care facem toate aceste lucruri.
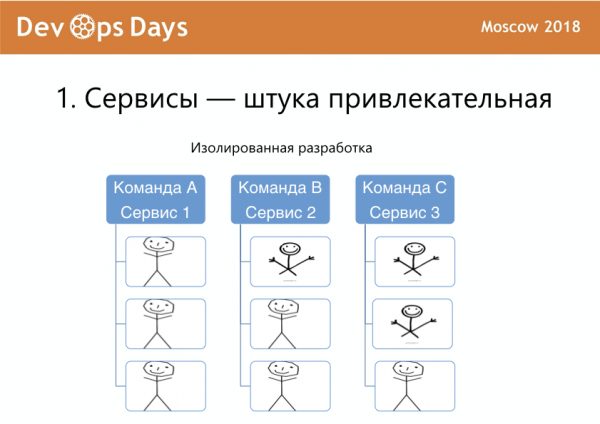
În al doilea rând, dezvoltarea izolată, când aveți mai multe echipe de dezvoltare, mai mulți dezvoltatori diferiți în fiecare echipă și fiecare echipă lucrează la un serviciu al său.
Există o nuanță cu echipele. Dezvoltatorii sunt diferiți. Și există, de exemplu, . Am văzut asta prima dată la Maxim Dorofeev. Uneori, oamenii-zăpadă sunt în unele echipe, iar în altele nu sunt. Acest lucru face ca serviciile utilizate în companie să fie puțin inegale.
Privind imaginea: acesta este un bun dezvoltator, are mâini mari, poate face multe. Problema principală este de unde cresc aceste mâini.
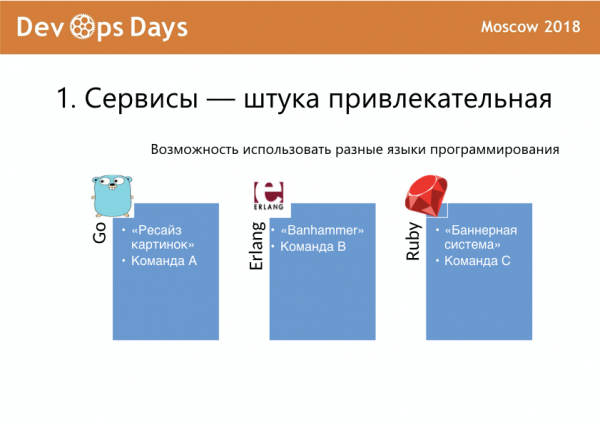
Serviciile oferă posibilitatea de a folosi diferite limbaje de programare, mai potrivite pentru diferite sarcini. Un serviciu este pe Go, altul pe Erlang, altul pe Ruby, ceva pe PHP, ceva pe Python. În general, se poate extinde foarte mult. Aici sunt și nuanțe.
Arhitectura orientată pe servicii este înainte de toate despre devops. Asta înseamnă că dacă nu aveți automatizare, nu aveți un proces de deploy, dacă configurați manual, configurațiile pot varia de la un instanță de serviciu la alta și trebuie să intrați acolo să faceți ceva, atunci sunteți în iad.
De exemplu, aveți 20 de servicii și trebuie să le desfășurați manual, aveți 20 de console și apăsați simultan „enter”, ca niște ninja. Asta nu este prea bine.
Dacă aveți un serviciu după testare (dacă există testare, desigur) și trebuie să-l mai ajustați ca să funcționeze în producție, am și pentru voi vești proaste.
Dacă depindeți de servicii specifice de la Amazon și lucrați în Rusia, atunci acum două luni aveți și voi „Totul în jur arde, sunt bine, totul e grozav.”
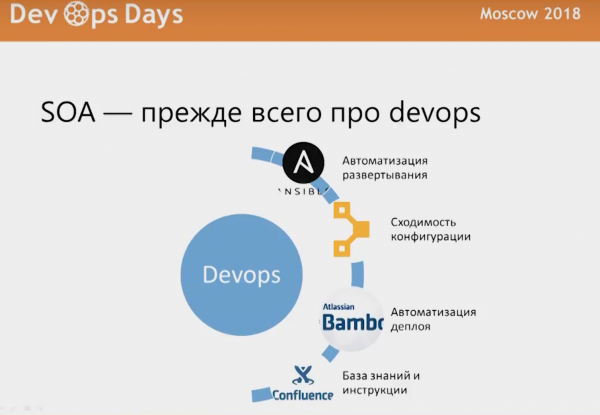
Folosim Ansible pentru automatizarea desfășurării, Puppet pentru convergență, Bamboo pentru automatizarea desfășurării, Confluence pentru a documenta toate acestea cumva.
Nu voi detalia acest aspect, deoarece prezentarea este mai degrabă despre practicile de interacțiune, nu despre implementarea tehnică.
Am avut, de exemplu, probleme în care Puppet pe server rulează cu Ruby 2, iar o aplicație este scrisă pentru Ruby 1.8 și nu funcționează împreună. Se întâmplă o mică eroare acolo. Şi când trebuie să păstrați mai multe versiuni de Ruby pe aceeași mașină, în general apar probleme.
De exemplu, fiecare dezvoltator primește o platformă care are aproape tot ceea ce avem, toate serviciile pe care le putem dezvolta, astfel încât acesta să aibă un mediu izolat, în care să-l poată distruge și construi cum dorește.
Uneori, este necesar un pachet special compilat cu suport pentru anumite funcționalități. Este destul de strict. Am ascultat o prezentare unde imaginea Docker cântărea 45 GB. În Linux, desigur, e mai simplu, acolo totul e mai mic, dar oricum, nu vor fi suficiente resurse.
Și există dependențe contradictorii, când o parte a proiectului depinde de o bibliotecă într-o anumită versiune, altă parte a proiectului depinde de o altă versiune și bibliotecile nu se instalează împreună deloc.
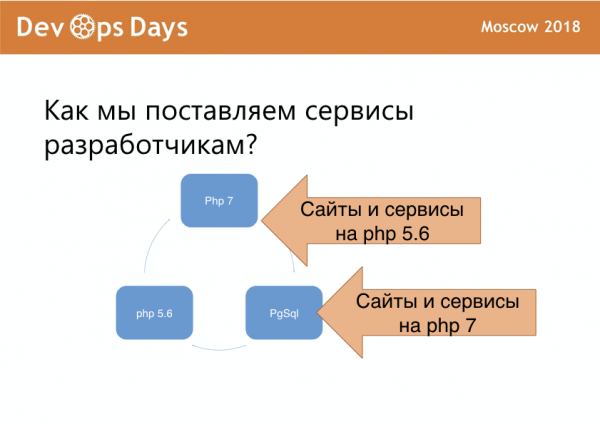
Avem site-uri și servicii pe PHP 5.6, ne e rușine pentru ele, dar ce putem face. Aceasta este o platformă pentru noi. Avem mai multe site-uri și servicii pe PHP 7, pentru care nu ne e rușine. Și fiecare dezvoltator are baza lui, unde se bucură că poate lucra.
Dacă scrieți în companie într-o singură limbă, atunci trei mașini virtuale per dezvoltator sună normal. Dacă aveți diferite limbaje de programare, atunci situația devine mai complicată.
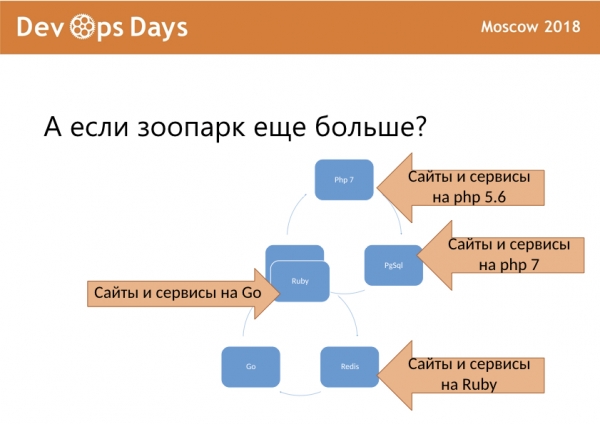
Apare site-uri și servicii pe acest, pe acest, apoi încă o platformă pentru Go, o platformă pentru Ruby, și un Redis pe lângă. În cele din urmă, totul se transformă într-un mare domeniu de suport, iar tot timpul ceva poate să cedeze.
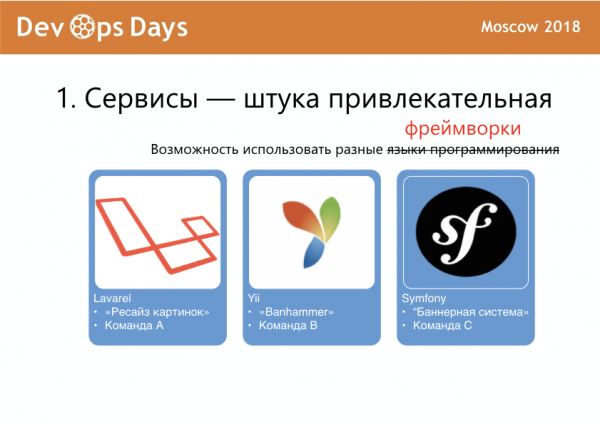
De aceea, am înlocuit avantajele limbajelor de programare cu utilizarea diferitelor framework-uri, deoarece framework-urile PHP sunt destul de variate, fiecare având capacități diferite, comunități diferite, suport diferit. Astfel, poți scrie un serviciu astfel încât să ai deja ceva pregătit pentru el.
Fiecare serviciu are echipa sa
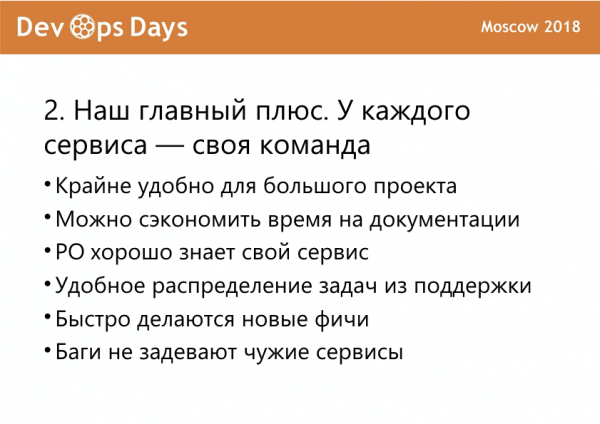
Principalul nostru avantaj, care s-a cristalizat de-a lungul anilor, este că fiecare serviciu are echipa sa. Acest lucru este convenabil pentru un proiect mare, poți economisi timp pe documentație, iar managerii cunosc bine proiectul lor.
Sarcinile de suport pot fi delegat cu ușurință. De exemplu, dacă serviciul de asigurare s-a stricat. Și imediat echipa care se ocupă cu asigurările merge să repare.
Funcțiile noi sunt realizate rapid, deoarece atunci când ai un anumit serviciu atomic, poți să încorporezi rapid ceva.
Și când ți-ai stricat serviciul, iar asta se întâmplă inevitabil, nu ai afectat celelalte servicii, și dezvoltatorii din alte echipe nu vin să-ți spună: „Ooo, nu fă așa”.
Ca întotdeauna, există nuanțe. Avem echipe stabile, managerii sunt aduși strâns de echipă. Există documente clare, managerii monitorizează totul. Fiecare echipă are câteva servicii împreună cu managerul, și există un punct specific de competență.
Dacă echipele sunt flotante (acest lucru este folosit uneori și la noi), există o metodă bună numită „hartă stea”.
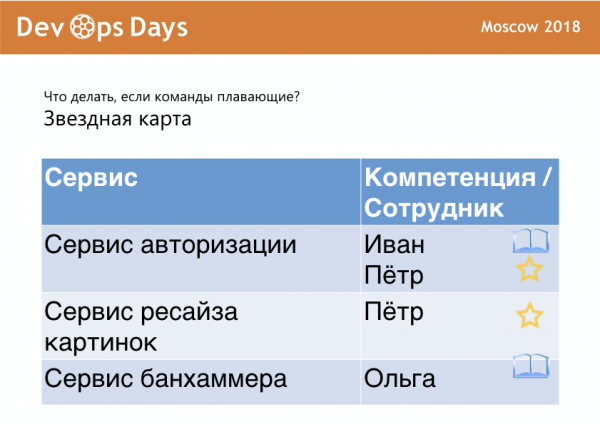
Ai o listă de servicii și oameni. Steaua înseamnă că persoana este expert în acest serviciu, iar culegerea indică că persoana studiază acest serviciu. Sarcina persoanei este să schimbe culegerea cu o stea. Iar dacă nimic nu este scris în fața serviciului, încep problemele, despre care voi vorbi mai departe.
Cum apar serviciile orfane?
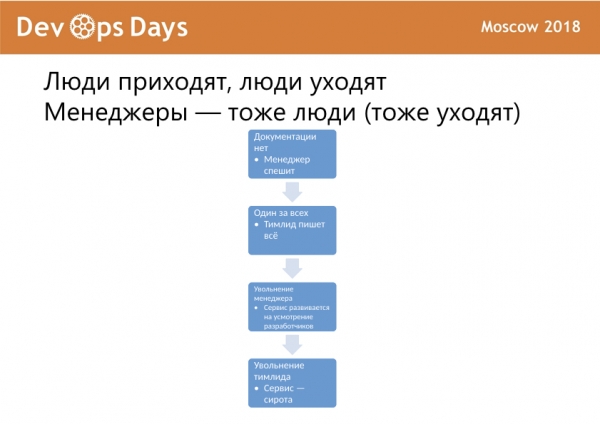
Primul inconvenient, primul mod de a avea un serviciu orfan în infrastructura ta este prin concedierea angajaților. A avut cineva vreodată o situație în care termenele vin înainte de a evalua sarcinile? Uneori se întâmplă ca termenii să fie stricte și să nu fie suficient timp pentru documentație. „Trebuie să predăm serviciul în producție, apoi vom completa detaliile.”
Dacă echipa este mică, poate exista un singur dezvoltator care scrie tot, ceilalți fiind doar de sprijin. „Am realizat arhitectura principală, tu scrie interfețele.” Apoi, într-un anumit moment, managerul pleacă. Și în perioada în care managerul s-a dus și unul nou nu a fost încă numit, dezvoltatorii decid singuri în ce direcție se îndreaptă serviciul și ce se întâmplă. Și cum știm (să ne întoarcem câteva slide-uri înapoi), în unele echipe există persoane unice, uneori un lider unic. Apoi acesta pleacă și obținem un serviciu orfan.
Între timp, sarcinile din suport și din afacere nu dispar nicăieri, ele se acumulează în backlog. Dacă în timpul dezvoltării serviciului au existat erori arhitecturale, acestea se acumulează de asemenea în backlog. Serviciul se degradează încet.
Cum recunoaștem un orfan?
Această listă descrie bine situația. Cine s-a recunoscut în infrastructura sa?
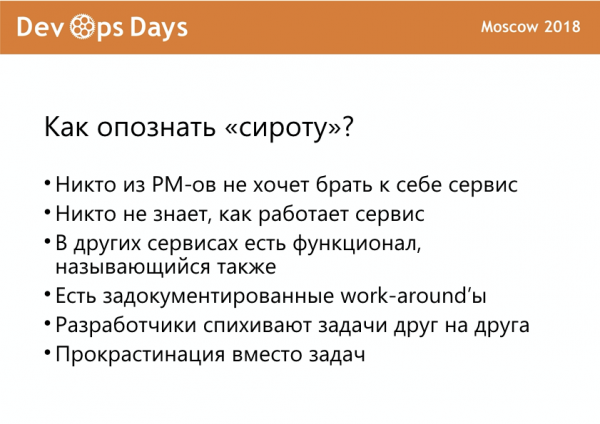
Despre soluțiile workaround documentate: există un serviciu și, în general, funcționează, are un manual de două pagini despre cum să lucrezi cu el, dar cum funcționează în interior, nimeni nu știe.
Sau, de exemplu, există un scurtător de linkuri. La noi, de exemplu, acum sunt utilizate trei scurtătoare de linkuri pentru scopuri diferite în servicii diferite. Acestea sunt consecințele.
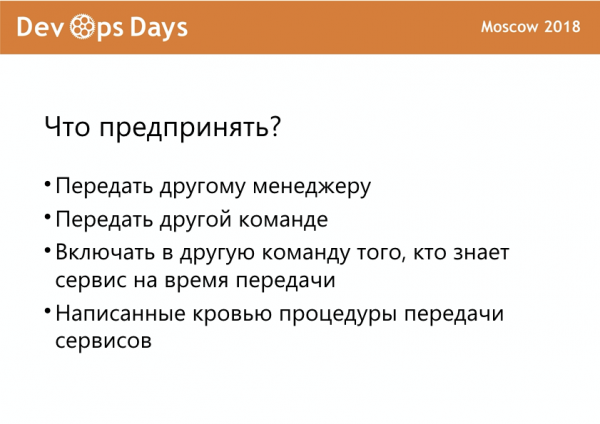
Acum voi deveni căpitanul evidentului. Ce trebuie să facem? În primul rând, trebuie să predăm serviciul unui alt manager, unei alte echipe. Dacă liderul vostru nu a plecat încă, atunci în această altă echipă, când înțelegeți că serviciul seamănă cu un orfan, trebuie să includeți pe cineva care știe măcar ceva despre el.
Cel mai important lucru: trebuie să aveți proceduri de predare bine definite. În cazul nostru, eu sunt de obicei cel care urmărește acest lucru, pentru că am nevoie să funcționeze totul. Managerii trebuie să aibă totul predat rapid, iar ce se va întâmpla cu el mai târziu nu este atât de important pentru ei.
Următoarea modalitate de a face o aplicație „Să facem externalizare, va fi mai rapid, iar apoi o vom preda echipei”. Este clar că toți au planuri în echipă, o ordine. De multe ori, clientul de afaceri crede că un externalizator va face totul la fel ca departamentul tehnic din companie. Cu toate acestea, motivațiile lor sunt diferite. La externalizare pot exista soluții tehnologice bizare și algoritmi neobișnuiți.
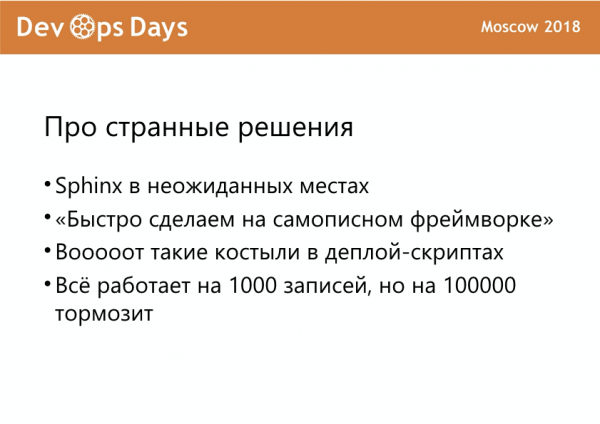
De exemplu, am avut un serviciu în care Sphinx se găsea în locuri neașteptate. Voi povesti mai târziu ce a trebuit să facem.
Externalizatorii au uneori framework-uri proprii. Este pur și simplu PHP brut cu copiat și lipit din proiectul anterior, unde poți găsi de toate. Costuri mari în scripturile de deploy, când trebuie să schimbi câteva linii dintr-un fișier folosind scripturi Bash complicate, aceste scripturi de deploy fiind apelate de un alt script. În final, schimbi sistemul de deploy, alegi ceva diferit, și hop, serviciul tău nu mai funcționează. Pentru că trebuiau adăugate încă 8 linkuri între diferite foldere. Sau se poate întâmpla că o mie de înregistrări funcționează, iar o sută de mii deja nu.
Voi continua să coordonez. Acceptarea serviciului din externalizare este o procedură obligatorie. A avut cineva experiența în care un serviciu din externalizare ajunge, dar nu este acceptat nicăieri? Nu este atât de popular, desigur, ca aplicația orphan, dar totuși.
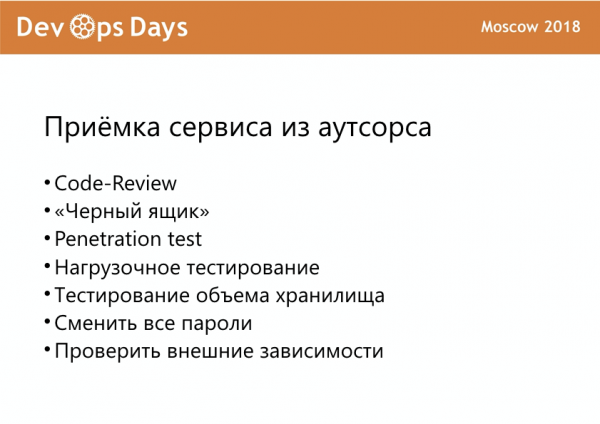
Serviciul trebuie verificat, trebuie revizuit, trebuie schimbate parolele. Am avut un caz în care ne-au trecut un serviciu, iar în panoul de administrare era „if login == ‘admin’ && password == ‘admin’…”, scris chiar în cod. Stăm și ne gândim, și asta scriu oamenii în 2018?
Testarea capacității de stocare este, de asemenea, o chestiune necesară. Trebuie să vezi ce se va întâmpla cu o sută de mii de înregistrări, înainte de a lansa acest serviciu în producție.
Nu ar trebui să-ți fie rușine să trimiți serviciul pentru îmbunătățiri. Când spui: „Nu vom accepta acest serviciu, avem 20 de sarcini, faceți-le, apoi acceptăm”, este normal. Conștiința nu ar trebui să te frământe că pui managerul într-o situație neplăcută sau că afacerea va cheltui bani. Apoi, afacerea va cheltui mai mult.
Am avut un caz când am decis să facem un proiect pilot la externalizare.
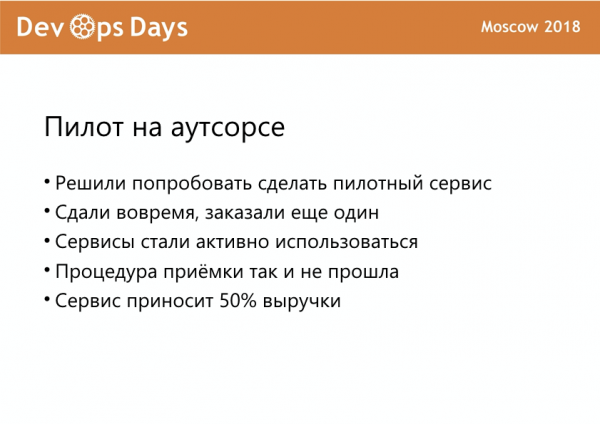
A fost predat la timp, iar acesta a fost singurul criteriu de calitate. Prin urmare, s-a realizat un alt proiect pilot, care nu mai era chiar un pilot. Aceste servicii au fost acceptate, au fost date administrativ, uite codul vostru, uite echipa, uite managerul vostru. Serviciile au început deja să genereze profit. Cu toate acestea, ele au rămas în continuare orfane, nimeni nu înțelege cum funcționează, iar managerii se străduiesc să se dezică de sarcinile lor.
Există un alt concept excelent — dezvoltarea de tip partizan. Când un anumit departament, de regulă, departamentul de marketing, dorește să testeze o ipoteză și comandă un serviciu complet în externalizare. Încep să curgă trafic pe el, închid documentele, semnează actele cu contractorul, intră în exploatare și spun: „Băieți, avem un serviciu aici, pe el deja există trafic, ne aduce bani, haideți să-l acceptăm!”. Noi suntem: „Wow, cum așa?”.
Și încă un mod de a obține un serviciu-orfan: când o echipă se află brusc suprasolicitată, conducerea spune: „Hai să transferăm serviciul acestei echipe către o altă echipă, care are o încărcare mai mică”. Apoi îl transferăm unei a treia echipe și schimbăm managerul. Și, în final, avem din nou un orfan.
Care este problema cu orfanii?
Cine nu știe, acesta este nava liniară Wasa, ridicată în Suedia, celebră pentru faptul că s-a scufundat la numai 5 minute după lansarea pe apă. Și regele Suediei, de altfel, nu a pedepsit pe nimeni pentru asta. A fost construită de două generații de ingineri care nu știau să construiască astfel de nave. Efectul este previzibil.
Nava ar fi putut să se scufunde, de altfel, mult mai rău, de exemplu, când la bord se îndrepta regele undeva într-o furtună. Dar, în acest fel, s-a scufundat imediat, conform agilității, asta este bine — eșec devreme.
Dacă am eșuat devreme, de obicei nu sunt probleme. De exemplu, la recepție, am trimis-o pentru refacere. Dar dacă am eșuat deja în producție, când s-au investit bani, atunci pot apărea probleme. Consecințele, așa cum le numesc în afaceri.
Ce este periculos în cazul serviciilor-orfane:
- Serviciul se poate defecta brusc.
- Serviciul se repară mult timp sau nu se repară deloc.
- Probleme de securitate.
- Probleme cu modificările și actualizările.
- Dacă un serviciu important se defectează, afectează reputația companiei.
Ce să facem cu serviciile-orfane?
Repet încă o dată ce trebuie făcut. În primul rând, trebuie să existe documentație. 7 ani la Banki.ru m-au învățat că testerii nu ar trebui să creadă pe cuvânt dezvoltatorii, iar exploatarea nu ar trebui să creadă pe cuvânt pe nimeni. Trebuie să verificăm.
În al doilea rând, trebuie să redactăm scheme de interacțiune, deoarece se întâmplă ca serviciile, care nu sunt foarte bine primite, să conțină dependențe despre care nimeni nu a spus nimic. De exemplu, dezvoltatorii au configurat serviciul pe cheia lor pentru anumite servicii, cum ar fi Yandex.Maps sau Dadata. Dacă ați atins limita gratuită, totul se strică și nu știți ce s-a întâmplat. Toate aceste capcane trebuie să fie descrise: în serviciu se folosește Dadata, Sms, altceva.
În al treilea rând, lucrul cu datoriile tehnice. Când faceți anumite prostii sau acceptați un serviciu și spuneți că trebuie să faceți ceva, trebuie să urmăriți ca aceste lucruri să fie realizate. Pentru că mai târziu poate să se dovedească că o mică groapă nu este atât de mică și veți cădea în ea.
Cu sarcinile arhitecturale am avut o istorie legată de Sphinx. În unul dintre serviciile noastre, Sphinx era folosit pentru a introduce liste. Pur și simplu o listă cu paginare, dar în același timp se reindexa în fiecare noapte. Era construit din două indexuri: unul era reindexat în fiecare noapte și exista și un index mic care era atașat la acesta. În fiecare zi, cu o probabilitate de 50%, fie explodează, fie nu, la implementare indexul se strica și știrile noastre nu se mai actualizau pe pagina principală. La început, durea 5 minute, cât se reindexa indexul, apoi indexul a crescut, iar într-un anumit moment a început să se reindexeze timp de 40 de minute. Când am eliminat acest lucru, am respirat ușurați, pentru că era evident că va mai trece puțin timp și avem un index care se va reindexa toată ziua de lucru. Acesta ar fi un eșec pentru portalul nostru, opt ore fără știri — totul, afacerea s-a oprit.
Planul de lucru cu serviciul orfan
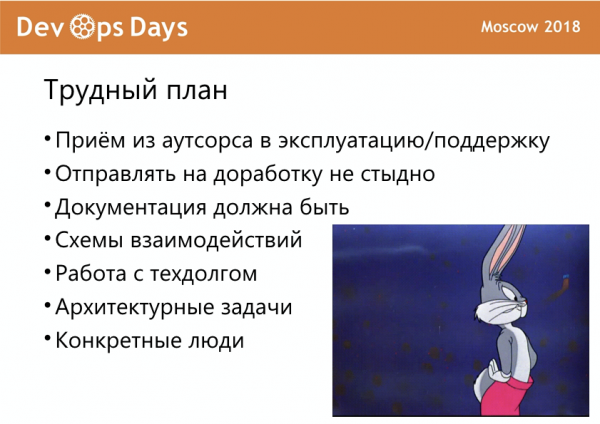
De fapt, este foarte greu de realizat, pentru că devops-ul este despre comunicare. Vrei să ai relații bune cu colegii tăi, dar când lovești colegii și managerii cu reglementări în cap, ei pot avea sentimente contradictorii față de persoanele care fac acest lucru.
Pe lângă toate aceste puncte, mai există încă un aspect important: pentru fiecare serviciu specific, pentru fiecare etapă a procesului de implementare, trebuie să existe oameni responsabili. Când oamenii lipsesc și trebuie să implicăm alte persoane, care trebuie să învețe tot acest proces, devine dificil.
Dacă nimic din toate acestea nu a ajutat și serviciul orfan a rămas orfan, iar nimeni nu vrea să îl preia, documentația nu este scrisă, echipa care a fost chemată la acest serviciu refuză să facă ceva, există o soluție simplă — refacă totul.
Adică iei cerințele pentru serviciu din nou și scrii un nou serviciu, mai bun, pe o platformă mai bună, fără soluții tehnologice stranii. Și migrezi pe el în producție.
Am avut o situație când am preluat un serviciu pe Yii 1 și ne-am dat seama că nu putem să-l dezvoltăm mai departe, deoarece ne-am epuizat dezvoltatorii care știu să lucreze bine pe Yii 1. Toți dezvoltatorii lucrează bine pe Symfony 3. Ce facem? Am alocat timp, o echipă, un manager, am rescris proiectul și am direcționat treptat traficul pe el.
După aceasta, vechiul serviciu poate fi șters. Este procedura mea favorită, când trebuie să elimin un serviciu din sistemul de gestionare a configurațiilor și apoi să mă asigur că toate instanțele în producție au fost închise, pentru a nu lăsa urme dezvoltatorilor. Repozitoriul din Git rămâne.
Asta a fost tot ce am vrut să împărtășesc, sunt gata să discut, subiectul este controversat, mulți s-au aventurat în el.
Pe slide-uri s-a vorbit despre uniformizarea limbajelor. Ca exemplu a fost redimensionarea imaginilor. Dar este cu adevărat necesar să se ajungă la un singur limbaj? Pentru că redimensionarea imaginilor în PHP, putea fi de fapt realizată și în Golang.
În realitate, acest lucru nu este necesar, ca în toate practicile. Poate, în unele cazuri, este chiar nedorit. Dar trebuie să înțelegi că, dacă ai o companie cu 50 de oameni în departamentul tehnic, din care 45 sunt PHP-iști, iar 3 sunt devops care se pricep la Python, Ansible, Puppet și alte asemenea, și doar unul dintre ei scrie un serviciu în Go pentru redimensionarea imaginilor, atunci, când pleacă, expertiza pleacă odată cu el. Și în acest context, va trebui să cauți un dezvoltator specific pe piață, care cunoaște acest limbaj, mai ales dacă este rar. Din punct de vedere organizațional, acest lucru este problematic. Din punctul de vedere al devops-ului, nu va trebui doar să clonezi un set existent de playbook-uri pe care le folosești pentru a desfășura servicii, ci va trebui să le scrii din nou.
În prezent, dezvoltăm un serviciu pe Node.js, iar acesta va fi exact locul pentru fiecare dezvoltator cu un limbaj diferit. Dar ne-am gândit și am realizat că merită. Aici este o întrebare de a te gândi și a reflecta.
Cum monitorizați serviciile voastre? Cum colectați și urmăriți jurnalele?
Jurnalele le colectăm în Elasticsearch și le plasăm în Kibana, iar în funcție de faptul că este un mediu de producție sau unul de testare, sunt folosite diferite colectoare. Undeva folosim Lumberjack, altundeva altceva, nu mai țin minte. Și mai sunt câteva locuri în anumite servicii unde instalăm Telegraf și trimitem date separate.
Cum să coexiste Puppet și Ansible într-un singur mediu?
De fapt, acum avem două medii, unul - Puppet, celălalt - Ansible. Lucrăm la îmbinarea lor. Ansible este un mediu bun pentru configurarea inițială, Puppet este o soluție mai puțin potrivită pentru configurarea inițială, deoarece necesită muncă manuală direct pe platformă, iar Puppet asigură convergența configurației. Aceasta înseamnă că platforma se menține în stare actualizată, iar pentru a menține o mașină care utilizează Ansible în stare actualizată, trebuie să rulezi playbook-uri cu o anumită periodicitate. Asta este diferența.
Cum vă mențineți compatibilitatea? Aveți configurații atât în Ansible, cât și în Puppet?
Aceasta este o mare durere pentru noi; ne menținem compatibilitatea manual și ne gândim cum să trecem de la toate acestea. Cu Puppet, instalăm pachete și menținem anumite linkuri, iar Ansible ne instalează codul și ajustează configurațiile aplicațiilor.
Prezentarea a fost despre diferite versiuni de Ruby. Care este soluția?
Ne-am confruntat cu asta într-un singur loc și trebuie să păstrăm mereu acest lucru în minte. Pur și simplu am dezactivat acea parte care funcționa pe Ruby-ul ce nu era compatibil cu aplicațiile și am păstrat-o separat.
În acest an, conferința va avea loc pe 7 decembrie la „Technopolis”. Până pe 11 noiembrie primim propuneri pentru prezentări. nouă dacă doriți să vorbiți.
Înscrierea pentru participanți este deschisă, alăturați-vă!
Sursa: habr.com
