

Noi la Badoo monitorizăm constant tehnologiile noi și evaluăm dacă merită să le utilizăm în sistemul nostru. Unul dintre aceste studii pe care dorim să-l împărtășim cu comunitatea este dedicat lui Loki — un sistem de agregare a jurnalelor.
Loki este o soluție pentru stocarea și vizualizarea jurnalelor, de asemenea, acest stack oferă un sistem flexibil pentru analiza acestora și pentru trimiterea datelor către Prometheus. În mai a fost lansată o nouă actualizare, care este activ promovată de către dezvoltatori. Ne-a interesat ce știe să facă Loki, ce oportunități oferă și în ce măsură poate fi o alternativă la ELK — stack-ul pe care îl folosim acum.
Ce este Loki
Grafana Loki este un set de componente pentru un sistem complet de gestionare a jurnalelor. Spre deosebire de alte sisteme similare, Loki se bazează pe ideea de a indexa doar metadatele jurnalelor — etichete (la fel ca în Prometheus), iar jurnalelor în sine le comprimă în blocuri separate.
,
Înainte de a trece la descrierea a ceea ce se poate face cu ajutorul lui Loki, vreau să explic ce se înțelege prin „ideea de a indexa doar metadatele”. Să comparăm abordarea lui Loki și abordarea de indexare în soluțiile tradiționale, cum ar fi Elasticsearch, pe baza unui exemplu dintr-un jurnal nginx:
172.19.0.4 - - [01/Iun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Sistemele tradiționale analizează întreaga linie, inclusiv câmpurile cu multe valori unice user_id și item_id, și păstrează totul în indici mari. Avantajul acestei abordări este că se pot efectua interogări complexe rapid, deoarece aproape toate datele sunt în indice. Însă, pentru aceasta trebuie să plătești cu faptul că indicele devine mare, ceea ce implică cerințe asupra memoriei. În cele din urmă, indicele textului complet al jurnalelor este comparabil ca dimensiune cu jurnalele în sine. Pentru a căuta rapid prin el, indicele trebuie să fie încărcat în memorie. Și cu cât sunt mai multe jurnale, cu atât indicele crește mai repede și cu atât mai multă memorie consumă.
Abordarea Loki necesită extragerea doar a datelor necesare din șiruri, a căror cantitate este mică. Astfel, obținem un index compact și putem căuta date filtrându-le după timp și după câmpurile indexate, apoi scanând restul folosind expresii regulate sau căutări de subșir. Procesul pare să nu fie cel mai rapid, dar Loki împarte interogarea în mai multe părți și le execută în paralel, procesând o cantitate mare de date într-un timp scurt. Numărul de șarde și interogările paralele în acestea sunt configurabile; astfel, cantitatea de date care poate fi procesată într-o unitate de timp depinde liniar de resursele furnizate.
Această compunere între un index rapid mare și un index mic cu permutări complete paralele permite Loki să controleze costurile sistemului. Acesta poate fi configurat și extins flexibil în conformitate cu nevoile.
Stiva Loki este compusă din trei componente: Promtail, Loki, Grafana. Promtail colectează jurnalele, le procesează și le trimite la Loki. Loki le stochează. Grafana poate interoga date din Loki și le afișa. În general, Loki poate fi folosit nu doar pentru stocarea jurnalelor și căutarea în acestea. Întreaga stivă oferă mari oportunități de procesare și analiză a datelor primite, folosind stilul Prometheus.
Descrierea procesului de instalare poate fi găsită .
Căutare în jurnale
Căutarea în jurnale se poate face în interfața specială Grafana — Explorer. Pentru interogări se folosește limbajul LogQL, foarte similar cu PromQL, folosit în Prometheus. În principiu, acesta poate fi considerat un grep distribuit.
Interfața de căutare arată astfel:
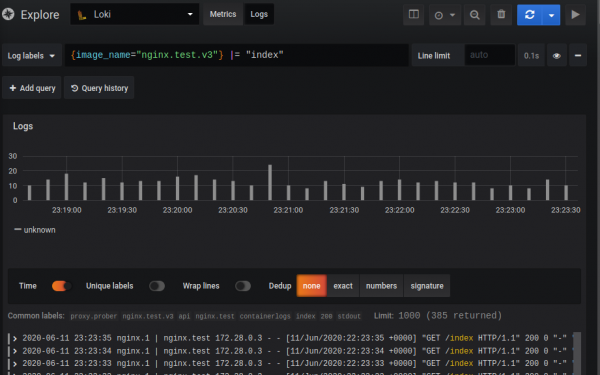
O interogare constă din două părți: selector și filtrare. Selectorul este căutarea în metadatele indexate (etichetele) atribuite jurnalele, iar filtrarea este șirul de căutare sau regexp-ul prin care se filtrează înregistrările definite de selector. În exemplul dat: în acolade — selectorul, tot ce urmează — filtrul.
{image_name="nginx.promtail.test"} |= "index"Din cauza principiului de funcționare al Loki, nu se pot efectua interogări fără selector, dar etichetele pot fi făcute extrem de generice.
Selectorul este o valoare key-value în acolade. Selectorii pot fi combinați și pot fi definite condiții diferite de căutare, utilizând operatorii =, != sau expresii regulate:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Va găsi jurnale cu eticheta instance, având valorile kafka-2, kafka-3, și va exclude dev
Filtrul este un text sau o expresie regulată care va filtra toate datele obținute de selector.
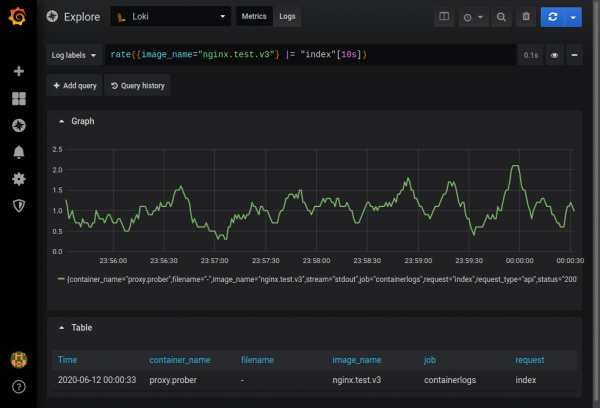
Există posibilitatea de a obține grafice ad-hoc pentru datele obținute în modul metrics. De exemplu, poți afla frecvența apariției în jurnalele nginx a înregistrării care conține șirul index:
Descrierea completă a funcționalităților se găsește în documentație .
Parsarea jurnalelor
Există mai multe modalități de a colecta jurnale:
- Prin Promtail, componenta standard a stivei pentru colectarea jurnalelor.
- Direct din containerul Docker folosind
- Folosind Fluentd sau Fluent Bit, care sunt capabile să trimită date în Loki. Spre deosebire de Promtail, acestea au parseuri gata pregătite pentru aproape orice tip de jurnal și se descurcă inclusiv cu jurnalele multiline.
De obicei, pentru parsare se folosește Promtail. Acesta face trei lucruri:
- Găsește sursele de date.
- Atașează etichete acestora.
- Trimite datele în Loki.
În prezent, Promtail poate citi jurnalele din fișiere locale și din jurnalul systemd. Trebuie instalat pe fiecare mașină de pe care se colectează jurnale.
Există o integrare cu Kubernetes: Promtail află automat prin API REST Kubernetes starea cluster-ului și colectează jurnale de pe nod, serviciu sau pod, imediat etichetând în funcție de metadatele din Kubernetes (numele podului, numele fișierului etc.).
De asemenea, este posibil să etichetezi pe baza datelor din jurnal folosind Pipeline. Pipeline-ul Promtail poate consta din patru tipuri de etape. Mai în detaliu – în , aici voi menționa câteva nuanțe.
- Etapele de parsare. Aceasta este etapa RegEx și JSON. În această etapă extragem date din jurnal în așa-numita hartă extrasă. Se poate extrage din JSON, copiind pur și simplu câmpurile necesare în harta extrasă, sau prin expresii regulate (RegEx), unde în harta extrasă “sunt mapează” grupurile denumite. Harta extrasă reprezintă un depozit key-value, unde key este numele câmpului, iar value este valoarea sa din jurnale.
- Etapele de transformare. Această etapă are două opțiuni: transform, unde stabilim reguli de transformare, și source — sursa de date pentru transformare din harta extrasă. Dacă în harta extrasă nu există acest câmp, acesta va fi creat. Astfel, se pot crea etichete care nu se bazează pe harta extrasă. În această etapă putem manipula datele în harta extrasă, folosind un . De asemenea, trebuie să ții minte că harta extrasă este încărcată complet în timpul procesării, ceea ce permite, de exemplu, verificarea valorii în aceasta: “{{if .tag}valoarea tag-ului există{end}}”. Template-ul suportă condiții, bucle și unele funcții de tip string, precum Replace și Trim.
- Etapele acțiunii. În această etapă poți face ceva cu datele extrase:
- Crează un eticheta din datele extrase, care va fi indexată de Loki.
- Modifică sau setează timpul evenimentului din jurnal.
- Modifică datele (textul jurnalului), care vor fi trimise în Loki.
- Crează metrici.
- Etapa de filtrare. Etapa de potrivire, în care poți fie să trimiți în /dev/null înregistrările de care nu avem nevoie, fie să le direcționezi pentru procesare ulterioară.
Îți voi arăta un exemplu de procesare a jurnalelor nginx obişnuite, cum poți analiza jurnalele folosind Promtail.
Pentru test, vom folosi ca nginx-proxy o imagine modificată a lui nginx jwilder/nginx-proxy:alpine și un mic demon care știe să se întrebe pe sine prin HTTP. Demonul are definite câteva endpoint-uri, la care poate oferi răspunsuri de dimensiuni diferite, cu diferite statuturi HTTP și cu diferite întârzieri.
Vom colecta jurnalele de la containerele Docker, care pot fi găsite la calea /var/lib/docker/containers//-json.log
În docker-compose.yml configurăm Promtail și indicăm calea către config:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Adăugăm în promtail.yml calea către jurnale (în config există o opțiune "docker", care face aceeași lucru într-o linie, dar aceasta nu ar fi la fel de clar):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # doar pentru linux
Când activezi această configurație, jurnalele din toate containerele vor ajunge în Loki. Pentru a evita asta, modificăm setările nginx-ului de test în docker-compose.yml — adăugăm logarea câmpului tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Modificăm promtail.yml și configurăm Pipeline. La intrare ajung jurnalele de următoarea natură:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Etapa Pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Extragem din JSON-ul de intrare câmpurile stream, attrs, attrs.tag (dacă există) și le punem în harta extrasă.
 - regex:
     expresie: ^(?P([^|]+))|(?P([^|]+))$
     sursă: "tag"
Dacă am reușit să punem câmpul tag în harta extrasă, folosim regex pentru a extrage numele imaginii și numelui containerului.
 - etichete:
     image_name:
     container_name:
Atribuim etichetele. Dacă în datele extrase se vor descoperi cheile image_name și container_name, valorile lor vor fi atribuite etichetelor corespunzătoare.
 - potrivire:
     selector: '{job="docker",container_name="",image_name=""}'
     acțiune: drop
Aruncăm toate jurnalele care nu au etichetele image_name și container_name stabilite.
  - potrivire:
     selector: '{image_name="nginx.promtail.test"}'
     stagii:
       - json:
           expresii:
             row: log
Pentru toate jurnalele în care image_name este egal cu nginx.promtail.test, extragem câmpul log din jurnalul original și îl punem în harta extrasă cu cheia row.
  - regex:
         # suprascriem culorile forego
         expresie: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         sursă: logrow
Curățăm șirul de intrare folosind expresii regulate și extragem virtual host-ul nginx și șirul de jurnal nginx.
     - regex:
         sursă: nginxlog
         expresie: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parserizăm jurnalul nginx folosind expresii regulate.
    - regex:
           sursă: request_url
           expresie: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           sursă: request_url
           expresie: ^/photo/(?P[^/?.]+).*$
       - regex:
           sursă: request_url
           expresie: ^/api/(?P[^/?.]+).*$
Analizăm request_url. Folosind regex, determinăm destinația cererii: către fișiere statice, fotografii, API și stabilim cheia corespunzătoare în harta extrasă.
       - șablon:
           sursă: request_type
           șablon: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Folosind operatori condiționali în Template verificăm câmpurile stabilite în harta extrasă și setăm valorile necesare pentru câmpul request_type: photo, static, API. Atribuim other, dacă nu am reușit. Acum request_type conține tipul cererii.
       - etichete:
           api_request:
           virtual_host:
           request_type:
           status:
Stabilim etichetele api_request, virtual_host, request_type și status (HTTP status) pe baza a ceea ce am reușit să punem în harta extrasă.
       - output:
           sursă: nginx_log_row
Schimbăm output. Acum, în Loki, se trimite jurnalul nginx curățat din harta extrasă.
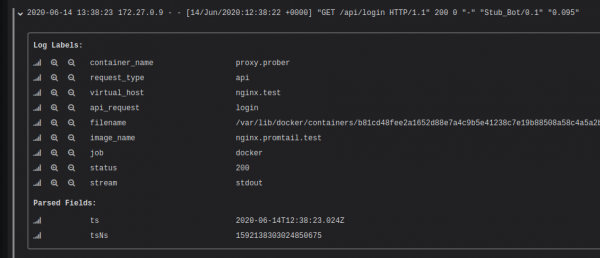
După rularea acestui config, se poate observa că fiecărei înregistrări i-au fost atribuite etichete pe baza datelor din jurnal.
Este important de menționat că extragerea etichetelor cu un număr mare de valori (cardinalitate) poate încetini semnificativ funcționarea Loki. Adică, nu ar trebui să plasăm în index, de exemplu, user_id. Citiți mai multe despre acest lucru în articolul „”. Dar asta nu înseamnă că nu putem căuta după user_id fără indici. Trebuie să folosim filtre în căutare („grep” pe date), iar indexul aici joacă rolul unui identificator de flux.
Vizualizarea logurilor
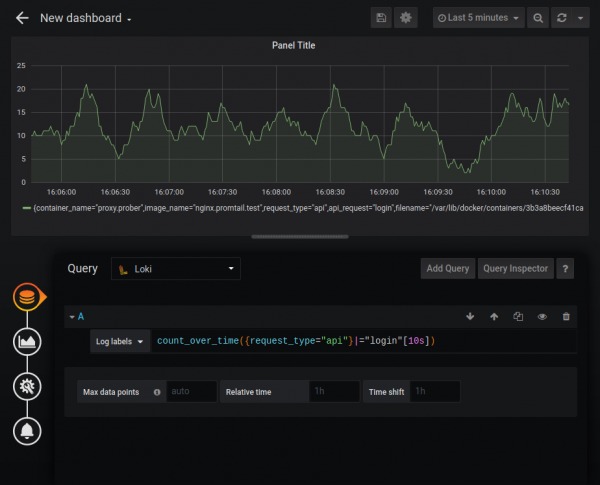
Loki poate funcționa ca sursă de date pentru graficele Grafana, folosind LogQL. Sunt acceptate următoarele funcții:
- rate — numărul de înregistrări pe secundă;
- count over time — numărul de înregistrări într-un interval dat.
De asemenea, există funcții agregatoare precum Sum, Avg și altele. Se pot construi grafice oarecum complexe, cum ar fi un grafic al numărului de erori HTTP:
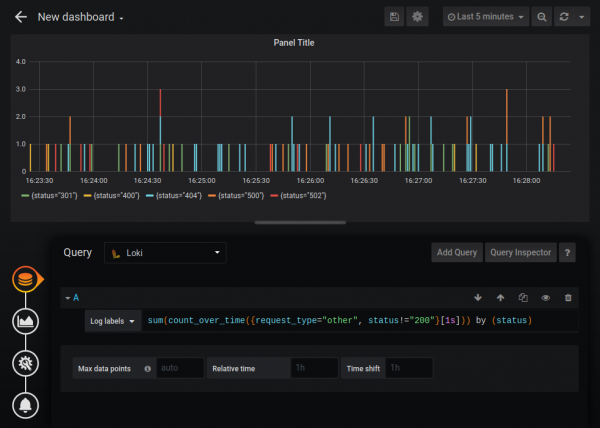
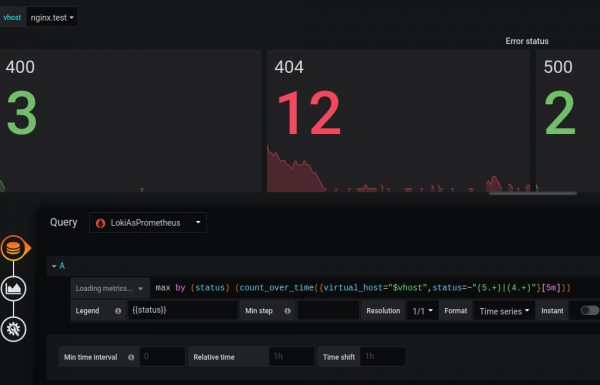
Sursele de date standard Loki sunt oarecum limitate în funcționalitate comparativ cu sursele de date Prometheus (de exemplu, nu se poate schimba legenda), dar Loki poate fi conectat ca sursă de tip Prometheus. Nu sunt sigur că acest comportament este documentat, dar, judecând după răspunsul dezvoltatorilor „”, de exemplu, este destul de legitim, iar Loki este complet compatibil cu PromQL.
Adăugăm Loki ca sursă de date de tip Prometheus și adăugăm URL-ul /loki:

Și putem crea grafice, la fel ca și cum am lucra cu metrici din Prometheus:
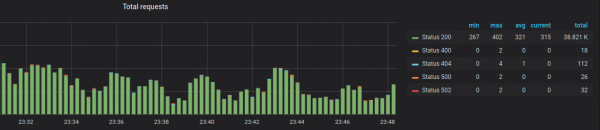
Cred că diferența în funcționalitate este temporară și dezvoltatorii o vor corecta în viitor.
Metrici
În Loki, este disponibilă posibilitatea de a extrage metrici numerice din loguri și de a le trimite în Prometheus. De exemplu, în logul nginx se află numărul de octeți pe răspuns, precum și, cu o anumită modificare a formatului standard al logului, și timpul în secunde necesar pentru răspuns. Aceste date pot fi extrase și trimise în Prometheus.
Adăugăm încă o secțiune în promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "timpul răspunsului ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "suma octeților răspuns"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "numărul de octeți răspuns"
           source: bytes_out
           config:
             action: inc
Această opțiune permite definirea și actualizarea metricilor pe baza datelor din extracted map. Aceste metrici nu sunt trimise în Loki — ele apar în endpoint-ul Promtail /metrics. Prometheus trebuie să fie configurat astfel încât să primească datele obținute în această etapă. În exemplul dat pentru request_type=“api” colectăm o metrică de tip histogramă. Cu acest tip de metrici este convenabil să obținem percentile. Pentru statice și foto, colectăm suma byte-ilor și numărul de linii în care am primit bytes, pentru a calcula valoarea medie.
Citiți mai multe despre metrici .
Deschidem portul pe Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
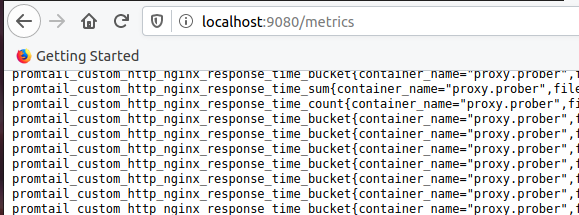
Ne asigurăm că metricile cu prefixul promtail_custom au apărut:
Configurăm Prometheus. Adăugăm job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Și desenăm un grafic:
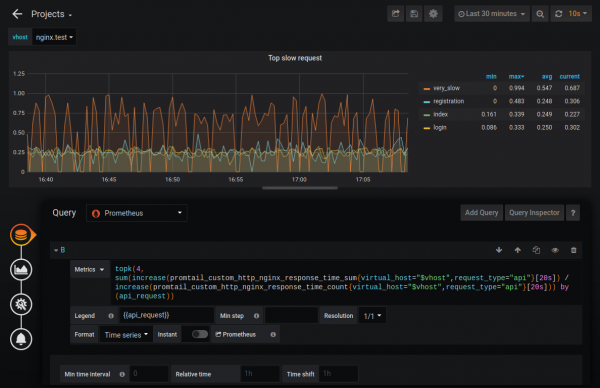
Astfel putem afla, de exemplu, cele patru cele mai lente cereri. De asemenea, pe aceste date metrici se poate configura monitorizarea.
Scalare
Loki poate funcționa atât în mod singur (single binary mode), cât și în mod distribuit (horizontally-scalable mode). În al doilea caz, poate stoca datele în cloud, având în vedere că chunk-urile și indexul sunt stocate separat. În versiunea 1.5 a fost implementată posibilitatea de a stoca într-un singur loc, dar nu se recomandă utilizarea acesteia în producție.
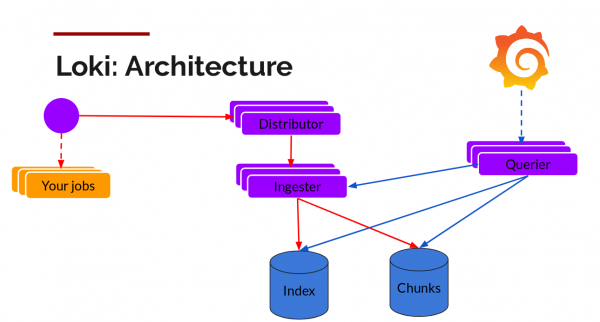
Chunk-urile pot fi stocate în stocarea compatibilă S3, pentru stocarea indexurilor — se pot utiliza baze de date scalabile orizontal: Cassandra, BigTable sau DynamoDB. Celelalte părți ale Loki — Distributors (pentru scriere) și Querier (pentru interogări) — sunt stateless și, de asemenea, se scalază orizontal.
La conferința DevOpsDays Vancouver 2019, unul dintre participanți, Callum Styan, a menționat că, cu Loki, proiectul său avea petabytes de loguri cu un indice mai mic de 1% din dimensiunea totală: “”.
Compararea Loki și ELK
Dimensiunea indexului
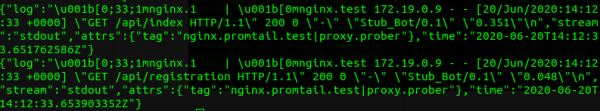
Pentru testarea dimensiunii indexului obținute, am folosit logurile de la containerul nginx, pentru care a fost configurat Pipeline-ul menționat anterior. Fișierul cu loguri conținea 406.624 de linii, având un volum total de 109 MB. Logurile au fost generate pe parcursul unei ore, aproximativ 100 de înregistrări pe secundă.
Exemplu de două linii din log:
La indexarea ELK, aceasta a dat o dimensiune a indexului de 30,3 MB:
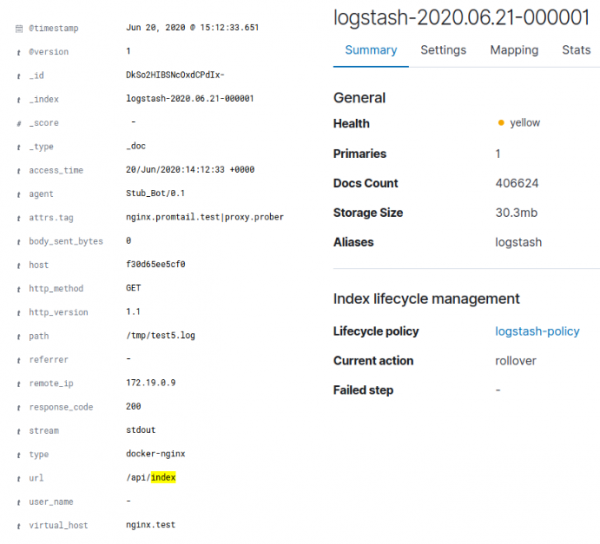
În cazul lui Loki, aceasta a dat aproximativ 128 KB de index și aproximativ 3,8 MB de date în bucăți. Merită menționat că jurnalul a fost generat artificial și nu a avut o mare diversitate de date. Compresia gzip simplă pe jurnalul JSON de origine de la Docker cu date a dus la o compresie de 95,4%, iar având în vedere că în Loki a fost trimis doar jurnalul nginx curățat, comprimarea până la 4 MB este explicabilă. Numărul total de valori unice pentru etichetele Loki a fost de 35, ceea ce explică dimensiunea mică a indexului. Pentru ELK, jurnalul a fost de asemenea curățat. Astfel, Loki a comprimat datele originale cu 96%, iar ELK - cu 70%.
Consumul de memorie
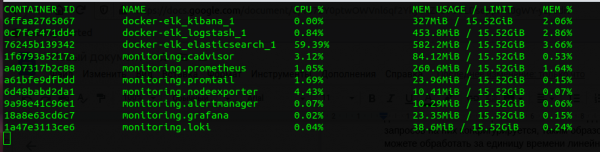
Dacă comparăm întreaga stivă Prometheus și ELK, Loki „înghite” de câteva ori mai puțin. Este evident că un serviciu pe Go consumă mai puțin decât un serviciu pe Java, iar comparația dimensiunii JVM Heap Elasticsearch cu memoria alocată pentru Loki este incorectă, însă merită menționat că Loki folosește mult mai puțină memorie. Avantajul său la CPU nu este atât de evident, dar totuși există.
Viteză
Loki procesează mai rapid jurnalele. Viteza depinde de mulți factori - ce fel de jurnale, cât de sofisticat le parsăm, rețeaua, discul etc. - dar este cu siguranță mai mare decât la ELK (în testul meu - de aproximativ două ori). Acest lucru se explică prin faptul că Loki stochează mult mai puține date în index și, prin urmare, petrece mai puțin timp la indexare. Cu viteza de căutare, situația este inversă: Loki încetinește vizibil pe date de dimensiuni de peste câțiva gigabaiți, în vreme ce viteza de căutare la ELK nu depinde de dimensiunea datelor.
Căutare în jurnale
Loki cedează semnificativ în fața ELK în ceea ce privește capabilitățile de căutare în jurnale. Grep cu expresii regulate este o unealtă puternică, dar este inferioară unei baze de date mature. Absența interogărilor de tip range, agregarea numai pe etichete, imposibilitatea de a căuta fără etichete - toate acestea ne limitează în căutarea informațiilor de interes în Loki. Aceasta nu înseamnă că nu putem găsi nimic cu Loki, dar determină fluxul de lucru cu jurnale, când întâi identifici problema pe graficele Prometheus, iar apoi cauți, pe baza acelor etichete, ce s-a întâmplat în jurnale.
Interfața
În primul rând, este frumos (îmi cer scuze, nu m-am putut abține). Grafana are o interfață atrăgătoare, dar Kibana este mult mai funcțională.
Pro și contra Loki
Printre avantajele se numără faptul că Loki se integrează cu Prometheus, astfel că, metricile și alertele le obținem gata configurate. Este convenabil pentru colectarea și stocarea logurilor cu Kubernetes Pods, deoarece beneficiază de descoperirea serviciilor moștenită de la Prometheus și adaugă automat etichete.
Printre dezavantaje se numără documentația slabă. Unele aspecte, precum caracteristicile și funcționalitățile Promtail, le-am descoperit doar pe parcursul studierii codului, din fericire, open-source. Un alt dezavantaj sunt capabilitățile limitate de parsare. De exemplu, Loki nu poate parsa loguri multiline. De asemenea, se poate menționa că Loki este o tehnologie relativ nouă (versiunea 1.0 a fost lansată în noiembrie 2019).
Concluzie
Loki este o tehnologie 100% interesantă, care se potrivește pentru proiecte mici și medii, permițând rezolvarea multor sarcini de agregare a logurilor, căutare în loguri, monitorizare și analiză a logurilor.
Nu folosim Loki în Badoo, deoarece avem un stack ELK care ne satisface și care, de-a lungul anilor, s-a îmbogățit cu diverse soluții personalizate. Pentru noi, problema principală este căutarea în loguri. Având aproape 100 GB de loguri pe zi, este important să putem găsi totul și puțin mai mult și să facem acest lucru rapid. Pentru construirea de grafice și monitorizare, folosim alte soluții, care sunt adaptate nevoilor noastre și integrate între ele. Stack-ul Loki are avantaje semnificative, dar nu ne va oferi mai mult decât avem deja, iar avantajele sale cu siguranță nu vor compensa costul migrării.
Și, deși după cercetare a devenit clar că nu putem folosi Loki, sperăm că acest articol vă va ajuta în alegere.
Repozitorul cu codul utilizat în articol se află la .
Sursa: habr.com
