

În ultimele aproximativ șase luni, am lucrat la crearea unui sistem de combatere a activităților frauduloase (activitate frauduloasă, fraudă etc.) fără nicio infrastructură inițială pentru aceasta. Ideile pe care le-am găsit și implementat în sistemul nostru ne ajută să detectăm numeroase activități frauduloase și să le analizăm. În acest articol, aș dori să vorbesc despre principiile pe care le-am urmat și despre ceea ce am realizat pentru a ajunge la starea actuală a sistemului nostru, fără a ne aprofunda în partea tehnică.
Principiile sistemului nostru
Când auziți termeni precum „automatic” și „fraud”, cel mai probabil începeți să vă gândiți la învățarea automată, Apache Spark, Hadoop, Python, Airflow și alte tehnologii din ecosistemul Apache Foundation și din domeniul Data Science. Cred că există un aspect al utilizării acestor instrumente care, de obicei, nu este menționat: ele necesită existența unor anumite condiții preliminare în sistemul dumneavoastră corporativ înainte de a începe să le utilizați. Pe scurt, aveți nevoie de o platformă de date corporativă care să includă un lac de date și un depozit. Dar ce se întâmplă dacă nu aveți o astfel de platformă și trebuie să dezvoltați în continuare această practică? Principiile de mai jos ne-au ajutat să ajungem în momentul în care ne putem concentra pe îmbunătățirea ideilor noastre și nu pe căutarea unor soluții funcționale. Totuși, aceasta nu este o „platformă” a proiectului. În plan sunt încă multe lucruri din punct de vedere tehnologic și de produs.
Principiul 1: valoarea pentru afacere este prioritară
În fruntea tuturor eforturilor noastre am plasat „valoarea pentru afacere”. În general, orice sistem de analiză automată face parte dintr-un grup de sisteme complexe cu un nivel ridicat de automatizare și complexitate tehnică. Crearea unei soluții complete va dura mult timp, dacă o creați de la zero. Am decis să punem mai întâi valoarea afacerii, iar pe locul doi, completitudinea tehnologică. În viața reală, aceasta înseamnă că nu acceptăm tehnologiile de vârf ca pe o dogmă. Alegem tehnologia care funcționează cel mai bine pentru noi în acest moment. Cu timpul, poate părea că va trebui să reconceputăm unele module. Acest compromis este unul pe care l-am acceptat.
Principiul 2: Inteligența umană augmentată
Mă îndoiesc că majoritatea oamenilor care nu sunt profund implicați în dezvoltarea soluțiilor de învățare automată ar putea crede că scopul este de a înlocui oamenii. În realitate, soluțiile de învățare automată sunt departe de a fi perfecte, iar în anumite domenii înlocuirea este posibilă doar parțial. Am abandonat această idee de la bun început din mai multe motive: datele dezechilibrate despre activitatea fraudulentă și imposibilitatea de a oferi o listă cuprinzătoare de caracteristici pentru modelele de învățare automată. În schimb, am ales varianta cu inteligență extinsă. Aceasta este o концепție alternativă a inteligenței artificiale, care se concentrează pe rolul de sprijin al AI, subliniind faptul că tehnologiile cognitive sunt destinate îmbunătățirii inteligenței umane, nu înlocuirii acesteia. [1]
Având în vedere acest lucru, dezvoltarea unei soluții complete de învățare automată de la zero ar necesita eforturi uriașe, care ar întârzia generarea de valoare pentru afacerea noastră. Am decis să construim un sistem cu un aspect de învățare automată în creștere iterativ, sub îndrumarea experților noștri în domeniu. Partea complicată a dezvoltării unui astfel de sistem este că acesta trebuie să ofere analistilor noștri cazuri nu doar din perspectiva dacă este sau nu o activitate frauduloasă. În general, orice anomaliile în comportamentul clienților sunt cazuri suspecte pe care specialiștii trebuie să le investigheze și să reacționeze în vreun fel. Numai o parte din aceste cazuri înregistrate pot fi cu adevărat clasificate ca fiind frauduloase.
Principiul 3: platformă de analize extinse
Partea cea mai complexă a sistemului nostru este verificarea continuă a fluxului de lucru al sistemului. Analiștii și dezvoltatorii trebuie să poată accesa cu ușurință seturi de date din perioadele anterioare, inclusiv toate metricile folosite pentru analiză. În plus, platforma de date trebuie să ofere o modalitate simplă de a adăuga un nou set de indicatori la cele existente. Procesele pe care le creăm, nu doar cele software, trebuie să permită recalcularea facilă a perioadelor anterioare, adăugarea de noi metrici și modificarea prognozelor de date. Am putea realiza acest lucru acumulând toate datele generate de sistemul nostru de producție. În acest caz, datele ar deveni treptat o povară. Am fi fost nevoiți să gestionăm un volum în creștere de date pe care nu le folosim și să le protejăm. Într-un astfel de scenariu, datele devin din ce în ce mai irelevante în timp, dar necesită în continuare eforturi din partea noastră pentru a fi gestionate. Pentru noi, acumularea de date nu avea sens, așa că am decis să adoptăm o altă abordare. Am ales să organizăm depozitele de date în timp real în jurul entităților țintă pe care dorim să le clasificăm și să păstrăm doar datele care permit verificarea celor mai recente și relevante perioade. Complexitatea acestor eforturi constă în faptul că sistemul nostru este eterogen, având mai multe depozite de date și module software care necesită o planificare atentă pentru a funcționa în mod coerent.
Conceptul constructiv al sistemului nostru
Avem patru componente principale în sistemul nostru: sistemul de recepție (ingestion system), calcul (computational), analiza (BI analysis) și sistemul de urmărire (tracking system). Acestea servesc scopuri izolate specifice și le menținem separate conform unor abordări definite în dezvoltare.
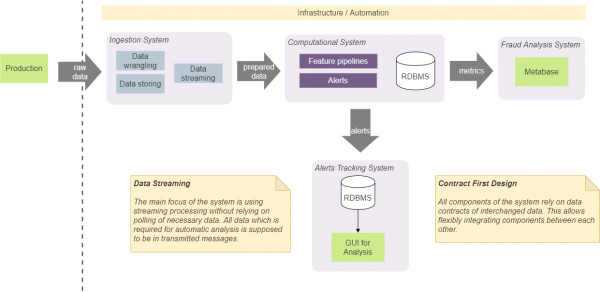
Design bazat pe contracte
În primul rând, am convenit că componentele trebuie să se bazeze doar pe anumite structuri de date (contracte) care sunt transmise între ele. Aceasta permite o integrare ușoară între ele și nu impune o compunere specifică (și ordinea) a componentelor. De exemplu, în unele cazuri, aceasta ne permite să integrăm direct sistemul de primire cu sistemul de urmărire a alertelor. În acest caz, acest lucru se va face conform unui contract convenit pentru alerte. Aceasta înseamnă că ambele componente vor fi integrate folosind un contract care poate fi utilizat de orice altă componentă. Nu vom adăuga un contract suplimentar pentru adăugarea alertelor în sistemul de urmărire din sistemul de intrare. Această abordare necesită utilizarea unui număr minim de contracte definite anterior și simplifică sistemul și comunicațiile. În esență, folosim o abordare numită „Contract First Design” și o aplicăm contractelor de transmitere a datelor. [2]
Streaming peste tot
Salvarea și gestionarea stării într-un sistem va duce inevitabil la complicarea implementării sale. În general, starea ar trebui să fie accesibilă din orice componentă, să fie consistentă și să ofere cea mai actuală valoare pentru toate componentele și ar trebui să fie fiabilă cu valori corecte. În plus, apelurile către stocarea permanentă pentru a obține ultima stare vor crește numărul de operațiuni de intrare-ieșire și complexitatea algoritmilor utilizați în conveierele noastre în timp real. Din acest motiv, am decis să eliminăm stocarea stării, pe cât posibil, din sistemul nostru. Această abordare necesită includerea tuturor datelor necesare în blocul de date transmis (mesaj). De exemplu, dacă trebuie să calculăm numărul total de anumite observații (numărul de operațiuni sau cazuri cu caracteristici specifice), îl calculăm în memorie și generăm un flux de astfel de valori. Modulele dependente vor folosi împărțirea și gruparea pentru a fragmenta fluxul în funcție de entități și a opera pe ultimele valori. Această abordare a eliminat necesitatea de a avea un stocaj permanent pe disc pentru astfel de date. Sistemul nostru folosește Kafka ca broker de mesaje, iar acesta poate fi folosit ca bază de date cu KSQL. [3] Dar utilizarea sa ne-ar lega strâns soluția de Kafka, și am decis să nu-l folosim. Abordarea aleasă ne permite să înlocuim Kafka cu un alt broker de mesaje fără modificări interne serioase în sistem.
Această concept nu înseamnă că nu folosim stocări pe disc și baze de date. Pentru a verifica și analiza performanța sistemului, trebuie să stocăm pe disc o parte semnificativă din date, care reprezintă diverse metrici și stări. Un aspect important aici este că algoritmii în timp real nu depind de astfel de date. În majoritatea cazurilor, folosim datele salvate pentru analiza autonomă, depanare și urmărirea unor cazuri și rezultate specifice pe care le generează sistemul.
Problemele sistemului nostru
Există anumite probleme pe care le-am rezolvat până la un anumit nivel, dar acestea necesită soluții mai bine gândite. Acum aș dori doar să le menționez aici, deoarece fiecare punct merită un articol separat.
- Trebuie să definim în continuare procesele și politicile care contribuie la acumularea de date semnificative și relevante pentru analiza, descoperirea și cercetarea automată a datelor.
- Implementarea rezultatelor analizei realizate de om în procesul de configurare automată a sistemului pentru actualizarea acestuia cu cele mai recente date. Aceasta nu este doar o actualizare a modelului nostru, ci și o actualizare a proceselor și o îmbunătățire a înțelegerii datelor noastre.
- Găsirea unui echilibru între abordarea deterministă IF-ELSE și ML. Cineva a spus: „ML este un instrument pentru cei disperați”. Aceasta înseamnă că veți dori să folosiți ML atunci când nu mai înțelegeți cum să optimizați și să îmbunătățiți algoritmii dvs. Pe de altă parte, abordarea deterministă nu permite descoperirea anomaliilor care nu au fost prevăzute.
- Avem nevoie de o modalitate simplă de a verifica ipotezele noastre sau corelațiile între metrici în date.
- Sistemul trebuie să aibă mai multe niveluri de rezultate adevărate pozitive (true positive). Cazurile de fraudă sunt doar o parte din toate cazurile care pot fi considerate pozitive pentru sistem. De exemplu, analiștii doresc să primească toate cazurile suspecte pentru verificare, iar doar o mică parte dintre acestea sunt fraude. Sistemul trebuie să ofere în mod eficient analiștilor toate cazurile, indiferent dacă este vorba de o fraudă reală sau doar de un comportament suspect.
- Platforma de date trebuie să permită accesul la seturi de date pentru perioadele trecute, cu calcule realizate și estimate în timp real.
- Implementarea simplă și automată a oricărei componente a sistemului în cel puțin trei medii diferite: producție, experimental (beta) și pentru dezvoltatori.
- Și în final, dar nu mai puțin important. Trebuie să creăm o platformă extinsă pentru verificarea performanței, pe care să putem analiza modelele noastre. [4]
Linkuri
Sursa: habr.com
