

Kube-scheduler este un component esențial al Kubernetes, responsabil pentru planificarea podurilor pe noduri conform politicilor specificate. Adesea, în procesul de exploatare a unui cluster Kubernetes, nu trebuie să ne gândim la politicile exacte utilizate pentru planificarea podurilor, deoarece setul de politici al kube-scheduler-ului implicit se potrivește majorității sarcinilor zilnice. Cu toate acestea, există situații în care este important să gestionăm cu atenție procesul de distribuire a podurilor, iar pentru realizarea acestei sarcini există două căi:
- Crearea unui kube-scheduler cu un set personalizat de reguli
- Scrierea propriei soluții de scheduling și învățarea acesteia pentru a lucra cu solicitările de la serverul API
În cadrul acestui articol, voi descrie implementarea primului punct pentru a rezolva problema planificării necorespunzătoare a podurilor într-unul dintre proiectele noastre.
O scurtă introducere în funcționarea kube-scheduler-ului
Este important de menționat că kube-scheduler nu este responsabil pentru planificarea efectivă a podurilor — acesta este responsabil doar pentru a determina nodul pe care trebuie să fie plasat podul. Cu alte cuvinte, rezultatul activității kube-scheduler-ului este numele nodului pe care acesta îl returnează serverului API la solicitarea de planificare, iar pe aceasta activitatea sa se încheie.
Mai întâi, kube-scheduler compilează o listă de noduri pe care podul poate fi planificat conform politicilor predicates. Apoi, fiecare nod din această listă primește un anumit număr de puncte conform politicilor priorites. Ca rezultat, este selectat nodul care a acumulat cel mai mare număr de puncte. Dacă există noduri care au acumulat aceeași valoare maximă, este selectat aleatoriu unul dintre ele. Lista și descrierea politicilor predicates (filtrare) și priorites (evaluare) pot fi consultate în .
Descrierea problemei
Deși avem un număr mare de clustere Kubernetes gestionate de Nixys, ne-am confruntat pentru prima dată cu problema planificării podurilor doar recent, când a apărut necesitatea de a rula un număr mare de sarcini periodice (~100 de entități CronJob) pentru unul dintre proiectele noastre. Pentru a simplifica la maximum descrierea problemei, vom lua ca exemplu un microserviciu, în cadrul căruia se declanșează o sarcină cron la fiecare minut, generând o anumită încărcare pe CPU. Pentru funcționarea sarcinii cron, au fost alocate trei noduri complet identice din punct de vedere al caracteristicilor (24 vCPU pe fiecare).
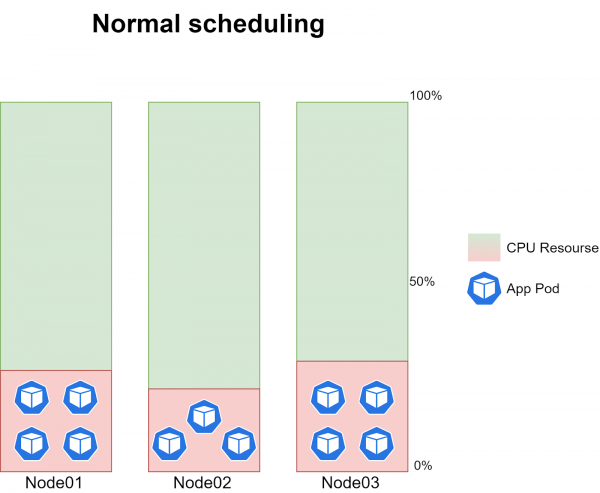
Totuși, nu se poate spune cu exactitate cât timp va dura executarea CronJob, deoarece volumul de date de intrare se schimbă constant. În medie, în condiții normale de funcționare a kube-scheduler-ului, pe fiecare nod funcționează 3-4 instanțe ale sarcinii, care generează ~20-30% din încărcarea CPU-ului fiecărui nod:
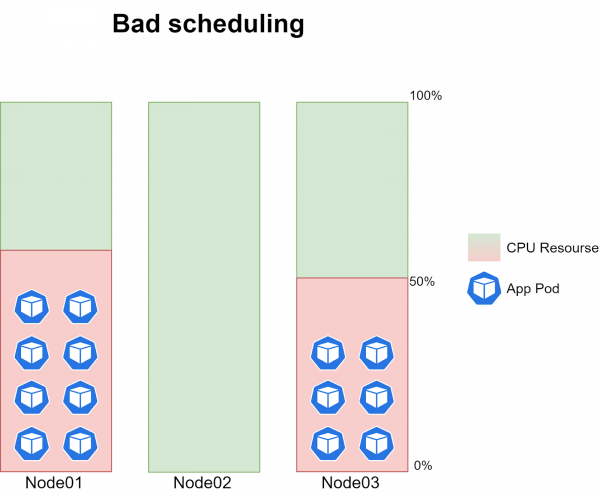
Problema constă în faptul că, uneori, podurile sarcinilor cron nu erau planificate pe unul dintre cele trei noduri. Adică, la un moment dat, pe unul dintre noduri nu era planificat niciun pod, în timp ce pe celelalte două noduri funcționau câte 6-8 instanțe ale sarcinii, generând ~40-60% din încărcarea CPU-ului:
Problema reapărea cu o periodicitate complet aleatorie și uneori corela cu momentul lansării unei noi versiuni a codului.
Prin creșterea nivelului de logare al kube-scheduler-ului la 10 (-v=10), am început să înregistrăm câte puncte acumulează fiecare dintre noduri în procesul de evaluare. În condiții normale de planificare, în jurnale putea fi văzută următoarea informație:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1387 millicore 4161694720 bytes memorie, scor 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1347 millicore 4444810240 bytes memorie, scor 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1387 millicore 4161694720 bytes memorie, scor 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1687 millicore 4790840320 bytes memorie, scor 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1347 millicore 4444810240 bytes memorie, scor 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacitate 23900 millicore 67167186944 bytes memorie, cerere totală 1687 millicore 4790840320 bytes memorie, scor 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Scor: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Scor: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Scor: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Scor: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Scor: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Scor: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Scor: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Scor: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Scor: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Scor: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Scor: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Scor: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Scor: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Scor: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Scor: (10)
generic_scheduler.go:781] Host Node01 => Scor 100043
generic_scheduler.go:781] Host Node02 => Scor 100043
generic_scheduler.go:781] Host Node03 => Scor 100043
Adică, conform informațiilor obținute din jurnale, fiecare dintre noduri a acumulat un număr egal de puncte finale și, pentru planificare, a fost aleasă una aleatorie. În momentul planificării problematice, jurnalele arătau astfel:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 1587 millicores 4581125120 bytes de memorie, punctaj 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 1087 millicores 3532549120 bytes de memorie, punctaj 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 1587 millicores 4581125120 bytes de memorie, punctaj 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 987 millicores 3322833920 bytes de memorie, punctaj 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 987 millicores 3322833920 bytes de memorie, punctaj 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacitate 23900 millicores 67167186944 bytes de memorie, cerere totală 1087 millicores 3532549120 bytes de memorie, punctaj 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Punctaj: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Punctaj: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Punctaj: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Punctaj: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Punctaj: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Punctaj: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Punctaj: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Punctaj: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Punctaj: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Punctaj: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Punctaj: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Punctaj: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Punctaj: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Punctaj: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Punctaj: (10)
generic_scheduler.go:781] Host Node03 -> Punctaj 100041
generic_scheduler.go:781] Host Node02 -> Punctaj 100041
generic_scheduler.go:781] Host Node01 -> Punctaj 100038
Din care se poate observa că una dintre noduri a obținut mai puține puncte finale decât celelalte, iar prin urmare, planificarea a fost efectuată doar pe cele două noduri care au obținut cel mai mult. Astfel, ne-am convins că problema constă exact în planificarea podurilor.
Algoritmul următor pentru rezolvarea problemei a fost evident pentru noi — să analizăm jurnalele, să înțelegem din ce prioritate specifică nodul nu a obținut puncte și, dacă este necesar, să corectăm politicile de bază ale kube-scheduler-ului. Totuși, aici ne-am confruntat cu două dificultăți semnificative:
- La cel mai înalt nivel de înregistrare (10) se reflectă un set de puncte doar pentru unele priorități. În fragmentul de jurnal de mai sus se poate observa că, pentru toate prioritățile reflectate în jurnale, nodurile obțin același număr de puncte în timpul planificării normale și în cea problematică, dar rezultatul final în cazul planificării problematice diferă. Astfel, se poate concluziona că, pentru anumite priorități, calculul punctelor se face 'în fundal', și nu avem posibilitatea de a înțelege care prioritate specifică a determinat ca nodul să nu obțină puncte. Am descris în mod detaliat această problemă în depozitul Kubernetes pe Github. La momentul redactării acestui articol, am primit un răspuns de la dezvoltatori că suportul pentru înregistrare va fi adăugat în actualizările Kubernetes v1.15, v1.16 și v1.17.
- Nu există o modalitate simplă de a înțelege cu ce set specific de politici lucrează în prezent kube-scheduler. Da, în această listă este enumerată, dar nu conține informații cu privire la ce greutăți specifice sunt atribuite fiecărei politici de prioritate. Se pot vizualiza greutățile sau se pot edita politicile kube-scheduler-ului doar în .
Merită menționat că, o dată am reușit să constatăm că nodul nu a obținut puncte conform politicii ImageLocalityPriority, care acordă puncte nodului dacă deja există o imagine necesară pentru a lansa aplicația. Adică, în momentul lansării unei noi versiuni a aplicației, sarcina cron reușea să se execute pe două noduri, descărcând pe ele o nouă imagine din registrul docker, și astfel cele două noduri obțineau un scor final mai mare comparativ cu al treilea.
Așa cum am menționat mai devreme, în jurnale nu vedem informații despre evaluarea politicii ImageLocalityPriority, așadar, pentru a verifica presupunerea noastră, am lansat o imagine cu noua versiune a aplicației pe cel de-al treilea nod, după care planificarea a funcționat corect. Problema planificării a fost observată destul de rar din cauza politicii ImageLocalityPriority, mai frecvent ea era legată de altceva. Deoarece nu am putut debuga complet fiecare dintre politicile din lista priorites a kube-schedulere-ului implicit, a apărut necesitatea de a gestiona flexibil politicile de planificare a podurilor.
Formularea problemei
Am dorit ca soluția problemei să fie cât mai specifică, adică entitățile de bază Kubernetes (aici se face referire la kube-scheduler-ul implicit) să rămână neschimbate. Nu ne-am dorit să rezolvăm problema într-un loc și să o creăm în altul. Astfel, am ajuns la două variante de soluționare a problemei, care au fost menționate în introducerea articolului — crearea unui scheduler suplimentar sau scrierea propriului. Cerința principală pentru planificarea sarcinilor cron este distribuirea uniformă a încărcăturii pe trei noduri. Această cerință poate fi satisfăcută de politicile existente ale kube-schedulere-ului, așadar nu are sens să scriem propriul scheduler pentru a rezolva problema noastră.
Instrucțiunile pentru crearea și desfășurarea unui kube-scheduler suplimentar sunt descrise în . Cu toate acestea, ni s-a părut că entitățile Deployment nu sunt suficiente pentru a asigura disponibilitatea serviciului critic kube-scheduler, așa că am decis să desfășurăm un nou kube-scheduler ca Static Pod, iar Kubelet va monitoriza direct acesta. Astfel, am stabilit următoarele cerințe pentru noul kube-scheduler:
- Serviciul trebuie să fie desfășurat ca Static Pod pe toți masterii clusterului
- Trebuie să existe disponibilitate în cazul în care podul activ cu kube-scheduler devine inaccesibil
- Prioritatea principală în planificare trebuie să fie cantitatea de resurse disponibile pe nod (LeastRequestedPriority)
Implementarea soluției
Este bine să menționăm de la bun început că toate lucrările vor fi efectuate în Kubernetes v1.14.7, deoarece această versiune a fost utilizată în proiect. Vom începe prin a scrie manifestul pentru noul nostru kube-scheduler. Vom folosi ca bază manifestul implicit (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) și îl vom adapta la următoarea formă:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Scurt despre principalele modificări:
- Am schimbat numele pod-ului și al containerului în kube-scheduler-cron
- Am specificat utilizarea porturilor 10151 și 10159, având în vedere că a fost definită opțiunea
hostNetwork: trueși nu putem folosi aceleași porturi ca kube-scheduler-ul implicit (10251 și 10259) - Prin parametrul --config am specificat fișierul de configurare de la care trebuie să pornească serviciul
- Am configurat montarea fișierului de configurare (scheduler-custom.conf) și a fișierului de politici de planificare (scheduler-custom-policy-config.json) din gazdă
Să nu uităm că kube-scheduler-ului nostru îi vor fi necesare permisiuni similare cu cele implicite. Edităm rolul său de cluster:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Acum să discutăm despre ce ar trebui să conțină fișierul de configurare și fișierul cu politicile de planificare:
- Fișierul de configurare (scheduler-custom.conf)
Pentru a obține configurația kube-scheduler-ului implicit, trebuie să folosim parametrul--write-config-todin . Configurația obținută va fi plasată în fișierul /etc/kubernetes/scheduler-custom.conf și va arăta astfel:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Scurt despre principalele modificări:
- Am setat în schedulerName numele serviciului nostru kube-scheduler-cron.
- În parametru
lockObjectNametrebuie, de asemenea, să stabilim numele serviciului nostru și să ne asigurăm că parametrulleaderElecteste setat la true (în cazul în care aveți un singur nod master, puteți seta false). - Am specificat calea către fișierul de descriere a politicilor de programare în parametrul
algorithmSource.
Merită să ne oprim mai în detaliu asupra celui de-al doilea punct, unde edităm parametrii pentru cheia leaderElection. Pentru a asigura disponibilitatea în caz de defecțiune, am activat (leaderElect) procesul de alegere a liderului (master) între podurile kube-scheduler-ului nostru folosind un singur endpoint (resourceLock) numit kube-scheduler-cron (lockObjectName) în spațiul de nume kube-system (lockObjectNamespace). Despre cum se asigură în Kubernetes disponibilitatea ridicată a componentelor principale (inclusiv kube-scheduler) se poate citi în .
- Fișierul politicilor de programare (scheduler-custom-policy-config.json)
Așa cum am menționat anterior — pentru a ști cu ce politici specifice lucrează kube-scheduler-ul implicit, trebuie să analizăm codul acestuia. Cu alte cuvinte, nu putem obține un fișier cu politicile de programare ale kube-scheduler-ului implicit, similar fișierului de configurare. Vom descrie politicile de programare care ne interesează în fișierul /etc/kubernetes/scheduler-custom-policy-config.json astfel:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Astfel, kube-scheduler începe prin a compune o listă de noduri pe care un pod poate fi programat, conform politicii GeneralPredicates (care include un set de politici PodFitsResources, PodFitsHostPorts, HostName și MatchNodeSelector). Apoi, fiecare nod este evaluat pe baza setului de politici din array-ul priorities. Pentru a îndeplini cerințele sarcinii noastre, am considerat că un astfel de set de politici va fi soluția optimă. Reamintesc că setul de politici cu detalii este disponibil în . Pentru a îndeplini sarcina, puteți pur și simplu să schimbați setul de politici utilizate și să le atribuiți greutăți corespunzătoare.
Manifestul noului kube-scheduler, pe care l-am creat la începutul capitolului, se va numi kube-scheduler-custom.yaml și va fi plasat la următoarea cale /etc/kubernetes/manifests pe cele trei noduri master. Dacă totul este realizat corect, Kubelet de pe fiecare nod va rula pod-ul, iar în jurnalele noului nostru kube-scheduler vom vedea informații despre faptul că fișierul nostru cu politici a fost aplicat cu succes:
Crearea scheduler-ului din configurație: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Înregistrarea predicate-ului: GeneralPredicates
Tipul de predicate GeneralPredicates este deja înregistrat, reutilizându-se.
Înregistrarea priorității: ServiceSpreadingPriority
Tipul de prioritate ServiceSpreadingPriority este deja înregistrat, reutilizându-se.
Înregistrarea priorității: EqualPriority
Tipul de prioritate EqualPriority este deja înregistrat, reutilizându-se.
Înregistrarea priorității: LeastRequestedPriority
Tipul de prioritate LeastRequestedPriority este deja înregistrat, reutilizându-se.
Înregistrarea priorității: NodePreferAvoidPodsPriority
Tipul de prioritate NodePreferAvoidPodsPriority este deja înregistrat, reutilizându-se.
Înregistrarea priorității: NodeAffinityPriority
Tipul de prioritate NodeAffinityPriority este deja înregistrat, reutilizându-se.
Crearea scheduler-ului cu predicate de potrivire 'map[GeneralPredicates:{}]' și funcții de prioritate 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Acum rămâne doar să specificăm în spec-ul CronJob-ului nostru că toate cererile de programare a pod-urilor sale trebuie să fie gestionate de noul nostru kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Concluzie
În cele din urmă, am obținut un kube-scheduler suplimentar cu un set unic de politici de programare, al cărui funcționare este supravegheată direct de kubelet. De asemenea, am configurat alegerile unui nou lider între pod-urile kube-scheduler-ului nostru în cazul în care vechiul lider devine inaccesibil din diverse motive.
Aplicațiile și serviciile obișnuite continuă să fie planificate prin kube-scheduler-ul implicit, în timp ce toate sarcinile cron au fost complet migrate pe noul sistem. Sarcina generată de sarcinile cron este acum distribuită uniform între toate nodurile. Având în vedere că cele mai multe sarcini cron sunt executate pe aceleași noduri ca și aplicațiile principale ale proiectului, acest lucru a permis reducerea semnificativă a riscurilor de mutare a podurilor din cauza lipsei de resurse. După implementarea unui kube-scheduler suplimentar, problemele cu programarea neuniformă a sarcinilor cron nu au mai apărut.
Citiți și alte articole de pe blogul nostru:
Sursa: habr.com
