

Bună ziua tuturor! Mă numesc Kirill, sunt CTO la Adapty. O mare parte din arhitectura noastră se află pe AWS, iar astăzi vă voi povesti despre cum am redus costurile cu serverele de 3 ori prin utilizarea instanțelor spot în mediu de producție, precum și despre cum să le configurăm pentru auto-scalare. În primul rând, va fi o prezentare generală despre cum funcționează, iar apoi un ghid detaliat pentru implementare.
Ce sunt instanțele spot?
spot sunt servere ale altor utilizatori AWS, care în prezent sunt inactive și le vând cu reduceri mari (Amazon afirmă până la 90%, dar din experiența noastră ~3x, variind în funcție de regiune, AZ și tipul de instanță). Principalul lor dezavantaj în comparație cu cele obișnuite este că se pot opri în orice moment. De aceea, mult timp am considerat că utilizarea lor în medii de dezvoltare este acceptabilă, sau pentru calcule, păstrând rezultatele intermediare pe S3 sau într-o bază de date, dar nu în producție. Există soluții terțe care permit utilizarea spot-urilor în producție, dar pentru cazul nostru implică multe compromisuri, așa că nu le-am implementat. Abordarea descrisă în articol funcționează pe deplin în cadrul funcționalităților standard AWS, fără scripturi suplimentare, cron-uri etc.
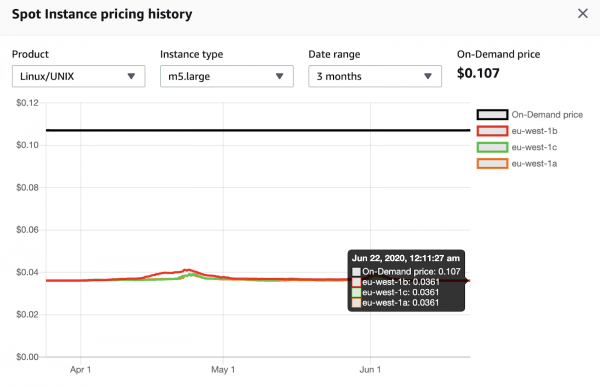
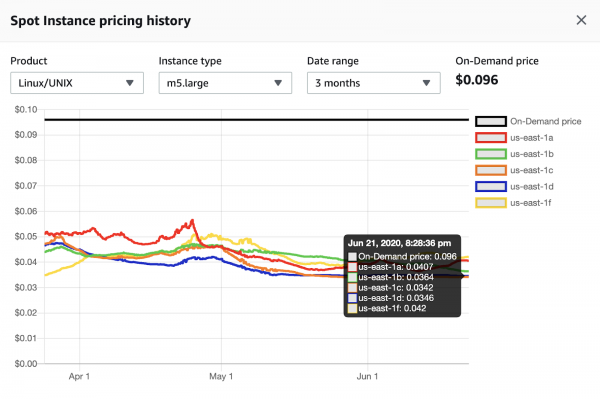
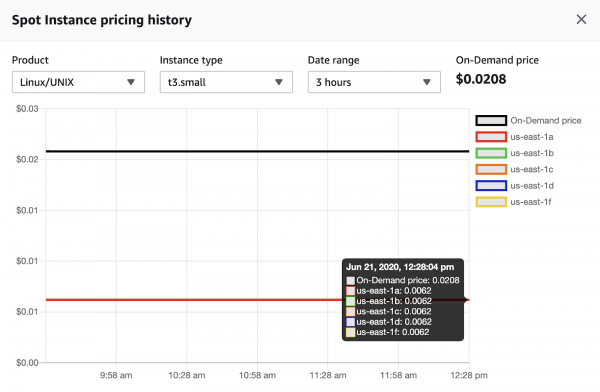
Mai jos sunt câteva capturi de ecran care arată istoricul prețurilor pentru instanțele spot.
m5.large în regiunea eu-west-1 (Irlanda). Prețul a fost în mare parte stabil timp de 3 luni, în prezent economisind 2.9x.
m5.large în regiunea us-east-1 (N. Virginia). Prețul variază continuu de-a lungul a 3 luni, în prezent economisind între 2.3x și 2.8x, în funcție de zona de disponibilitate.
t3.small în regiunea us-east-1 (N. Virginia). Prețul este stabil timp de 3 luni, în prezent economisind 3.4x.
Arhitectura serviciului
Arhitectura de bază a serviciului despre care vom discuta în acest articol este ilustrată în diagrama de mai jos.
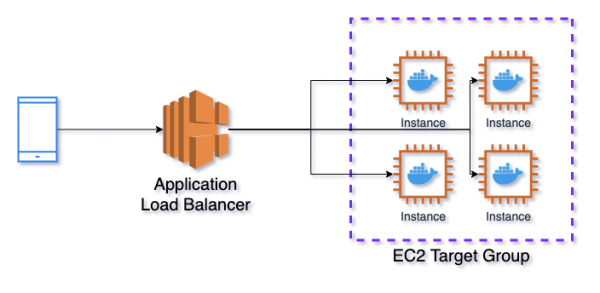
Application Load Balancer → EC2 Target Group → Elastic Container Service
Ca echilibror de sarcină, se folosește Application Load Balancer (ALB), care trimite cererile către EC2 Target Group (TG). TG are responsabilitatea de a deschide porturile pentru instanțe pentru ALB și de a le lega de porturile containerelor Elastic Container Service (ECS). ECS este un echivalent al Kubernetes pe AWS, care se ocupă cu managementul containerelor Docker.
Pe un instanță pot exista mai multe containere active cu aceleași porturi, așa că nu putem să le stabilim fix. ECS informează TG că lansează o nouă sarcină (denumită pod în terminologia Kubernetes), aceasta verifică porturile disponibile pe instanță și alocă unul dintre ele pentru sarcina lansată. De asemenea, TG verifică în mod regulat dacă instanța și API-ul de pe aceasta funcționează prin health check și, în cazul în care observă probleme, încetează să trimită cereri acolo.
EC2 Auto Scaling Groups + ECS Capacity Providers
În diagrama de mai sus nu este prezentat serviciul EC2 Auto Scaling Groups (ASG). Din denumire se poate înțelege că se ocupă de scalarea instanțelor. Până de curând, AWS nu avea o capacitate încorporată de a gestiona numărul de mașini lansate din ECS. ECS permitea scalarea numărului de sarcini, de exemplu, în funcție de utilizarea CPU, RAM sau de numărul de cereri. Dar dacă sarcinile ocupau toate instanțele disponibile, nu erau lansate automat mașini noi.
Aceasta s-a schimbat odată cu apariția ECS Capacity Providers (ECS CP). Acum, fiecare serviciu din ECS poate fi legat de ASG, iar dacă sarcinile nu se încadrează pe instanțele active, vor fi lansate mașini noi (dar în limitele stabilite de ASG). Acest lucru funcționează și în sens invers; dacă ECS CP observă instanțe idle fără sarcini, va comanda ASG să le oprească. ECS CP are capacitatea de a specifica un procent țintă de utilizare a instanțelor, astfel încât un anumit număr de mașini să fie întotdeauna liber pentru scalarea rapidă a sarcinilor, voi detalia acest aspect mai târziu.
EC2 Launch Templates
Ultimul serviciu despre care voi vorbi înainte de a trece la detalii despre cum se creează această infrastructură este EC2 Launch Templates. Acesta permite crearea unui șablon conform căruia vor fi lansate toate mașinile, pentru a nu repeta procesul de la zero de fiecare dată. Aici poți alege tipul mașinii lansate, grupul de securitate, imaginea discului și multe alte parametri. De asemenea, poți specifica datele utilizatorului, care vor fi instalate pe toate instanțele lansate. În datele utilizatorului se pot rula scripturi, de exemplu, se poate edita conținutul fișierului .
Unul dintre parametrii cei mai importanți în cadrul acestui articol este =true. Dacă acest parametru este activat, de îndată ce ECS primește semnalul că instanța spot este retrasă, toate sarcinile care funcționează pe aceasta vor fi mutate în statusul Draining. Nici o sarcină nouă nu va fi alocată acestei instanțe, iar dacă există sarcini care doresc să fie desfășurate pe ea, acestea vor fi anulate. Solicitările de la echilibratorul de sarcină vor înceta să mai vină. Notificarea despre eliminarea instanței vine cu două minute înainte de evenimentul efectiv. Așadar, dacă serviciul dvs. nu îndeplinește sarcini mai mult de 2 minute și nu salvează nimic pe disc, puteți utiliza instanțe spot fără pierderi de date.
În ceea ce privește discul — AWS a făcut recent utilizarea Elastic File System (EFS) împreună cu ECS, cu acest sistem chiar discul nu reprezintă o barieră, dar nu am încercat acest lucru, deoarece, în principiu, nu avem nevoie de disc pentru a stoca starea. În mod implicit, după primirea SIGINT (trimis în momentul mutării sarcinii în statusul Draining), toate sarcinile active vor fi oprite în 30 de secunde, chiar dacă nu au reușit să finalizeze, această perioadă poate fi modificată cu ajutorul parametrului . Este esențial să nu îl setați mai mare de 2 minute pentru mașinile spot.
Crearea serviciului
Să trecem direct la crearea serviciului descris. În timpul procesului, voi descrie câteva puncte utile suplimentare despre care nu s-a menționat anterior. În general, aceasta este o instrucțiune pas cu pas, dar nu voi considera unele cazuri foarte de bază sau, dimpotrivă, foarte specifice. Toate acțiunile sunt efectuate în consola vizuală AWS, dar pot fi reproduse programatic folosind CloudFormation sau Terraform. În Adapty, utilizăm Terraform.
Șablon de lansare EC2
În acest serviciu, se creează o configurație a mașinilor care vor fi utilizate. Managementul șabloanelor se desfășoară în secțiunea EC2 -> Instanțe -> Șabloane de lansare.
Imaginea de mașină Amazon (AMI) — specificăm imaginea discului cu care vor fi lansate toate instanțele. Pentru ECS, în cele mai multe cazuri, este recomandat să folosiți o imagine optimizată de la Amazon. Aceasta este actualizată regulat și conține tot ce este necesar pentru funcționarea ECS. Pentru a afla ID-ul actual al imaginii, accesăm pagina , alegem regiunea utilizată și copiem ID-ul AMI pentru aceasta. De exemplu, pentru regiunea us-east-1, ID-ul actual la momentul scrierii acestui articol este ami-00c7c1cf5bdc913ed. Acest ID trebuie introdus în secțiunea Specificați o valoare personalizată.
Tipul instanței — specificați tipul instanței. Alegeți-l pe cel care se potrivește cel mai bine nevoilor dumneavoastră.
Cheie de acces (login) — specificați certificatul prin care vă puteți conecta la instanță prin SSH, dacă este necesar.
Setările rețelei — specificați parametrii de rețea. Platforma de rețea în majoritatea cazurilor ar trebui să fie Cloud Privat Virtual (VPC). Grupuri de securitate — grupuri de securitate pentru instanțele dumneavoastră. Deoarece vom utiliza un balansor înaintea instanțelor, recomand să specificați aici un grup care permite conexiuni de sănătate doar de la balansor. Astfel, veți avea 2 grupuri de securitate, unul pentru balansor, care permite conexiuni de intrare (inbound) din toate sursele pe porturile 80 (http) și 443 (https), iar al doilea pentru mașini, care permite conexiuni de intrare pe orice port din grupul balansor. Conexiunile de ieșire (outbound) în ambele grupuri trebuie să fie deschise pe protocol TCP pentru toate porturile către toate adresele. Puteți restricționa porturile și adresele pentru conexiunile de ieșire, dar în acest caz trebuie să monitorizați constant pentru a vă asigura că nu încercați să accesați ceva pe un port închis.
Stocare (volum) — specificați parametrii discurilor pentru mașini. Dimensiunea discului nu poate fi mai mică decât cea specificată în AMI, pentru ECS Optimized — 30 GiB.
Detalii avansate — specificați parametrii suplimentari.
Opțiunea de achiziție — dorim să achiziționăm instanțe spot. Vrem, dar nu vom bifa această opțiune aici, o vom configura în Grupul de Auto Scaling, acolo sunt mai multe opțiuni.
Profilul de instanță IAM — specificați rolul cu care vor fi lansate instanțele. Pentru ca instanțele să funcționeze în ECS, au nevoie de permisiuni, care de obicei sunt incluse în rolul ecsInstanceRole. În unele cazuri, acesta poate fi creat; dacă nu, aici sunt informații despre cum să faceți asta. După crearea sa, specificați-l în șablon.
Urmează multe parametrii, în general, majoritatea pot fi lăsate la valorile implicite, dar fiecare dintre ele are o descriere clară. Eu întotdeauna includ parametrii instanței EBS-optimized și T2/T3 Unlimited, dacă sunt utilizate instanțe.
Date utilizator — specificați datele utilizatorului. Vom edita fișierul /etc/ecs/ecs.config, în care se află configurația agentului ECS.
Exemplu despre cum ar putea arăta datele utilizatorului:
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — parametrul indică faptul că instanța aparține unui cluster cu numele specificat, adică acest cluster va putea desfășura sarcinile sale pe acest server. Deocamdată nu am creat un cluster, dar la crearea acestuia vom folosi acest nume.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — parametrul indică faptul că, la primirea semnalului de oprire a instanței spot, toate sarcinile de pe aceasta trebuie să fie transmise în statutul Draining.
ECS_CONTAINER_STOP_TIMEOUT=1m — parametrul indică faptul că, după primirea semnalului SIGINT, toate sarcinile au la dispoziție 1 minut înainte de a fi terminate.
ECS_ENGINE_AUTH_TYPE=docker — parametrul indică faptul că se utilizează schema docker ca mecanism de autorizare.
ECS_ENGINE_AUTH_DATA=... — parametrii de conectare la un registry privat de containere, unde sunt stocate imaginile dvs. Docker. Dacă este public, nu este necesar să specificați nimic.
În cadrul acestui articol, voi folosi o imagine publică din Docker Hub, așa că nu voi specifica parametrii ECS_ENGINE_AUTH_TYPE și ECS_ENGINE_AUTH_DATA nu este necesar.
Util de știut: se recomandă actualizarea regulată a AMI-urilor, deoarece în versiunile noi se actualizează versiunile Docker, Linux, agentul ECS etc. Pentru a nu uita despre acest lucru, puteți privind lansarea de versiuni noi. Puteți primi notificări pe email și să actualizați manual sau puteți scrie o funcție Lambda care va crea automat o nouă versiune a șablonului de lansare cu AMI-ul actualizat.
EC2 Auto Scaling Group
Grupul Auto Scaling este responsabil pentru lansarea și scalarea instanțelor. Managementul grupurilor se face în secțiunea EC2 -> Auto Scaling -> Auto Scaling Groups.
Șablon de lansare — alegem șablonul creat la pasul anterior. Lăsăm versiunea implicită.
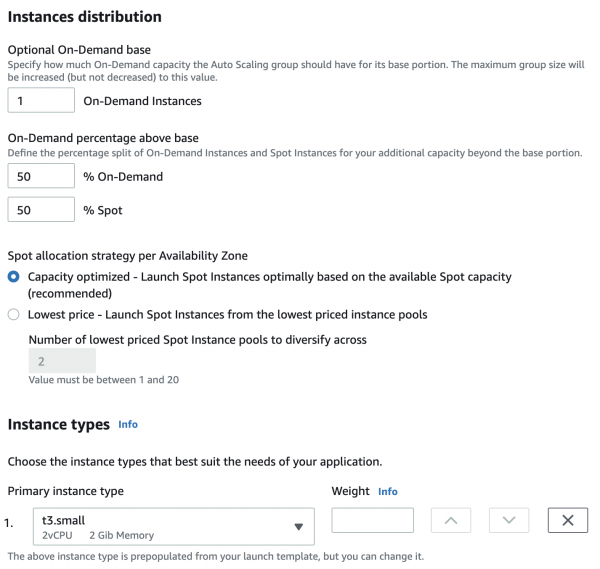
Opțiuni de achiziție și tipuri de instanțe — specificăm tipurile de instanțe pentru cluster. 'Adhere to launch template' folosește tipul de instanță din șablonul de lansare. 'Combine purchase options and instance types' permite configurarea flexibilă a tipurilor de instanțe. Vom folosi aceasta.
Baza opțională On-Demand — numărul de instanțe obișnuite, non-spot, care vor funcționa întotdeauna.
Procentul On-Demand deasupra bazei — raportul procentual între instanțele obișnuite și cele spot, 50-50 va distribui la egal, 20-80 pentru fiecare instanță obișnuită va ridica 4 instanțe spot. În acest exemplu, voi specifica 50-50, dar în realitate, de cele mai multe ori facem 20-80, în unele cazuri 0-100.
Tipuri de instanțe — aici poți specifica tipuri suplimentare de instanțe care vor fi utilizate în cluster. Nu le-am folosit niciodată, deoarece nu înțeleg foarte bine sensul acestei opțiuni. Poate că este vorba de limitele pentru anumite tipuri de instanțe, dar acestea se pot crește ușor prin suport. Dacă știi o utilizare, aș fi bucuros să citesc în comentarii)
Rețea — setările rețelei, alegi VPC și subrețele pentru mașini, în cele mai multe cazuri este indicat să alegi toate subrețelele disponibile.
Încărcarea echilibrată — setările balansoarului, dar vom face asta separat, aici nu intervenim. Controale de sănătate se vor configura de asemenea mai târziu.
Dimensiunea grupului — specificăm limitele pentru numărul de mașini din cluster și numărul dorit de mașini la început. Numărul de mașini din cluster nu va fi niciodată mai mic decât minimul specificat și nici mai mare decât maximul, chiar dacă în metrici ar trebui să se întâmple scalarea.
Politici de scalare — parametrii de scalare, dar vom scala bazându-ne pe sarcinile ECS pornite, așa că vom configura scalarea mai târziu.
Protecția la scalarea instanțelor — protecția instanțelor de ștergere la scalarea descendentă. Activăm pentru ca ASG să nu șteargă mașina pe care există sarcini active. Dezactivarea protecției pentru instanțele fără sarcini va fi gestionată de ECS Capacity Provider.
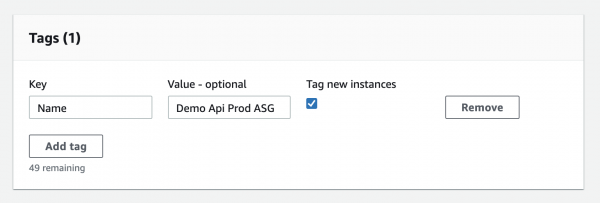
Adaugă etichete — poți specifica etichete pentru instanțe (pentru aceasta trebuie să fie bifată opțiunea Tag new instances). Recomand să specifici eticheta Name, astfel toate instanțele care sunt lansate în cadrul grupului vor avea același nume, ceea ce este convenabil pentru a le vizualiza în consolă.
După crearea grupului, deschide-l și accesează secțiunea Advanced configurations, deoarece în etapa de creație nu toate opțiunile sunt vizibile în consolă.
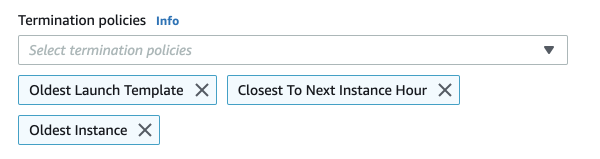
Politici de terminare — reguli care sunt luate în considerare la ștergerea instanțelor. Acestea se aplică în ordinea specificată. De obicei, folosim astfel de politici, ca în imaginea de mai jos. Mai întâi se șterg instanțele cu cel mai vechi Launch Template (de exemplu, dacă am actualizat AMI, ne-a fost creată o nouă versiune, dar toate instanțele au avut timp să treacă la aceasta). Apoi, se aleg instanțele care sunt cel mai aproape de următoarea oră de calcul pentru facturare. Și mai departe, se aleg cele mai vechi după data lansării.
Util de știut: pentru actualizarea tuturor mașinilor din cluster, este convenabil să folosești . Dacă combinați acest lucru cu funcția Lambda din pasul anterior, veți avea un sistem complet automatizat de actualizare a instanțelor. Înainte de a actualiza toate mașinile, este necesar să dezactivați protecția împotriva scalării înapoi pentru toate instanțele din grup. Nu setarea din grup, ci protecția de pe mașini, se face în tab-ul Management Instanțe.
Application Load Balancer și EC2 Target Group
Balansorul se creează în secțiunea EC2 → Load Balancing → Load Balancers. Vom folosi Application Load Balancer; comparația diferitelor tipuri de balansor poate fi citită pe .
Listeners — are sens să creați porturile 80 și 443 și să faceți redirecționare de la 80 la 443 ulterior folosind regulile balansorului.
Availability Zones — în majoritatea cazurilor alegem toate zonele de disponibilitate.
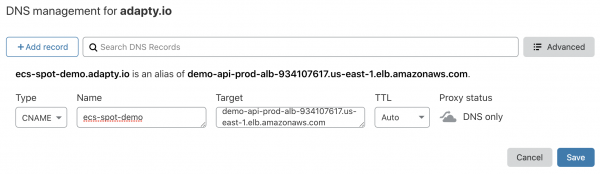
Configure Security Settings — aici se specifică certificatul SSL pentru balansor; cea mai convenabilă opțiune este să în ACM. Despre diferențe Security Policy poate fi citită în , se poate lăsa pe cel ales în mod implicit ELBSecurityPolicy-2016-08. După crearea balansorului, veți vedea DNS name, pe care trebuie să îl configurați CNAME pentru domeniul dumneavoastră. De exemplu, așa arată în Cloudflare.
Security Group — creăm sau alegem un grup de securitate pentru balansor; mai multe detalii despre acest lucru am scris mai sus în secțiunea EC2 Launch Template → Network settings.
Target group — creăm un grup care se ocupă de rutarea cererilor de la balansor către mașini și verifică disponibilitatea acestora, pentru a le înlocui în caz de probleme. Target type trebuie să fie Instance, Protocol și Port orice, dacă utilizați HTTPS pentru comunicarea între balansor și instanțe, atunci pe acestea trebuie să încărcați certificatul. În cadrul acestui exemplu, nu vom face asta, ci vom lăsa pur și simplu portul 80.
Controale de sănătate — parametrii de verificare a disponibilității serviciului. În acest serviciu, acesta ar trebui să fie un apel separat, care realizează părți importante din logica de afaceri; în cadrul acestui exemplu, voi lăsa setările implicite. Apoi, se poate alege intervalul de cereri, timeout-ul, codurile de răspuns de succes etc. În exemplul nostru, vom specifica codurile de succes 200-399, deoarece imaginea Docker care va fi utilizată returnează codul 304.
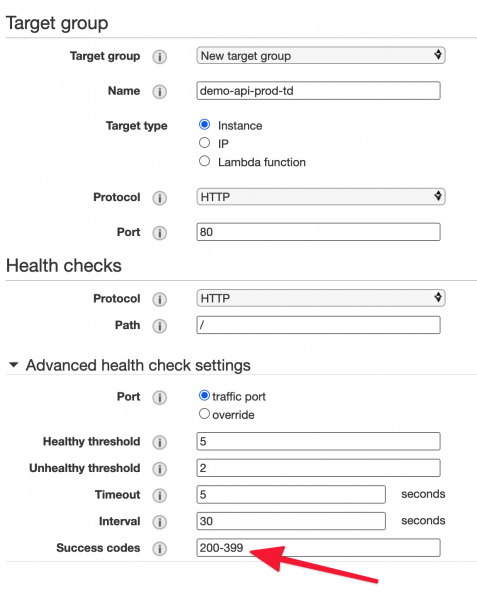
Register Targets — aici se aleg mașinile pentru grup, dar în cazul nostru acest lucru va fi gestionat de ECS, așa că vom sări peste acest pas.
Util de știut: la nivelul balansorului se pot activa jurnalele, care vor fi salvate în S3 într-un anumit interval. . De acolo pot fi exportate în servicii externe pentru analize, sau se pot realiza interogări SQL direct pe datele din S3 cu . Este convenabil și funcționează fără cod suplimentar. De asemenea, recomand configurarea ștergerii jurnalelor din bucket-ul S3 după o anumită perioadă de timp.
Definiția sarcinii ECS
În pașii anteriori am creat tot ce ține de infrastructura serviciului, acum trecem la descrierea containerelor pe care le vom lansa. Aceasta se face în secțiunea ECS → Definiții de sarcină.
Compatibilitatea tipului de lansare — alegem EC2.
Rolul IAM pentru executarea sarcinii — alegem ecsTaskExecutionRole. Cu ajutorul acesta se scriu jurnalele, se oferă acces la variabilele secrete etc.
În secțiunea Definiții de container, facem clic pe Adaugă container.
Imagine — link către imaginea cu codul proiectului, în cadrul acestui exemplu voi folosi o imagine publică de pe Docker Hub .
Limitele de memorie — limitele de memorie pentru container. Limita dură — limită dură, dacă containerul depășește valoarea specificată, comanda docker kill va fi executată, containerul va înceta imediat să funcționeze. Limita moale — limită moale, containerul poate depăși valoarea specificată, dar la plasarea sarcinilor pe mașini va fi luat în considerare acest parametru. De exemplu, dacă pe mașină sunt 4 GiB de memorie RAM, iar limita moale a containerului este de 2048 MiB, atunci pe această mașină pot fi maximum 2 sarcini lansate cu acest container. În realitate, 4 GiB de memorie RAM sunt puțin mai puțin decât 4096 MiB, acest lucru poate fi văzut în tab-ul ECS Instances din cluster. Limita moale nu poate fi mai mare decât limita dură. Este important de înțeles că, dacă într-o sarcină există mai multe containere, limitele lor se cumulează.
Mapările de porturi — în Portul gazdă indicăm 0, ceea ce înseamnă că portul va fi atribuit dinamic, acesta va fi monitorizat de Grupul țintă. Portul containerului — portul pe care rulează aplicația dumneavoastră, adesea este specificat în comanda de execuție, sau este atribuit în codul aplicației dumneavoastră, Dockerfile etc. Pentru exemplul nostru folosim 3000, deoarece este specificat în imaginea folosită.
Verificarea stării de sănătate — parametrii pentru verificarea funcționalității containerului, nu trebuie confundat cu cel care este configurat în Grupul țintă.
Mediu — setările de mediu. Unități CPU — asemănător cu limitele de memorie, doar că se referă la procesor. Fiecare nucleu de procesor reprezintă 1024 unități, așa că dacă serverul are un procesor cu două nuclee, iar valoarea setată pentru container este 512, atunci pe un server pot fi rulate 4 sarcini cu acest container. Unitățile CPU corespund întotdeauna numărului de nuclee, nu pot fi puțin mai puține, ca în cazul memoriei.
Comandă — comanda pentru a lansa un serviciu în interiorul containerului, toate parametrii sunt specificați prin virgulă. Acesta poate fi gunicorn, npm etc. Dacă nu este specificat, se va folosi valoarea directivei CMD din Dockerfile. Specificăm npm,start.
Variabile de mediu — variabilele de mediu ale containerului. Acestea pot fi atât date textuale simple, cât și variabile secrete din sau .
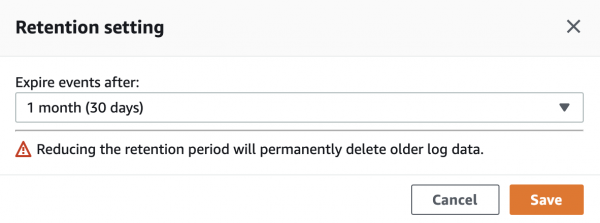
Stocare și Jurnalizare — aici vom configura jurnalizarea în CloudWatch Logs (serviciul de log-uri de la AWS). Pentru aceasta, este suficient să activăm opțiunea Auto-configure CloudWatch Logs. După ce se creează Task Definition, se va crea automat un grup de loguri în CloudWatch. În mod implicit, logurile sunt stocate acolo pentru totdeauna, recomand să schimbi perioada de retenție din Never Expire la perioada dorită. Acest lucru se face în grupurile de loguri CloudWatch, trebuie să dai clic pe perioada curentă și să alegi una nouă.
ECS Cluster și ECS Capacity Provider
Trecem în secțiunea ECS → Clusters pentru a crea un cluster. Ca șablon alegem EC2 Linux + Networking.
Numele cluster-ului — foarte important, facem aici un nume similar cu cel specificat în Launch Template în parametrul ECS_CLUSTER, în cazul nostru — DemoApiClusterProd. Bifăm opțiunea Create an empty cluster. Opțional, putem activa Container Insights pentru a vedea metricile serviciilor în CloudWatch. Dacă ai făcut totul corect, atunci în secțiunea ECS Instances vei vedea mașinile care au fost create în grupul Auto Scaling.
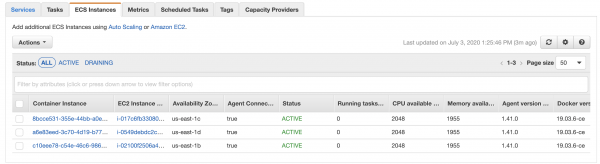
Trecem la pesta Provideri de capacitate și creăm unul nou. Reamintesc că acesta este necesar pentru a gestiona crearea și oprirea mașinilor în funcție de numărul de sarcini ECS active. Este important de menționat că provider-ul poate fi legat doar de un singur grup.
Grup Auto Scaling — alegem grupul creat anterior.
Scalare gestionată — activăm, astfel încât providerul să poată scala serviciul.
Capacitate țintă % — ce procent din încărcarea mașinilor cu sarcini ne este necesar. Dacă specificăm 100%, atunci toate mașinile vor fi întotdeauna ocupate cu sarcini active. Dacă specificăm 50%, atunci jumătate dintre mașini vor fi întotdeauna libere. În acest caz, dacă apare o creștere bruscă a încărcăturii, noile sarcini se vor direcționa imediat către mașinile libere, fără a fi nevoie să aștepte desfășurarea instanțelor.
Protecție gestionată la finalizare — activat, acest parametru permite providerului să elimine protecția instanțelor de la ștergere. Aceasta se întâmplă atunci când nu există sarcini active pe mașină și permite procentajul de capacitate țintă %.
Serviciul ECS și configurarea scalării
Pasul final:) Pentru a crea un serviciu, trebuie să accesați clusterul creat anterior în tab-ul Services.
Tip de lansare — trebuie să faceți clic pe Switch to capacity provider strategy și să alegeți providerul creat anterior.
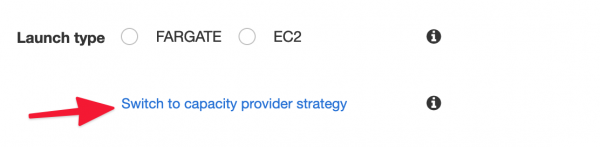
Definiția sarcinii — alegem Definiția sarcinii creată anterior și revizia acesteia.
Numele serviciului — pentru a nu ne confunda, întotdeauna indicăm același nume ca la Definiția sarcinii.
Tipul serviciului — întotdeauna Replica.
Numărul de sarcini — numărul dorit de sarcini active în serviciu. Acest parametru este gestionat prin scalare, dar tot trebuie să fie specificat.
Procentajul minim sănătos și Procentaj maxim — definesc comportamentul sarcinilor în timpul desfășurării. Valorile implicite sunt 100 și 200, ceea ce înseamnă că, în momentul desfășurării, numărul de sarcini va crește de două ori, iar apoi va reveni la forma dorită. Dacă aveți 1 sarcină, min=0, iar max=100, atunci în timpul desfășurării aceasta va fi eliminată, iar apoi va fi pornită o nouă, adică va exista o perioadă de inactivitate. Dacă lucrează 1 sarcină, min=50, max=150, atunci desfășurarea nu va avea loc, deoarece nu se poate împărți o sarcină în două sau crește cu 50%.
Tip de desfășurare — lăsăm Rolling update.
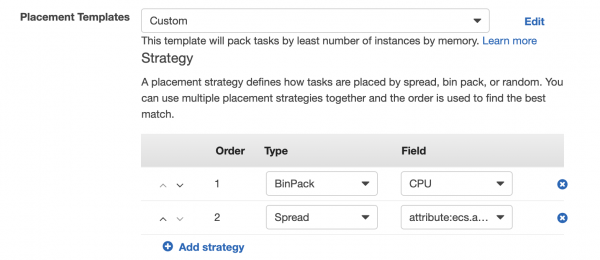
Șabloane de plasare — reguli de plasare a sarcinilor pe mașini. Implicit este setat AZ Balanced Spread — aceasta înseamnă că fiecare nouă sarcină va fi plasată pe o nouă instanță până când mașinile din toate zonele de disponibilitate sunt pornite. De obicei facem BinPack — CPU și Spread — AZ, în această politică sarcinile sunt plasate cât mai compact posibil pe o singură mașină pe CPU. Dacă este necesar să se creeze o nouă mașină, aceasta se va crea într-o nouă zonă de disponibilitate.
Tip de balansare a sarcinilor — alegem Application Load Balancer.
Rol IAM al serviciului — alegem ecsServiceRole.
Numele balansorului de sarcini — alegem balansorul creat anterior.
Perioada de grație pentru verificarea stării — pauză înainte de a efectua verificările de funcționalitate după desfășurarea unei noi sarcini, de obicei, setăm 60 de secunde.
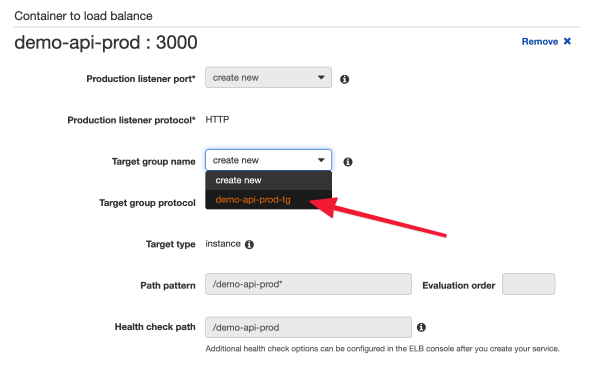
Container pentru balansarea sarcinilor — în punctul Numele grupului țintă alegem grupul creat anterior, iar totul se va completa automat.
Scalarea automată a serviciului — parametrii de scalare ai serviciului. Alegem Configure Service Auto Scaling to adjust your service’s desired count. Setăm numărul minim și maxim de sarcini la scalare.
Rol IAM pentru scalarea automată a serviciului — alegem AWSServiceRoleForApplicationAutoScaling_ECSService.
Politici automate de scalare a sarcinilor — reguli pentru scalare. Există 2 tipuri:
- Urmărirea obiectivelor — urmărirea metricii țintă (utilizarea CPU/RAM sau numărul de cereri pentru fiecare task). De exemplu, dorim ca încărcarea medie a procesorului să fie de 85%. Atunci când aceasta depășește acest prag, vor fi adăugate noi task-uri până când se va ajunge la valoarea țintă. Dacă încărcarea este mai mică, atunci task-urile vor fi eliminate, cu condiția ca protecția împotriva scalării în jos să nu fie activată (Dezactivează scalarea în jos).
- Scaling pas cu pas — reacția la un eveniment aleatoriu. Aici poți configura reacția la orice eveniment (Alarmă CloudWatch), atunci când acesta se întâmplă, poți adăuga sau elimina un număr specific de task-uri, sau poți specifica exact câte task-uri să fie.
Serviciul poate avea mai multe reguli de scalare, ceea ce poate fi util, însă este important să te asiguri că acestea nu intră în conflict între ele.
Concluzie
Dacă ai urmat instrucțiunile și ai folosit aceeași imagine Docker, serviciul tău ar trebui să returneze o astfel de pagină.

- Am creat un șablon pe care se desfășoară toate mașinile din serviciu. De asemenea, am învățat să actualizăm mașinile atunci când șablonul se schimbă.
- Am configurat gestionarea semnalului de oprire a instanței spot, astfel încât în decurs de un minut de la primirea acestuia, toate task-urile active sunt eliminate de pe mașină, astfel încât nimic nu se pierde și nu se întrerupe.
- Am ales un balancer de încărcare pentru a distribui uniform sarcina între mașini.
- Am creat un serviciu care funcționează pe instanțe spot, reducând astfel costurile pentru mașini de aproximativ 3 ori.
- Am configurat auto-scaling în ambele direcții pentru a gestiona creșterea sarcinilor, însă în același timp pentru a nu plăti pentru timpul de inactivitate.
- Folosim Capacity Provider pentru ca aplicația să gestioneze infrastructura (mașinile), nu invers.
- Suntem buni.
Dacă ai creșteri previzibile ale sarcinii, de exemplu, când te promovezi printr-o mare campanie de email, poți configura scalarea pe .
De asemenea, poți efectua scalarea pe baza datelor din diferite părți ale sistemului tău. De exemplu, avem o funcționalitate utilizatorii aplicației mobile. Uneori campania este trimisă către peste 1M de persoane. După o astfel de expediere, se observă întotdeauna o creștere semnificativă a cererilor API, deoarece mulți utilizatori accesează aplicația simultan. Așadar, dacă vedem că în coada pentru trimiterea notificărilor promoționale sunt mult mai multe decât indicatorii standard, putem imediat să lansăm câteva mașini și sarcini suplimentare pentru a fi pregătiți pentru încărcare.
Aș fi bucuros dacă ați împărtăși în comentarii cazuri interesante de utilizare a instanțelor spot și ECS sau orice altceva despre scalare.
În curând vor apărea articole despre cum procesăm mii de evenimente analitice pe secundă pe un stack în mare parte serverless (cu fonduri) și cum funcționează implementarea serviciilor folosind GitLab CI și Terraform Cloud.
Abonați-vă la noi, va fi interesant!
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Folosiți instanțe spot în producție?
22,2%Da6
66,7%Nu18
11,1%Am aflat despre ele dintr-un articol, intenționez să le folosesc3
Au votat 27 de utilizatori. 5 utilizatori s-au abținut.
Sursa: habr.com
