

De-a lungul anilor, Pinterest a avut 300 de milioane de utilizatori care au creat peste 200 de miliarde de pins pe mai mult de 4 miliarde de tablouri. Pentru a deservi această armată de utilizatori și vasta bază de conținut, portalul a dezvoltat mii de servicii, începând cu microservicii, cu care pot lucra câteva CPU, și terminând cu monoliți uriași, care rulează pe un întreg parc de mașini virtuale. Iată că a venit momentul în care compania a întors privirea către k8s. Ce anume a atras atenția „cubului” de către Pinterest? Află din traducerea noastră a unui articol recent din .
Așadar, sute de milioane de utilizatori și sute de miliarde de pins. Pentru a deservi această armată de utilizatori și vasta bază de conținut, am dezvoltat mii de servicii, începând cu microservicii, cu care poate lucra câteva CPU, și terminând cu monoliți uriași, care rulează pe un întreg parc de mașini virtuale. În plus, avem diverse cadre care de asemenea pot necesita resurse de CPU, memorie sau acces la operațiuni de intrare-ieșire.
În sprijinul acestui zoo de instrumente, echipa de dezvoltare se confruntă cu o serie de probleme:
- Inginerii nu au o modalitate unificată de a lansa mediile de lucru. Serviciile Stateless, serviciile Stateful și proiectele aflate în dezvoltare activă se bazează pe stive tehnologice complet diferite. Acest lucru a dus la crearea unui întreg curs de formare pentru ingineri și complică semnificativ activitatea echipei noastre de infrastructură.
- Dezvoltatorii, care dispun de propriul parc de mașini virtuale, impun o povară enormă asupra administratorilor interni. Ca rezultat, operațiuni aparent simple, cum ar fi actualizarea sistemului de operare sau a AMI, se întind pe săptămâni și luni. Aceasta duce la o creștere a sarcinii chiar și în situații care par complet banale.
- Dificultăți în crearea de instrumente globale de gestionare a infrastructurii pe cele deja existente. Situația este complicată și de faptul că găsirea proprietarilor mașinilor virtuale nu este ușor. Adică, nu știm dacă putem extrage în siguranță aceste resurse pentru a le folosi pe alte porțiuni ale infrastructurii noastre.
Sistemele de orchestrare a containerelor reprezintă o modalitate de a unifica gestionarea sarcinilor de lucru. Acestea îți deschid calea către creșterea vitezei de dezvoltare și simplifică gestionarea infrastructurii, deoarece toate resursele implicate în proiect sunt gestionate de un singur sistem centralizat.
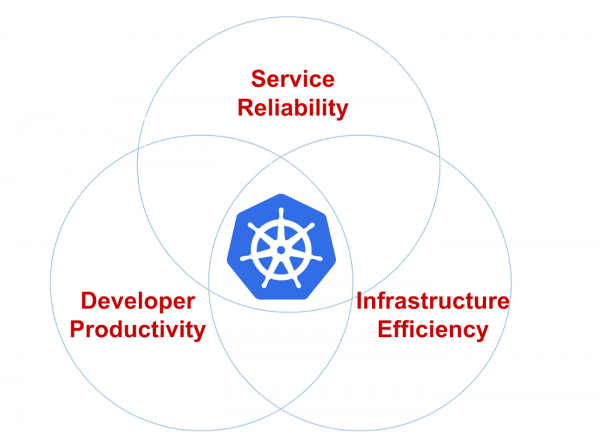
Figura 1: Prioritățile infrastructurii (fiabilitate, performanța dezvoltatorilor și eficiență).
Echipa Cloud Management Platform de la Pinterest a început să lucreze cu K8s în 2017. În prima jumătate a anului 2017, am documentat cea mai mare parte a capacităților noastre de producție, inclusiv API-ul și toate serverele web. Apoi, am efectuat o evaluare riguros a diferitelor sisteme de orchestrare a soluțiilor de containere, construirea clusterelor și gestionarea acestora. Până la sfârșitul anului 2017, am decis să utilizăm Kubernetes. Acesta era suficient de flexibil și era bine susținut în comunitatea dezvoltatorilor.
Până în prezent, am creat propriile instrumente de inițializare a clusterului bazate pe Kops și am migrat componentele existente ale infrastructurii — precum rețeaua, securitatea, metricile, jurnalizarea, managementul identității și traficul — pe Kubernetes. De asemenea, am implementat un sistem de modelare a sarcinilor de lucru pentru resursa noastră, complexitatea acestuia fiind ascunsă de dezvoltatori. Acum ne concentrăm pe asigurarea stabilității clusterului, scalării acestuia și conectării de noi clienți.
Kubernetes: drumul Pinterest
Începerea utilizării Kubernetes la scară largă în Pinterest ca platformă care va fi apreciată de inginerii noștri a venit cu numeroase dificultăți.
Ca companie mare, am investit sume semnificative în instrumentele de infrastructură. De exemplu, putem menționa instrumentele de securitate care gestionează certificatele și distribuie cheile, componentele de control al traficului, sistemele de descoperire a serviciilor, componentele de vizibilitate și trimitere a jurnalelor și metricilor. Toate acestea au fost adunate nu fără un motiv: am parcurs un drum normal de încercări și erori și, prin urmare, ne-am dorit să integrăm toate aceste componente în noua infrastructură pe Kubernetes în loc să reinventăm bicicleta veche pe o nouă platformă. Această abordare a simplificat în general migrarea, deoarece tot suportul aplicațiilor exista deja, fără a fi necesar să fie creat de la zero.
Pe de altă parte, modelele de prognozare a încărcărilor în Kubernetes (de exemplu, desfășurări, sarcini și seturi de Daemon) sunt insuficiente pentru proiectul nostru. Aceste probleme de utilizare sunt obstacole uriașe în calea tranziției către Kubernetes. De exemplu, am auzit cum dezvoltatorii de servicii se plâng de lipsa sau configurarea incorectă a intrărilor. De asemenea, ne-am confruntat cu utilizarea greșită a șabloanelor, când s-au creat sute de modalități cu aceeași specificație și sarcină, ceea ce a dus la probleme teribile de depanare.
A fost, de asemenea, foarte dificil să menținem versiuni diferite într-un singur cluster. Imaginați-vă dificultatea suportului pentru clienți, dacă trebuie să lucrați pe mai multe versiuni ale aceleași medii de execuție, cu toate problemele, bugurile și actualizările acestora.
Resursele și controlerele personalizate Pinterest
Pentru a facilita inginerilor noștri procesul de implementare a Kubernetes, precum și pentru a simplifica infrastructura și a accelera funcționarea acesteia, am dezvoltat propriile definiții ale resurselor personalizate (CRD).
CRD-urile oferă următoarele funcționalități:
- Uniunea diferitelor resurse native Kubernetes, astfel încât să funcționeze ca o singură sarcină. De exemplu, resursa PinterestService include desfășurarea, serviciul de autentificare și harta de configurație. Acest lucru permite dezvoltatorilor să nu se preocupe de configurarea DNS.
- Implementarea suportului necesar pentru aplicații. Utilizatorul trebuie să se concentreze doar pe specificația containerului conform logicii sale de afaceri, în timp ce controlerul CRD implementează toate init-containerele necesare, variabilele de mediu și specificațiile podurilor. Acest lucru asigură un nivel de confort complet diferit pentru dezvoltatori.
- Controlerele CRD administrează, de asemenea, ciclul de viață al resurselor proprii și îmbunătățesc disponibilitatea pentru depanare. Acest lucru include armonizarea specificațiilor dorite și reale, actualizarea stării CRD și păstrarea jurnalelor de evenimente și nu numai. Fără CRD, dezvoltatorii ar fi fost nevoiți să gestioneze un set numeros de resurse, ceea ce ar fi crescut doar probabilitatea de eroare.
Iată un exemplu de PinterestService și resursa internă care este gestionată de controlerul nostru:
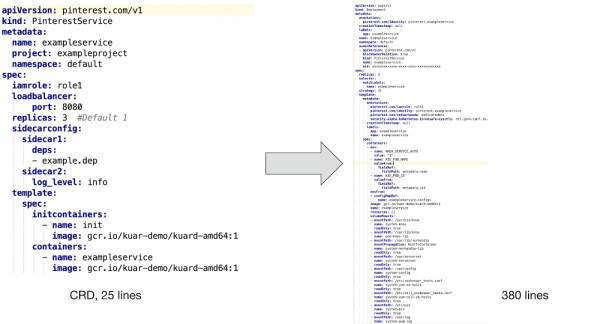
După cum se poate vedea mai sus, pentru a susține containerul utilizatorului, trebuie să integrăm în acesta un container de inițializare și câteva extensii pentru a asigura securitatea, vizibilitatea și gestionarea traficului de rețea. În plus, am creat șabloane de hărți de configurare și am implementat suport pentru șabloane PVC pentru sarcini de lucru, precum și urmărirea mai multor variabile de mediu pentru a monitoriza identificația, consumul de resurse și colectarea „gunoiului”.
Este greu de imaginat că dezvoltatorii ar dori să scrie aceste fiche de configurare manual, fără suport CRD, cu atât mai puțin să le susțină și să le depaneze ulterior.
Fluxul de lucru pentru desfășurarea aplicațiilor
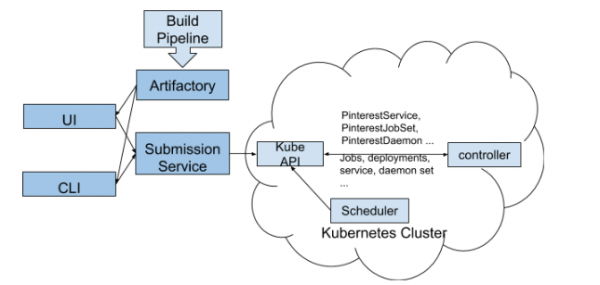
Ilustrația de mai sus arată cum să desfășurați un resursă personalizată Pinterest în clusterul Kubernetes:
- Dezvoltatorii interacționează cu clusterul nostru Kubernetes prin CLI și interfața utilizatorului.
- Instrumentele CLI / UI extrag fișierele YAML de configurare pentru fluxul de lucru și alte proprietăți de construcție (același identificator de versiune) din Artifactory, după care le trimit către Serviciul de Trimitere a Sarcinilor. Acest pas garantează că în cluster vor fi livrate doar versiunile funcționale.
- JSS este un portal pentru diverse platforme, inclusiv Kubernetes. Aici se face autentificarea utilizatorului, emiterea cotelor și o verificare parțială a configurației CRD-ului nostru.
- După verificarea CRD-ului pe partea JSS, informațiile sunt trimise către API-ul platformei k8s.
- Controlerul nostru CRD monitorizează evenimentele de pe toate resursele personalizate. Acesta transformă CR în resurse native k8s, adaugă modulele necesare, stabilește variabilele de mediu corespunzătoare și efectuează alte sarcini auxiliare, garantând astfel aplicațiilor containerizate suportul infrastructural necesar.
- Apoi, controlerul CRD trimite datele obținute către API-ul Kubernetes pentru a fi procesate de planificator și pentru a fi puse în funcțiune.
Notă: acest workflow de deploy în pre-lansare a fost creat pentru primii utilizatori ai noii platforme k8s. Acum ne aflăm în procesul de îmbunătățire a acestui proces pentru a ne integra complet cu noua noastră CI/CD. Asta înseamnă că nu putem discuta tot ce este legat de Kubernetes. Așteptăm cu nerăbdare să împărtășim experiența noastră și să vorbim despre progresul echipei în această direcție în următorul nostru blog «Building a CI/CD platform for Pinterest».
Tipuri de resurse speciale
În funcție de nevoile specifice ale Pinterest, am dezvoltat următoarele CRD, care se potrivesc diferitelor fluxuri de lucru:
- PinterestService sunt servicii stateless care funcționează de mult timp. Multe dintre sistemele noastre principale se bazează pe un set de astfel de servicii.
- PinterestJobSet modelează seturi de lucrări cu ciclu complet. Există un scenariu comun în Pinterest în care mai multe lucrări pornesc aceleași containere în paralel, fără a depinde de alte procese similare.
- PinterestCronJob este utilizat pe scară largă în combinație cu sarcini periodice mici. Aceasta este o interfață pentru funcționarea nativă cron, cu mecanisme de suport Pinterest care se ocupă de securitate, trafic, jurnale și metrici.
- PinterestDaemon include daemon-urile infrastructurii. Această familie continuă să crească pe măsură ce adăugăm tot mai mult suport pentru clusterele noastre.
- PinterestTrainingJob se extinde la procesele Tensorflow și Pytorch, asigurând același nivel de suport pe durata execuției, ca și celelalte CRD. Deoarece Tensorflow și alte sisteme de învățare automată sunt utilizate activ în Pinterest, am avut motive să construim în jurul lor un CRD separat.
De asemenea, lucrăm la PinterestStatefulSet, care va fi adaptat în curând pentru stocarea de date și alte sisteme stateful.
Suport pentru mediu de execuție
Când un modul de aplicații este lansat în Kubernetes, acesta primește automat un certificat pentru a se identifica pe sine. Acest certificat este folosit pentru accesarea stocării secrete sau pentru comunicarea cu alte servicii prin mTLS. Între timp, configuratorul de inițializare a containerelor și Daemon-ul vor încărca toate dependențele necesare înainte de a lansa aplicația containerizată. Când totul este gata, sidecar-ul de trafic și Daemon-ul vor înregistra adresa IP a modulului în Zookeeper-ul nostru, astfel încât clienții să o poată descoperi. Totul va funcționa, deoarece modulul de rețea a fost configurat înainte de lansarea aplicației.
Mai sus sunt prezentate exemple tipice de suport pentru sarcini de lucru în timpul execuției. Pentru alte tipuri de sarcini de lucru poate fi necesar un suport puțin diferit, dar toate sunt prezentate sub formă de sidecar-uri la nivel de pod, noduri sau Daemon-uri la nivel de mașini virtuale. Ne asigurăm că totul este implementat în cadrul infrastructurii de gestionare și aliniat între aplicații, ceea ce reduce semnificativ sarcina în ceea ce privește lucrările tehnice și suportul pentru clienți.
Teste și QA
Am construit un pipeline de testare end-to-end pe baza infrastructurii de testare existente în Kubernetes. Aceste teste se aplică tuturor clusterelor noastre. Pipeline-ul nostru a suferit numeroase revizuiri înainte de a deveni parte a clusterului de producție.
Pe lângă sistemele de testare, avem sisteme de monitorizare și alertare care urmăresc constant starea componentelor sistemului, consumul de resurse și alte măsurători importante, notificându-ne doar atunci când este nevoie de intervenție umană.
Alternative
Am analizat câteva alternative pentru resurse personalizate, precum controlerele de acces mutaționale și sistemele de șabloane. Totuși, toate acestea vin cu dificultăți considerabile în operare, așa că am ales calea CRD.
Controlerul de acces mutațional a fost folosit pentru introducerea sidecar-urilor, variabilelor de mediu și altor suporturi în timpul execuției. Totuși, s-a confruntat cu diverse probleme, cum ar fi legarea resurselor și gestionarea ciclului lor de viață, în timp ce în CRD aceste probleme nu apar.
Notă: Sistemele de șabloane, cum ar fi diagramele Helm, sunt de asemenea utilizate pe scară largă pentru a lansa aplicații cu configurații similare. Cu toate acestea, aplicațiile noastre de lucru sunt prea diverse pentru a fi gestionate prin șabloane. De asemenea, în timpul desfășurării continue, utilizarea șabloanelor va genera prea multe erori.
Lucrările viitoare
Acum ne confruntăm cu o sarcină mixtă pe toate clusterele noastre. Pentru a susține astfel de procese de diferite tipuri și dimensiuni, lucrăm în următoarele direcții:
- Conjunto-ul de clustere distribuie aplicații mari pe diferite clustere pentru a asigura scalabilitatea și stabilitatea.
- Asigurarea stabilității, scalabilității și vizibilității clusterele pentru a crea legături între aplicație și SLA-ul său.
- Gestionarea resurselor și cotelor, astfel încât aplicațiile să nu intre în conflict între ele, iar scalabilitatea clusterei să fie controlată de către noi.
- Noua platformă CI/CD pentru sprijinirea și desfășurarea aplicațiilor în Kubernetes.
Sursa: habr.com
