

În actuala pandemie COVID-19, au apărut multe probleme, asupra cărora hackerii s-au aruncat cu plăcere. De la viziere imprimate 3D și măști fabricate acasă, până la înlocuirea unui aparat complet de ventilație mecanică, acest flux de idei a inspirat și încântat sufletul. În același timp, au existat încercări de a avansa și în alt domeniu: în cercetări vizând combaterea virusului însuși.
Se pare că cea mai mare potențială soluție pentru oprirea pandemiei actuale și pentru a anticipa toate cele viitoare se află în abordarea ce încearcă să ajungă la rădăcina problemei. Această abordare de tipul „cunoaște-ți inamicul” este promovată de proiectul computațional Folding@Home. Milioane de oameni s-au înregistrat în proiect și își donează o parte din puterea de calcul a procesoarelor și GPU-urilor lor, creând astfel cel mai mare [computator] distribuit din istorie.
Dar pentru ce sunt folosiți exact toți acești exaflopi? De ce este necesar să se concentreze o asemenea putere de calcul asupra ? Какая тут работает биохимия, зачем вообще белкам нужно укладываться? Вот краткий обзор фолдинга белков: что это, как он происходит и в чём его важность.
Pentru început, cel mai important: de ce sunt necesare proteinele?
Proteinele sunt structuri esențiale pentru viață. Ele nu doar oferă material de construcție pentru celule, ci și acționează ca enzime-catalizatori pentru practic toate reacțiile biochimice. Proteinele, fie că sunt sau , constau în lanțuri lungi de , aranjate într-o secvență specifică. Funcțiile proteinelor sunt determinate de ce aminoacizi sunt localizați în anumite locuri ale proteinei. De exemplu, dacă o proteină trebuie să se leagă de o moleculă încărcată pozitiv, locul de legare trebuie să fie umplut cu aminoacizi încărcați negativ.
Pentru a înțelege cum obțin proteinele structura care le determină funcția, este necesar să trecem prin noțiunile de bază ale biologiei moleculare și fluxul de informații în celulă.
Producția, sau proteinelor începe cu procesul de . În timpul transcripției, dublul helix de ADN, care conține informațiile genetice ale celulei, se desface parțial, oferind acces la bazele azotate ale ADN-ului pentru o enzimă numită . Sarcina ARN-polimerazei este de a crea o copie ARN, sau transcripție, a genei. Această copie a genei se numește (ARNm), reprezintă o molecule unică, perfectă pentru controlul fabricilor proteice intracelulare, , care se ocupă cu producția sau proteinelor.
Ribozomii acționează ca dispozitive de asamblare – ei prind modelul ARNm și îl asociază cu alte părți mici de ARN, (ARNt). Fiecare ARNt are două domenii active – o secțiune de trei baze numită , care trebuie să se potrivească cu codonii corespunzători din ARNm, și o zonă pentru legarea aminoacizilor, specifică pentru acest . În timpul translării, moleculele ARNt din ribozom încearcă în mod aleatoriu să se asocieze cu ARNm prin anticodoni. În caz de succes, molecula ARNt își atașează aminoacidul la cel anterior, formând un nou link în lanțul de aminoacizi codificat de ARNm.
Această secvență de aminoacizi reprezintă primul nivel al ierarhiei structurale a proteinelor, prin urmare este numit . Întreaga structură tridimensională a proteinei și funcțiile sale derivă direct din structura primară și depind de diferitele proprietăți ale fiecărui aminoacid și de interacțiunile lor. Dacă nu ar exista aceste proprietăți chimice și interacțiuni ale aminoacizilor, ar fi rămas secvențe liniare fără structură tridimensională. Acest lucru poate fi observat de fiecare dată când gătit – în acest proces are loc structurii tridimensionale a proteinelor.
Legăturile de lungă distanță ale părților proteinelor
Următorului nivel de structură tridimensională, care depășește structura primară, i s-a dat un nume ingenios . Aceasta include legături de hidrogen între aminoacizi relativ apropiați. Esența acestor interacțiuni stabilizatoare se reduce la două lucruri: și . Bucla alfa formează o porțiune strans răsucită a polipeptidelor, în timp ce foaia beta – o zonă netedă și largă. Ambele forme au proprietăți atât structurale, cât și funcționale, care depind de caracteristicile aminoacizilor care le compun. De exemplu, dacă bucla alfa constă în principal din aminoacizi hidrofili, cum ar fi sau , atunci este probabil să participe la reacții în apă.
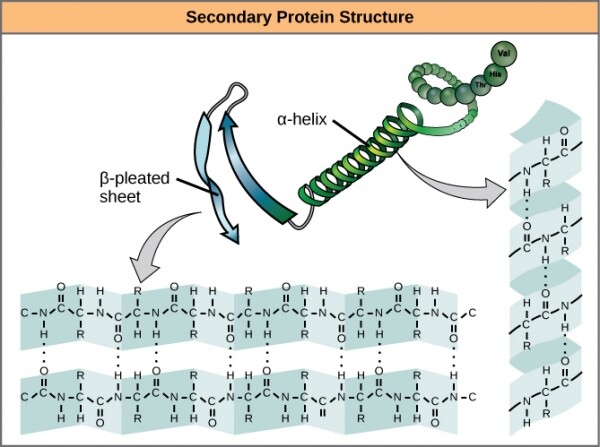
Alfa-spiralele și foile beta în proteine. Legăturile de hidrogen se formează în timpul expresiei proteinei.
Aceste două structuri și combinațiile lor formează următorul nivel al structurii proteinei — . Spre deosebire de fragmentele simple ale structurii secundare, structura terțiară este influențată în principal de hidrofobitate. În centrele majorității proteinelor se găsesc aminoacizi cu o hidrofobitate ridicată, de tipul sau , iar apa este exclusă din aceste zone datorită naturii „grase” a radicailor. Aceste structuri apar frecvent în proteinele transmembranare, integrate în dublul strat lipidic care înconjoară celulele. Regiunile hidrofobe ale proteinelor rămân termodinamic stabile în interiorul părții lipidice a membranei, iar regiunile hidrofobe ale proteinelor sunt expuse mediului acvatic de ambele părți.
De asemenea, stabilitatea structurilor terțiare este asigurată de interacțiuni pe distanțe lungi între aminoacizi. Un exemplu clasic al acestor legături este , care apare adesea între două radicale de cisteină. Dacă în salonul de coafură, în timpul procedurii de permanentare a părului unui client, ai simțit un miros ușor asemănător cu ouă stricate, atunci aceasta a fost o denaturare parțială a structurii terțiare a cheratinei conținute în păr, cauzată de reducerea legăturilor disulfidice prin intermediul amestecurilor .
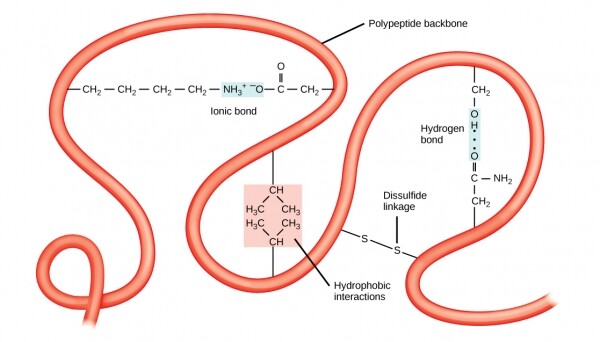
Structura terțiară este stabilizată prin interacțiuni pe distanțe lungi, cum ar fi hidrofobicitatea sau legăturile disulfidice.
Legăturile disulfidice pot apărea între dintr-un singur lanț polipeptidic sau între cisteine din lanțuri diferite. Interacțiunile dintre lanțuri diferite formează al structurii proteice. Un exemplu minunat de structură cvaternară este în sângele dumneavoastră. Fiecare moleculă de hemoglobină este alcătuită din patru globine identice, părți ale unei proteine, fiecare dintre ele fiind menținută într-o anumită poziție în interiorul polipeptidului prin punți disulfidice, precum și legată de o moleculă de heme care conține fier. Toate cele patru globine sunt legate între ele prin punți disulfidice intermoleculare, iar întreaga moleculă se leagă simultan de mai multe molecule de aer, până la patru, și este capabilă să le elibereze atunci când este necesar.
Modelarea structurilor în căutarea tratamentului bolii
Lanțurile polipeptidice încep să se plieze în forma finală în timpul traducerii, atunci când lanțul în creștere iese din ribozom – aproximativ cum un fir de metal cu memorie poate lua forme complexe atunci când este încălzit. Totuși, ca întotdeauna în biologie, lucrurile nu sunt atât de simple.
În multe celule, genele transcrise suferă o editare semnificativă înainte de a fi traduse, ceea ce modifică considerabil structura de bază a proteinei în comparație cu secvența pură a bazei genei. În acest proces, mecanismele de traducere colaborează adesea cu acompaniatori moleculare, proteine care se leagă temporar de lanțul polipeptidic în formare și care nu îi permit să adopte vreo formă intermediară din care ulterior nu ar putea trece la forma finală.
Toate acestea conduc la concluzia că prezicerea formei finale a unei proteine nu este o sarcină trivială. Decenii la rând, singura metodă de studiere a structurilor proteinelor au fost metodele fizice, cum ar fi cristale de raze X. Abia la sfârșitul anilor '60, chimiștii biofizici au început să construiască modele computaționale pentru plierea proteinelor, concentrându-se în mare parte pe modelarea structurii secundare. Aceste metode și urmașii lor necesită volume uriașe de date suplimentare pe lângă structura primară – de exemplu, tabele de unghiuri de legătură ale aminoacizilor, liste de hidrofobicitate, stări încărcate și chiar conservarea structurii și funcționarea pe intervale evolutive de timp – toate acestea pentru a deduce cum va arăta proteina finală.
Metodele de calcul de astăzi pentru prezicerea structurii secundare, care funcționează, printre altele, în rețeaua Folding@Home, au o precizie de aproximativ 80% – ceea ce este destul de bine, având în vedere complexitatea sarcinii. Datele obținute de modelele predictive pentru proteine precum proteina spike a SARS-CoV-2 vor fi corelate cu datele obținute prin studii fizice ale virusului. În cele din urmă, va fi posibil să obținem structura exactă a proteinei și, poate, să înțelegem cum se atașează virusul de receptori. din corpul uman, aflate în căile respiratorii care duc în interiorul corpului. Dacă reușim să înțelegem această structură, probabil vom putea găsi medicamente care blochează legarea și previn infecția.
Cercetările privind plierea proteinelor stau la baza înțelegerii noastre a unei cantități atât de mari de boli și infecții, încât chiar și atunci când prin intermediul rețelei Folding@Home vom descoperi cum să învingem COVID-19, ale cărui rate de creștere explozivă le observăm recent, această rețea nu va rămâne mult timp fără muncă. Este un instrument de cercetare excelent pentru a studia modelele proteice care stau la baza zeci de boli asociate cu plierea incorectă a proteinelor – cum ar fi boala Alzheimer sau o variantă a bolii Creutzfeldt-Jakob, pe care adesea o numim greșit „tulburarea vacii nebune”. Și când inevitabil va apărea un alt virus, vom fi deja pregătiți să începem din nou lupta cu el.
Sursa: habr.com
