

Cu toate că informațiile sunt acum abundente aproape peste tot, bazele de date analitice sunt încă destul de exotice. Puțini le cunosc bine și și mai puțini știu cum să le utilizeze eficient. Mulți continuă să "mănânce cactusul" cu MySQL sau PostgreSQL, care sunt concepute pentru alte scenarii, să se chinuie cu NoSQL sau să plătească prea mult pentru soluții comerciale. ClickHouse schimbă regulile jocului și reduce semnificativ greutatea de a pătrunde în lumea DBMS-urilor analitice.
Prezentarea de la BackEnd Conf 2018 și a fost publicată cu acordul prezentatorului.
Cine sunt eu și de ce vorbesc despre ClickHouse? Sunt director de dezvoltare la LifeStreet, care utilizează ClickHouse. În plus, sunt fondatorul Altinity. Acesta este un partener al Yandex care promovează ClickHouse și ajută Yandex să facă ClickHouse mai de succes. De asemenea, sunt dispus să împărtășesc cunoștințe despre ClickHouse.
Și nu sunt fratele lui Petya Zaytsev. Mă întreabă adesea despre asta. Nu, nu suntem frați.
«Este bine cunoscut», că ClickHouse:
- Este foarte rapid,
- Este foarte convenabil,
- Este folosit în Yandex.
Puțin mai puțin este cunoscut în ce companii și cum este utilizat.
Voi vorbi despre scopul, locul și modul în care este folosit ClickHouse, în afară de Yandex.
Voi explica cum sunt rezolvate sarcini specifice cu ajutorul ClickHouse în diferite companii, ce instrumente ClickHouse puteți utiliza pentru sarcinile voastre și cum au fost folosite în diverse companii.
Am selectat trei exemple care arată ClickHouse din perspective diferite. Cred că va fi interesant.
Prima întrebare: „De ce este nevoie de ClickHouse?”. Pare o întrebare destul de evidentă, dar există mai multe răspunsuri.
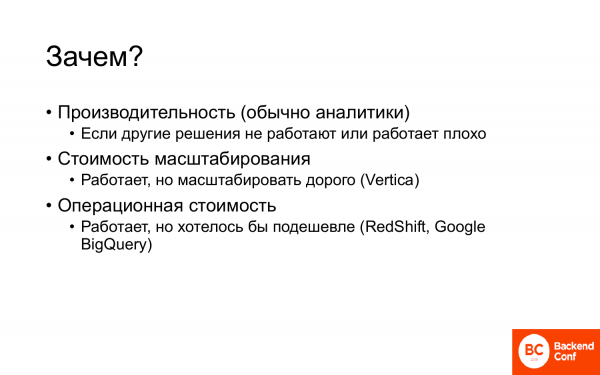
- Primul răspuns – din cauza performanței. ClickHouse este foarte rapid. Analiza pe ClickHouse este, de asemenea, foarte rapidă. Adesea, poate fi folosit acolo unde altceva funcționează foarte lent sau foarte prost.
- Al doilea răspuns – este costul. Și, în primul rând, costul scalării. De exemplu, Vertica – o bază de date complet diferită. Funcționează foarte bine dacă aveți doar câțiva terabaiți de date. Dar când vine vorba de sute de terabaiți sau de petabaiți, costul licenței și al suportului devine o sumă destul de considerabilă. Și este scump. Iar ClickHouse este gratuit.
- Răspunsul trei este costul operațional. Este o abordare puțin diferită. RedShift este un analog excelent. Pe RedShift poți crea foarte repede o soluție. Aceasta va funcționa bine, dar în fiecare oră, în fiecare zi și în fiecare lună vei plăti destul de mult către Amazon, deoarece acesta este un serviciu considerabil scump. Google BigQuery, de asemenea. Dacă cineva l-a folosit, știe că acolo poți lansa câteva interogări și să primești o factură care poate ajunge la sute de dolari dintr-o dată.
În ClickHouse nu există aceste probleme.
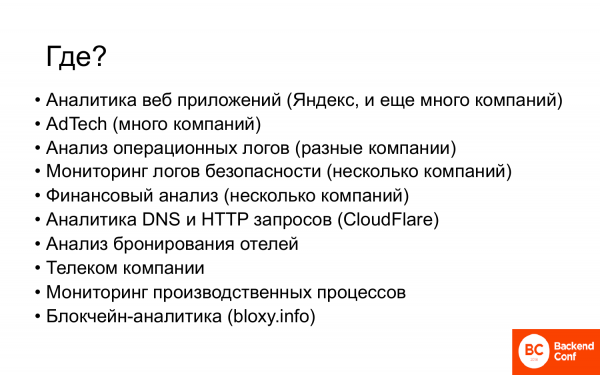
Unde se folosește acum ClickHouse? Pe lângă Yandex, ClickHouse este utilizat în multe afaceri și companii diferite.
- În primul rând, este vorba de analiza aplicațiilor web, adică acesta este un caz de utilizare care provine de la Yandex.
- Multe companii AdTech folosesc ClickHouse.
- Companii numeroase care au nevoie să analizeze jurnalele operaționale din diferite surse.
- Câteva companii folosesc ClickHouse pentru monitorizarea jurnalele de securitate. Le încarcă în ClickHouse, generează rapoarte, obțin rezultatele dorite.
- Companiile încep să îl folosească în analiza financiară, adică treptat, marile afaceri se îndreaptă și ele către ClickHouse.
- CloudFlare. Dacă cineva urmărește ClickHouse, cu siguranță a auzit de această companie. Este unul dintre contributorii importanți din comunitate. Și au o instalare ClickHouse foarte serioasă. De exemplu, au creat Kafka Engine pentru ClickHouse.
- Companiile telecomunicațiilor au început să folosească. Câteva companii folosesc ClickHouse fie ca dovadă de concept, fie deja în producție.
- O companie folosește ClickHouse pentru monitorizarea proceselor de producție. Testează cipuri, colectează o mulțime de parametri, în jur de 2.000 de caracteristici. Apoi analizează – un lot bun sau unul slab.
- Analiza blockchain. Există o companie rusă numită Bloxy.info. Aceasta face analiza rețelei ethereum. De asemenea, au făcut și asta pe ClickHouse.
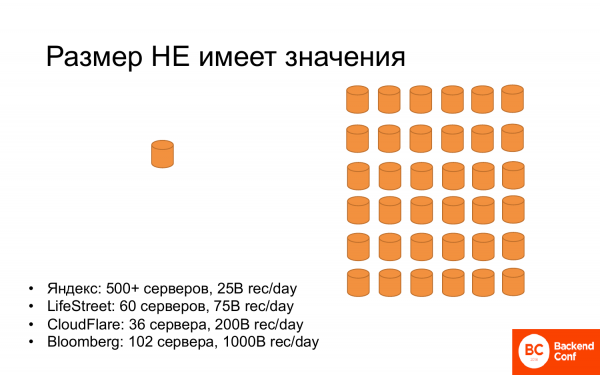
În plus, dimensiunea nu contează. Există multe companii care folosesc un singur server mic. Și acesta le permite să își rezolve problemele. Și chiar mai multe companii folosesc clustere mari formate din multe servere sau zeci de servere.
Și dacă ne uităm la recorduri:
- Yandex: 500+ servere, 25 de miliarde de înregistrări pe zi le păstrează acolo.
- LifeStreet: 60 de servere, aproximativ 75 de miliarde de înregistrări pe zi. Mai puține servere, dar mai multe înregistrări decât la Yandex.
- CloudFlare: 36 servere, 200 de miliarde de înregistrări pe zi pe care le păstrează. Au și mai puține servere și și mai multe date pe care le păstrează.
- Bloomberg: 102 server, aproximativ un trilion de înregistrări pe zi. Record la înregistrări.
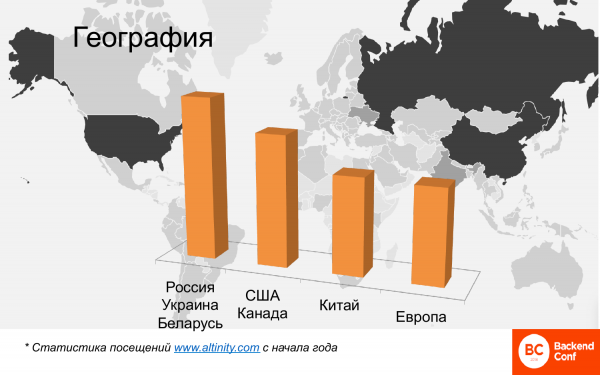
Geografic, acesta este de asemenea mult. Această hartă arată heatmap-ul unde ClickHouse este folosit în lume. Aici se evidențiază Rusia, China, America. Țările europene sunt puține. Și se pot distinge 4 clustere.
Acesta este un analiz comparativ, nu trebuie să căutăm cifre absolute. Aceasta este o analiză a vizitatorilor care citesc materiale în engleză pe site-ul Altinity, deoarece nu sunt vorbitori de rusă. Iar Rusia, Ucraina, Belarus, adică partea rusofonă a comunității, sunt cei mai numerosi utilizatori. Apoi urmează SUA și Canada. China își accelerează foarte mult ritmul. Acum șase luni, China aproape că nu era, iar acum China a depășit deja Europa și continuă să crească. Bătrâna Europă nu întârzie, iar liderul utilizării ClickHouse – surprinzător, este Franța.
De ce vă povestesc toate acestea? Pentru a arăta că ClickHouse devine soluția standard pentru analiza datelor mari și este deja folosită pe foarte multe fronturi. Dacă îl folosiți, sunteți pe drumul cel bun. Dacă nu l-ați folosit încă, nu trebuie să vă temeți că veți rămâne singuri și că nimeni nu vă va ajuta, deoarece deja mulți se ocupă cu aceasta.
Acestea sunt exemple reale de utilizare a ClickHouse în câteva companii.
- Primul exemplu – este o rețea de publicitate: migrarea de la Vertica la ClickHouse. Știu câteva companii care au trecut de la Vertica sau sunt în proces de migrare.
- Al doilea exemplu – un stocare tranzacțională pe ClickHouse. Acesta este un exemplu construit pe antipattern-uri. Tot ce nu trebuie făcut în ClickHouse conform sfaturilor dezvoltatorilor este aici realizat. Și, în plus, este realizat atât de eficient încât funcționează. Și funcționează mult mai bine decât o soluție tranzacțională tipică.
- Al treilea exemplu – este calculul distribuit pe ClickHouse. A fost o întrebare despre cum poate fi integrat ClickHouse în ecosistemul Hadoop. Voi arăta un exemplu despre cum o companie a realizat pe ClickHouse ceva asemănător containerului map reduce, urmărind localizarea datelor etc., pentru a rezolva o problemă foarte complexă.
- LifeStreet – Este o companie de Ad Tech care are toate tehnologiile aferente rețelei de publicitate.
- Se ocupă cu optimizarea anunțurilor, programmatic bidding.
- Multe date: aproximativ 10 miliarde de evenimente pe zi. În plus, aceste evenimente pot fi împărțite în mai multe subevenimente.
- Multe clienți au nevoie de aceste date, iar aceștia nu sunt doar oameni, ci și diverse algoritmi care se ocupă de programmatic bidding.
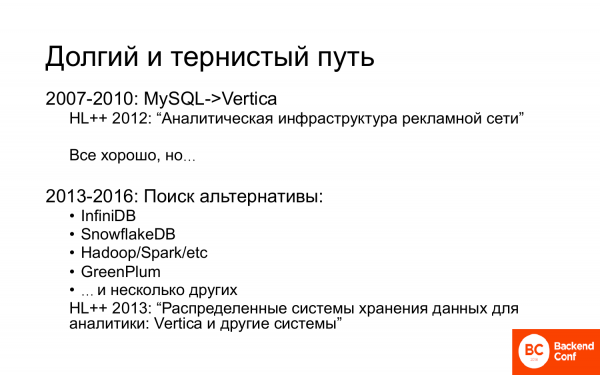
Compania a trecut printr-un drum lung și sinuos. Am vorbit despre el la HighLoad. La început, LifeStreet a migrat de la MySQL (cu o scurtă oprire pe Oracle) la Vertica. Puteți găsi o poveste despre asta.
Și totul mergea foarte bine, dar destul de repede a devenit clar că datele cresc și Vertica este costisitor. Astfel, am căutat diverse alternative. Unele dintre ele sunt enumerate aici. De fapt, am realizat un proof of concept sau uneori testări de performanță pentru aproape toate bazele de date disponibile pe piață în perioada 2013-2016 care se potriveau funcționalității. Despre o parte dintre ele am vorbit și la HighLoad.
Obiectivul era – a migra de la Vertica, în primul rând, deoarece datele creșteau. Și au crescut exponențial timp de câțiva ani. Apoi au ajuns pe o platformă stabilă, dar cu toate acestea, prognozând această creștere, cerințele de afaceri pentru volumul de date necesar pentru realizarea unei analize au arătat că în curând se va vorbi despre petabyți. Iar pentru petabyți plățile sunt deja foarte scumpe, așa că am căutat o alternativă unde să ne îndreptăm.
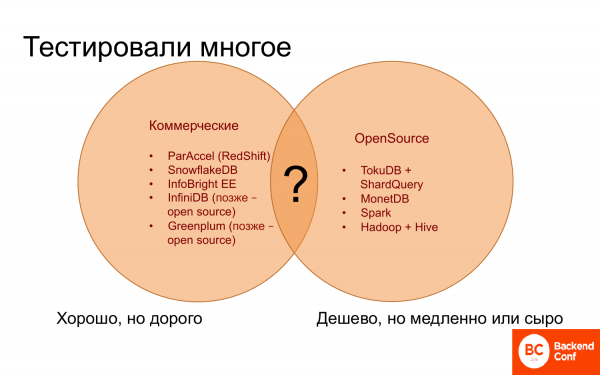
Unde să ne îndreptăm? O perioadă lungă de timp a fost complet neclar în ce direcție să ne îndreptăm, deoarece, pe de o parte, există baze de date comerciale, care par să funcționeze bine. Unele funcționează aproape la fel de bine ca Vertica, iar altele mai puțin bine. Dar toate sunt costisitoare, nu am reușit să găsim nimic mai ieftin și mai bun.
Pe de altă parte, există soluții open source, dar nu foarte multe, adică pentru analize acestea pot fi numărate pe degete. Și sunt gratuite sau ieftine, dar funcționează lent. Și de multe ori le lipsesc funcționalitățile necesare și utile.
Așadar, nu existau soluții care să combine avantajele bazelor de date comerciale și tot ceea ce este gratuit în open source.
Nu existau soluții până când, în mod surprinzător, Yandex nu a scos ClickHouse, ca un magician scoate un iepure din pălărie. Și aceasta a fost o soluție neașteptată, iar întrebarea rămâne: „De ce?”, dar, cu toate acestea.
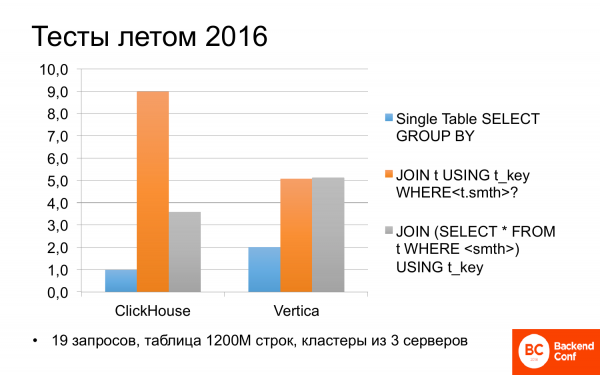
Și imediat în vara anului 2016 am început să ne uităm ce este ClickHouse. Și s-a dovedit că uneori poate fi mai rapid decât Vertica. Am testat diferite scenarii pe diverse interogări. Și dacă interogarea folosea doar un singur tabel, adică fără tipuri de join, ClickHouse era de două ori mai rapid decât Vertica.
Nu am ezitat și am verificat și teste recente ale Yandex. Acolo este același lucru: ClickHouse este de două ori mai rapid decât Vertica, motiv pentru care vorbesc frecvent despre asta.
Dar dacă interogările au join-uri, atunci situația devine mai ambiguă. Și ClickHouse poate fi de două ori mai lent decât Vertica. Dar dacă ajustezi puțin interogarea și o rescrii, devin aproximativ egale. Nu e rău. Și gratuit.
După ce am obținut rezultatele testelor și le-am privit din diferite perspective, LifeStreet a trecut la ClickHouse.
Este anul 2016, reamintesc. A fost ca în gluma cu șoarecii care plângeau și se înțepau, dar continuau să mănânce cactusul. Despre asta s-a discutat în detaliu, există un videoclip pe această temă și așa mai departe.
De aceea nu voi detalia mult despre asta, ci voi vorbi doar despre rezultate și câteva lucruri interesante despre care nu am vorbit atunci.
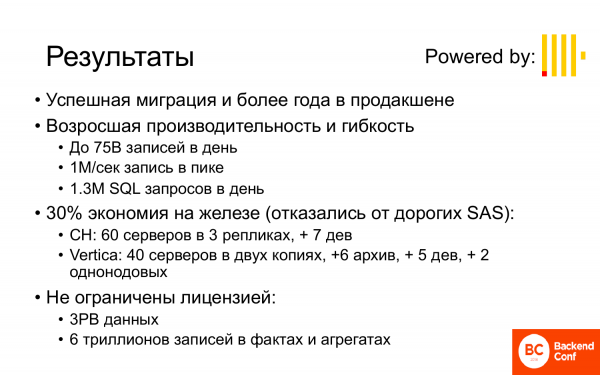
Rezultatele sunt acestea:
- Migrarea a fost un succes și sistemul funcționează deja în producție de mai bine de un an.
- Performanța și flexibilitatea au crescut. Din cele 10 miliarde de înregistrări pe care le-am putut stoca pe zi, și acelea pentru scurt timp, acum LifeStreet stochează 75 de miliarde de înregistrări pe zi și poate face asta timp de 3 luni sau mai mult. Dacă calculăm la vârf, se salvează până la un milion de evenimente pe secundă. Peste un milion de interogări SQL pe zi ajung în acest sistem, în principal de la diferite roboți.
- În ciuda faptului că pentru ClickHouse au fost folosite mai multe servere decât pentru Vertica, economiile și la hardware s-au realizat, deoarece în Vertica se utilizau discuri SAS destul de scumpe. În ClickHouse s-au folosit SATA. Și de ce? Pentru că în Vertica inserarea este sincronă. Și sincronizarea necesită ca discurile să nu fie foarte lente, iar rețeaua să nu fie foarte lentă, adică o operațiune destul de costisitoare. În schimb, în ClickHouse inserarea este asincronă. Mai mult, poți scrie întotdeauna local, fără costuri suplimentare, astfel că datele în ClickHouse pot fi inserate mult mai repede decât în Vertica, chiar și pe discuri care nu sunt cele mai rapide. Iar la citire este aproape egal. Citirea pe SATA, dacă sunt într-un RAID, este destul de rapidă.
- Fără restricții de licență, adică 3 petabytes de date pe 60 de servere (20 de servere reprezintă o replică) și 6 trilioane de înregistrări în fapte și agregate. Nimic similar nu și-ar fi putut permite Vertica.
Acum voi trece la aspectele practice în acest exemplu.
- Primul - este schema eficientă. De schema depinde foarte mult.
- Al doilea - este generarea de SQL eficient.
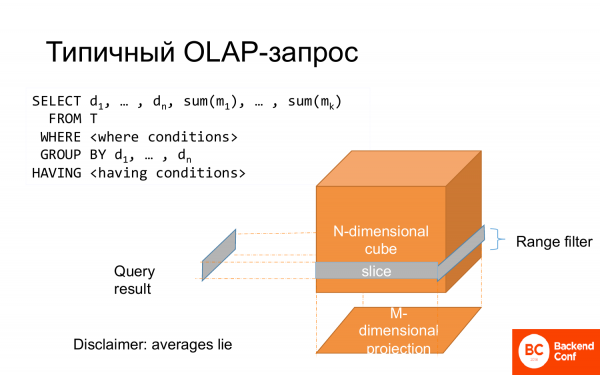
O interogare OLAP tipică este un select. O parte din coloane merge în group by, o parte din coloane merge în funcții de agregare. Există un where, care poate fi văzut ca o fereastră a cubului. Întregul group by poate fi văzut ca o proiecție. De aceea se numește analiză multidimensională a datelor.
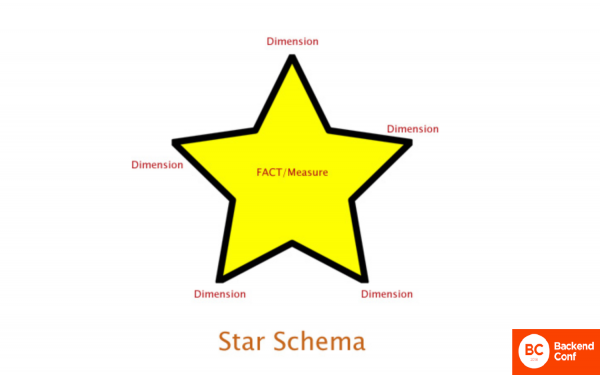
Și adesea este modelat sub formă de schemă stea, când există un fapt central și caracteristicile acestui fapt de-a lungul razelor.
Și din perspectiva designului fizic, a modului în care se așază pe tabelă, de obicei se face o reprezentare normalizată. Puteți denormaliza, dar este costisitor în ceea ce privește discurile și nu foarte eficient pentru interogări. De aceea, de obicei, se face o reprezentare normalizată, adică o tabelă de fapte și multe tabele de dimensiuni.
Dar în ClickHouse, aceasta funcționează prost. Există două motive:
- Primul - este pentru că în ClickHouse join-urile (join) nu sunt foarte bune, adică există join-uri (join), dar sunt slabe. Deocamdată slabe.
- Al doilea - este că tabelele nu sunt actualizate. De obicei, în aceste tabele, care sunt în jurul schemei de stea, trebuie să schimbi ceva. De exemplu, numele clientului, numele companiei și altele. Și asta nu funcționează.
Și există o soluție în ClickHouse. Chiar două:
- Primul - este utilizarea dicționarelor. Dicționarele externe sunt ceea ce ajută la rezolvarea cu 99% a problemei cu schema de stea, cu actualizările și altele.
- Al doilea - este utilizarea masivelor. Masivele ajută, de asemenea, să scapi de join-uri (join) și de problemele cu normalizarea.
- Nu este nevoie de join-uri (join).
- Actualizabile. Din martie 2018, a apărut o funcționalitate nedocumentată (nu o veți găsi în documentație) de a actualiza parțial dicționarele, adică acele înregistrări care s-au schimbat. Practic - este ca o tabelă.
- Întotdeauna în memorie, de aceea join-urile (join) cu dicționarul funcționează mai repede decât dacă ar fi fost o tabelă care stă pe disc și nici măcar nu este sigur că se află în cache, cel mai probabil nu.
- De asemenea, nu este nevoie de join-uri (join).
- Aceasta este o reprezentare compactă 1 la mulți.
- Și, în opinia mea, masivele sunt realizate pentru geek-i. Acestea sunt funcții lambda și altele.
Aceasta nu este o simplă afirmație. Este o funcționalitate extrem de puternică, care permite realizarea multor lucruri foarte simplu și elegant.
Exemple tipice care ajută la gestionarea array-urilor. Aceste exemple sunt simple și suficient de illustrative:
- Căutare după etichete. Dacă aveți hashtag-uri și doriți să găsiți anumite înregistrări după hashtag.
- Căutare după perechi key-value. Există, de asemenea, anumite atribute cu valori.
- Stocarea listelor de chei pe care trebuie să le traduceți în altceva.
Toate aceste sarcini pot fi rezolvate fără array-uri. Etichetele pot fi puse într-un șir și selectate cu ajutorul expresiilor regulate sau într-un tabel separat, dar atunci va trebui să faceți join-uri.
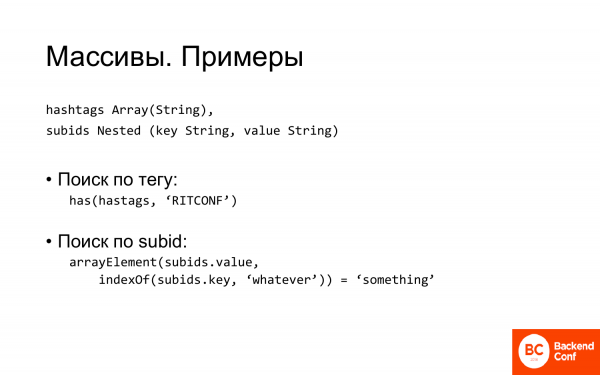
În ClickHouse nu trebuie să faceți nimic, este suficient să descrieți un array de string-uri pentru hashtag-uri sau să realizați o structură înfășurată pentru sisteme de tip key-value.
Structura înfășurată – poate nu este cel mai fericit nume. Acesta este compus din două array-uri care au o parte comună în nume și câteva caracteristici asociate.
Și căutarea după etichete este foarte simplă. Există o funcție has, care verifică dacă un element există în array. Asta este, am găsit toate înregistrările care aparțin conferinței noastre.
Căutarea după subid este puțin mai complicată. Trebuie mai întâi să găsim indexul cheii, iar apoi să luăm elementul cu acel index și să verificăm dacă valoarea este cea pe care o căutăm. Dar, cu toate acestea, este foarte simplu și compact.
Expresia regulată pe care ați dori să o scrieți, dacă ați stoca totul într-un singur șir, ar fi, pe de o parte, ciudată. Iar, pe de altă parte, ar funcționa mult mai lent decât cele două array-uri.
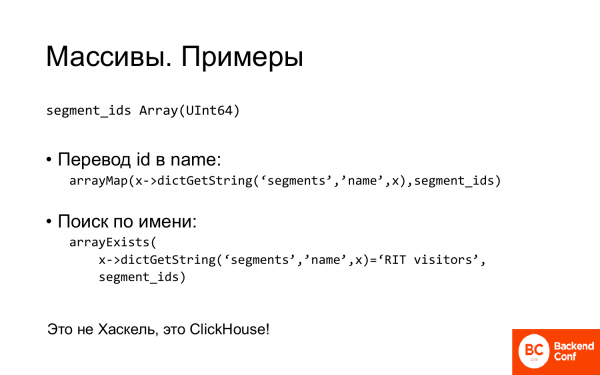
Un alt exemplu. Aveți un array în care stocați ID-urile. Și le puteți traduce în nume. Funcția arrayMap. Aceasta este o funcție lambda tipică. Transmiteți expresii lambda. Și ea extrage valoarea numelui pentru fiecare ID din dicționar.
În mod similar, se poate face și căutarea. Se transmite o funcție predicat care verifică cu ce se potrivesc elementele.
Aceste lucruri simplifică mult schema și rezolvă o mulțime de probleme.
Dar următoarea problemă cu care ne-am confruntat și despre care aș dori să menționez, este cererile eficiente.
- În ClickHouse nu există un planificator de cereri. Deloc.
- Dar, cu toate acestea, cererile complexe trebuie să fie planificate. În ce cazuri?
- Dacă există mai multe joinuri în interogare, pe care le înfășurați în subinterogări. Și ordinea în care sunt executate este importantă.
- Și al doilea – dacă interogarea este distribuită. Pentru că în interogările distribuite, doar cea mai interioară subinterogare se execută distribuit, iar restul este trimis pe un singur server, la care v-ați conectat și se execută acolo. Așadar, dacă aveți interogări distribuite cu multe joinuri, trebuie să selectați ordinea.
Și chiar și în cazuri mai simple, uneori este necesar să faceți treaba planificatorului și să rescrieți puțin interogările.
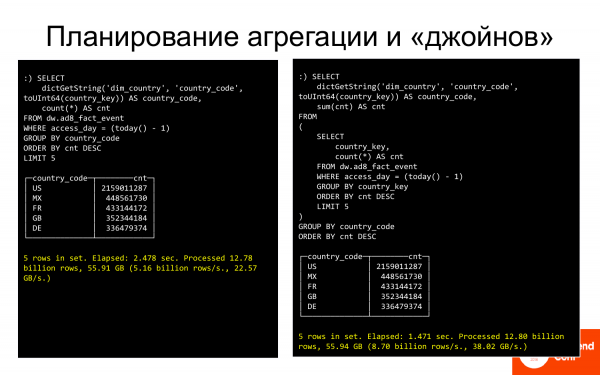
Iată un exemplu. Pe partea stângă, o interogare care arată primele 5 țări. Și aceasta se execută în 2,5 secunde, cred. Iar pe partea dreaptă, aceeași interogare, dar puțin rescrisă. În loc să grupăm după șiruri, am început să grupăm după cheie (int). Și asta este mai rapid. Apoi, am conectat un dicționar la rezultat. În loc de 2,5 secunde, interogarea se execută în 1,5 secunde. Asta e bine.
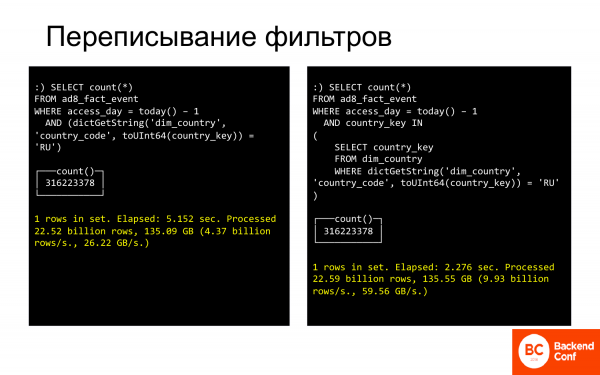
Un exemplu similar cu rescrierea filtrelor. Aici este o interogare pentru Rusia. Aceasta se execută în 5 secunde. Dacă o rescriem astfel încât să comparăm din nou nu șiruri, ci numere cu un set de chei care se referă la Rusia, atunci va fi mult mai rapid.
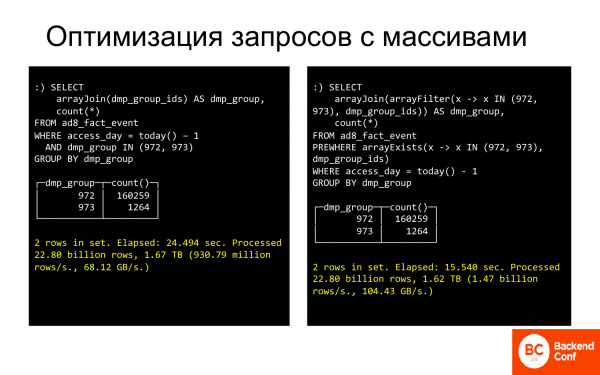
Există multe astfel de trucuri. Și acestea permit o accelerare semnificativă a interogărilor, care vi se par că deja funcționează rapid sau, dimpotrivă, funcționează lent. Le puteți face și mai rapide.
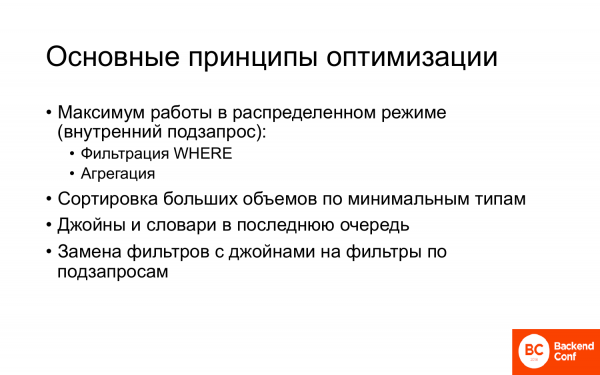
- Maximum de muncă în modul distribuit.
- Sortarea după tipuri minime, așa cum am făcut eu cu int.
- Dacă există unele joinuri, dicționare, este mai bine să le faceți în ultima etapă, când aveți deja datele cel puțin parțial grupate, atunci operația de join sau apelul dicționarului va fi apelat de mai puține ori și va fi mai rapid.
- Înlocuirea filtrelor.
Există și alte tehnici, nu doar cele pe care le-am demonstrat. Și toate acestea permit uneori accelerarea semnificativă a execuției interogărilor.
Trecem la următorul exemplu. Compania X din SUA. Ce face aceasta?
A fost o sarcină:
- Legarea offline a tranzacțiilor publicitare.
- Modelarea diferitelor modele de legare.
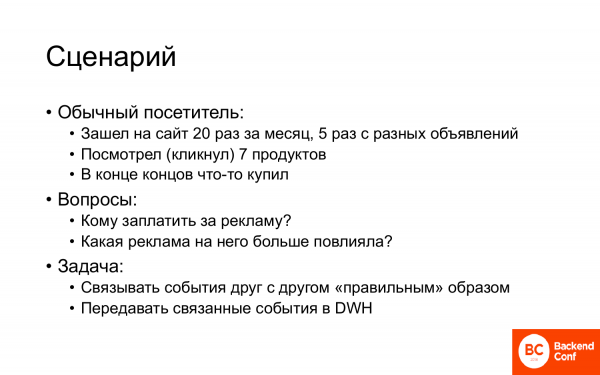
În ce constă scenariul?
Un vizitator obișnuit accesează site-ul, de exemplu, de 20 de ori pe lună din diferite reclame sau vine pur și simplu uneori fără nicio reclamă, pentru că își amine că a fost pe acest site. Se uită la diverse produse, le adaugă în coș, le scoate din coș. Și, în cele din urmă, cumpără ceva.
Întrebări rezonabile: „Cui trebuie să plătim pentru publicitate, dacă este necesar?” și „Ce reclamă a influențat-o, dacă a influențat-o?”. Adică, de ce a cumpărat și cum să facem ca oamenii asemănători cu acesta să cumpere de asemenea?
Pentru a rezolva această sarcină, este necesar să corelăm evenimentele care au loc pe site-ul web într-un mod corect, adică să construim o legătură între ele. Apoi, să le trimitem pentru analiză în DWH. Pe baza acestei analize, să construim modele pentru a arăta cui și ce reclamă.
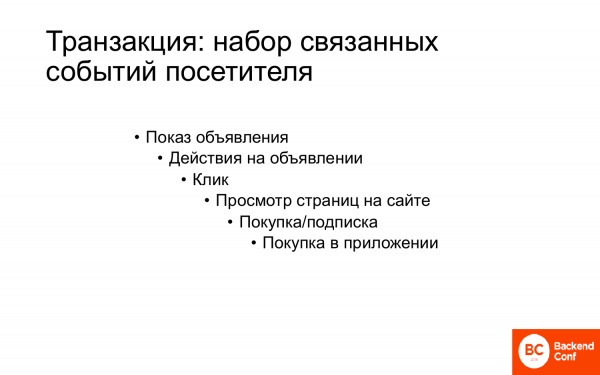
O tranzacție publicitară este un set de evenimente corelate ale utilizatorului, care încep de la afișarea reclamei, apoi se întâmplă ceva, poate o cumpărare, și apoi pot exista achiziții în cadrul achiziției. De exemplu, dacă este o aplicație mobilă sau un joc mobil, de obicei instalarea aplicației este gratuită, iar dacă se face ceva ulterior, este posibil să fie necesari bani. Și cu cât o persoană cheltuie mai mult în aplicație, cu atât este mai valoroasă. Dar pentru asta trebuie să le corelăm pe toate.
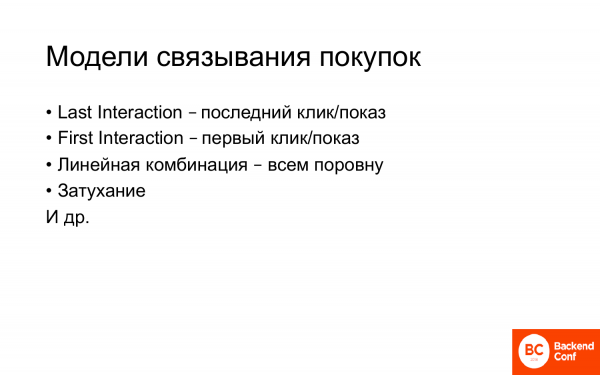
Există multe modele de corelare.
Cele mai populare sunt:
- Ultima interacțiune, unde interacțiunea este fie un clic, fie o afișare.
- Prima interacțiune, adică prima care a adus persoana pe site.
- Combinatie liniară – toate sunt tratate la fel.
- Dezintegrare.
- Și altele.
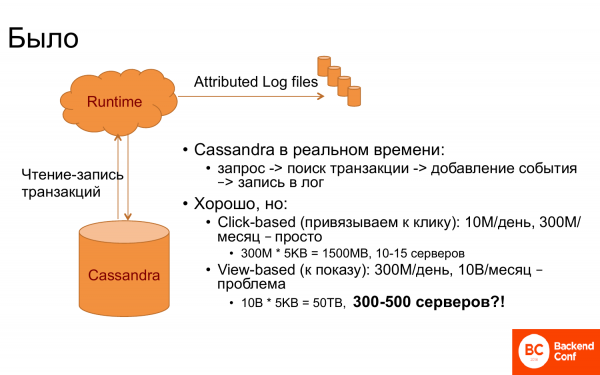
Și cum a funcționat totul inițial? A existat Runtime și Cassandra. Cassandra a fost utilizată ca stocare de tranzacții, adică în ea erau stocate toate tranzacțiile corelate. Și când apărea un eveniment în Runtime, de exemplu, vizualizarea unei pagini sau altceva, se făcea o cerere în Cassandra – există această persoană sau nu. Apoi erau preluate tranzacțiile care îi corespundeau. Și se realiza corelarea.
Și dacă a fost norocul ca în cerere să fie un id de tranzacție, atunci este ușor. Dar de obicei, nu este noroc. De aceea trebuia să găsim ultima tranzacție sau tranzacția cu ultimul clic și așa mai departe.
Și totul a funcționat foarte bine, până când asocierea a fost legată de ultimul clic. Pentru că sunt, să spunem, 10 milioane de clicuri pe zi, 300 de milioane pe lună, dacă stabilim o fereastră de o lună. Și deoarece în Cassandra totul trebuie să fie în memorie pentru a funcționa rapid, deoarece runtime-ul trebuie să răspundă rapid, erau necesari aproximativ 10-15 servere.
Dar când am dorit să legăm tranzacția de afișare, s-a dovedit imediat că nu este atât de simplu. De ce? Se vede că trebuie să stocăm cu 30 de ori mai multe evenimente. Și, în consecință, avem nevoie de 30 de ori mai multe servere. Și rezultatul este că aceasta este o cifră astronomică. Să menții până la 500 de servere pentru a face legătura, având în vedere că în runtime sunt considerabil mai puține servere, aceasta este o cifră greșită. Și am început să ne gândim ce să facem.
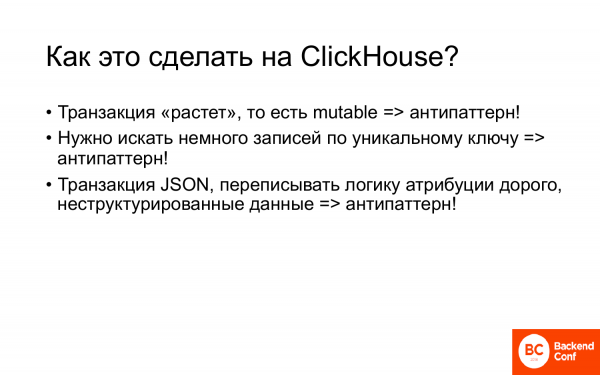
Și am ajuns la ClickHouse. Dar cum să facem asta pe ClickHouse? La prima vedere, pare un set de antipattern-uri.
- Tranzacția crește, ne atașăm tot mai multe evenimente noi la ea, adică este mutabilă, iar ClickHouse nu funcționează foarte bine cu obiectele mutabile.
- Când un vizitator vine la noi, trebuie să extragem tranzacțiile lui după cheie, după visit id. Aceasta este, de asemenea, o interogare punctuală, dar în ClickHouse nu se fac astfel de lucruri. De obicei, în ClickHouse se face scanări mari, dar aici trebuie să obținem câteva înregistrări. Este iarăși un antipattern.
- În plus, tranzacția era în json, dar nu voiam să o rescriem, așa că am dorit să păstrăm json-ul neestructurat, iar dacă era necesar, să extragem ceva din el. Și aceasta este tot un antipattern.
Adică, un set de antipattern-uri.
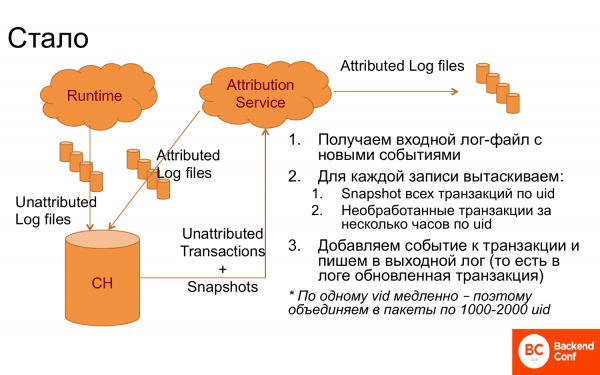
Dar, cu toate acestea, am reușit să realizăm un sistem care a funcționat foarte bine.
Ce a fost făcut? A fost implementat ClickHouse, în care erau încărcate jurnalele, împărțite în înregistrări. A fost creat un serviciu de atribuire, care primea jurnalele din ClickHouse. După aceea, pentru fiecare înregistrare după visit id obținea tranzacțiile, care puteau fi încă neprelucrate, și plus instantanee, adică tranzacțiile deja legate, și anume rezultatul muncii anterioare. Din acestea deja făcea logica, alegea tranzacția corectă, conecta noi evenimente. Înregistrarea a fost din nou scrisă în jurnal. Jurnalul se întorcea în ClickHouse, adică era un sistem ciclic constant. Și, în plus, se trimitea în DWH pentru a fi analizat acolo.
În această formă, nu a funcționat foarte bine. Și pentru a simplifica ClickHouse, atunci când s-a făcut o interogare după visit id, aceste interogări au fost grupate în blocuri de 1.000-2.000 de visit id-uri pentru a extrage toate tranzacțiile pentru 1.000-2.000 de persoane. Astfel, a funcționat.
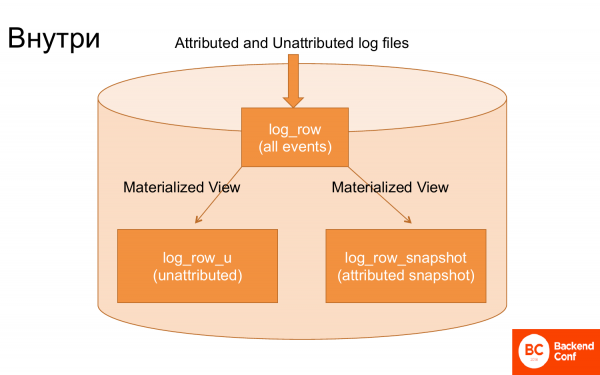
Dacă privim în interiorul ClickHouse, există doar 3 tabele principale care se ocupă de toate acestea.
Primul tabel, în care sunt încărcate logurile, este practic încărcat fără prelucrare.
Al doilea tabel. Prin intermediul unei vizualizări materializate, din aceste loguri au fost extrase evenimentele care nu au fost atribuite, adică cele necorelate. Și printr-o vizualizare materializată s-au extras tranzacțiile pentru construirea unei snapshot. Adică, o vizualizare materializată specială a construit snapshot-ul, și anume ultima stare acumulată a tranzacției.
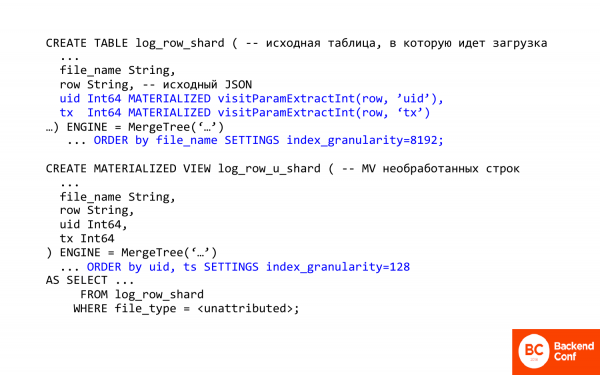
Aici este scris un text în SQL. Aș dori să comentez câteva aspecte importante în el.
Primul aspect important este posibilitatea în ClickHouse de a extrage coloane, câmpuri din json. Adică, ClickHouse are anumite metode pentru a lucra cu json. Acestea sunt foarte, foarte primitive.
visitParamExtractInt permite extragerea atributelor din json, adică prima apariție se activează. Astfel, se poate extrage id-ul tranzacției sau id-ul vizitei. Acesta este un aspect.
Al doilea – aici a fost utilizat un câmp materializat ingenios. Ce înseamnă aceasta? Înseamnă că nu îl poți insera în tabel, adică nu se inserează, ci se calculează și se stochează la inserare. La inserare, ClickHouse face munca pentru tine. Și astfel se extrage din json ceea ce vei avea nevoie ulterior.
În acest caz, vizualizarea materializată este pentru rândurile neprelucrate. Și folosește primul tabel cu loguri practic brute. Și ce face? În primul rând, schimbă ordinea, adică acum ordonarea se face după visit id, pentru că avem nevoie să extragem rapid tranzacția specifică unei anumite persoane.
Al doilea aspect important este index_granularity. Dacă ați văzut MergeTree, de obicei, index_granularity este setat la 8.192. Ce este aceasta? Este parametrul de sparsitate a indexului. În ClickHouse, indexul este rar, el nu indexează niciodată fiecare înregistrare. Face acest lucru la fiecare 8.192. Și este bine când trebuie să contabilizezi multe date, dar este rău când este puțin, din cauza overhead-ului mare. Și dacă reduci index granularity, reduci overhead-ul. Nu se poate reduce la unu, pentru că ar putea să nu fie suficientă memorie. Indexul este întotdeauna stocat în memorie.
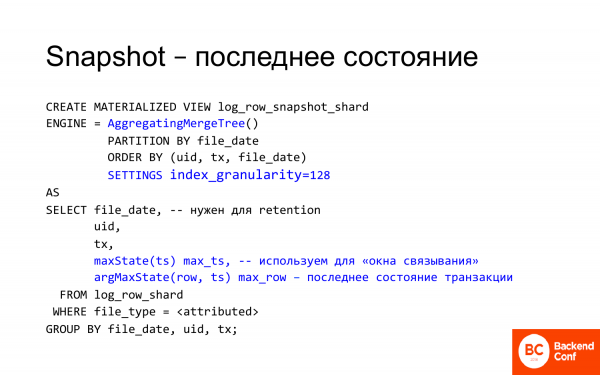
Snapshotul utilizează și alte funcții interesante ale ClickHouse.
În primul rând, există AggregatingMergeTree. În AggregatingMergeTree se stochează argMax, adică este starea tranzacției corespunzătoare celei mai recente date. Tranzacțiile sunt generate constant pentru acest vizitator. Și în cea mai recentă stare a acelei tranzacții am adăugat un eveniment și am obținut o nouă stare. A revenit din nou în ClickHouse. Și prin argMax, în această vedere materializată, putem obține întotdeauna starea actuală.
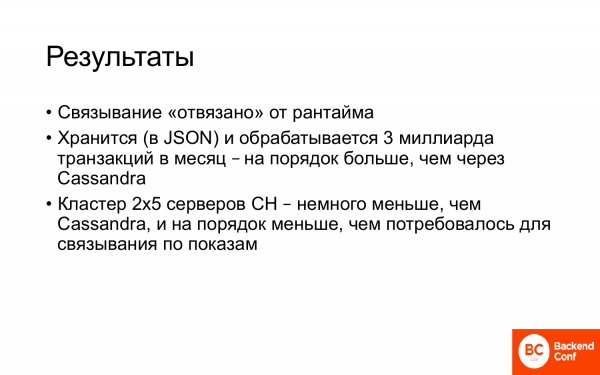
- Legarea este "decuplată" de Runtime.
- Se stochează și se procesează până la 3 miliarde de tranzacții pe lună. Aceasta este cu mult mai mult decât era în Cassandra, adică într-un sistem tranzacțional tipic.
- Cluster de 2x5 servere ClickHouse. 5 servere, fiecare având o replică. Acesta este chiar mai puțin decât era în Cassandra, pentru a realiza atribuire bazată pe click, iar aici avem atribuire bazată pe impresii. Adică, în loc să creștem numărul de servere de 30 de ori, am reușit să le reducem.
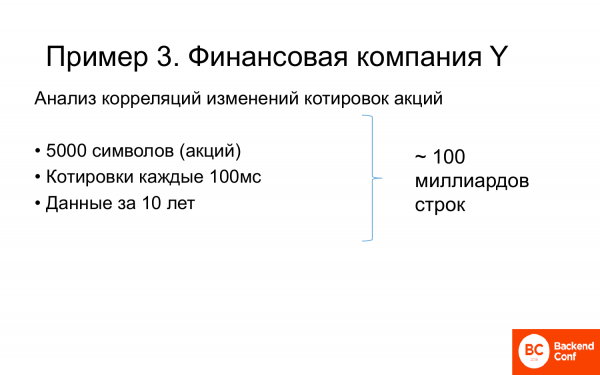
Și ultimul exemplu este compania financiară Y, care a analizat corelațiile modificărilor cotelor de acțiuni.
Și sarcina era următoarea:
- Există aproximativ 5.000 de acțiuni.
- Cotțiile sunt cunoscute la fiecare 100 de milisecunde.
- Datele s-au acumulat în 10 ani. Evident, pentru unele companii mai mult, pentru altele mai puțin.
- În total, aproximativ 100 de miliarde de rânduri.
Și trebuia să se calculeze corelația modificărilor.
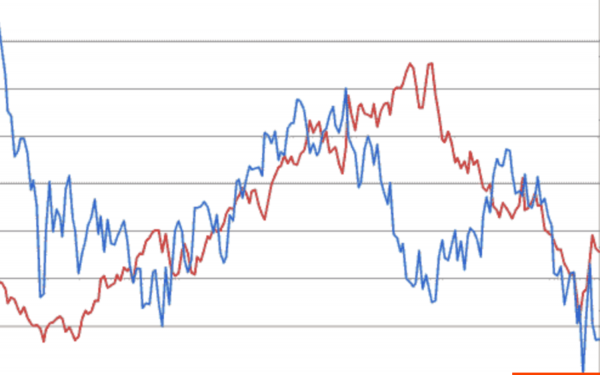
Aici sunt două acțiuni și cotele lor. Dacă una crește, și cealaltă crește, atunci este o corelație pozitivă, adică una crește, iar cealaltă crește. Dacă una crește, așa cum se vede la finalul graficului, iar cealaltă scade, atunci este o corelație negativă, adică atunci când una crește, cealaltă scade.
Analizând aceste variații reciproce, se pot face predicții pe piața financiară.
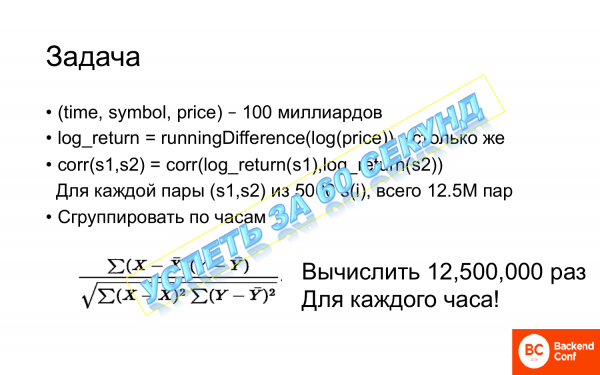
Dar sarcina este complicată. Ce se face pentru asta? Avem 100 de miliarde de înregistrări, în care sunt: timp, acțiune și preț. Trebuie să calculăm mai întâi 100 de miliarde de ori diferența de rulare a algoritmului prețului. Diferența de rulare este o funcție în ClickHouse care calculează diferența dintre două rânduri în mod secvențial.
Și după aceasta trebuie să calculăm corelația, iar corelația trebuie calculată pentru fiecare pereche. Pentru 5.000 de acțiuni, există 12,5 milioane de perechi. Și aceasta este mult, adică de 12,5 ori trebuie să calculăm o astfel de funcție de corelație.
Și dacă cineva a uitat, atunci x și y sunt așteptările matematice pe baza eșantionului. Adică nu este suficient să calculăm doar rădăcinile și sumele, ci trebuie să calculăm și alte sume în interiorul acestor sume. Trebuie să efectuezi o mulțime de calcule de 12,5 milioane de ori, iar apoi trebuie să le grupăm pe ore. Și avem și multe ore. Trebuie să ne încadrăm în 60 de secunde. Este o glumă.
Trebuia să ne descurcăm cumva, pentru că totul funcționa foarte, foarte lent, înainte de a veni ClickHouse.
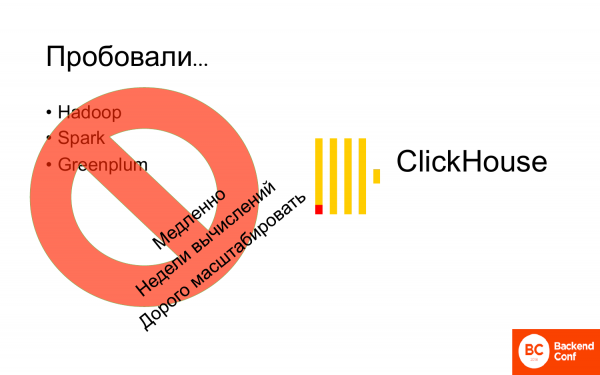
Au încercat să calculeze asta pe Hadoop, pe Spark, pe Greenplum. Și totul era foarte lent sau costisitor. Adică, se putea calcula cumva, dar era scump.
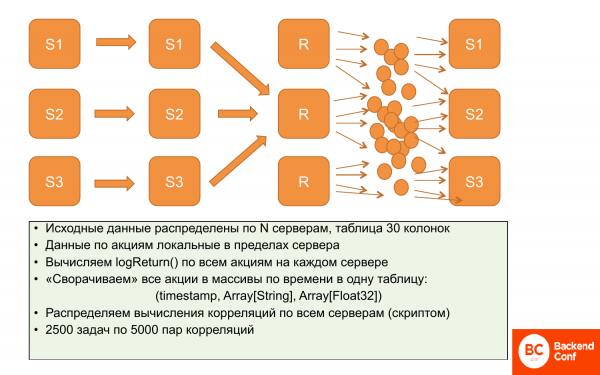
Apoi a venit ClickHouse și totul a devenit mult mai bine.
Aduc aminte, problema noastră este legată de localizarea datelor, pentru că nu putem localiza corelațiile. Nu putem aduna o parte din date pe un server, o parte pe altul și să calculăm; trebuie să avem toate datele pretutindeni.
Ce au făcut? Inițial, datele sunt localizate. Pe fiecare dintre servere sunt stocate date despre prețurile unui anumit set de acțiuni. Și ele nu se suprapun. De aceea, putem calcula logReturn în paralel și independent, totul se desfășoară simultan și distribuit.
Apoi au decis să diminueze aceste date, fără a pierde expresivitatea. Să le diminueze folosind array-uri, adică pentru fiecare interval de timp să facă un array de acțiuni și un array de prețuri. Astfel, datele ocupă mult mai puțin spațiu. Și este mai convenabil să lucrăm cu ele. Acestea sunt operațiuni aproape paralele, adică calculăm parțial în paralel și apoi scriem pe server.
După aceasta, acestea pot fi replicat. Litera „r” înseamnă că aceste date au fost replicate. Adică, avem aceleași date pe toate cele trei servere – anume aceste array-uri.
Apoi, cu un script special din acest set de 12,5 milioane de corelații care trebuie calculate, putem forma pachete. Adică, 2.500 de sarcini cu 5.000 de perechi de corelații. Și această sarcină este calculată pe un anumit server ClickHouse. Are toate datele, pentru că datele sunt identice și le poate calcula secvențial.
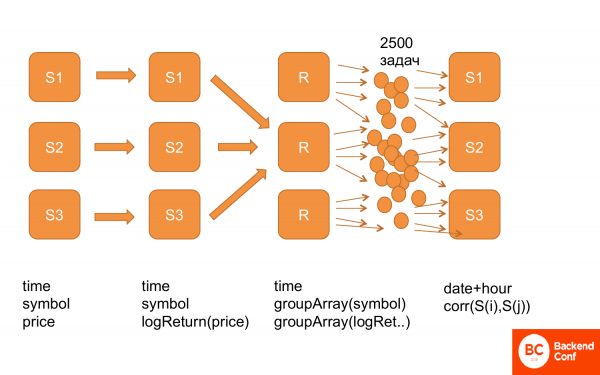
Încă o dată, cum arată asta. Mai întâi, avem toate datele într-o structură de acest tip: timp, acțiuni, preț. Apoi am calculat logReturn, adică datele aceleași structuri, doar că în loc de preț avem deja logReturn. Apoi le-am reorganizat, adică am obținut timp și groupArray pe acțiuni și pe prețuri. Am replicat. Și după asta am generat o grămadă de sarcini și le-am trimis către ClickHouse pentru a le calcula. Și asta funcționează.
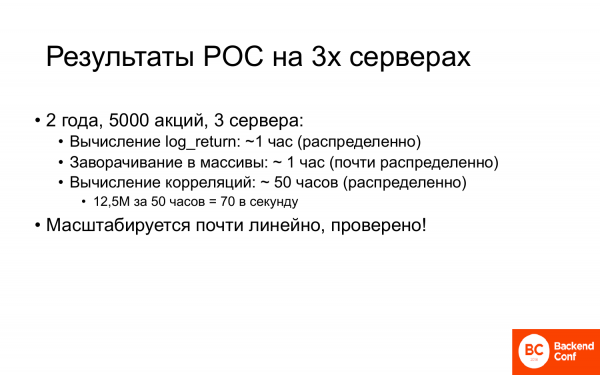
La proof of concept, sarcina a fost o sub-sarcină, adică am luat mai puține date. Și doar pe trei servere.
Primele două etape: calcularea Log_return și ambalarea în tablouri au durat aproximativ o oră fiecare.
Dar calcularea corelației a durat cam 50 de ore. Însă 50 de ore este puțin, pentru că înainte la ei această operațiune dura săptămâni. A fost un mare succes. Și, dacă ne gândim, totul a fost calculat de 70 de ori pe secundă în acest cluster.
Dar cel mai important este că acest sistem este practic fără gâtleie, adică se scalează aproape liniar. Și au verificat asta. Au reușit să-l scaleze cu succes.
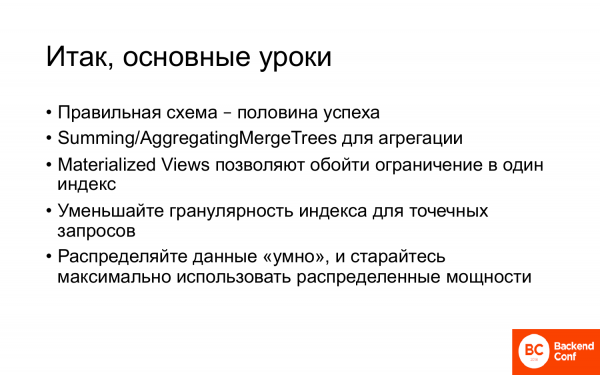
- Schema corectă este jumătate din succes. Și schema corectă este utilizarea tuturor tehnologiilor necesare ClickHouse.
- Summing/AggregatingMergeTrees sunt tehnologiile care permit agregarea sau calcularea stării snapshot ca un caz particular. Și aceasta simplifică considerabil multe lucruri.
- Materialized Views permit ocolirea limitării la un singur index. Poate că nu am exprimat asta foarte clar, dar când încarcăm jurnalele, jurnalele brute erau în tabel cu un singur index, iar jurnalele de atribut erau în tabel, adică aceleași date, doar filtrate, dar indexul era complet diferit. Se pare că sunt aceleași date, dar cu o sortare diferită. Și Materialized Views permite, dacă aveți nevoie, ocolirea unei astfel de limitări ClickHouse.
- Reduceți granularitatea indexului pentru interogări punctuale.
- Și distribuiți datele inteligent, încercând să localizați datele cât mai mult posibil în interiorul serverului. Și încercați ca interogările să utilizeze de asemenea localizarea acolo unde este maxim posibil.
În concluzie, putem spune că ClickHouse și-a consolidat acum poziția atât în domeniul bazelor de date comerciale, cât și în cel al bazelor de date open source, și anume pentru analiză. S-a integrat perfect în acest peisaj. Mai mult decât atât, începe treptat să înlocuiască alte soluții, deoarece, când ai ClickHouse, nu mai ai nevoie de InfiniDB. Poate că Vertica nu va mai fi necesară curând, dacă vor oferi o susținere SQL adecvată. Folosiți-l!
—Vă mulțumesc pentru prezentare! Foarte interesant! Au fost realizate vreo comparații cu Apache Phoenix?
- Nu, nu am auzit pe nimeni să facă o comparație. Noi și Yandex încercăm să monitorizăm toate comparațiile ClickHouse cu diferite baze de date. Pentru că, dacă se dovedește că ceva este mai rapid decât ClickHouse, Alexei Milovidov nu poate dormi noaptea și începe rapid să-l optimizeze. Nu am auzit de o astfel de comparație.
(Alexei Milovidov) Apache Phoenix este un motor SQL pe Hbase. Hbase este destinat în principal scenariilor de tip key-value. Fiecare rând poate avea un număr arbitrar de coloane cu nume arbitrare. Acest lucru se poate spune și despre sisteme precum Hbase, Cassandra. Și pentru acestea, interogările analitice complexe nu vor funcționa corespunzător. Sau s-ar putea să credeți că funcționează bine, dacă nu ați avut experiență cu ClickHouse.
Mulțumesc
Bună ziua! Mă interesează destul de mult acest subiect, deoarece lucrez cu un sistem analitic. Dar, când mă uit la ClickHouse, am impresia că este foarte potrivit pentru analiza evenimentelor, mutabile. Dacă trebuie să analizez multe date de afaceri cu o mulțime de tabele mari, ClickHouse, din câte înțeleg, nu este foarte potrivit pentru mine? În special, dacă acestea se schimbă. Este corect sau există exemple care pot infirma acest lucru?
Asta este corect. Și este adevărat pentru majoritatea bazelor de date analitice specializate. Ele sunt concepute pentru a lucra cu una sau mai multe tabele mari, care sunt mutable, și cu multe mici, care se schimbă lent. Adică, ClickHouse nu este ca Oracle, unde poți stoca totul și construi interogări foarte complexe. Pentru a utiliza eficient ClickHouse, trebuie să construiești schema în modul care funcționează bine în ClickHouse. Adică, să eviți normalizarea excesivă, să folosești dicționare, să încerci să faci mai puține relații lungi. Dacă schema este construită în acest mod, atunci sarcini de afaceri similare pe ClickHouse pot fi rezolvate mult mai eficient decât într-o bază de date relațională tradițională.
Mulțumesc pentru prezentare! Am o întrebare referitoare la ultimul caz financiar. Au avut o analiză. Trebuia să compare cum evoluează în sus și în jos. Și înțeleg că ați construit sistemul exact pentru această analiză? Dacă mâine, să zicem, le-ar trebui un alt raport pe aceste date, trebuie să reconstruiască schema și să încarce datele din nou? Adică, să facă o oarecare preprocesare pentru a obține interogarea?
Sigur, aceasta este utilizarea ClickHouse pentru o sarcină foarte specifică. Aceasta ar putea fi rezolvată în mod tradițional în cadrul Hadoop. Este o sarcină perfectă pentru Hadoop. Dar pe Hadoop este foarte lent. Scopul meu este să demonstrez că în ClickHouse se pot rezolva sarcini care de obicei sunt gestionate prin alte mijloace, dar într-un mod mult mai eficient. Este adaptat pentru o sarcină specifică. Este clar că, dacă există o sarcină similară, aceasta poate fi rezolvată într-un mod similar.
Înțeleg. Ați spus că a fost procesat timp de 50 de ore. Este vorba de la început, când au fost încărcate datele sau când au fost obținute rezultatele?
Da-da.
Bine, vă mulțumesc foarte mult.
Este pe un cluster de 3 servere.
Bună! Mulțumesc pentru prezentare! Totul este foarte interesant. Nu întreb despre funcționalitate, ci despre utilizarea ClickHouse din perspectiva stabilității. Au avut loc vreo problemă, a fost nevoie să restaurați? Cum se comportă ClickHouse în această situație? Și s-a întâmplat vreodată să aveți o cădere și replica, de asemenea? De exemplu, noi am întâlnit probleme cu ClickHouse, când a depășit limita și a căzut.
Sigur, nu există sisteme perfecte. Și ClickHouse are, de asemenea, problemele sale. Dar ați auzit vreodată că Yandex.Metrica nu a funcționat o perioadă lungă? Probabil că nu. Funcționează fiabil undeva din 2012-2013 pe ClickHouse. Pot de asemenea să vorbesc despre experiența mea. Nu am avut niciodată întreruperi complete. Au putut apărea unele probleme parțiale, dar niciodată nu au fost atât de critice încât să afecteze serios afacerea. Acest lucru nu s-a întâmplat niciodată. ClickHouse este destul de fiabil și nu pică în mod aleator. Nu trebuie să vă faceți griji în legătură cu asta. Nu este un lucru precar. Acest lucru a fost dovedit de multe companii.
Bună ziua! Ați spus că trebuie să gândiți foarte bine schema de date de la început. Dar ce se întâmplă dacă acest lucru nu a fost realizat? Datele mele continuă să curgă. Trec șase luni și îmi dau seama că nu pot continua așa, trebuie să reîncărc datele și să fac ceva cu ele.
Acest lucru depinde, desigur, de sistemul dumneavoastră. Există câteva metode de a face acest lucru practic fără întrerupere. De exemplu, puteți crea o Materialized View, în care să aveți o altă structură a datelor, dacă aceasta poate fi mapată în mod clar. Adică, dacă permite maparea prin ClickHouse, adică extragerea unor elemente, schimbarea cheii primare, schimbarea partiționării, atunci se poate crea o Materialized View. Acolo, vechile date pot fi scrise, iar noile vor fi scrise automat. Apoi, doar schimbați utilizarea Materialized View, apoi schimbați scrierea și ștergeți tabelul vechi. Acesta este un mod de a face asta fără oprire.
Mulțumim.
Sursa: habr.com
